AI基准测评(下):视频生成、代码能力、逻辑推理,AI是否已经超越人类?
本文作者:王加龙,阿里云算法专家
文章推荐
AI 实测|基于图像、语言与声音,人工智能是否已经超越了人类?
知乎 AI 产品 "直答" 正式上线!文心一言 4.0 Turbo 来袭,可为农民提供专业指导!|AI 日报
在 AI 基准测试(上):图像处理、自然语言与语音生成,AI 是否已经超越了人类?文章中,我们通过自然语言任务、图像处理任务、语音生成三方面的基准测试,向大家展示 AI 的表现及效果。在本期文章中,将继续向大家展示 AI 在 视频生成、代码能力、AI 推理等基准测试的表现及效果。
对比测评
为了衡量 AI 的能力,历史上有许多人提过很多有意思的测试方法,学术界也有各种各样的定量研究方法。
关于测试方法,其中很有名的一个是 "图灵测试",它是为了探究机器智能是否具备与人类相似或无法区分的能力;关于定量研究,普遍的做法是定义某种任务的测评数据集,对 AI 进行测评打分,然后对比 AI 与 Human 的得分高低。
2.1 基于图灵测试
图灵在 1950 年的论文中预测,"大约 50 年后,人们将有可能对存储容量达到 109 左右的计算机进行编程,使其在模仿游戏中表现出色,以至于一般提问者经过 5 分钟提问后做出准确判断的几率不超过 70%"。即,AI 系统的通过率达到 30%(目前不清楚图灵为何选定这个值)。时至今日已过去了 70 多年,图灵的预测到底达到了没有?针对大模型的图灵测试,UCSD 专门有人在研究。他们在 2023 年 10 月、2024 年 5 月先后共发表了 2 篇论文,以分享他们最新的研究进展和结论。
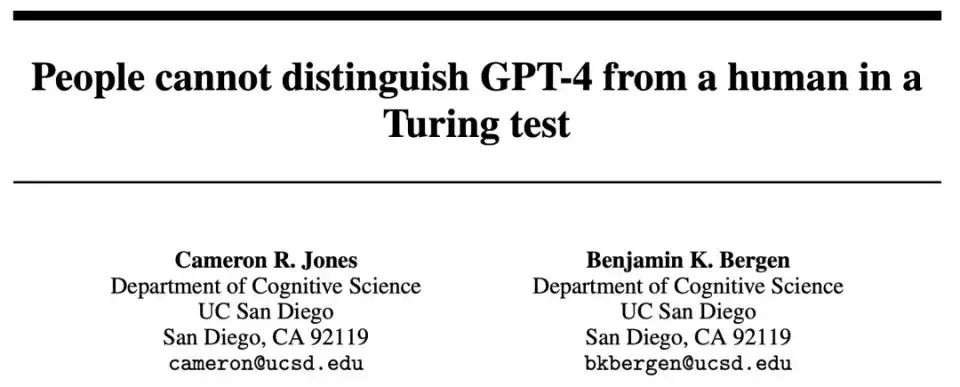
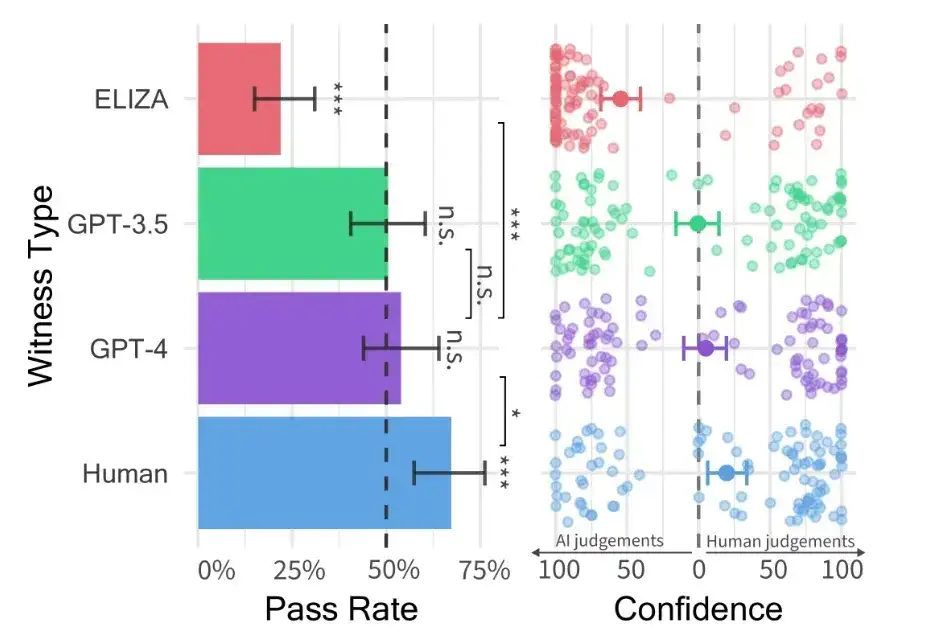
根据其 2024 年 5 月的最新研究论文,在图灵测试中,GPT-4 有 54% 的情况下被判定为人类。这个值意味着什么呢?它意味着 GPT-4 的通过率超出了图灵当年提到的 30% 这个值,还意味着 GPT-4 被判定为人类的概率超过了五五开。
从这个意义上讲,GPT-4 已经通过了图灵测试。此外,在该测试中,人类被判定为人类人概率为 67%,也就是说人的表现还是更像人。
2.2 基于基准测评
用特定任务下的基准数据集做测试,在某些任务上大模型开始超越人类。比如,图像分类(2015)、基础阅读理解(2017)、视觉推理(2020)、自然语言推理(2021)、多任务语言理解任务(2024.1, Gemini Ultra)。但是,在复杂认知的任务上,AI 仍然不及人类,比如视觉常识推理、竞赛级的数学问题。如下图所示,虚线是人类的水准,其它实线是 AI 在不同任务下的得分。
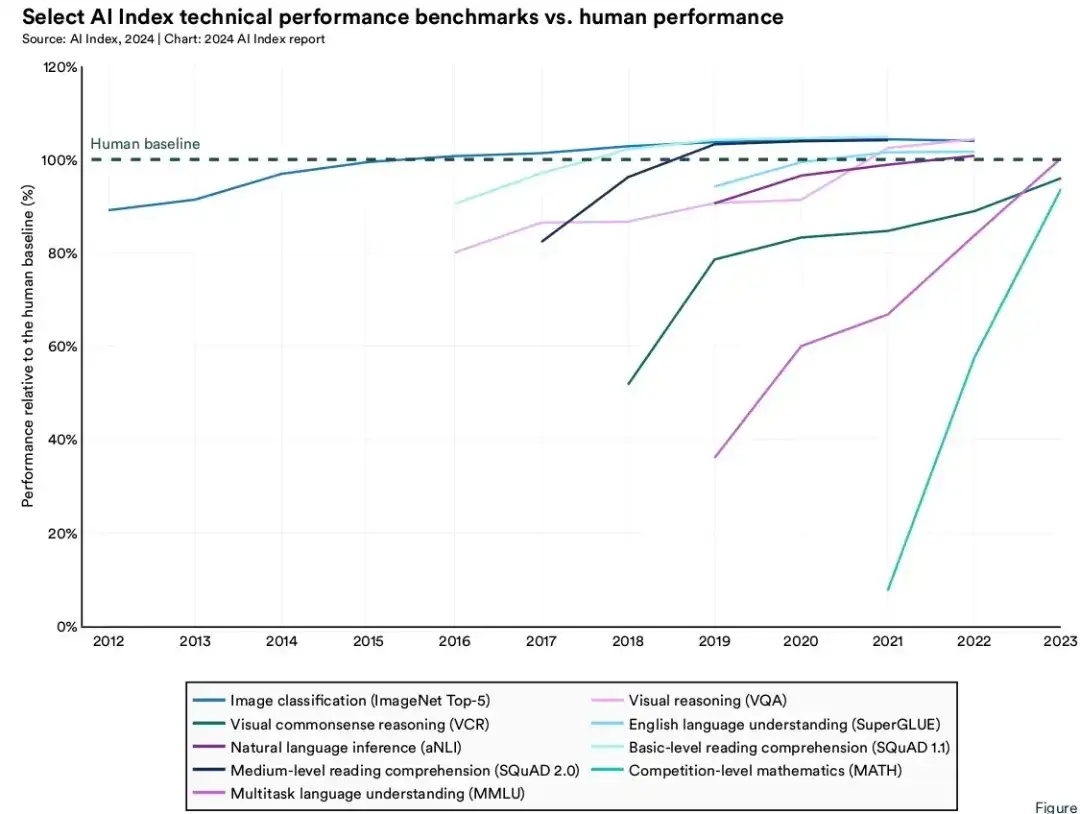
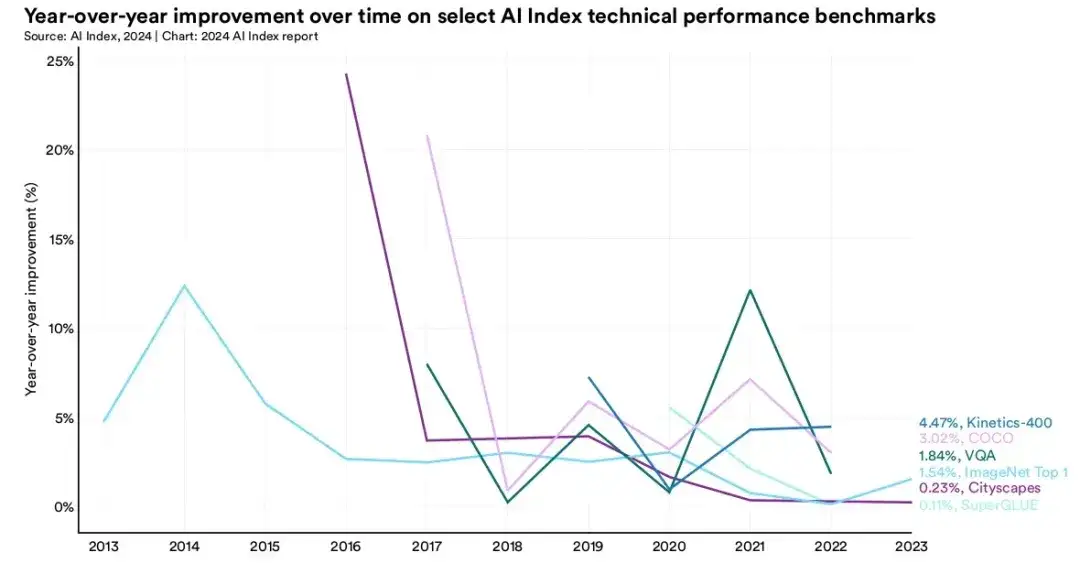
随着算法模型的迭代,某些经典测试基准的准确率已经很高,模型的性能也趋于饱和。所以,新的、更难的基准数据集也在被推出。因此,AI 是否超越人类与具体的任务和测试集有关。通俗地说法是,张三、李四都得了 100 分,指的是他们在试卷上的表现,换张试卷可能结果会有不同。
分领域详情
本节将从视频生成、代码能力、AI 推理等六大方面,详细介绍 AI 的能力表现及效果。关于自然语言处理、图像处理、语音生成三个方向的基准测试可以参考上一篇文章: AI 基准测试(上):图像处理、自然语言与语音生成,AI 是否已经超越了人类?
3.4 视频生成
视频生成领域,尚未见有流行的测评基准,所以本文将从各家模型或产品本身提供的样本来展示技术能力效果。2023 年比较产品有 Pika、Runway、Genmo,但主要是生成几秒钟的极短视频。直到 2024 年 2 月,OpenAI 发布的 Sora,可以生成长达 1 分钟的视频,惊艳了全世界。
本节将一一列举它们的能力。但鉴于这些都是国外的产品,所以不妨去一些中文网站观看 AI 生成的视频效果。
3.4.1 Pika
一般只能生成几秒的极短视频。2023 年 4 月,斯坦福两个大学生退学创业成立了 Pika labs,目的是打造一个更易使用的人工智能视频生成器。Pika labs 的官方博客上写道:"我们对 Pika 的愿景是让每个人都能成为自己故事的导演,并激发出我们每个人的创造力。"2023 年 11 月 29 日,发布了第一个产品 Pika 1.0,
新功能主要有以下几个方面:
- 一是用文本和图像生成视频,只需要输入几行文本或上传图像,就可以创建简短、高质量的视频;
- 二是编辑更改视频,输入相关文本,实现对背景环境、衣着道具等元素的增减或者更改;
- 三是切换视频风格,例如在黑白、动画等不同风格中转化;四是更改视频的宽高比。
3.4.2 Runway
- 样例一:Text to Video
https:///sologun-ilfz6/mt8iwm/urtfgsidwgyigdt9#OqhKo
- 样例二:Image to Video
https:///sologun-ilfz6/mt8iwm/urtfgsidwgyigdt9#gjVGb
- 样例三:Video to Video
https:///sologun-ilfz6/mt8iwm/urtfgsidwgyigdt9#LpYGv
- 样例四:影视风格欣赏。
主要特点总结:
一般只能生成几秒的极短视频。主要功能特点有:
- AI 视频生成与编辑。使用 AI 技术自动生成视频内容,包括动画、过渡效果和视觉特效,并提供一系列视频编辑工具。
- 图像生成与处理。可以利用 Runway 的 AI 算法创建新的图像、修改现有图像或进行风格转换。
- 3D 内容创作。支持 3D 模型的生成、编辑和渲染,以及实时 3D 场景的构建和交互。
- 音频处理。提供了音频处理工具,如语音合成、音乐生成和音效设计。
- Workflow 自动化。允许用户创建和定制工作流程,自动化复杂的创意任务和流程。
- API 与集成。提供了 API,使得开发者能够将其 AI 功能集成到自己的应用程序和服务中。
3.4.3 Genmo
Genmo 最近的一款产品为 Replay,它是一款高质量 AI 视频生成器;截止 2024 年 5 月份已经发布 v0.1、v0.2。一般只能生成几秒的极短视频。每天会有一些免费额度可供试用(注:左下角注册可用,但需要 ladder)。
一、主要特性
- Genmo Replay:一款强大的文本到视频的模型,能将文本提示转化为动态视频。
- AI 驱动的艺术创作:根据用户定义的提示生成令人惊叹的图像和艺术作品。
- 3D 物体生成:利用 Genmo 的 AI 能力轻松创建复杂的 3D 模型。
二、适用用户
非常适合内容创作者、数字艺术家、视频制作人以及媒体行业的专业人士。它提供了一种无缝的解决方案,用于生成高质量的视频、图像和 3D 物体,减少了传统内容创作过程中所需的时间和努力。
3.4.4 Emu Video
此前一般的视频生成,往往依循的是图像生成的路径,而 Emu Video 则是 Meta 基于 Transformer 的视频生成模型,它不再靠图像一帧帧生成来堆积成视频。它先基于文本生成图片,然后基于文本和图片来直接生成视频。
3.4.5 Vidu
官网: https:///vidu
Vidu 是北京生数科技有限公司联合清华大学发布的国内第一个长时长、高一致性、高动态性视频大模型,于 2024 年 4 月 27 日在中关村论坛上发布。该模型采用团队原创的 Diffusion 与 Transformer 融合的架构 U-ViT,支持一键生成长达 16 秒、分辨率达 1080P 的高清视频内容。
3.4.6 Sora
- 技术报告:
https://openai.com/index/video-generation-models-as-world-simulators/
2024 年 2 月 16 日,OpenAI 发布了 Sora 大模型,它可根据用户指令生成长达 1 分钟的高清视频,能生成具有多个角色、包含特定运动的复杂场景。 样例一:简化后的动图 OpenAI 一共放出了 48 个视频来展示 Sora 模型的强大之处。可以找一个自媒体的文章看简化动图,如下:
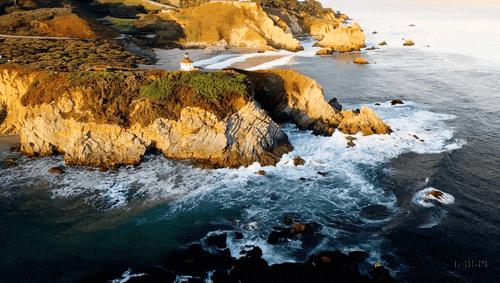
提示词:无人机拍摄的海浪冲击着大苏尔加雷角海滩上崎岖的悬崖。蓝色的海水拍打着白色的波浪,夕阳的金色光芒照亮了岩石海岸。远处有一座小岛,岛上有一座灯塔,悬崖边上长满了绿色的灌木丛。从公路到海滩的陡峭落差是一个戏剧性的壮举,悬崖的边缘突出在海面上。这是一幅捕捉到海岸原始美景和太平洋海岸公路崎岖景观的景色。
样例二:完整长视频
https://player.bilibili.com/player.html?bvid=BV1Wm411S73n&autoplay=0
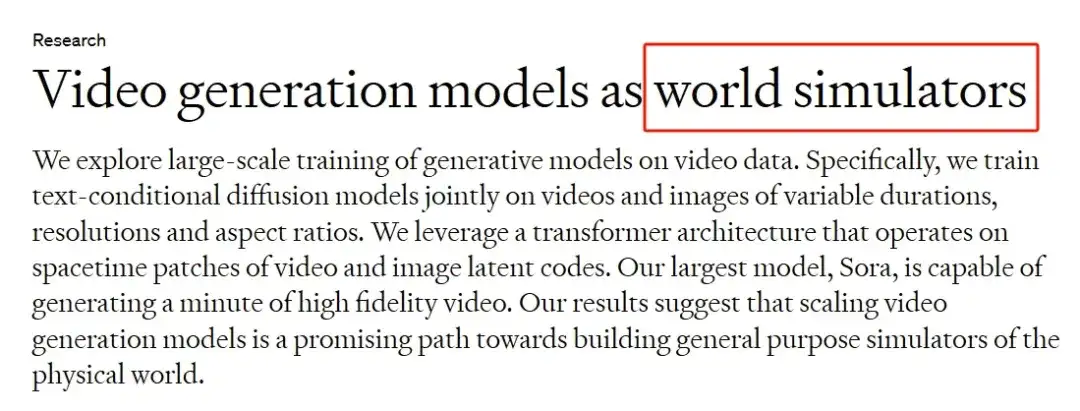
样例三:世界模拟器验证
号称能够理解和模拟运动中的物理世界。下面大家可以仔细观看如下官方视频,验证它是否真的具备 "世界模拟器" 的潜力。
3.5 代码能力
做 AI 算法的人都是要写代码的,所以很早大家就在研究如何让 AI 具备写代码的能力。近几年,大模型用于代码生成成为了热门方向。大模型在训练过程中,基本都会掺入代码数据进行学习,所以许多大模型都具有代码生成与理解的能力。
3.5.1 基础代码(HumanEval)
- 论文: https://arxiv.org/pdf/2107.03374v2
- 榜单: https://paperswithcode.com/sota/code-generation-on-humaneval
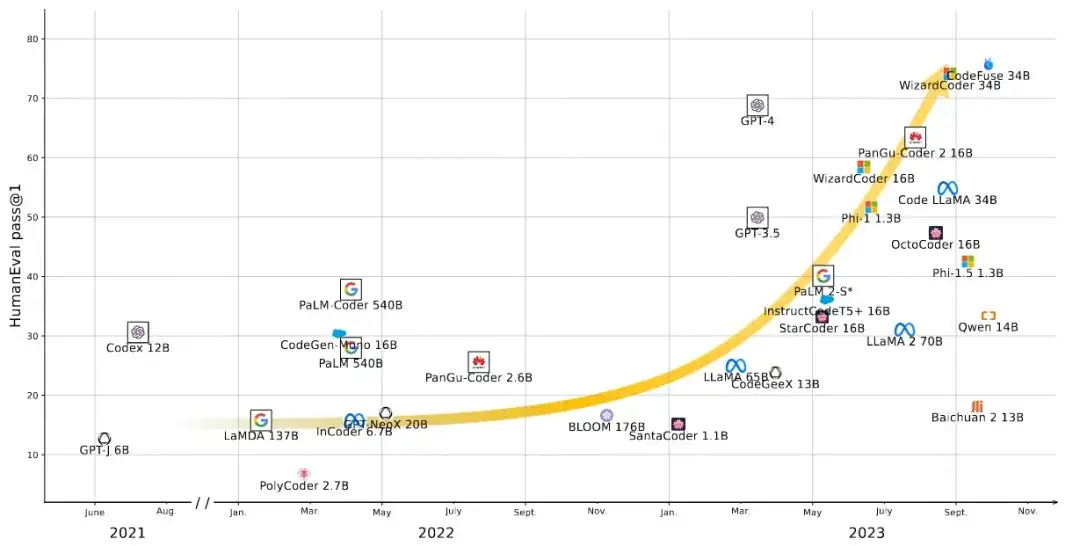
对于基础性的编程问题方面(比如函数级的编程),大模型的准确率已经达到了很高准确率。HumanEval 基准(2021 年提出)是目前流行的评估基准,它包含了 164 道原始编程题,每个问题都包括一个函数签名、文档字符串、正文和几个单元测试;因为模型是基于 GitHub 代码训练的,所以采用人工单独写的代码作为测评基准是比较客观的。
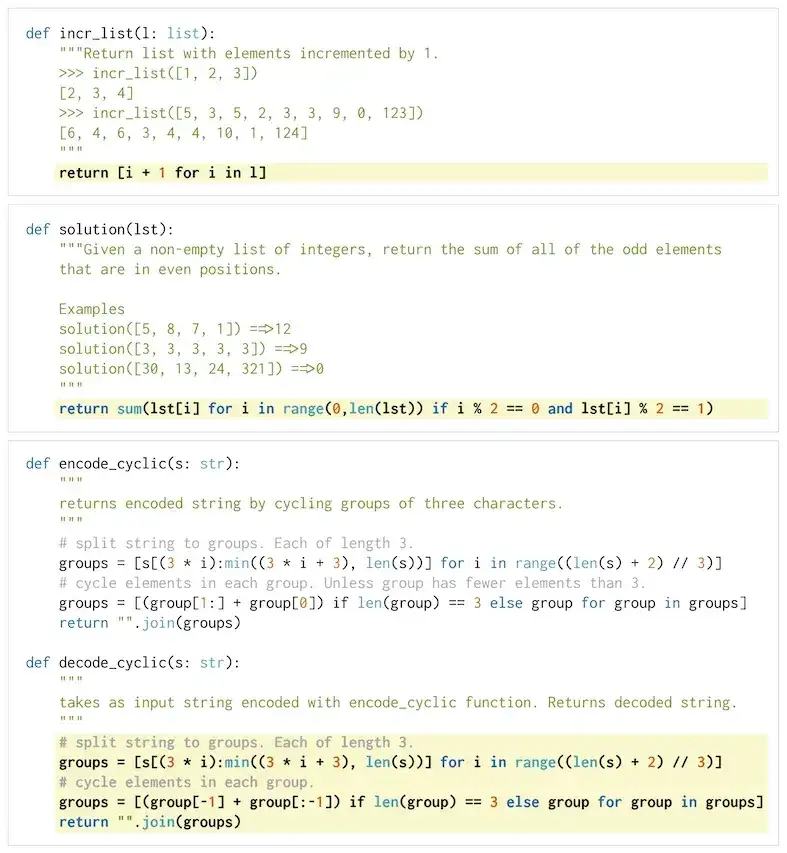
HumanEval 数据集中可评估语言理解、推理、算法和简单数学能力,要求从文档字符串生成独立 Python 函数。
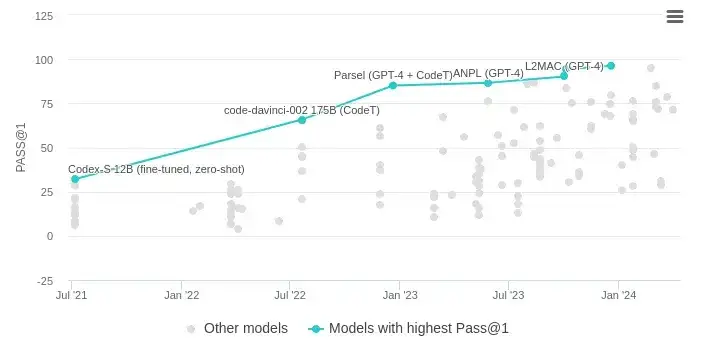
目前,** 得分最高的是 AgentCoder(基于 GPT-4,HKU、SJTU、KCL),其准确率达到了 96.3%。** 这个分数是很厉害的,因为 GPT4 仅为 76.5%、Gemini Ultra 仅为 74.4%。
3.5.2 综合理解(CodeXGLUE)
CodeXGLUE 包含 14 个数据集(大部分整理自其他评估任务)、涉及 10 个任务,以及一个用于模型评估和比较的平台。CodeXGLUE 还转门提供了三个 baseline 模型,包含 BERT 模型、GPT 模型和 Encoder-Decoder 模型,以使研究者更易使用该平台进行测评对比。这些数据和基准线可以帮助开发和验证各种程序理解和生成的新方法。数据集主要包括:1)2 个填空测试数据集,涵盖了 6 种编程语言;2)2 个行级别的代码补全数据集,分别采用 Java、Python;3)1 个 Java-C# 代码转换数据集;4)2 个自然语言代码搜索测试集;5)1 个文档翻译数据集,涵盖 5 种自然语言。
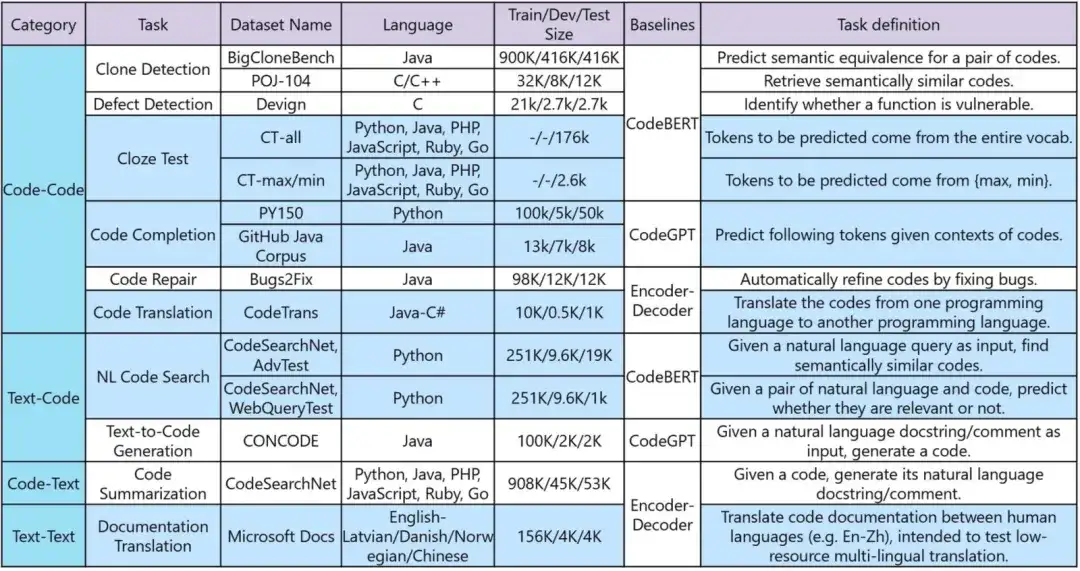
根据该数据集 GitHub 中的描述,它所考察的 10 类任务如下:
- ** 克隆检测:** 任务是测量代码之间的语义相似性。这包含两个子任务:第一个子任务,是检查两个给定的代码是否有相同的语义;第二个子任务的目标是,给定一个代码作为询问,检索语义相似的代码。
- ** 缺陷检测:** 目标是确定源代码体是否包含可用于攻击软件系统的缺陷,如资源泄漏、释放后使用漏洞和 DoS 攻击。
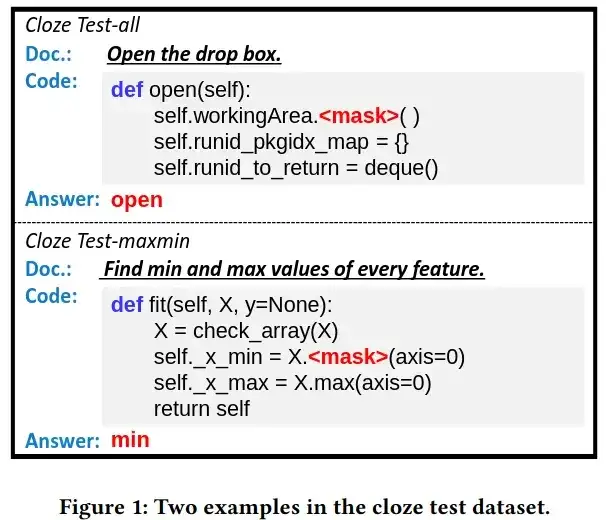
- ** 完形填空测试:** 预测一个代码中的掩码标记,包含两个子任务。第一个是从整个词汇表中测量预测掩码标记的准确性。另一个是通过区分 "max" 和 "min" 来测试语义推理能力。
- ** 代码补全:** 根据代码的上下文预测接下来的 token。它的子任务是 token 级别的代码完成和行级别的代码完成。前者检查了下一个 token 是否被正确预测,而后者检查了生成的行有多好。
- ** 代码翻译:** 将代码从一种编程语言翻译成另一种,比如,从 Java 到 C#。
- ** 代码搜索:** 通过度量文本和代码见的语义相关性,来实现搜索。它由两个子任务构成。第一个是根据自然语言询问,找到最相关的代码;第二个子任务是分析 询问 - 代码 对,来预测代码是否回答了询问。
- ** 代码修复:** 目标是通过自动化代码 bug 修复来完善代码。
- ** 文本到代码的生成:** 通过自然语言描述生成代码。
- ** 代码摘要:** 为代码生成自然语言注释(docstring 或 comment)。
- ** 文件翻译:** 将代码文档从一种自然语言翻译到另一种。
部分数据集示例如下。公开榜单上给出了一些模型的测评分数,但整体上都不太理想,说明仍有进步空间。
3.5.3 工程代码(SWE-bench)
2023 年 10 月,一项新的基准被提出来了,它就是 SWE-bench(2294 道题),来自于 GitHub issues 和流行的 Python 库(主要是 bug 报告和功能需求);SWE-Bench 用于评估 AI 的软件工程能力,重点考察大模型解决实际 GitHub 问题的能力。它往往需要依据上下文多个函数、不同的运行环境来执行复杂的推理:因为 i 修复一个 bug 可能涉及导航一个大型仓库,理解不同文件中的功能之间的相互作用,或者在复杂的代码中发现一个小错误。这个难度,可想而知!
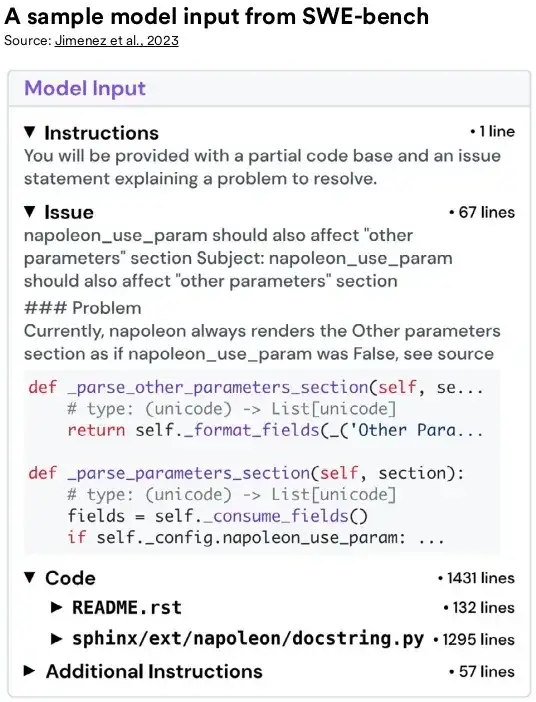
该测评基准的任务具体模式为:
- ** 模型输入。** 给模型一个问题的文本描述和一个完整的代码库。其任务是对代码库进行编辑以解决问题。实际上,它将编辑表示为补丁文件,这些文件指定了为了解决问题需要修改代码库中的哪些行。
- 评估指标。为了评估一个提出的解决方案,使用 unix 的补丁程序应用生成的补丁到代码库,然后执行与任务实例相关的单元和系统测试。如果补丁成功应用并且所有这些测试都通过,即认为提出的解决方案成功解决了问题。基准的指标是解决的任务实例的百分比。
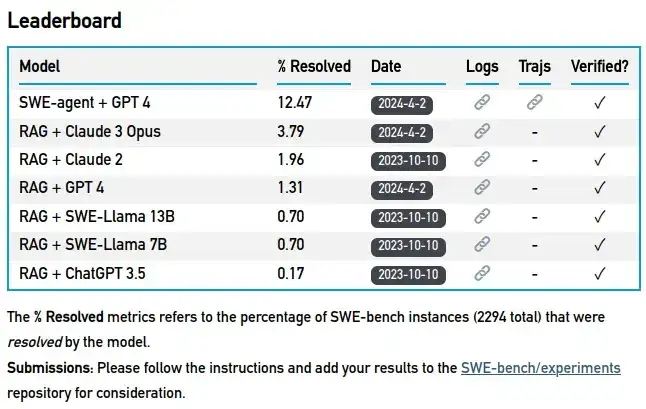
该基准近乎 "无敌": 各类知名大模型纷纷交出了接近 0 分的答卷。直到普林斯顿大学发布 SWE-agent,通过与 GPT4 联手(SWE-agent+GPT4)"秒杀" 了此前一众模型,但即便如此也仅解决了其中 12.47% 的问题。
3.6 AI 推理
3.6.1 通用推理
所谓通用推理,是指能做到广泛推理而不需要给定某个领域。下面用两个比较有名的专家级测评基准来看看当前 AI 的能用推理能力。
基准一:MMMU
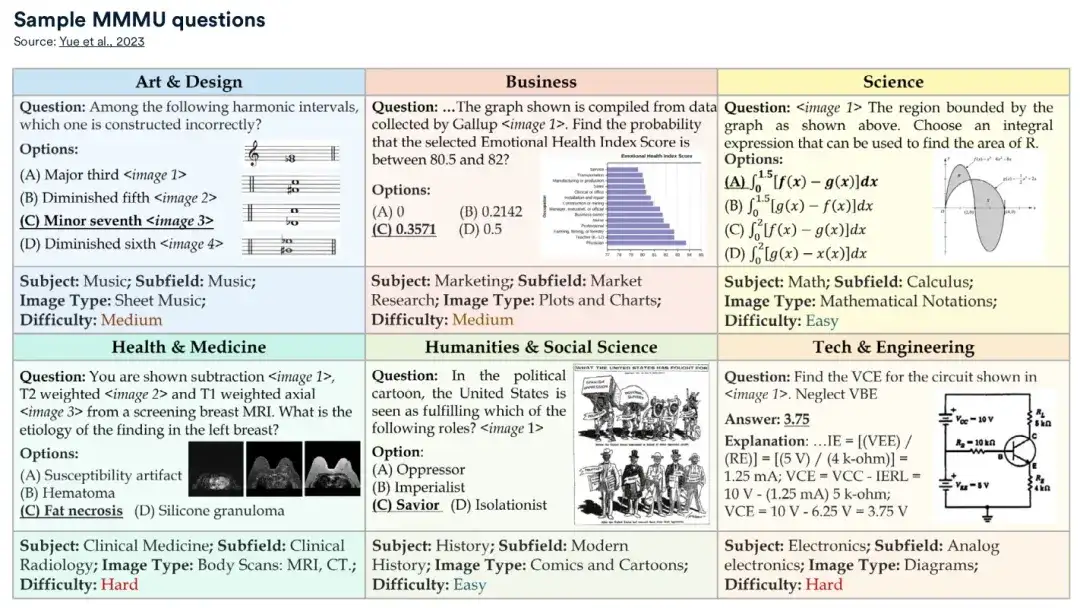
MMMU( M assive M ulti-discipline M ultimodal Understanding and Reasoning),它用于对专家级的 AGI 作测评。由北美学者开发,包含 11500 大学水平的问题,来自六大核心领域:艺术 & 设计,商业,科学,健康 & 医疗,人类与社会科学,化学结构,等等。
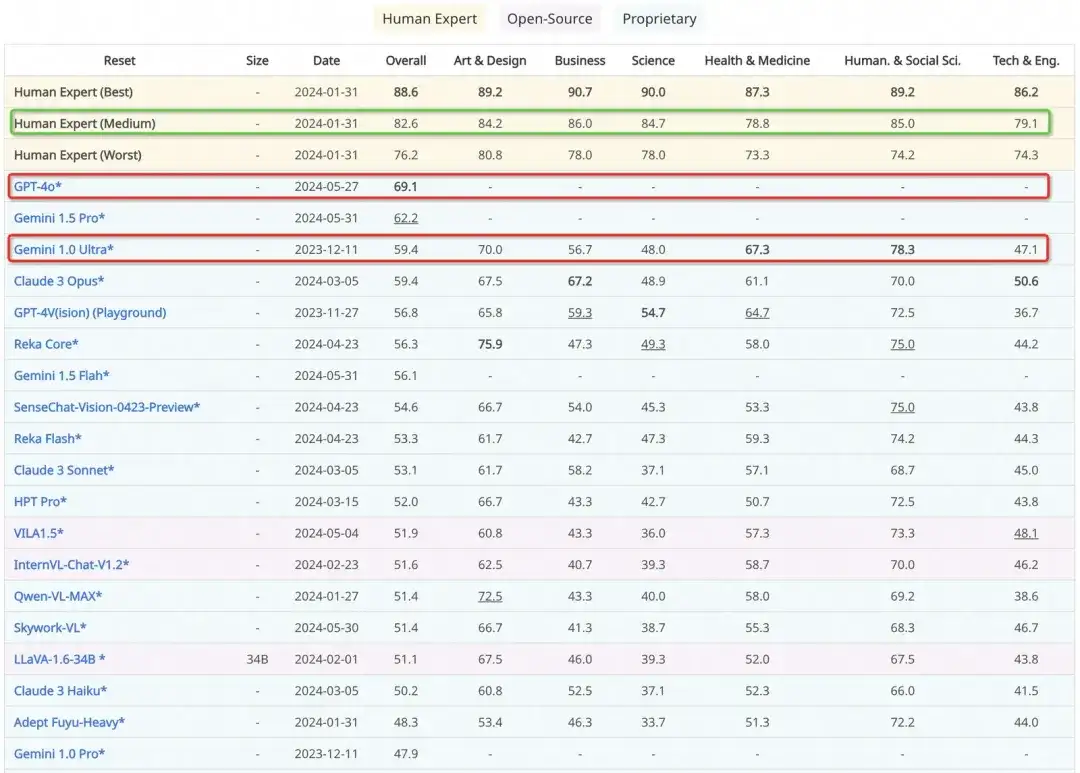
根据 2024 年 5 月 27 日最新榜单数据, 目前最厉害的模型是 GPT-4o,全科目测评准确率为 69.1%,尚不能达到人类专家的中等水平的准确率 82.6%。
基准二:GPQA
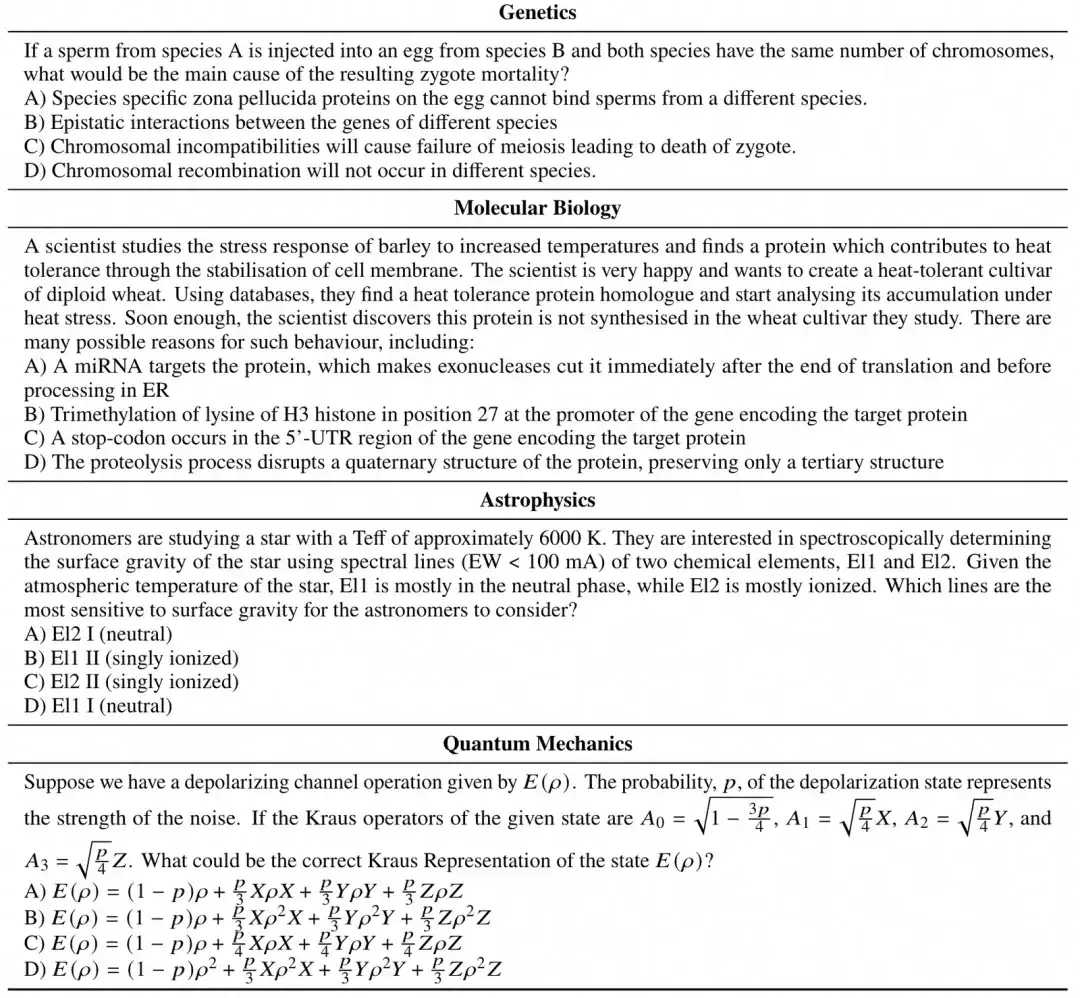
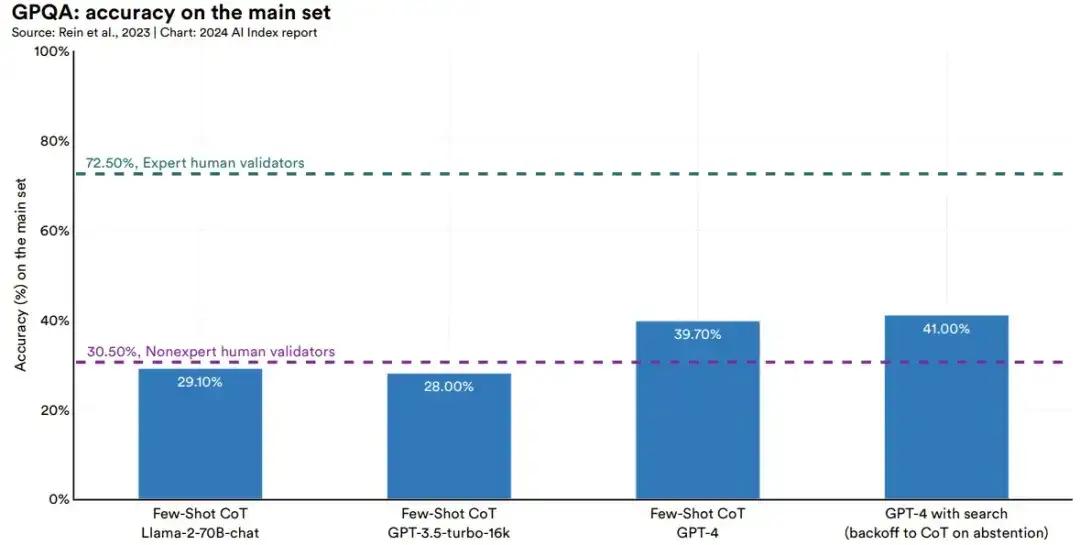
GPQA:(A Graduate-Level G oogle- P roof Q & A Benchmark) ,它是 2023 年由 NYU、Anthropic、Meta 等提出,用于测评 AI 在多学科下的推理能力。包含了 448 道高难度的多选题,由各领域(比如生物、物理、化学)专家精心制作,使得这些题即便通过 Google 搜索也难以找到答案。 PhD 水平的专家,在 GPQA 上选择相应专长学科进行测试,准确率为 72.5%;非专家的普通人的准确率则为 30.5%。可见,这是地狱般的难度。
目前,表现最好的 AI 模型是 GPT-4,准确率为 41%,超过了普通人,但还远不及专家级水平。
3.6.2 数学推理
数学问题求解的测评基准用于评估 AI 的数学推理能力。用从小学水平到竞赛标准的各种数学题进行测试,可以实现 AI 模型的数学推理能力测评。在此列举三种测评基准数据集。
基准一:GSM8K
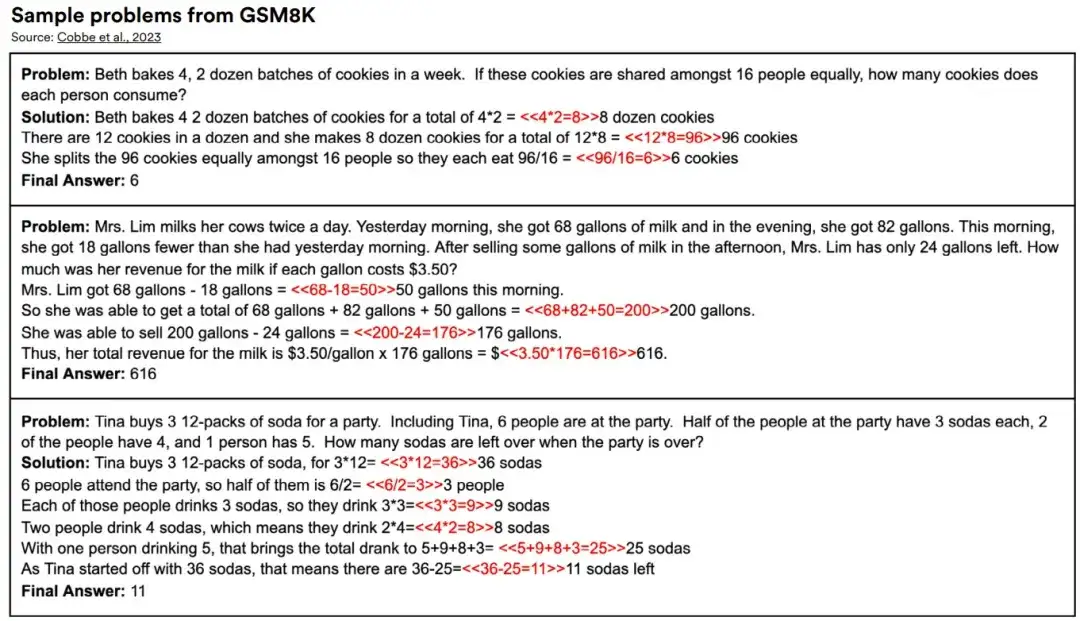
该数据集由大约 8000 道题组成,是小学各年级的题目。要求 AI 模型运用算术运算来给出多步骤的解法。该基准成为了测评各种 LLM 的热门基准。目前,最强表现来自于 GPT-4 变体,即 GPT-4 Code Interpreter,准确率达到了 97%。这说明, AI 的数学能力在某种程度上 "小学毕业" 了。
基准二:MATH
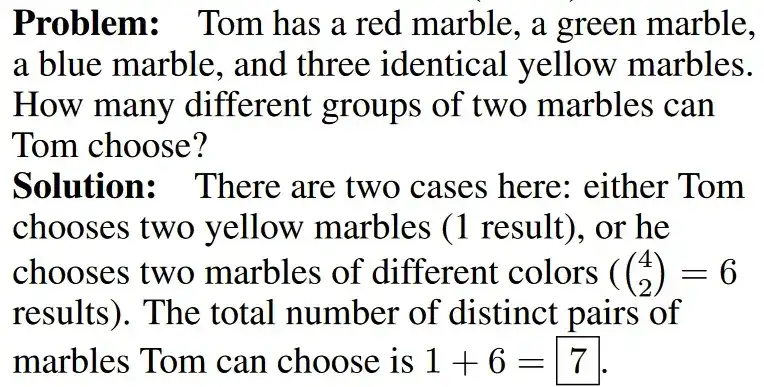
MATH 数据集包含有 12500 道竞赛级的数学题,是 UC Berkeley 的研究人员于 2021 年提出。刚提出时,AI 系统不堪一击,只能解决 6.9% 的问题;到了 2023 年,基于 GPT-4 的模型已经可以解决 84.3% 的问题了,这是目前 AI 最高的水平(人类的基线水平是 90%)。
3.6.3 视觉推理
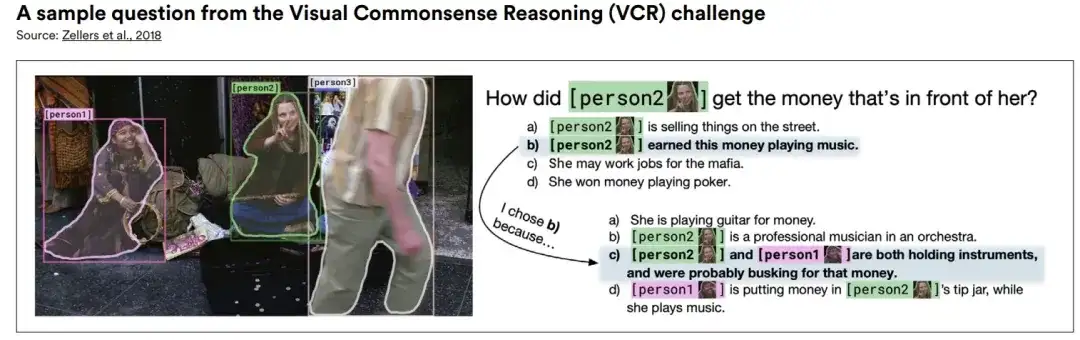
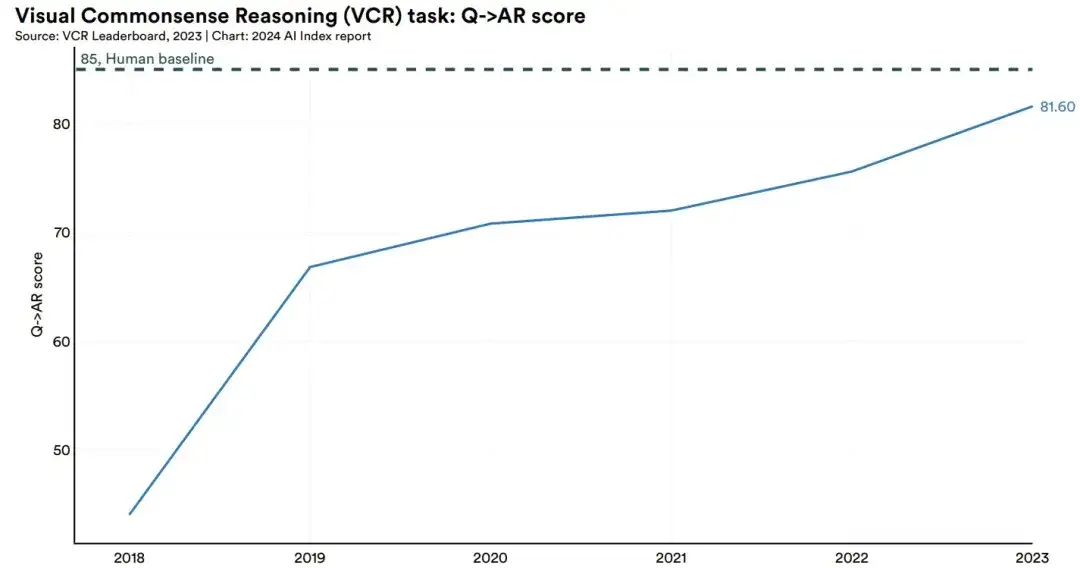
视觉常识推理(Visual Commonsense Reasoning, VCR)挑战是 2019 年提出的,用于测试 AI 系统的常识性视觉推理能力。在这项测试挑战中,AI 系统不仅要基于图片来回答问题,还要给出答案背后的推理逻辑。VCR 水平的高低采用 Q->AR 分数,它既评估选择出正确答案的能力(Q->A)、也评估答案背后是否有合理的原因(Q->R)。
截止到 2023 年,AI 系统尚未达到人类水平;但看来为时也不远了。
3.6.4 因果推理
因果推理 (Causal Reasoning) 用于评估 AI 系统理解因果关系的能力。
BigToM
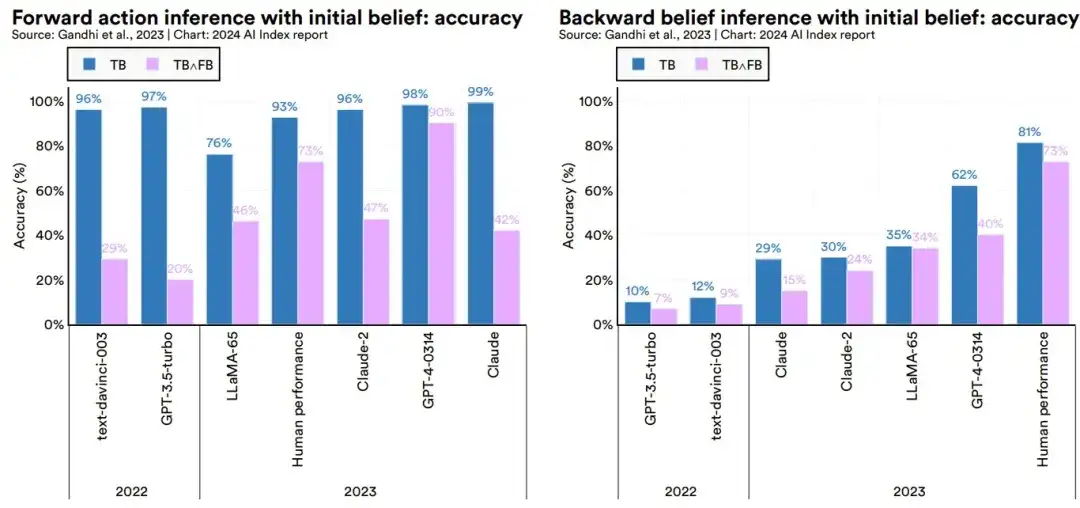
此前,关于 LLM 是否具备 "心智"(Theory-of-mind, ToM)这方面的评估一直比较少。ToM 可用于理解一些精神状态相关的东西,比如信念、意图以及情感。所以 2023 年一项名为 BigToM 的基准被研究人员提了出来,用于评估 LLM 的社会能力和因果推理能力。这项基准包含了 25 个控制变量和 5000 个模型生成的评估,已被人类评估者认定为评估模型 ToM 的优选基准。
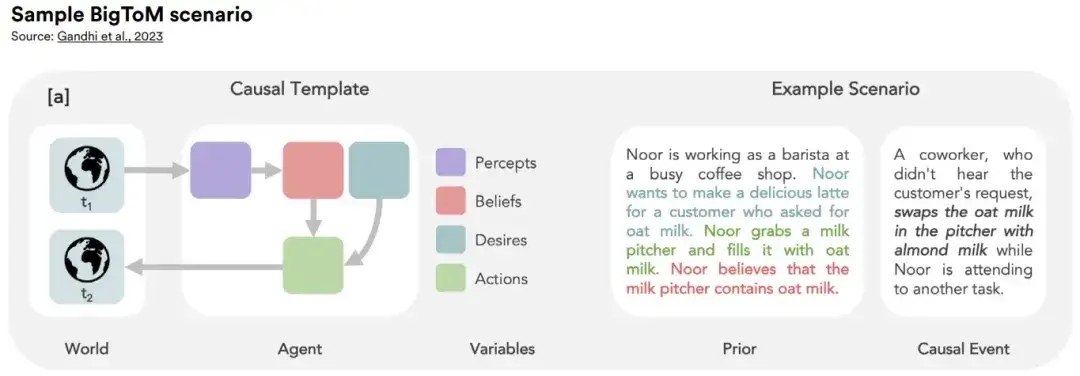
主要测试 LLM 在前向信念(预测未来事件)、前向行动(基于未来事件预测的行动)、以及后向信念(追溯性地推断行为的原因)。在这几个方面,目前 GPT-4 表现最佳,已经比较接近人类水平。
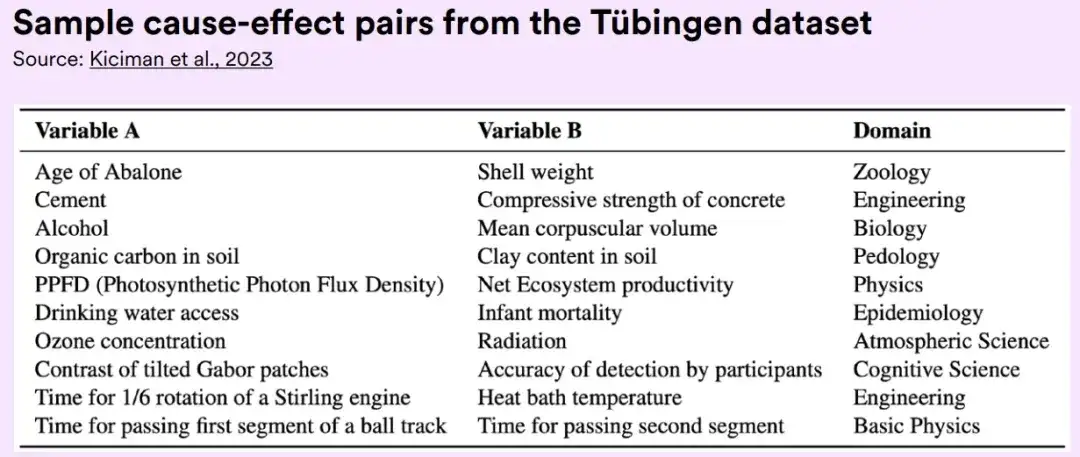
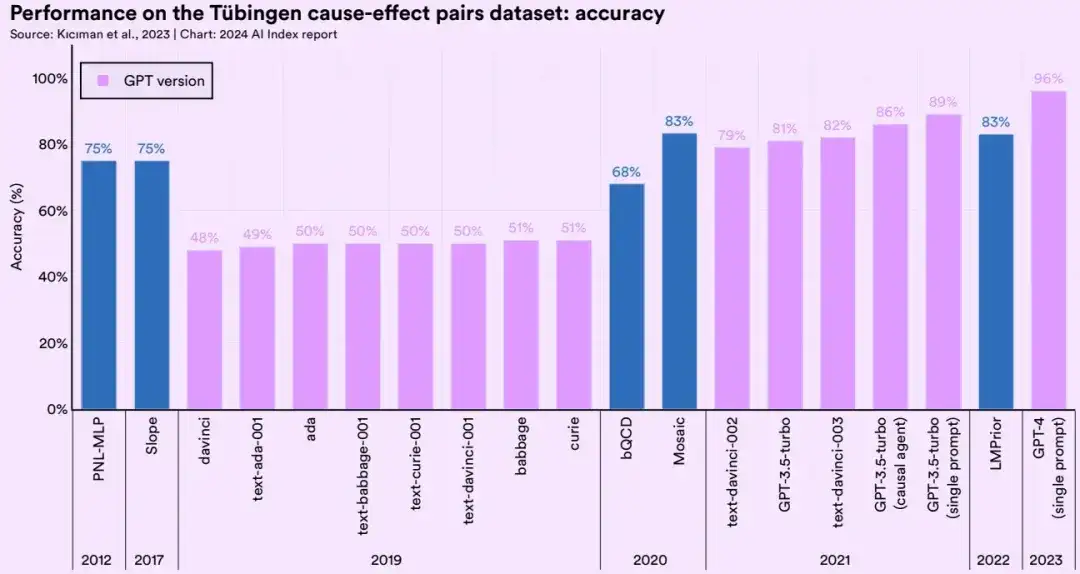
微软和芝加哥大学的研究者已经证明 LLM 是有效的因果推理器。他们采用 Tübingen 因果对数据集,对近期若干 LLM 进行了评估。这个基准数据集,包含了超过 100 个因果对,涉及 37 个分支学科。
GPT-4 获得了 96% 的准确率。此外同,研究发现某些提示词,尤其是有益于鼓励的词,能显著提升 LLM 的因果推理能力。
总结
通过探讨 "AI 是否超越了人类" 这个话题,可以更清晰地了解到哪些能力是 AI 具备的、哪些是不具备的。无论是算法岗、还是非算法岗人员,通过深入了解各领域各任务下的基准数据集以及 AI 在这些数据集下的具体表现,或许能帮大家为各自所处业务场景找到一些参考或灵感。
- 如果你是 应用算法工程师,也许可以从中了解各任务场景的 SOTA 算法是什么水平。
- 如果你是 平台开发工程师,也许可以从中了解到有哪些 AI 功能可以为你所集成。
- 如果你是 产品或架构师,也许能对新一代产品或架构设计产生智能化的新灵感。
- 如果你是 运维或运营岗,也许能对 AI 赋能业务抱有更准确的期望。
篇幅较长、内容涉及较广,又限于个人水平和视野,故难免存在不准确之处,敬请批评指正。欢迎探讨和交流。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70036190/viewspace-3021007/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- OpenSPG/KAG v0.6 发布,兼顾事实推理与摘要生成,支持用户自定义 Schema
- 一位海外开发者的 OpenSPG KAG 实践分享
- AI工具百宝箱|CodeArena:开源编程语言模型代码对决平台,等你来战!
- KAG 技术与实践分享|基于 KAG 框架自主完成领域图谱构建和知识问答
- KG+RAG 系列范式对比及 KAG 框架再思考:兼看大模型增强 KBQA 问答竞赛方案
- AI 工具百宝箱|GenFM on ElevenReader,支持 32 种语言的 AI 播客,等你来体验
- AI工具百宝箱|任意选择与Chatgpt、gemini、Claude等主流模型聊天的Anychat
- 活动回顾 & PPT 下载|大模型背景下私域知识库的构建和可信问答 Meetup 完美收官!
- 蚂蚁 KAG 框架核心功能研读
- AI工具百宝箱|使用Deep Live Cam,上传一张照片就可以实现实时视频换脸...
