NVIDIA GTC 2024 大会 | 如何降低 AI 工程成本?蚂蚁从训练到推理的全栈实践
本文内容来源于 蚂蚁集团 AI Infra 部门负责人张科,在 GTC 2024 大会 China AI Day 线上专场的演讲。在演讲中张科分享了 AI 工程当前的现状和主要挑战,以及蚂蚁集团在 AI 工程领域的实践经验和开源项目,也欢迎 AI 工程领域的同行们共同参与开源项目的共建与共享。
张科于 2009 年中国科学院硕士毕业加入微软,主要工作有必应搜索引擎排序系统重构和广告主平台研发,开源深度学习模型标准 ONNX 以及推理引擎 ONNX Runtime 的主要作者之一。2020 年回国后加入蚂蚁,负责蚂蚁 AI 基础设施建设。
扫描上方图片二维码或点击【阅读原文】,观看视频,并可下载讲义。
AI 工程现状与挑战
下图趋势展示了当今 AI 工程的现状:模型参数规模呈指数级增长,动辄达万亿规模,甚至更高,与此相伴的是对算力的需求急剧攀升,其需求是万卡乃至几十万卡,EFLOPS 级别的计算能力。值得庆幸的是,在 AI 工程层面,开源生态蓬勃发展,有诸如 DeepSpeed、NVIDIA Megatron-LM, TensorRT-LLM 等开源框架可供业界借鉴与使用。
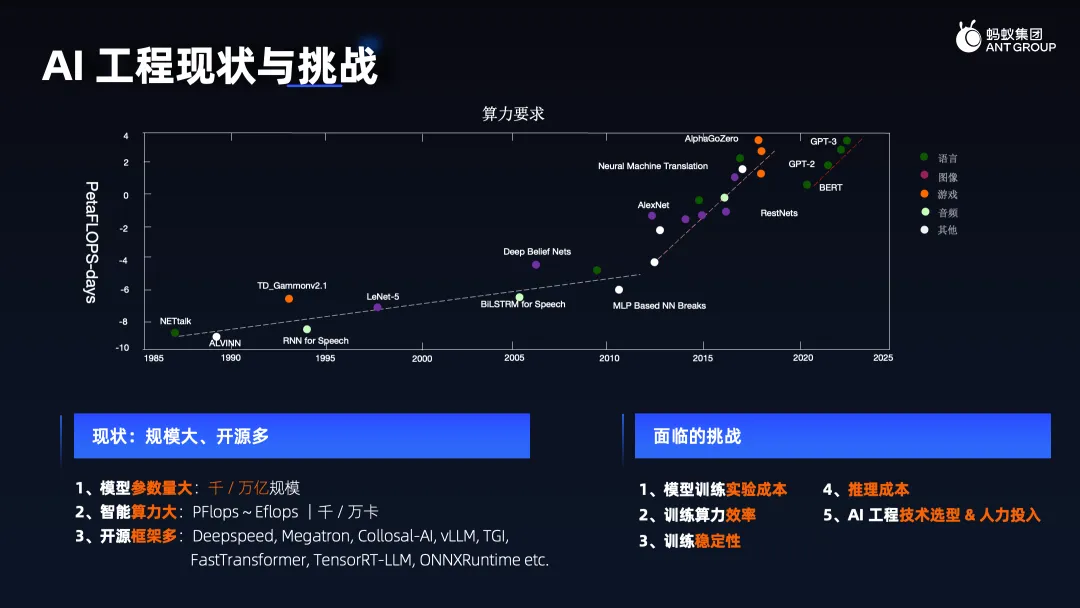
当前 AI 工程面临多重挑战:
首先,成本问题是首要痛点,无论是训练还是推理成本,尤其是 AI 训练的试验成本亟需降低。正如我们不希望核试验频繁操作,AI 模型训练同样期望降低试错成本,追求试验效率的最大化。此外,鉴于训练是一个长期且复杂的分布式系统运作过程,我们迫切要求训练过程高效且稳定,分布式系统的可靠性至关重要。
另一方面,面对众多开源框架和技术选项,AI 工程师在技术选型上面临巨大挑战,包括需要考虑开源技术与自研技术的权衡、如何在琳琅满目的开源资源中选择适合自身需求的技术路径等,同时,这也意味着企业在人力投入上需要深思熟虑,既要看准技术趋势,又要确保资源的有效利用。
蚂蚁 AI 工程实践
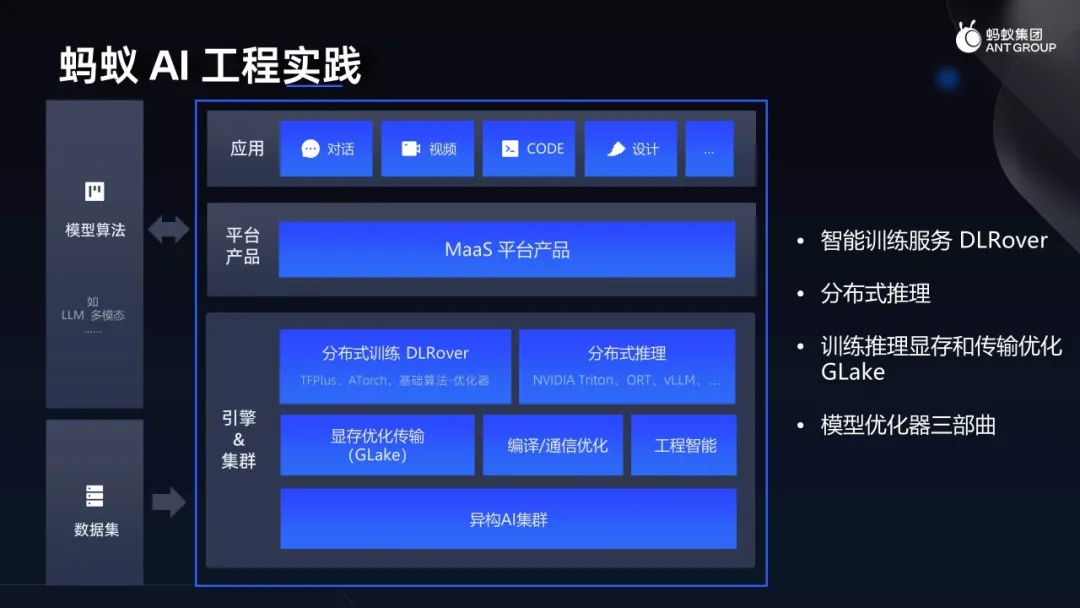
蚂蚁集团在 AI 基础设施建设中践行全栈战略,涵盖应用层、平台产品层、引擎框架和异构 AI 集群。本文将详细介绍这四个层面:首先,聚焦于我们发布的智能分布式训练服务 DLRover,其次,探讨我们在分布式推理场景中的实践经验,再者,介绍我们在显存优化与数据传输方面的工作成果 GLake;最后会分享我们在工程智能领域的具体工作,特别是模型优化器的基础算法研发。
其中,DLRover、GLake 以及模型优化器均已开源,欢迎 Star 关注:
- DLRover: https://github.com/intelligent-machine-learning/dlrover
- GLake: https://github.com/intelligent-machine-learning/glake
大规模分布式智能训练服务 DLRover
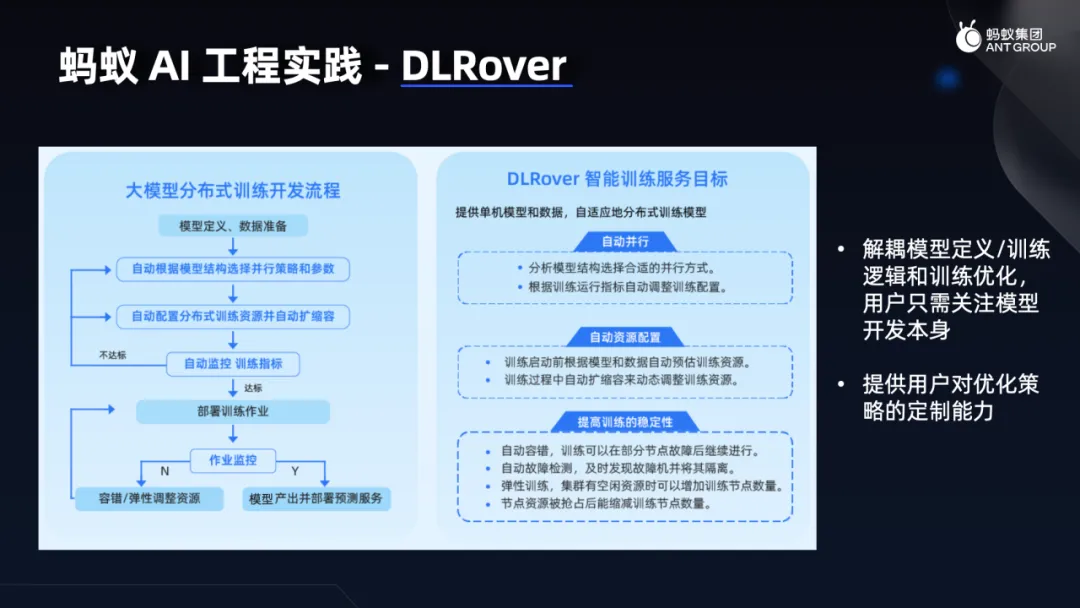
DLRover 是我们推出的专注于大规模分布式训练的智能服务。面对大模型分布式训练的反复迭代流程,DLRover 致力于解耦模型定义、训练逻辑与训练优化,以便算法工程师专注于核心的模型研发工作,同时赋予工程研发人员进行优化定制的能力。
DLRover 的设计初衷包括三个方面:
- 首先,实现自动并行,针对大规模分布式训练的并行调优,力求使各种并行策略高效协同,以达到最优效率。
- 其次,提供自动资源配置功能,减轻算法研发人员与硬件和工程参数交互的负担,让他们无需关心非专业硬件和工程参数设置,专注核心的算法研发。
- 最后是提升大规模分布式训练的稳定性,确保数千乃至数万个分布式节点在长达数月的运行过程中,始终保持长期稳定且高效的运行状态。
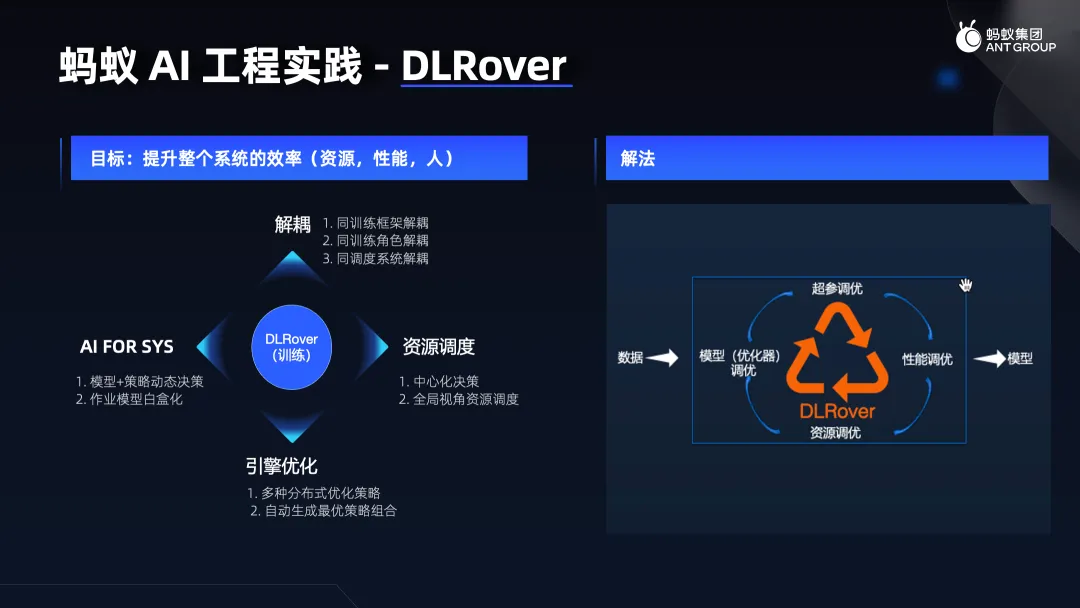
总结来说, DLRover 的核心目标还是在于提升整个系统的效率,包括资源、性能、人效。其关键特性表现为:
- 深度解耦:分离算法研发与训练框架的依赖关系,并减少训练角色及调度系统的耦合度,使算法工程师可以聚焦于算法创新,而非底层技术细节;
- 资源调度:采用中心化决策机制,具备全局资源视角,实时掌握大规模分布式训练任务以及集群整体资源使用状况,从而作出更优的资源调度决策;
- 引擎优化:DLRover 整合了多种分布式优化策略,并可以自动生成最优决策组合;
- AI for Sys:通过构建模型来智能决策最优策略组合,通过超参数调优训练性能,资源利用率,以及模型结构与效果,从而在训练过程达成综合性的优化任务。
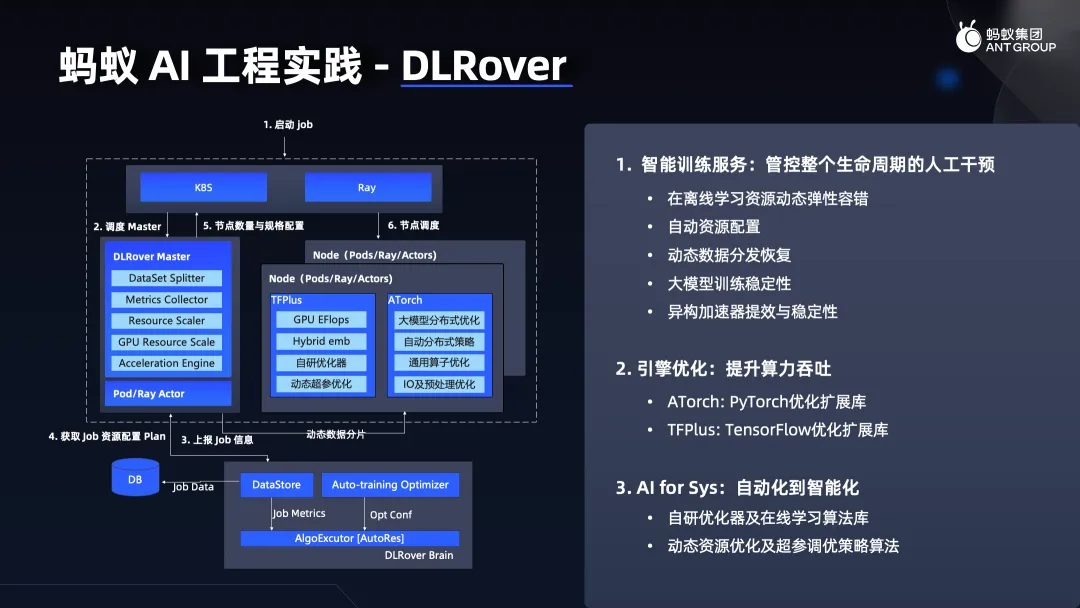
DLRover 的核心架构包括三个部件:
- 完整的服务模块;
- 引擎优化扩展库;
- 面向 AI 工程设计的优化,从自动化到智能化过程的算法库,服务于 AI for Sys 部分;
在整个训练服务流程中,DLRover 兼顾离线和在线训练需求,涵盖资源的动态弹性伸缩、容错机制、资源配置管理,以及对动态数据的高效分发与恢复。其中,动态数据的高效分发和恢复,会和容错机制、大模型训练稳定性提升模块、异构加速器提效和稳定性模块,配合使用。在引擎优化层面,DLRover 重点关注训练框架优化,以及 TensorFlow 的优化扩展,因为 TensorFlow 在大模型时代前,其应用较为广泛,尤其是搜推场景。为此,我们开发了 TensorFlow 优化扩展库 TFPlus,以及 PyTorch 优化扩展库 ATorch。这两个库均作为扩展组件,需与相应的 TensorFlow 或 PyTorch 版本配套使用,而非独立运行。至于 AI for Sys 部分,我们专注于自动化到智能化的转化,主要体现在自研优化器和在线学习算法库上。该算法库涵盖了处理数据延迟反馈、处理在线学习中数据漂移等问题。
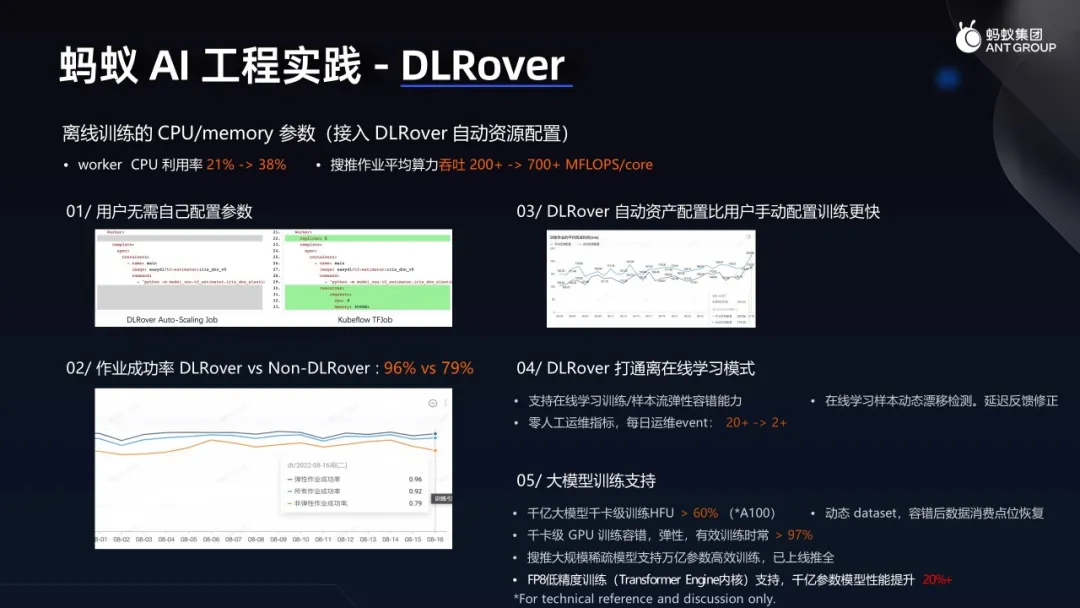
在蚂蚁集团内部,DLRover 智能训练服务的实际应用展现出显著的效果。
- 首先,其智能化程度已达到让算法用户无需手动配置任何与硬件相关的资源参数,诸如 CPU 数量、内存大小、GPU 数量及显存分配等,全部交由系统自动处理。
得益于 DLRover 集成的容错机制和弹性伸缩功能,训练工作的成功率实现了大幅提升,下图数据显示已达到 96%,实际最新数据更为出色。尤为值得一提的是,DLRover 的智能化配置相较于人工手动配置,在训练速度上展现出了明显优势,有效地缩短了训练周期。
- 此外,如下图右下角第五点,在大模型训练方面,DLRover 的表现同样引人注目。
面对千亿参数模型及千卡规模的并行训练场景,DLRover 能够实现高达 60% 以上的高性能指标 (HFU),并且这一数据仍在持续进步。而在稳定性方面,DLRover 确保了极高的有效训练时长占比,即仅计算模型真实起作用的时间,剔除无效及异常停机时间,目前可达到 97% 以上,最优情况下甚至能达到 99.4%,显示了卓越的训练稳定性。同时,我们也与 NVIDIA 合作,在 FP8 低精度训练上取得了一定的进展。
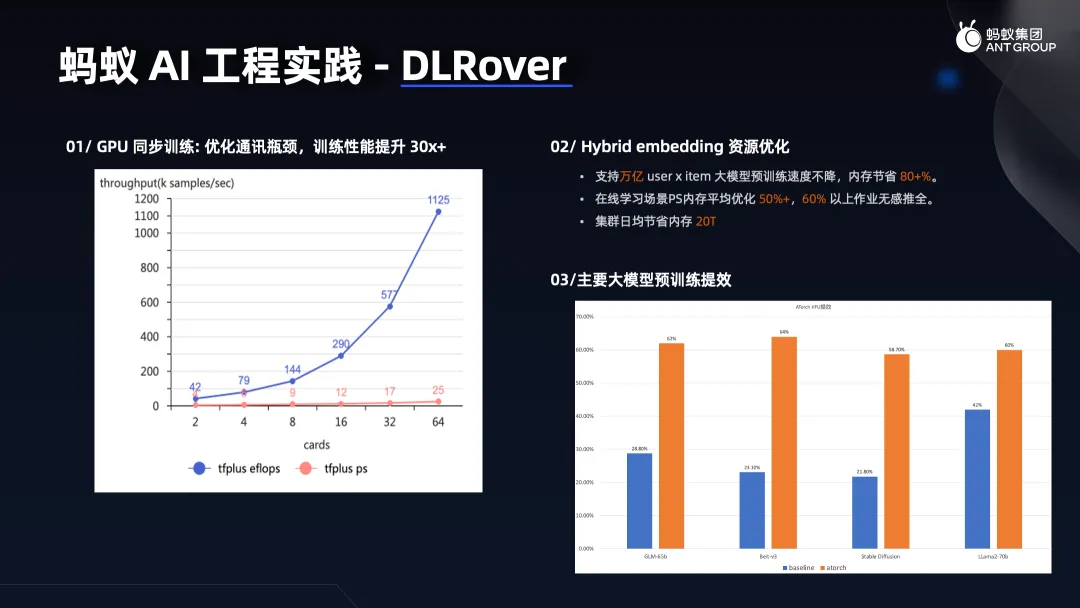
如下图所示,DLRover 的 TFPlus 扩展库通过引入 GPU 同步训练机制,尤其在稀疏模型训练场景下,性能提升效果十分显著。在 TFPlus 扩展库中,我们特地开发了 hybrid embedding 优化技术,针对稀疏 embedding 占用存储空间大且访问热度不均的特点,创造性地将 SSD 等存储介质融入其中,构建了一套分层的 embedding 存储方案。这套方案使得即便是处理万亿级别的大规模模型预训练任务,训练速度也能保持高效而不受任何影响。同时,内存使用量大幅削减,节省率高达 80% 以上,堪称是一项极为出色的优化工作。
分布式推理引擎
在 AI 推理引擎部分,下图展示的是一张详细的推理工程栈架构图,其中的组件包括前端、图优化、运行时及算子优化等,本文重点阐述蚂蚁集团在推理引擎建设中的技术选型和实践成果。
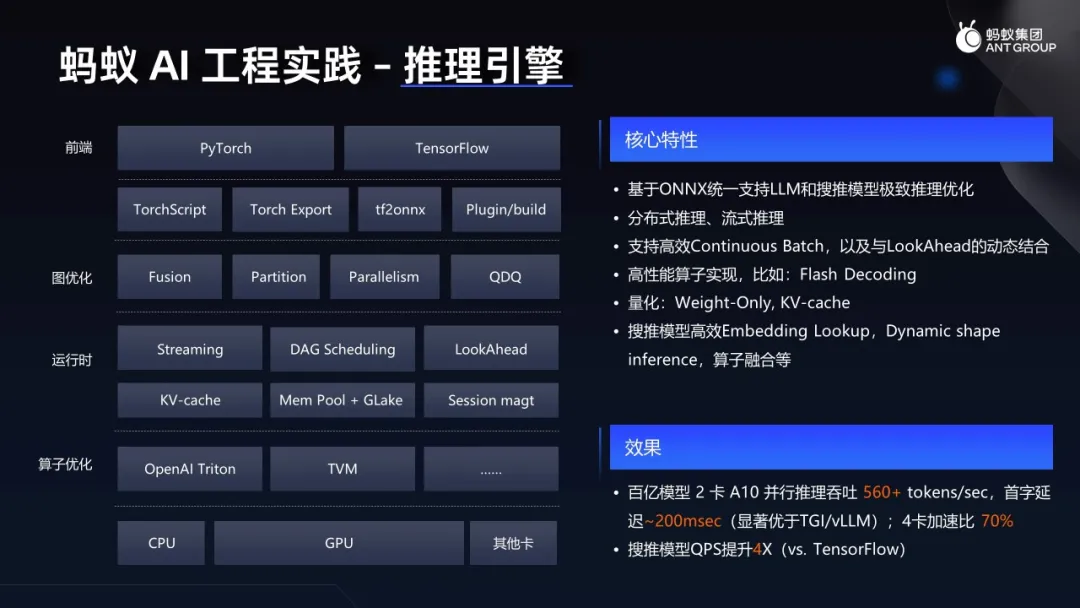
首先,我们采用 ONNX 路线,统一支持 LLM 和搜推模型推理优化。考虑到公司内部涉及多种训练框架如 TensorFlow 和 PyTorch,作为企业内的 AI 工程中台部门,需要兼顾各类模型的推理需求。因此,分布式推理、流式推理以及 Continuous Batching 和 LookAhead 等核心特性被纳入推理引擎设计中。其中,Continuous Batching 和 LookAhead 就是预先做 decoding,可以依据实际情况动态组合,以实现优秀性能。例如,在较高 Batching 情况下,LookAhead 的重要性相对减弱。此外,我们还实践了高性能算子,包括 FlashAttention、Flash Decoding 以及量化技术等,不断提升推理效率。就目前可以分享的成果显示,在百亿参数模型上,利用两张 NVIDIA A10 Tensor Core GPU 并行推理,我们能够实现每秒处理超过 560 个 tokens 的吞吐量,首响应延迟控制在 200 毫秒以内。并且这个数据并非最新成果,但展现出令人满意的多卡加速比和推理性能。
训练推理显存和传输优化 GLake
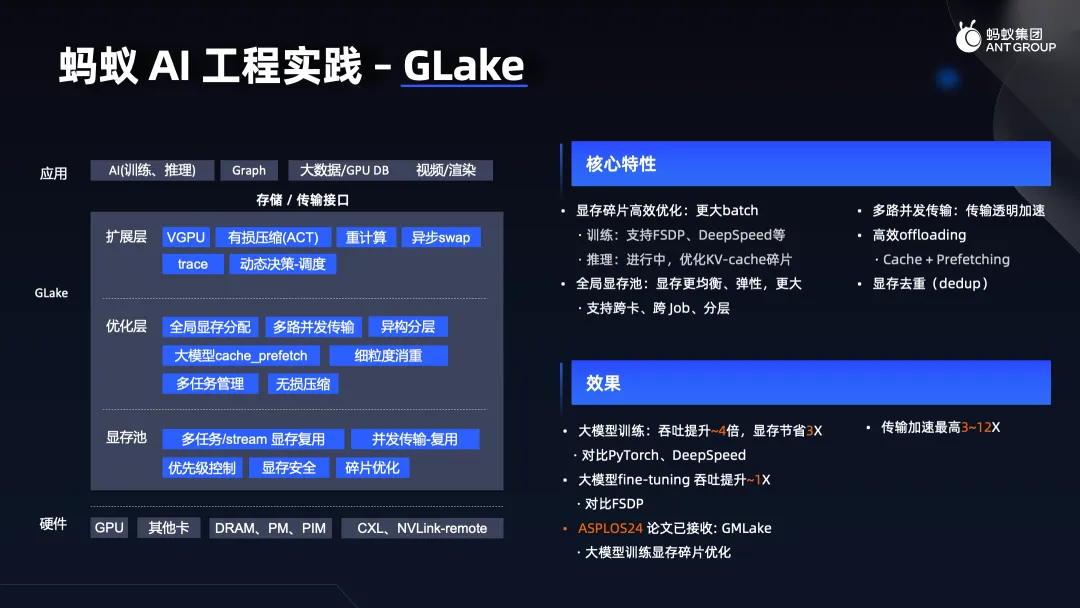
在显存优化与传输优化方面,我们开发了名为 GLake 的服务,并已有一篇论文《GMLake》被 ASPLOS24 收录。GLake 旨在实现显存池化、层次化管理和碎片优化,充分利用一台物理机内部多张 GPU 卡之间的高速互联,实现多路并发和提升数据传输速率。
经实践验证,GLake 在大模型训练场景下表现卓越,吞吐量提升了近四倍,使得 batch size 可大幅度增大,同时数据传输速率提高了 3 到 12 倍。相较于 PyTorch 和 DeepSpeed,采用 GLake 进行大模型做调优(fine-tuing)时,吞吐量也能提升大约一倍。值得关注的是,GLake 作为一个通用的加速库,能很好地与现有开源框架和工程项目协同,例如 DeepSpeed、NVIDIA Megatron-LM,vLLM 等。
模型优化器三部曲
最后,本文会介绍蚂蚁集团在工程智能领域的探索,特别是针对大模型训练的优化策略。这项工作最初起源于对普通模型训练过程的深入研究,包括如何通过工程与算法相结合的方式,优化资源利用、提升模型泛化能力和加速收敛进程。 为此,我们推出三种优化器,并且每种优化器都有一篇对应学术论文可供参考。
- 第一个优化器是 Group Optimizer,这是一种无损压缩技术,旨在节省资源。通过该优化器,模型能够实现 80% 以上的压缩率,且不影响模型性能,广泛适用于各类在线学习场景。
- 第二个优化器 WSAM 聚焦于提升模型泛化能力。我们知道,深度神经网络的泛化性能与其极值点的平坦程度密切相关。WSAM 通过将平坦度作为正则化项,以优化训练极值点的平坦度,从而有效提升模型的泛化能力。在某个落地营销场景,通过采用 WSAM 优化器,我们成功将整体 GMV 提升了近 30%。
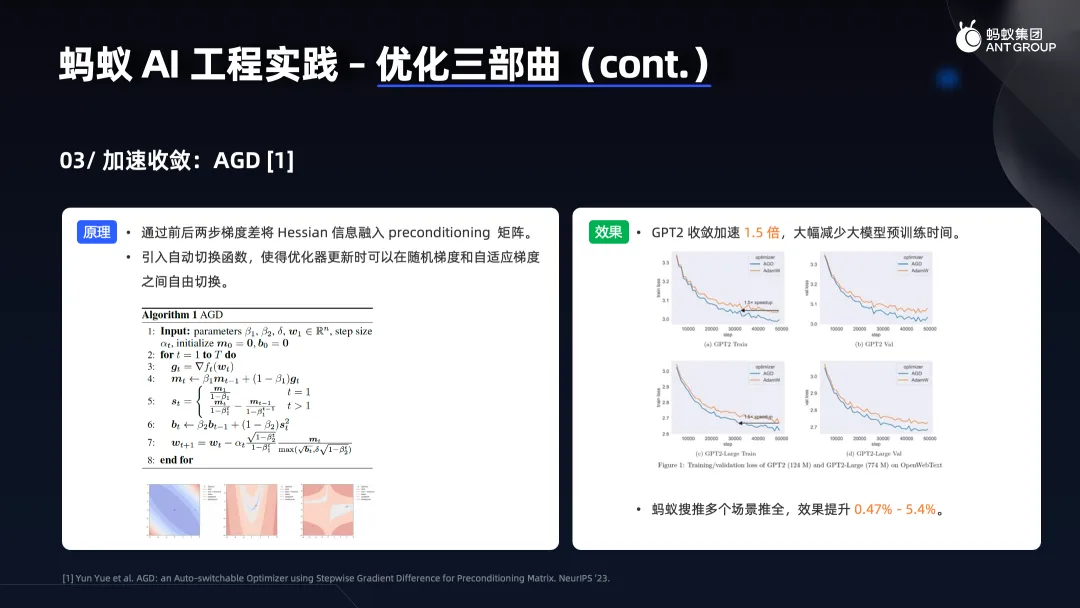
- 最后着重介绍用于加速收敛的优化器 AGD,之所以如此重视,是因为它与大模型训练的效率提升紧密相关。这款优化器旨在缩短模型训练时长,快速收敛至理想状态,同时保持良好的模型性能。其内在数学原理借鉴了拟二阶优化器的思想,以实现更高效的收敛速度。
在实际验证过程中,我们通过对 GPT-2 模型进行实验,收集数据来检验该优化器的效果。实验结果显示,在 GPT-2 模型上,该优化器能使收敛速度提升 1.5 倍。
开源共建 & 共享
在大模型技术迅速演进的时代,技术创新与工程实践的进步可谓瞬息万变,令每一位从业者应接不暇。我们认为,AI 领域的核心之一在于分享精神与共赢心态。随着算法的不断突破,必然伴随着工程层面的优秀实践涌现。在这个行业中,特别是在工程领域,很少有绝对保密或持久领先的秘诀。因此,倡导开源共建与共享显得尤为重要。我们鼓励所有从业人士,不论是产业界的实践者还是学术界的科研人员,积极参与进来,共同推动 AI 工程和 AI 基础设施建设的发展。通过分享各自宝贵的实践经验与研究成果,大家能够共同探讨、相互启发,共同提升整个行业的技术水平。
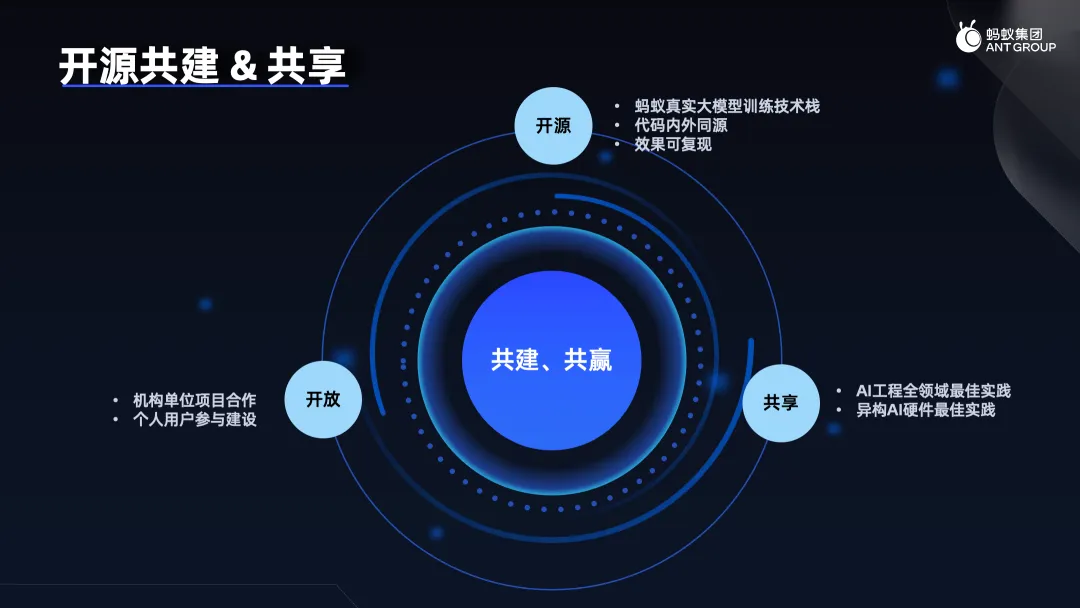
目前蚂蚁 AI Infra 团队已经开源了 2 个项目,帮助解决大模型训练过程中的工程问题,欢迎 Star 关注:
- DLRover,致力于通过提升深度学习训练过程的智能性,来解决整个系统的提效问题:
https://github.com/intelligent-machine-learning/dlrover
- GLake, 一个工作在底层(虚拟与物理显存管理)与系统层(包括多卡、多通道、多任务)的加速库以及相关工具集,旨在对 GPU 显存 + 传输进行一体优化:
https://github.com/intelligent-machine-learning/glake
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70036190/viewspace-3010649/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- OpenSPG/KAG v0.6 发布,兼顾事实推理与摘要生成,支持用户自定义 Schema
- 一位海外开发者的 OpenSPG KAG 实践分享
- AI工具百宝箱|CodeArena:开源编程语言模型代码对决平台,等你来战!
- KAG 技术与实践分享|基于 KAG 框架自主完成领域图谱构建和知识问答
- KG+RAG 系列范式对比及 KAG 框架再思考:兼看大模型增强 KBQA 问答竞赛方案
- AI 工具百宝箱|GenFM on ElevenReader,支持 32 种语言的 AI 播客,等你来体验
- AI工具百宝箱|任意选择与Chatgpt、gemini、Claude等主流模型聊天的Anychat
- 活动回顾 & PPT 下载|大模型背景下私域知识库的构建和可信问答 Meetup 完美收官!
- 蚂蚁 KAG 框架核心功能研读
- AI工具百宝箱|使用Deep Live Cam,上传一张照片就可以实现实时视频换脸...
