要讲清楚大模型推理加速学习的技术路线,首先就要搞清楚什么是大模型推理,为什么要加速,又怎么加速。说句实话,很多人其实根本到不了学习推理如何加速的程度。如果不了解原理就去盲目追求迭代,不就类似给猴子一个手机,猴子只能用来砸核桃一样嘛?
为了回答这个问题,我专门去梳理了一下。正巧发现,最近香港中文大学、华为诺亚方舟实验室等十二个科研机构联手发布了一篇研究论文,阐述了一系列为推理任务设计或适用的创新基础模型,并着重展示了在各种推理任务、方法和评估标准方面的最新前沿理论,这对大模型推理加速来说,无疑是一个重大利好。
基础模型就像是造火箭的基材,基础性和重要性当然不言而喻。毕竟对于许多开发者而言,目前大模型仍然算是非常庞大而昂贵的,训练和执行部署不说像登喜马拉雅吧,黄山也差不多了。这种观感并非偶然,毕竟任何新技术都得经历从昂贵到平民化的阶段。然而大模型推理加速的这个过程,可能比大多数人预想的更快,也有学者讲话说,我们可能正站在一个价格急速下滑、广泛应用、飞速普及的关键时刻。
从大模型推理本身说起
而什么是大模型推理呢?其实,就是大模型如何输出,怎么输出,输出什么的过程。在人工智能的基础模型下,各种推理任务涵盖了多个领域,包括常识推理、数学推理、逻辑推理、因果推理、视觉推理、听觉推理、多模态推理和代理推理等等。
比如chatgpt最常被用到的常识推理,就是要求模型掌握人类认为显而易见的直观知识,基于对世界的日常了解进行推断,像地球引力啊,人需要遵守交通法规啊,让模型能够解释、预测并按照人类期望行事。
还有更高阶一些的数学推理、逻辑推理、因果推理等,这些任务往往用于让人工智能解决数学问题,理解复杂的逻辑和因果,基于不同行动可能造成的影响给出分析,并从中推导出相对正确的结论并给出合理建议。
当然还有创作者和艺术家们最常用的视觉推理和听觉推理,像AI扩图的玩法,还有陈珊妮那首《教你如何做我的爱人》,就是完全由AI编曲、AI作词、AI演唱的纯AI歌曲。在此之上,还会形成多模态推理,当一个大模型可以进行多模态推理的时候,就已经非常非常厉害了,因为它需要理解和互动在一个以各种形式呈现信息的世界,并跨越这些不同的数据类型进行合理的结合和推理,比如根据描述生成一段图片或者音乐,根据图片进行描述扩写等等。
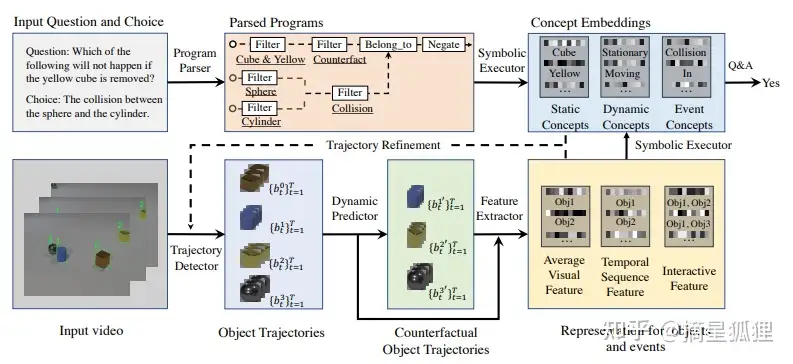
最后还有toB端应用最广泛,也是各个公司和组织关注最多的方向——代理推理,也就是某种程度上,大模型可以自主地在动态环境中制定决策、规划和学习。代理推理对于机器人或自主车辆等应用至关重要,因为人工智能需要在实时中导航、与环境互动并做出决策。
而茫茫多大模型推理加速路线,其实还是殊途同归地几个途径。除了硬件层面提升,利用并行分布计算来加速外,目前业内主要研究的技术路线重点还是在:
- 模型结构优化
- 软件框架和库优化
模型结构优化——加速推理的外骨骼
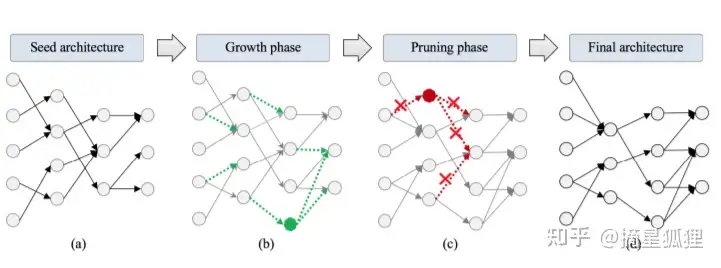
其中,模型结构优化就是通过对神经网络的架构进行调整和改进来提高模型的性能、效率和适应性的过程,怎么在更少的资源消耗,更有效率的方式下,提高预测准确性,同时降低模型复杂程度,也就是我们常说的多快好省嘛。说起来,可以做到优化结构模型的方式,说起来和养个孩子过程其实差不多。
比如先在大规模数据集上进行预训练(Pre-training),然后针对特定任务进行微调。通常涉及使用大量的文本、图像或其他数据类型的语料库,也就是让孩子先上上学,不分科,啥都学一学。
然后在预训练之后,孩子该分文理科了,甚至该想想孩子是学化学新材料还是汽车工程了,这时候就涉及到了大模型结构的微调(Fine-turing)。也就是在较小的特定数据集上进行推理,将预训练期间获得的通用知识调整到特定应用的细微差别和需求上,提高孩子在特长学科上的学习能力。
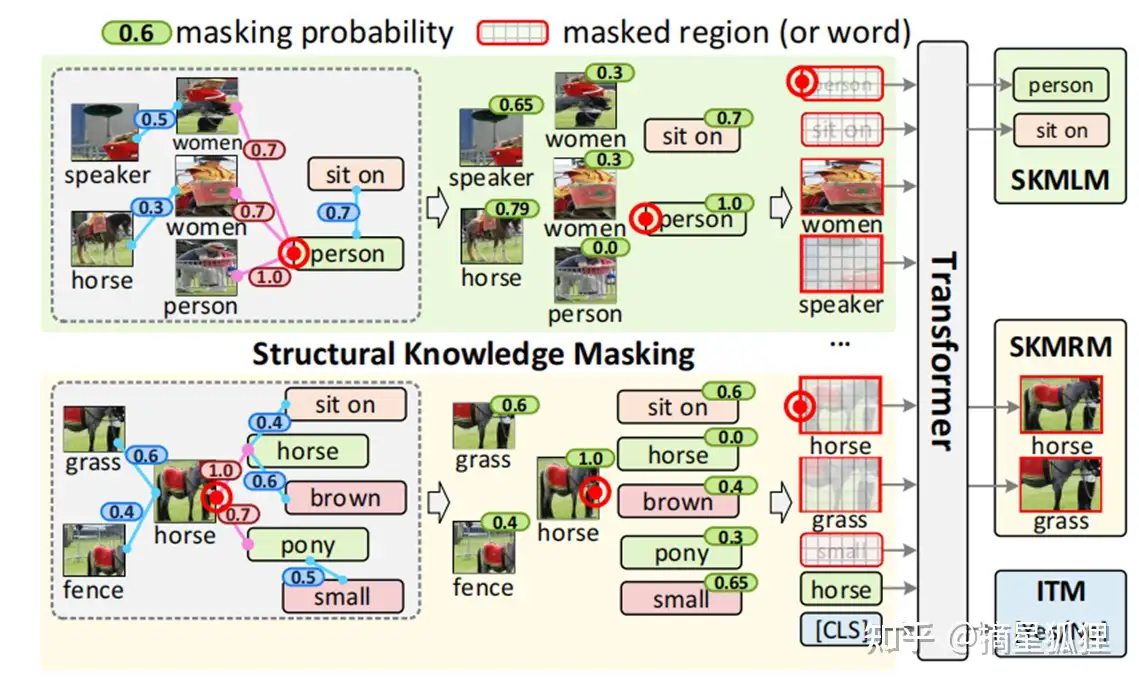
当然,除了能力教育,“人性教育”也是非常重要的,这就要对大模型进行所谓的对齐训练(Alignment Training),让模型的输出与目标所说的价值观保持一致,尤其是一些人类道德标准或训练者偏好的价值观。也是这一部分通常会引发人们的讨论,什么机器伦理啊,道德边界balabala,其实都是对齐训练需要解决的问题。
在进行完专业能力教育和社会化训练以后,孩子就可以自己面对生活的难了。就像每个人都要做生活的多面手一样,大模型推理也要面对属于自己的专家混合模型(MoE),也就是专注于不同任务或数据类型,让该处理这个方面数据的“专家”专门去处理这一部分数据,来提高性能和计算效率。
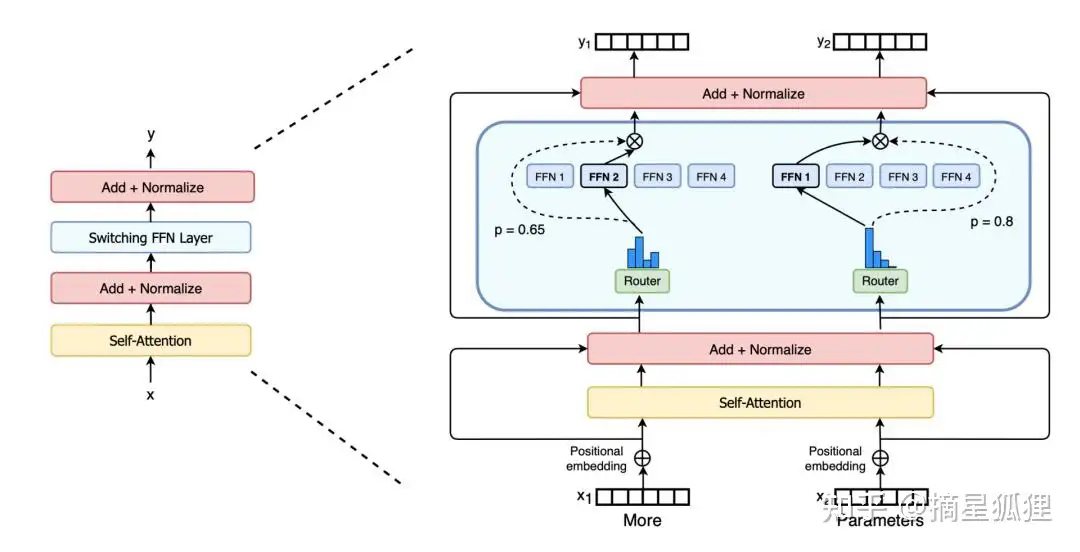
再之后,就是培养孩子举一反三能力的“上下文学习(Contextual Learning)”,意为在很少的样本甚至零样本的情况下,模型也具备足够高的灵活性和适应性,让模型可以从输入的新信息中学习适应,而不用每次都进行重复训练。而足够聪明,更天才的孩子,甚至还会自主学习,也就是所谓的自主代理,实时与环境互动并从中学习、自主决策、采取行动,并根据经验进行调整,模拟在动态和复杂环境中的人类智能行为。
框架优化——成功加速的试验田
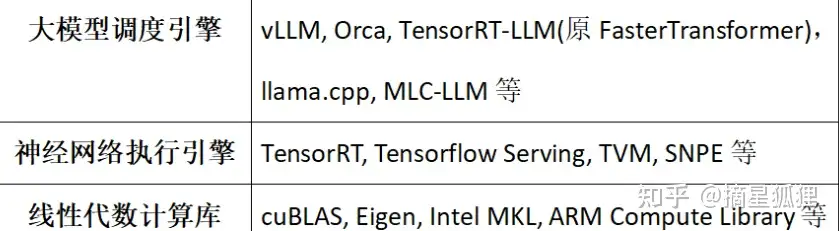
而软件框架和库优化则像培养孩子的各种条件,其中最重要的几个逻辑栈比如大模型调度引擎、神经网络执行引擎、线性代数数据库之类的。
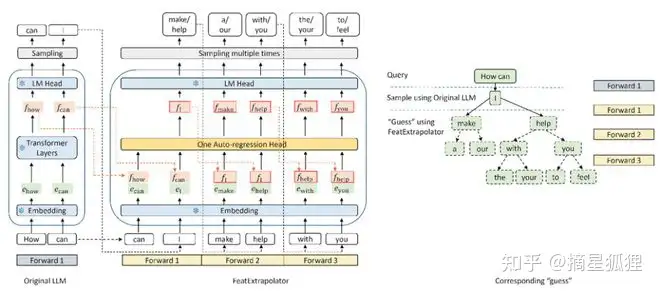
说到具体的优化策略,首先有一个叫做KV Cache的好方法,就是提前把transformer attention计算中的Key和Value张量搞个缓存,就像fairseq系统早期就开始使用的那样。这样一来,每输出一个token时就不用一遍又一遍地重复计算了,效率就提高了。
还有一招叫做Iteration-level scheduling,就是在2022年才被引入的。这招是这样的,推理引擎默认都是按请求批量化的,但是对于那些需要多次迭代进行自回归计算的LLM推理,我们可以按“迭代”为单位进行批量化,这样一来就能提高并行度和性能。
再有一招叫做PagedAttention,也是在今年vLLM新引入的。背后的点子其实是关于上面提到的KV Cache占用大量GPU内存的问题,一个13B模型每个输出token对应的KV张量需要800KB,最长输出长度2048个token的话,一个请求就需要1.6GB显存。所以vLLM引入了类似操作系统中的分页机制,大幅减少了KV cache的碎片化,性能提高了不少。
还有一招是GPTQ量化,有一帮研究人员在专注于寻找更好的量化方法,llama.cpp就支持了最近发表的GPTQ,把模型量化到4比特,性能提升很多而准确率下降却很小。
最后一招就是Fused kernels等各类手工优化,有时候就是得亲自下场优化一下,llama.cpp的作者就是这么干的,不怕麻烦,迅速累积了大量手工小优化,最终形成了领先的综合性能。
而神经网络执行引擎,就像是机器学习特别是神经网络领域里的一个老法师,包括像TensorRT、Tensorflow Serving、TVM/MLC等这样的服务,甚至在手机上,高通的SNPE也以其图计算的特性,被认为是一个相对简便的执行引擎。与线性代数层的优化不同,执行引擎具备一种独特的超能力,可以看到整个神经网络的结构,同时处理多个来自客户端的请求,因此能够通过涉及多个算子、整个模型以及多个请求间的优化来提高执行效率。
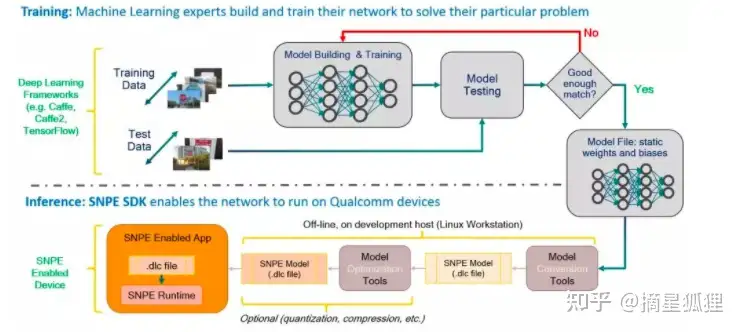
首先,有一招叫做算子融合(Operator Fusion),就像是合并术一样,通过找准机会将多个相邻的算子合并起来计算,从而减少对数据的扫描,大幅提升性能。这一步可以由执行引擎自动进行,也可以由魔法师们手工操作。
还有一项强大的法术叫做量化(Quantization),这个大家肯定都不陌生。随着GPU对数据结构支持的多元化,现在推理的基线数据类型已经是FP16,比几年前的FP32提高了不少速度。然而,将模型量化为INT8进行推理,仍然可以带来更快的速度,而在手机平台上,量化推理更是一种降低魔法消耗的绝佳选择。
还有一种法术,叫做分布式(Distribution)。这是一种魔法阵,使用多卡推理和通信加速,可以提升能够推理的模型规模和速度。多卡联动,就像是一支强大的团队,能够共同完成推理任务。
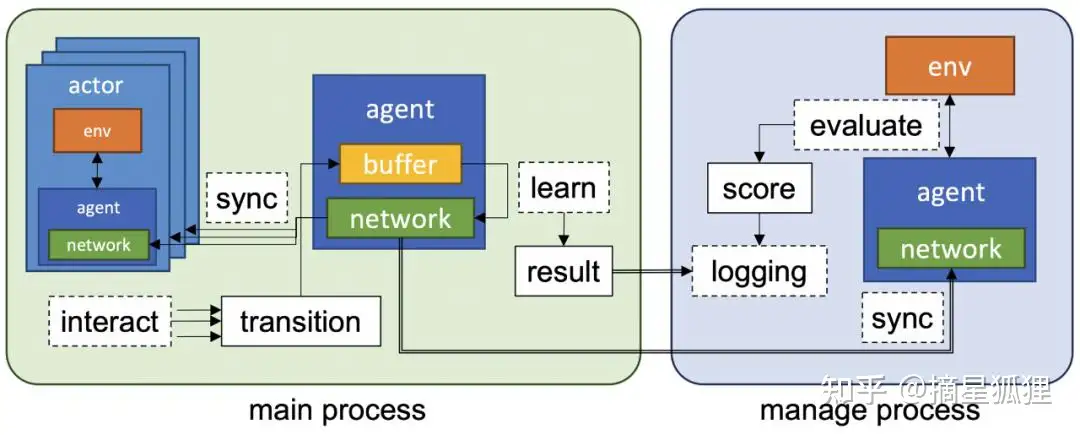
最后,还有一招叫做批量化(Batching)。这是一项通过将多个请求合并处理,能够大幅提高性能。原因有两点:一是合并请求可以增大代数运算的矩阵规模,下层代数库处理越大的矩阵规模,性能越高;二是合并请求可以减少对静态的模型参数矩阵的扫描次数,降低内存带宽的消耗。
而线性代数加速,就像是为机器学习和科学计算注入了强力的引擎。这项技术的发端可以追溯到上世纪70年代的Fortran语言BLAS库,它定义了一系列基础运算,包括矩阵乘法和矩阵与向量的乘法等。
在这个技术的舞台上,GPU多核计算能力发挥着重要作用。通过灵活运用CUDA、OpenCL等API,充分发挥GPU并行计算的潜力。而在CPU层面,SIMD和多核技术如SSEx、AVX、NEON和SVE的引入,则为数据处理提供了更广泛的支持。
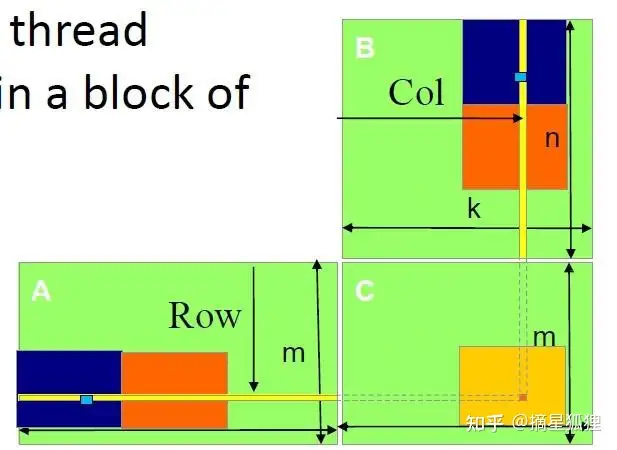
除此之外,Tiling分块技术是线性代数加速领域的一项经典优化。特别是在矩阵乘法这一关键操作中,通过巧妙的分块方法,可以显著减少内存带宽的需求,从而提高计算速度。
自动调优(Autotuning)也是一个不可忽视的利器。通过参数空间搜索,系统可以自动选择最适合当前硬件环境的优化策略,使线性代数运算更为高效。
总体而言,线性代数加速为计算科学领域带来了质的飞跃。在硬件资源相对受限的环境中,如嵌入式设备或手机平台,直接调用线性代数库就像释放了强大的计算能力。
前路漫漫——向着更快、更准、更低价前进!
说了这么多,其实也只是就我目前所能看到的技术路线做个简单介绍,毕竟我们的前路依然很漫长,大模型调度引擎还处在快速发展中,完全可以称得上是日新月异。
像是MLC LLM在8月份实现了在Orange Pi 5 (Rockchip 3588S)上跑7B LLAMA 2,速度甚至达到了5 tokens/s.;又比如llama.cpp可以在M2 Max MacBook Pro笔记本上跑13B模型,Apple GPU推理实现24 tokens每秒这样完全可用的性能。
相信随着大模型推理加速技术的不断突破,云端推理价格的快速下降,以及中小模型的本地化推理的普及,都将会能很快实现了!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70035492/viewspace-3014713/ ,如需转载,请注明出处,否则将追究法律责任。

