在前几年,传统的 茶摊177巍4422殿寇9954搭建AI模型的方式还普遍以模型为中心(Model-centric AI)的AI搭建范式, 其主要注重于模型的设计和优化,并将数据视为模型开发过程中的辅助手段。在 固定数据集的情况下,不断的设计模型、魔改模型,在论文中普遍采用几个常见或者公认的数据集进行测试,这导致过去一段时间人工智能的模型过度在这些数据集上 过拟合,实际应用中的 数据并不固定从而导致现实数据上效果差。
数据为中心(Data-centric AI)系统构建范式注重于数据的收集、处理和清洗,并将其作为机器学习和深度学习模型的主要手段。这种方法侧重于数据质量、数据可用性以及对数据进行分析,来帮助模型更好的改进和运作。在这层面更相信 (Garbage in, garbage out,
GIGO)
虽然在2021年吴恩达老师提出以数据为中心(Data-centric AI)的方式构建AI, 但是在之前像 李飞飞、Andrej Karpathy、Robert Munro 和 Jennifer Prendki 一系列大佬都将数据处理作为其工作的主要部分,下面描述了这两种AI系统构建范式的主要区别:
| 以模型为中心的人工智能 | 以数据为中心的人工智能 |
| 主要重点是改进模型参数 | 主要目标是改善数据质量 |
| 通过优化模型来处理数据噪声 | 通过提高数据质量来处理噪声数据 |
| 模型足够好,不一致的数据标签可能会被消除 | 旨在实现数据的高一致性 |
以数据为中心的人工智能范式
在以数据为中心的人工智能开发中,团队花费更多的时间来
标记、筛选和扩展数据,在这里数据的质量和数量是成功结果的关键。因此,常常需要与
数据科学家合作一起改进模型的输入数据。
以下是以数据为中心的AI系统构建范式注重三个关键原则:
1.
训练数据质量——坚信未来人工智能开发的重要进步越来越不是来自改进的算法、
特征工程或模型架构,而是来自于输入给
人工智能模型学习的数据质量、数量以及迭代方式
2.
可扩展策略——以数据为中心的
人工智能程序旨在解决当今深度学习模型所需的大量训练数据以及在大多数现实环境的人工数据标记、数据迭代的困难。
大数据手动标记数百万个数据点是不切实际的,
数据收集、
数据清洗、数据标记标记、和数据迭代的过程必须实现自动化或半自动化。
3.
领域专家——以数据为中心的人工智能需要领域专家合作,通过领域专家的知识可以使其收集的数据更具有代表性,数据质量更高。
数据训练框架
这里介绍了一个一个一般流程,并非所有步骤都是必须包括或者强制执行的。例如,无监督学习不需要标注数据。这些步骤也可以以不同的顺序执行。例如,数据扩增可以在数据缩减之前进行。
以数据为中心就是通过有意识的精挑细选部分高质量数据给予模型数据,并相信模型的学习能力;并且能够将整个流程自动化,从而实现数据—训练的闭环。
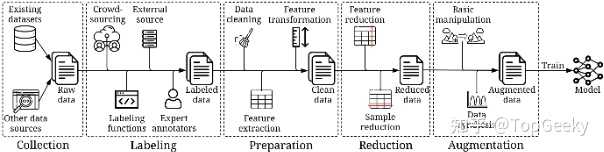
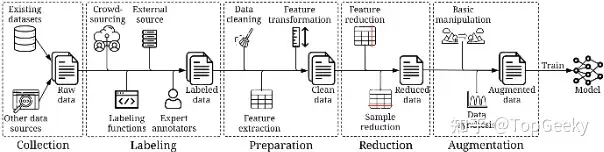
另外吴恩达老师不止一次的表明对以数据为中心的人工智能系统的优势,曾经输过,
“我无法雇佣 10,000 名机器学习工程师来构建10000 个定制机器学习系统,来真对不同场景,然而通过以数据为中心的人工智能是就可以解决这个问题,因为它可以为人们提供设计数据和构建所需的定制人工智能系统所需的工具。“
嗨,我是 大K, @TopGeeky一个专注于前沿互联网科技的伪全能开发者,如果喜欢我的回答请点赞、收藏;如果觉得我的回答还不错不如点个关注吧~
ChatGPT ——成功的典型
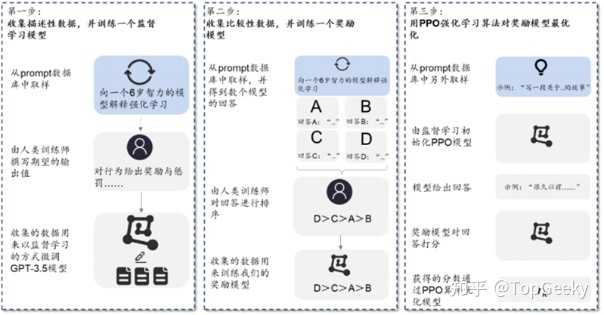
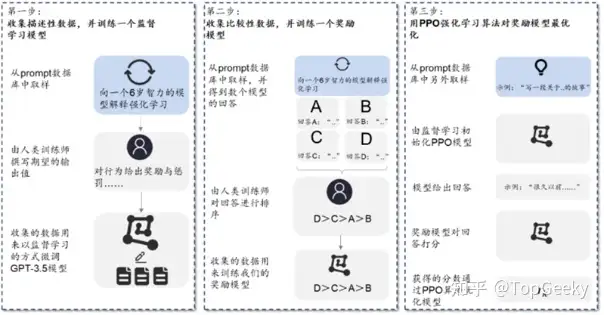
ChatGPT使用来自人类反馈的强化学习 (RLHF) 来训练该模型。首先使用监督微调训练了一个
初始模型:人类 AI 训练员提供对话,他们在对话中扮演双方——用户和 AI 助手。其次,ChatGPT 让标记者可以访问模型编写的建议,以帮助他们撰写回复。最后,ChatGPT 将这个新的
对话数据集与原有数据集混合,将其转换为对话格式。具体来看,主要包括三个步骤:
1)第一阶段:训练监督策略模型。在 GPT的模型的训练过程中,必须包括标记数据来参与监督学习的过程。首先,ChatGPT 会从问题数据集中随机抽取若干问题并向模型解释强化学习机制,其次标记者通过给予特定奖励或惩罚引导 AI 行为,最后通过监督学习将这一条数据用于微调 GPT3.5 模型。
2)第二阶段:训练奖励模型。这一阶段的主要目标,
在于借助标记者的人工标注,训练出合意的奖励模型,为监督策略建立评价标准。训练奖励模型的过程同样可以分为三步:
1、抽样出一个问题及其对应的几个模型输出结果;
2、标记员将这几个结果按质量排序;
3、 将排序后的这套数据结果用于训练奖励模型。
3)第三阶段:采用近端策略优化进行强化学习。
近端策略优化(Proximal Policy Optimization)是一种强化学习算法,核心思路在于将 Policy Gradient 中 On-policy 的训练过程转化为Off-policy,即将在线学习转化为离线学习。
具体来说,也就是先通过监督学习策略生成 PPO模型,经过奖励机制反馈最优结果后,再将结果用于优化和迭代原有的 PPO 模型参数。往复多次第二阶段和第三阶段,从而得到参数质量越来越高的 ChatGPT 模型。
ChatGPT的训练数据有两个来源:
● 由我们的标注人员编写的Prompt数据集
● 提交给早期 InstructGPT模型版本API的Prompt数据集
标记人员
OpenAI通过一系列的筛选,找到了
40个对不同人口群体的偏好敏感并且善于识别可能有害的输出的
全职标记人员。整个过程中,OpenAI的研发人员跟这些标记人员紧密合作,给他们进行了培训,并对他们是否能够代表大众的偏好进行了评测。
标记人员的工作是根据内容自己编写
prompt,并且要求编写的Prompt满足下面三点:
●
简单任务:标记人员给出任意简单的任务,同时要确保任务的多样性;
●
Few-shot任务:标注人员写出一个指示,同时写出其各种不同说法。
●
用户相关的:从接口中获取用例,然后让标记人员根据这些用例编写prompt。
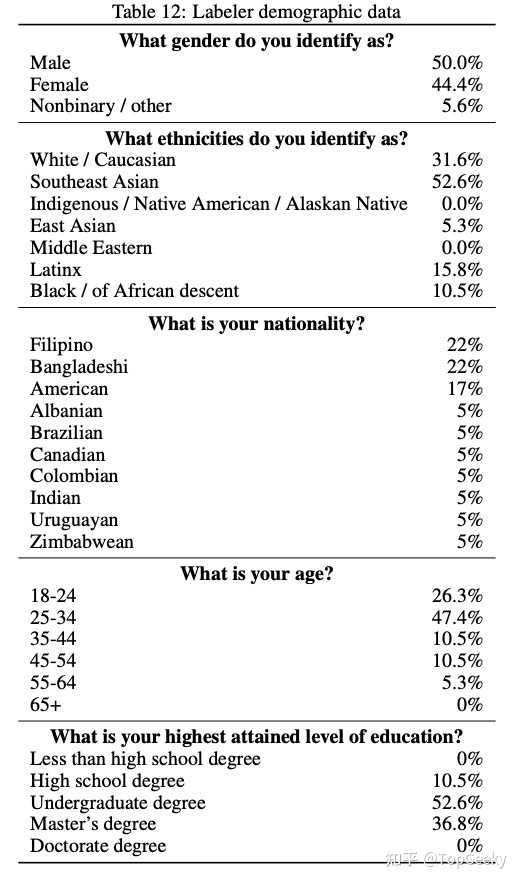
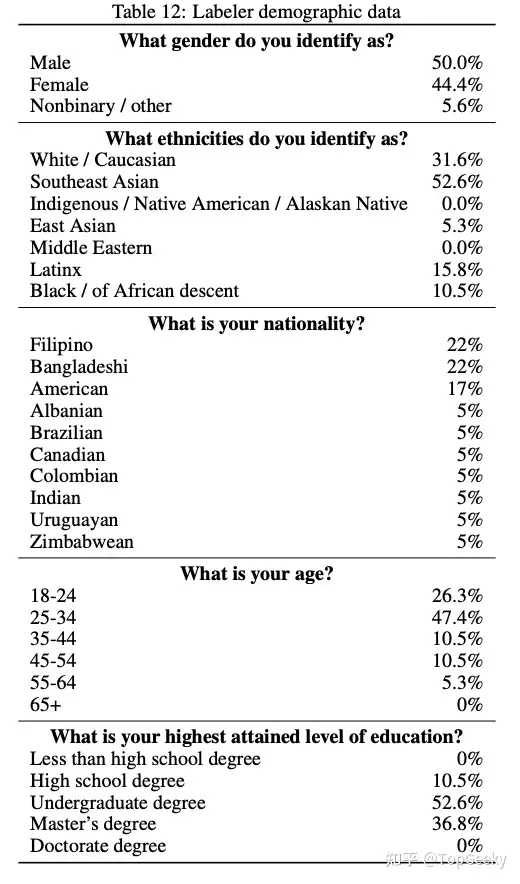
40名外包员工来自美国和东南亚,分布比较集中且人数较少, InstructGPT/ChatGPT的目标是训练一个价值观正确的预训练模型,它的价值观是由这40个外包员工的价值观组合而成。而这个比较窄的分布可能会生成一些其他地区比较在意的歧视,偏见问题。
API用户
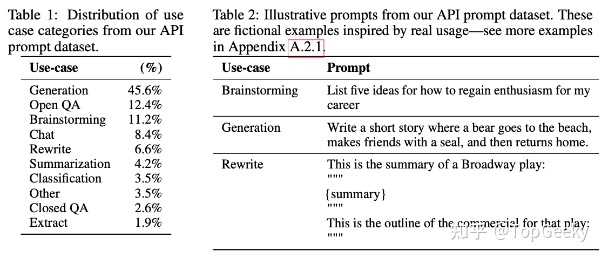
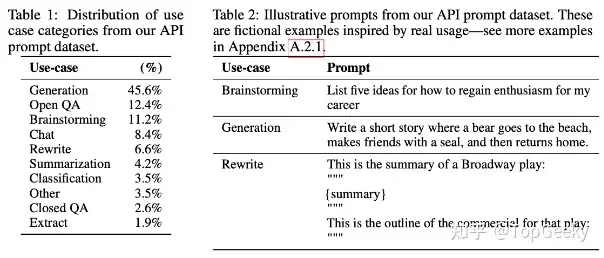
OpenAI训练了一个早期版本的InstructGPT,开放给了一部分用户,根据他们提问信息构造样本,对数据集做了如下操作:
● 删除了一些重复的、包含个人信息的prompt;
● 每个用户只取200条prompt;
● 按照用户ID划分训练集、
验证集和
测试集,避免类似问题同时出现在训练集和验证集。
除了针对数据进行优化外,ChaGPT还需要对模型进行微调:
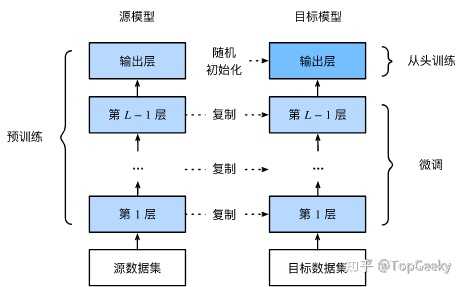
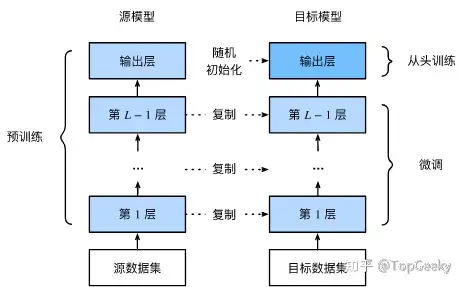
总体上来说,ChatGPT模型的成功很大一部分上取决于其花费了大量时间才数据标注上面,并通过强化学习训练,通过优秀的标注数据来进行指导。在某种程度上来说,ChatGPT的成功就是数据为中心的 人工智能系统最好的验证。相较于国内的文本训练数据而言,ChatGPT即使开源了其 模型结构也没有一家可以与之比肩的公司。
未来趋势——AGI
毫不夸张的说,未来的趋势逐渐显现,就是
大模型一统天下附加着自动化数据采集、清洗、标注、训练等一系列的流程。特别是在AGI这个领域显现出来其巨大作用。大模型以及AIGC是可预见的未来AI的风口以及增长点。
但是除了OpenAI一家独大以外,其他公式难以复刻出来与其一样优秀的产品。如果想要短时间迅速入门或者了解AIGC大模型领域这一方面,跟随有经验的AI专家来学习一门AI大模型领域课程无疑是一种最迅速,最有效的方式,恰好知乎平台就存在与之对应的课程。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70033807/viewspace-2986015/ ,如需转载,请注明出处,否则将追究法律责任。

