在Python爬虫实战(1) | 爬取豆瓣网排名前250的电影(上)中,我们最后爬出来的结果不是很完美,这对于“精益求精、追求完美的”程序猿来说怎么能够甘心
所以,今天,用python爬取豆瓣网排名前250的电影 进!阶!版!他来了!
我们在爬取豆瓣网排名前250的电影(上)中用到了 urllib 模块和 re 模块用来进行获取网页信息和解析内容。
俗话说:“工欲善其事,必先利其器“。今天,我要着重介绍一下两个全新的模块,这两个模块能让我们的爬虫体验更好,更易上手。
通常情况下,Python官方提供的“电池”都是最可靠和实用的——除了 urllib。因为在Python社区,有一个比Pyhotn“亲儿子” urllib 还好用的HTTP库——Requests。
Requests简化了 urllib 中的诸多冗杂且无意义的操作,并提供了更强大的功能。
安装
建议在Windows命令行窗口进行下载。首先按住win+R键打开命令行窗口,并在里面输入
pip install requestsGET请求
最基本的get请求可以直接用get()方法
response = request.get("http:///")或response = requests.request("get", "http:///")
添加头部headers和 url 参数
例如:我现在想在百度搜索咸鱼二字,输入之后回车我们可以看到我们的url是这样的
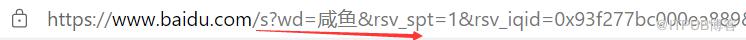
如果想添加headers,可以传入headers参数来增加请求头中的headers信息
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}url = "http:///"response = requests.get(url, headers=headers)
如果要将参数放在url中传递,可以利用
params参数
kw = {"wd": "咸鱼"}url = "http:///s?"response = requests.get(url, params=kw)
由于这部分知识内容比较多,下期会专门出一个专题来介绍它
我相信大多数人第一眼看到这个模块,心想:靓汤?美丽汤?这个可不是广式老火靓汤
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库,能够通过你喜欢的转换器实现惯用的文档导航,,查找或者修改文档的方式
安装
建议在Windows命令行窗口进行下载。首先按住win+R键打开命令行窗口,并在里面输入
pip3 install bs4
解析器
Beautiful Soup支持Python标准库中的HTML解析器,还支持一些第三方的解析器,其中一个是 lxml,所以请安装好lxml
pip install lxml另一个可供选择的解析器是纯Python实现的 html5lib , html5lib的解析方式与浏览器相同,可以选择下列方法来安装html5lib:
pip install html5lib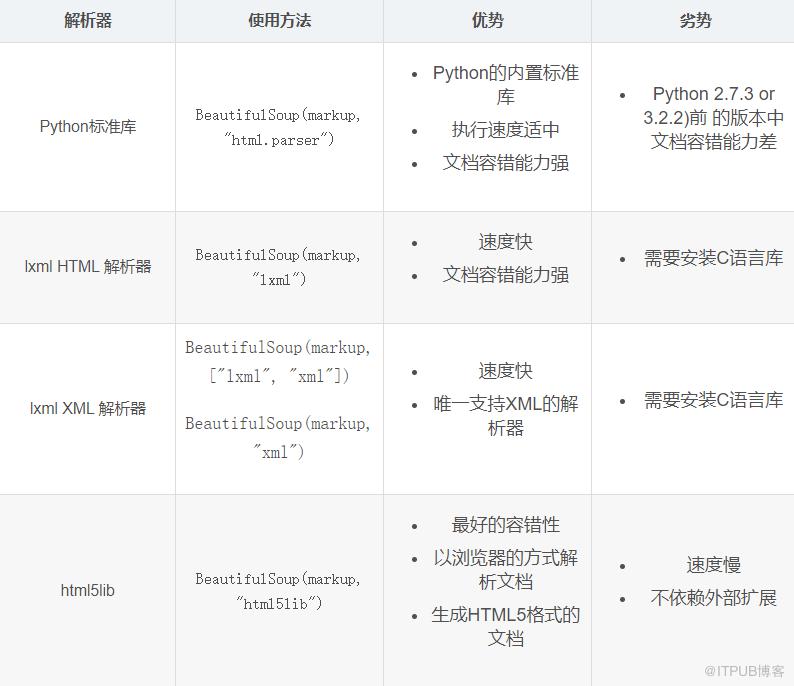
Beautiful Soup将复杂HTML文档转换成一个复杂的树形结构,每个节点都是Python对象
所有对象可以归纳为4种: Tag , NavigableString , BeautifulSoup , Comment
Tag
标签:通常是包含在<>里面的
有两个重要的属性:name (名字)和 attrs(属性)
每一个tag都有自己的name,例如
# 获取nameimport bs4html = '''<html><head><title>Test Html</title></head>'''# 选择使用lxml作为解析器soup = bs4.BeautifulSoup(html, 'lxml')# 获取nameprint(soup.title.name)print(soup.head.name)

我们可以使用.attr 获取到Tag对象的所有属性值(attrs),返回的是字典格式,所有可以使用['key'] 来获取指定的属性值。简单一点我们也可以省略attrs,直接使用tag['key'] 来获取。
import bs4html = '''<ul><li class="item-0" name="one"><a href="">baidu</a>'''# 选择使用lxml作为解析器soup = bs4.BeautifulSoup(html, 'lxml')# 获取li节点所有属性,返回字典形式print(soup.li.attrs)# 获取li节点的class属性值print(soup.li.attrs['class'])print(soup.li['class'])print(soup.li.get('class'))# 获取a节点所有属性print(soup.a.attrs)# 获取a节点的class属性值print(soup.a.attrs['href'])print(soup.a['href'])print(soup.a.get('href'))
答案:
{'class': ['item-0'], 'name': 'one'}['item-0']['item-0']['item-0']{'href': ''}
我们还可以获取节点内的文本内容(string),默认获取第一个
import bs4html = '''<ul><li class="item-0" name="one"><a href="">baidu</a><li class="item-1" name="two"><a href="">alibaba</a>'''soup = bs4.BeautifulSoup(html, 'lxml')#获取属性print(soup.a.attrs)获取节点内容print(soup.a.string)print(soup.a.string)
答案:
{'href': ''}baidu
上面选择节点的方法太单一了,不适合实际开发使用。Beautiful Soup提供了一些查询方法供我们使用
find_all()、find()
find_all()
find_all() 方法搜索当前tag的所有tag子节点,并判断是否符合过滤器的条件
find_all( name , attrs , recursive , text , **kwargs )
name:查找所有名字为 name 的tag,串对象会被自动忽略掉
attrs:根据属性查询,使用字典类型
text :可以搜搜文档中的字符串内容,与 name 参数的可选值一样, text 参数接受字符串 , 正则表达式 , 列表, True 。
recursive:调用tag的 find_all() 方法时,Beautiful Soup会检索当前tag的所有子孙节点,如果只想搜索tag的直接子节点,可以使用参数 recursive=False
limit:find_all() 方法返回全部的搜索结构,如果文档树很大那么搜索会很慢.如果我们不需要全部结果,可以使用 limit 参数限制返回结果的数量。效果与SQL中的limit关键字类似,当搜索到的结果数量达到 limit 的限制时,就停止搜索返回结果
find()
find_all() 方法将返回文档中符合条件的所有tag,尽管有时候我们只想得到一个结果。比如文档中只有一个标签,那么使用 find_all() 方法来查找标签就不太合适,
使用 find_all 方法并设置 limit=1 参数不如直接使用 find() 方法.下面两行代码是等价的:
soup.find_all('title', limit=1)soup.find('title')
唯一的区别是 find_all() 方法的返回结果是值包含一个元素的列表,而 find() 方法直接返回结果
find_all() 方法没有找到目标便返回空列表, find() 方法找不到目标时,返回 None
推荐使用lxml解析库,必要时使用html.parser
标签选择筛选功能弱但是速度快
建议使用find()、find_all() 查询匹配单个结果或者多个结果
如果对CSS选择器熟悉建议使用select()
记住常用的获取属性和文本值的方法
俗话说:“你学的知识都是别人跟你讲述的,你只有亲自实践,才能将其转化为自己的”
在大概了解了这两个模块的相关知识之后,我们来进行实战
开发环境:
python3.9
pycharm2021专业版
我们先观察网页,看看它的url规律:
第一页: https://movie.douban.com/top250?start=0&filter=第二页: https://movie.douban.com/top250?start= 25&filter=第三页: https://movie.douban.com/top250?start= 50&filter=
不难看出,页数每次加1,url里面start的值就加20,-共有10页,start的值 最大为225。这是因为1页里面有25部电影。一共有10页,也就是250部电影。
按F12打开开发者工具,找到Elements,进行网页内容的分析
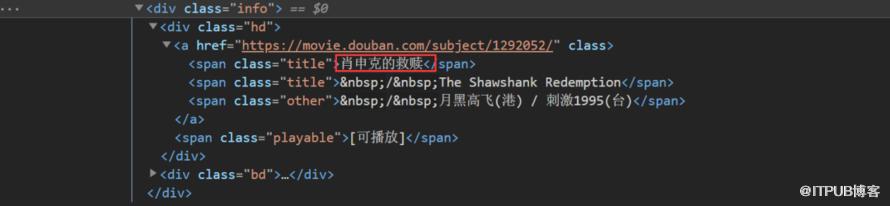
我们可以看到,电影的名字就在<div class=“info”>...</div> 标签中的<div class=“hd”>...</div> 里面
其从属关系为:div ——> a ——> span
而我们这次加大难度,顺便将电影信息也爬取下来。我们来看一下电影的信息存放在哪个标签里面
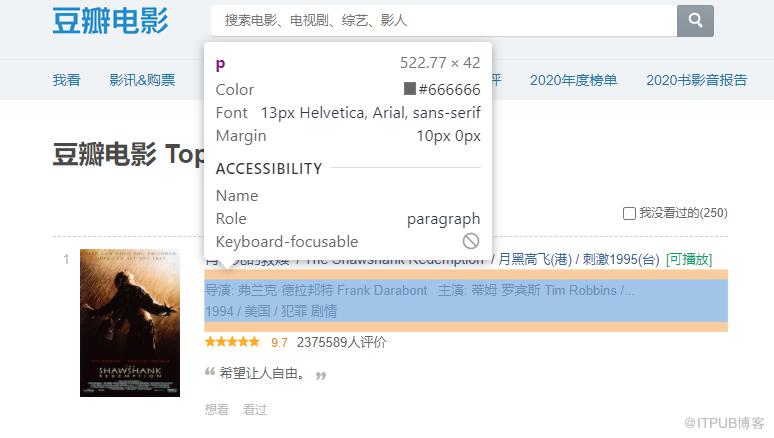
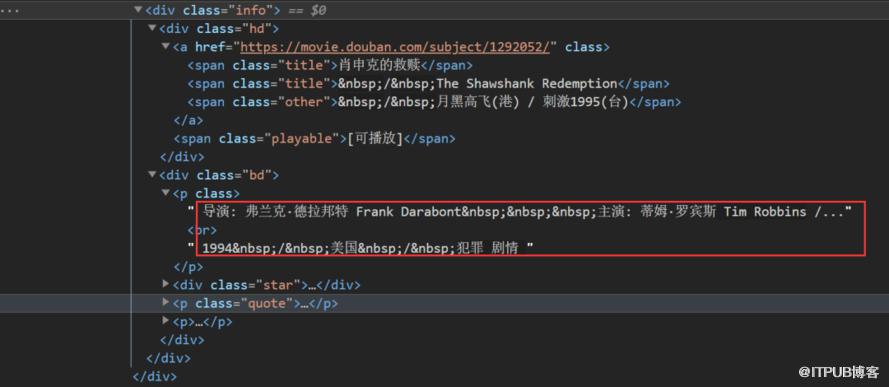
可以看到,电影的一些描述信息都在<div class=“info”>...</div>标签中<div class=“bd”>...</div>的里面
其从属关系为:div ——> p
所以我们可以先调用 find_all()方法,将属性为 class=“info“ 的 div 标签一一找出来,并返回一个列表
再从这个列表当中找到我们的电影名字和描述信息
根据URL规律来指定我们爬取网页的顺序
if __name__ == "__main__":"""网页地址为:https://movie.douban.com/top250"""pages = 0while pages <= 225:url = 'https://movie.douban.com/top250?start=%s' % pagesprint("正在爬取数据..........")pages += 25download_list(url)print("爬取完毕!")
使用网页下载器来获取网页
为了防止网站有反爬虫机制,我们将爬虫模拟成一个浏览器,并设置了访问时间间隔
def get_pages(url):headers = {"User-Agent": 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.77 Safari/537.36 Edg/91.0.864.41'}try:'''模拟浏览器,时间间隔'''response = requests.get(url=url, headers=headers, timeout=5)except requests.exceptions as e:print('error')finally:content = response.text #返回解码后的html内容return content
使用bs4模块来对获取到的网页内容进行解析
def get_movies(contents):soup = bs4.BeautifulSoup(contents, "lxml")'''find_all()方法返回一个列表,返回的是当前网页的所有电影名字和信息的一个列表'''div_list = soup.find_all('div', class_='info')movies_list = []for each in div_list:'''电影名字、信息'''movies_name = each.find('div', class_='hd').a.span.text.strip()movies_info = each.find('div', class_='bd').p.text.strip()movies_info = movies_info.replace("\n", " ").replace("\xa0", " ")movies_info = ' '.join(movies_info.split())'''zhon将当前页的电影名字和信息添加到一个列表当中'''movies_list.append([movies_name, movies_info])return movies_list
将获取到的电影名字,信息写进.txt文件中
with open('豆瓣电影top250.txt', 'a+', encoding='utf-8') as file:for info in movies_list:file.write(info[0]+'\t')file.write(info[1]+'\n')
源代码如下
import requestsimport bs4def get_pages(url):headers = {"User-Agent": 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.77 Safari/537.36 Edg/91.0.864.41'}try:response = requests.get(url=url, headers=headers, timeout=5)except requests.exceptions as e:print('error')finally:content = response.textreturn contentdef get_movies(contents):soup = bs4.BeautifulSoup(contents, "lxml")div_list = soup.find_all('div', class_='info')movies_list = []for each in div_list:'''电影名字、信息'''movies_name = each.find('div', class_='hd').a.span.text.strip()movies_info = each.find('div', class_='bd').p.text.strip()movies_info = movies_info.replace("\n", " ").replace("\xa0", " ")movies_info = ' '.join(movies_info.split())movies_list.append([movies_name, movies_info])return movies_listdef download_list(url):web_url = urlcontents = get_pages(web_url)movies_list = get_movies(contents)with open('1.txt', 'a+', encoding='utf-8') as file:for info in movies_list:file.write(info[0]+'\t')file.write(info[1]+'\n')if __name__ == "__main__":"""网页地址为:https://movie.douban.com/top250"""pages = 0while pages <= 225:url = 'https://movie.douban.com/top250?start=%s' % pagesprint("正在爬取数据..........")pages += 25download_list(url)print("爬取完毕!")
让我们来看一下结果怎么样吧
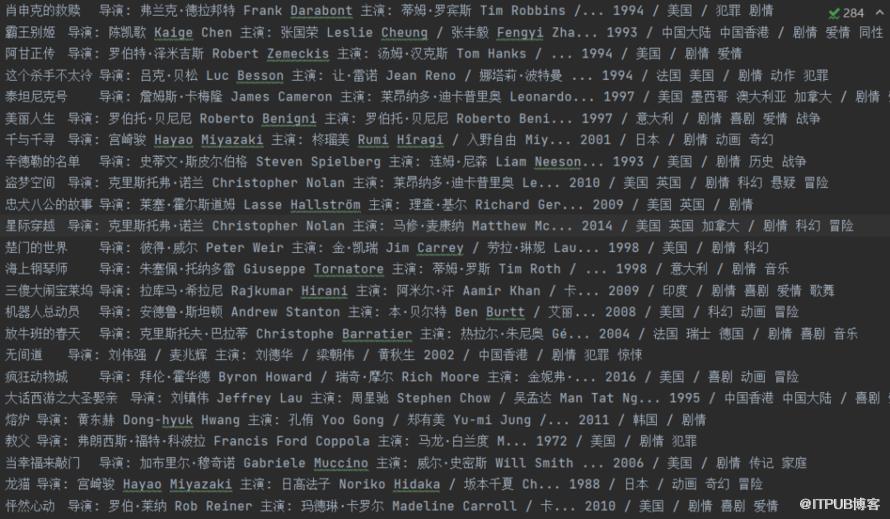

文章的最后,我想请问一下各位小伙伴,你们能不对其进行一个升级,将电影的海报图片也下载下来。欢迎各位投稿!
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。

