10.9日,我发表了一篇名为《运维排查篇 | 服务器产生大量的TIME_WAIT的原因你知道吗?》的文章
在发表文章的第二天,就有读者大佬指出我的错误
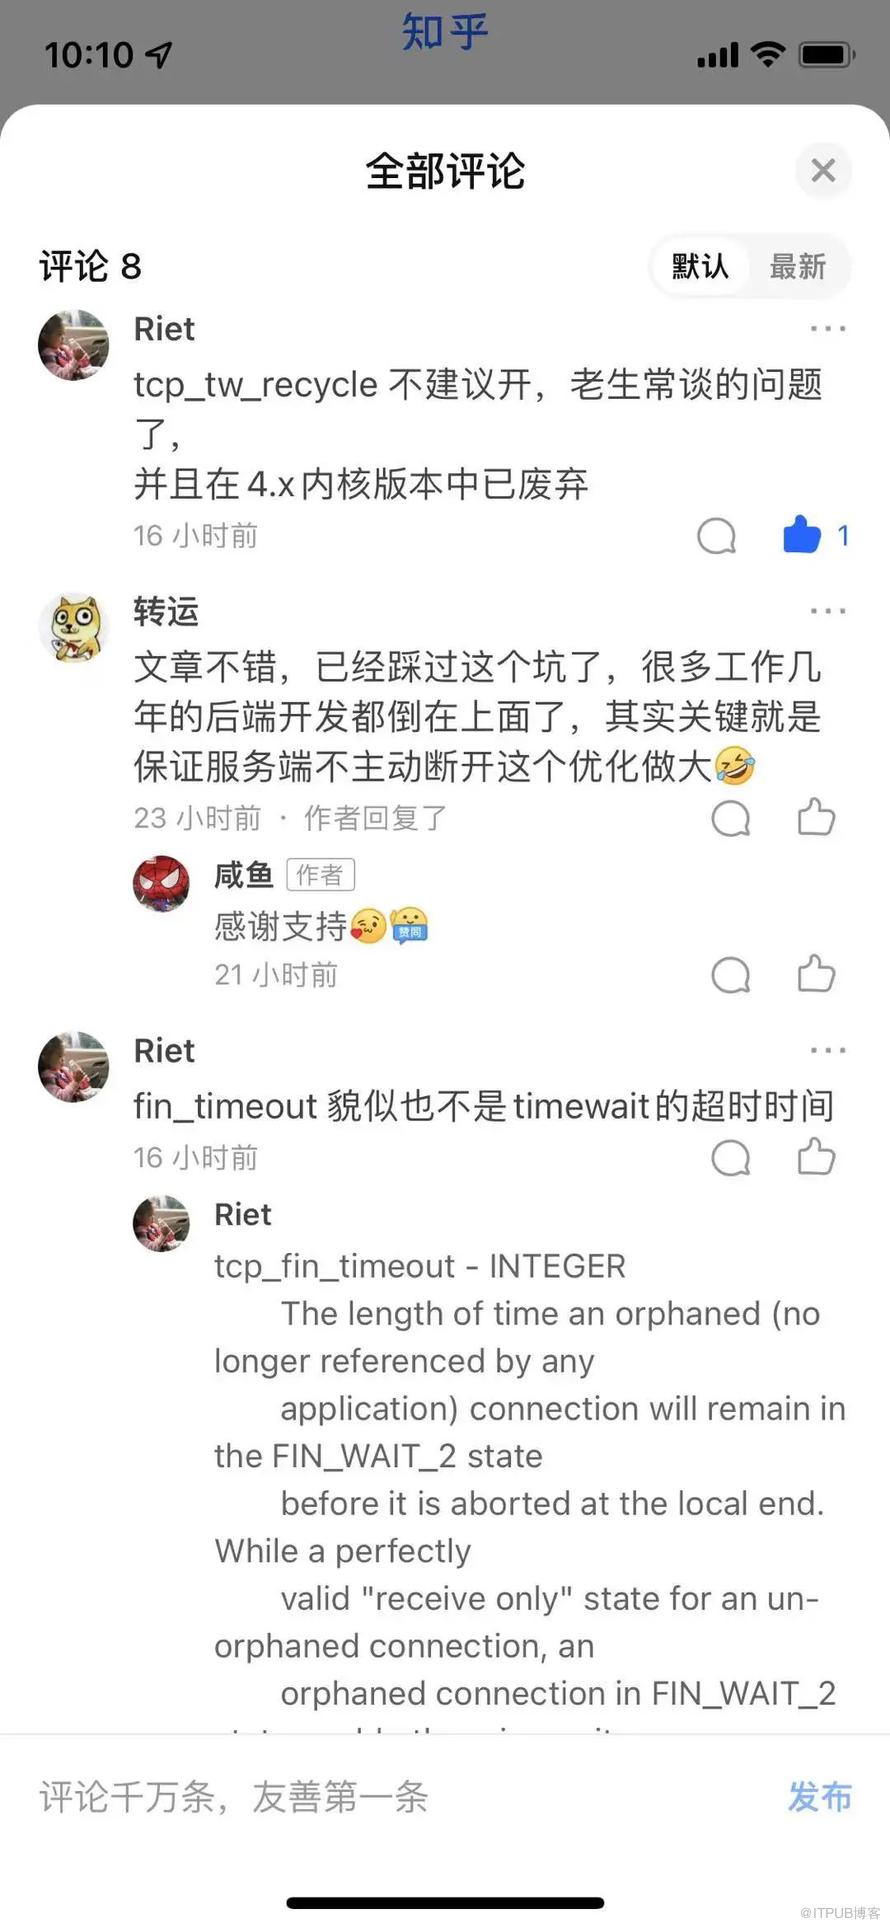
在这里我特别感谢这位读者,我觉得每一次错误都是自己进步成长的一次机会
于是,怀着刨根问底的态度,我查阅了网上相关的资料,问了实习时候的大佬同事,对《运维排查篇 | 服务器产生大量的TIME_WAIT的原因你知道吗?》这篇文章里面的一些错误做出更正
关于 net.ipv4.tcp_fin_timeout
在《运维排查篇 | 服务器产生大量的TIME_WAIT的原因你知道吗?》这篇文章中,我指出可以通过内核参数:
/proc/sys/net/ipv4/tcp_fin_timeout
来修改 TIME_WAIT 状态的超时时间
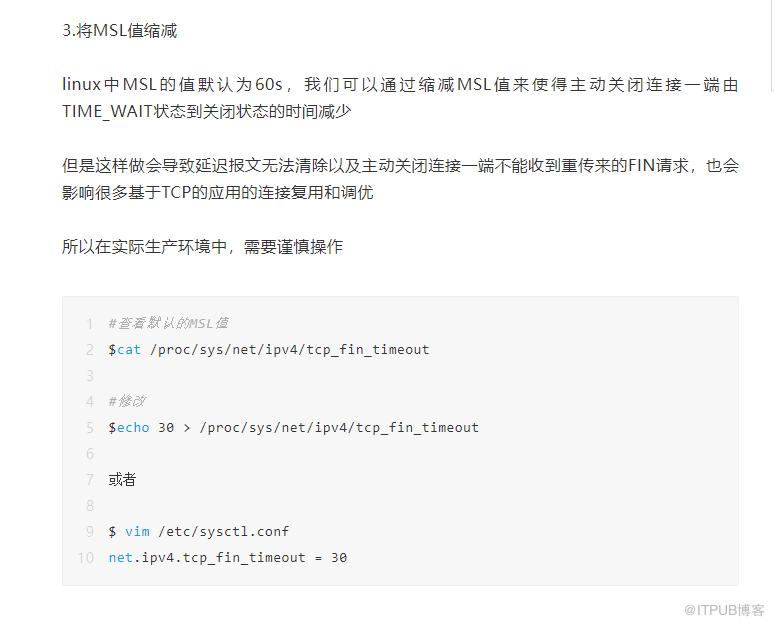
后来经过大佬读者指出错误,以及我查阅了相关文档之后,发现事实并不是这样的
我们先来看下关于这个内核参数的相关说明
Linux内核源代码在释出时会包含有一些关于内核参数和函数的说明文档,方便人们更好的了解
在CentOS、RedHat系统中,我们可以从官网:https://www.kernel.org/ 下载内核源码包,里面就会有这些文档
除此之外,我们还可以使用 kernel-doc 工具包来进行查看
#首先安装工具包[root@promote]# yum install -y kernel-doc#查看版本[root@promote]# rpm -qa kernel-dockernel-doc-3.10.0-1160.42.2.el7.noarch
下载安装之后我们进入到如下路径(工具包版本不同,路径也不同)
[root@promote]# cd /usr/share/doc/kernel-doc-3.10.0/Documentation/这个路径里面包含了关于内核参数的说明文档,为txt格式,我们可以使用grep命令查找你想要了解的内核参数
这里我们查找 tcp_fin_timeout 参数的说明文档
相关路径
/usr/share/doc/kernel-doc-3.10.0/Documentation/networking/ip-sysctl.txt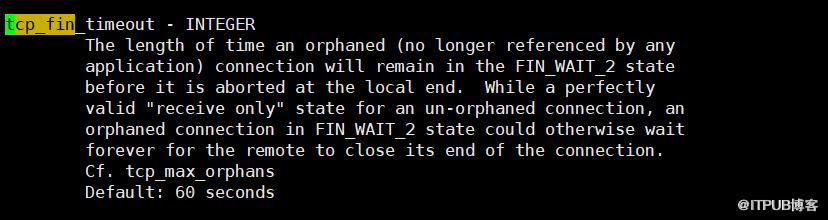
tcp_fin_timeout - INTEGERThe length of time an orphaned (no longer referenced by anyapplication) connection will remain in the FIN_WAIT_2 statebefore it is aborted at the local end. While a perfectlyvalid "receive only" state for an un-orphaned connection, anorphaned connection in FIN_WAIT_2 state could otherwise waitforever for the remote to close its end of the connection.Cf. tcp_max_orphansDefault: 60 seconds
tcp_fin_timeout - INTEGER对于本端断开的socket连接,TCP保持在FIN_WAIT_2状态的时间。对方可能会断开连接或一直不结束连接或不可预料的进程死亡。默认值为 60 秒。过去在2.2版本的内核中是 180 秒。您可以设置该值﹐但需要注意﹐如果您的机器为负载很重的web服务器﹐您可能要冒内存被大量无效数据报填满的风险﹐FIN-WAIT-2 sockets 的危险性低于 FIN-WAIT-1 ﹐因为它们最多只吃 1.5K 的内存﹐但是它们存在时间更长。另外参考 tcp_max_orphans。默认值:60秒
从关于 tcp_fin_timeout 的说明文档我们可以得出,如果是本端主动断开连接,则该值指的是TCP保持在FIN_WAIT_2状态的时间
那么真正控制TIME_WAIT状态超时时间的是哪个参数呢?
这篇文章里面的内容为我们解开了疑惑

内核中真正管用的是一个宏定义,在 $KERNEL/include/net/tcp.h里面,有下面的行:
#define TCP_TIMEWAIT_LEN (60*HZ)
这个宏是真正控制 TCP TIME_WAIT 状态的超时时间的。如果我们希望减少 TIME_WAIT 状态的数目(从而节省一点点内核操作时间),那么可以把这个数值设置低一些,根据我们的测试,设置为 10 秒比较合适
关于 net.ipv4.tcp_tw_recycle
在《运维排查篇 | 服务器产生大量的TIME_WAIT的原因你知道吗?》这篇文章中,我指出通过开启参数:
net.ipv4.tcp_tw_recycle
来实现TIME_WAIT sockets 的快速回收
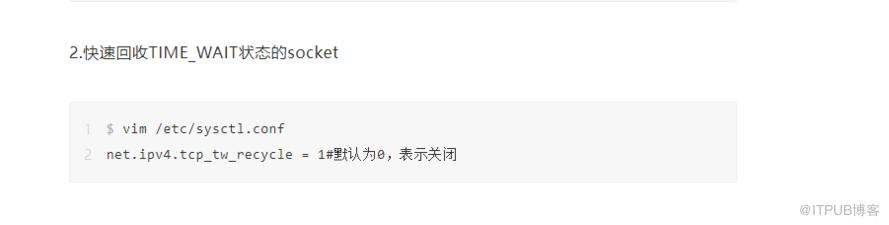
在linux内核说明文档中,对 net.ipv4.tcp_tw_recycle 描述如下
tcp_tw_recycle - BOOLEANEnable fast recycling TIME-WAIT sockets. Default value is 0.It should not be changed without advice/request of technicalexperts.
中文版:
启用快速回收时间等待套接字。默认值为0。未经技术专家的建议/要求,不得对其进行更改。
实际上,要实现快速回收TIME_WAIT状态的 sockets ,不但需要开启net.ipv4.tcp_tw_recycle,还需要开启 net.ipv4.tcp_timestamps(默认开启)这个开关才有效果
我们可以通过如下shell来查看:
[root@promote]# sysctl -a|grep -E "tcp_timestamp|tw_reuse|tw_recycle"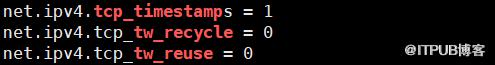
除此之外,查看了 net.ipv4.tcp_tw_recycle 的源码后发现
开启这个选项后,Linux会丢弃所有来自远端的timestamp时间戳小于上次记录的时间戳(由同一个远端发送的)的任何数据包。也就是说要使用该选项,则必须保证数据包的时间戳是单调递增的。
总的来说,tcp_tw_recycle开启后(前提是tcp_timestamps一并开启,这样才有效)系统会记录并检查每个连接的时间戳,如果后面连接的时间戳比之前记录的小,系统就会认为是错误的连接,拒绝并丢弃这个连接
这种机制在某种环境(例如nat环境)下会存在重大问题,比如说使用LVS做负载均衡,一般情况下lvs后面是多台后端server。
当客户端请求到达lvs后,lvs转发给后端server,这些请求的时间戳没有被修改
对于后端server来说,请求都是由lvs发起的,后端server会认为是同一条连接,加上不同客户端的请求的时间不一致,就会出现时间戳错乱的现象,如果这时候开启了 tcp_tw_recycle ,会导致许多请求被丢弃,就会出现部分客户端能连接服务器,部分不能连接的情况
总结
tcp_fin_timeout 指的是TCP保持在FIN_WAIT_2状态的时间,并非TIME_WAIT状态的超时时间
tcp_tw_recycle选项在4.10内核之前不适用于NAT或者负载均衡的情况(其他情况下也是不建议开启),在4.12内核版本中被移除
出现TIME_WAIT状态的连接是正常现象,实在过多时,我们可以试着使用如下方式进行优化(不能一刀切,需要结合实际生产环境来使用)
将短链接修改成长连接
增加服务器的可用端口范围;增加服务器服务端口,让服务器能容纳足够多的TIME_WAIT连接
将net.ipv4.tcp_max_tw_buckets设置为很小的值(默认是18000). 当TIME_WAIT连接数量达到给定的值时,所有的TIME_WAIT连接会被立刻清除,并打印警告信息。但这种粗暴的清理掉所有的连接,意味着有些连接并没有成功等待2MSL,就会造成通讯异常
最后,衷心感谢指出我文章不足的大佬读者,让我对这些参数有了一个更深入的了解。也让我知道了解决一个问题不能随便找个方案就去使用,得先对每个参数都深入了解之后再做操作,否则可能会造成悲剧。
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。

