看了看后台,发现之前写的几篇有关爬虫实战的文章特别受欢迎,阅读量都是好几千那种
然后回头发现自己好久没写爬虫了,刚好写了个小小的爬虫 demo ,今天分享给大家
需求分析
我们先来看一下需求:
获取自1994年至2022年之间,各年度的大陆票房情况,包括年度排名、电影名称和票房总额
各个年度的电影票房情况分别保存至以本年度为名称的CSV文件,例如2022年电影票房数据保存到2022.csv
我们发现,中国历年来的电影票房都对应着一个 url,而且这个 url 是有规律的
例如:
1994年的中国大陆电影票房网址:http://www.boxofficecn.com/boxoffice1994
1995年的中国大陆电影票房网址:http://www.boxofficecn.com/boxoffice1995
那么我们在提供 url 的时候只需要将最后那部分也就是年份那部分进行修改即可
网页分析
在知道了网址的规律之后,我们对网页进行一下分析
我们按 F12 进入网页代码查看器,当前页面的代码结构如下图

可以看到电影的信息都存放在 <tr align='left'> 标签里面
年份、票房、电影名称以及排名都在 <td> 标签里面
代码实现
既然知道了我们要获取的信息的所在标签中,那么就开始我们的爬取过程吧!
需要导入的库文件
import requestsimport bs4
将当前网页获取下来
注意:因为网页中含有中文字符,所以我们在下载网页源码之前先看下它的编码格式,输入当前网页的编码格式 print(res.encoding)
可以看到是 UTF-8 编码格式,所以我们将网页源码获取之后要对其进行编码 encode('UTF-8')
def get_web(url):header = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36 Edg/91.0.864.59"}res = requests.get(url, headers=header, timeout=5)# 查看当前网页的编码格式print(res.encoding)#对网页源码进行编码content = res.text.encode('UTF-8')return content
从网页源码中获取所需标签信息
将网页下载获取下来之后,我们使用 bs4 模块来进行解析并获取我们所需要的数据信息
soup = bs4.BeautifulSoup(content, 'lxml')movie_list = soup.find_all('tr', attrs={'align': 'left'})
这里我定义了一个 movie_list 去存放票房信息
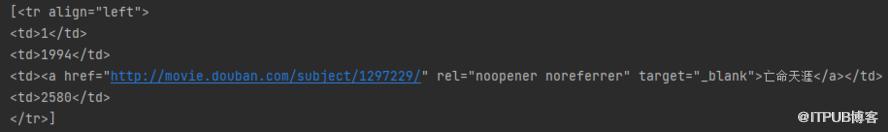
可以看到 movie_list 是一个 bs4.element.ResultSet 对象,我们需要对其进行遍历才能获得里面的元素
print(type(movie_list))##结果<class 'bs4.element.ResultSet'>
信息处理
遍历获取 movie_list 中的元素并且对其进行处理,然后存放到列表 list 中
list = []for i in movie_list:i = i.text.split('\n')i = i[1:len(i)-1]list.append(i)
list 中的元素如下所示:
[['1', '1995', '真实的谎言', '10300'],['2', '1995', '红番区', '9500'],['3', '1995', '阳光灿烂的日子', '5000'],['4', '1995', '虎胆龙威3', '4700'],['5', '1995', '狮子王(1994)', '4130'],['6', '1995', '红粉', '4000'],['7', '1995', '红樱桃', '4000'],['8', '1995', '生死时速', '3780'],['9', '1995', '七七事变', '3300'],['10', '1995', '绝地战警', '3280'],['11', '1995', '阿甘正传', '1960']]
接着我们将 list 中的内容以键值对的形式保存,方便信息的阅读性
我们以电影排名作为唯一的key
dic = {}for i in list:dic[i[0]] = {'年份': i[1], '电影名称': i[2], '票房(万元)': i[3]}return dic
数据保存
我们将字典中的内容保存到本地的 csv 文件中
def data_save(dic,year):file_name = 'D:\movie\\' + str(year) + '.csv'with open(file_name, 'w+') as f:f.write('排名,年份,电影名称,票房(万元)\n')for k, v in dic.items():f.write(k+','+v['年份']+','+v['电影名称']+','+v['票房(万元)']+'\n')
补充:
def data_save(dic,year):file_name = 'D:\movie\\' + str(year) + '.csv'with open(file_name, 'w+') as f:f.write('排名,年份,电影名称,票房(万元)\n')for k, v in dic.items():f.write(k+','+v['年份']+','+v['电影名称']+','+v['票房(万元)']+'\n')
刚开始用上面这段代码实现的时候报错
UnicodeEncodeError: 'gbk' codec can't encode character u'\xa0' in position 12:illegal multibyte sequence出现 UnicodeEncodeError ,说明是 Unicode 编码问题,
gbk’ codec can’t encode character 说明是将 Unicode 字符编码为 GBK 时候出现的问题;
此时,往往最大的可能就是,本身 Unicode 类型的字符中,包含了一些无法转换为 GBK 编码的一些字符
unicode 中的 ‘\xa0’ 字符在转换成gbk编码时会出现问题例如 gbk 无法转换 '\xa0' 字符
所以,在转换的时候必须进行一些前置动作,例如将这些字符替换成空格
.replace(u'\xa0', u' ')后面在演示的时候分别又报了如下报错
UnicodeEncodeError: 'gbk' codec can't encode character '\u200e' in position 13: illegal multibyte sequenceUnicodeEncodeError: 'gbk' codec can't encode character '\u200b' in position 13: illegal multibyte sequence
有了上面的经验,我们只需要把对应无法转换的字符替换成空格即可
replace(u'\u200b', u' ')replace(u'\u200e', u' ')
最后代码如下所示:
def get_content(url):content = get_web(url)list = parse_content(content)dic = {}for i in list:i[1] = i[1].replace(u'\xa0', u' ').replace(u'\u200b', u' ').replace(u'\u200e', u' ')i[2] = i[2].replace(u'\xa0', u' ').replace(u'\u200b', u' ').replace(u'\u200e', u' ')i[3] = i[3].replace(u'\xa0', u' ').replace(u'\u200b', u' ').replace(u'\u200e', u' ')dic[i[0]] = {'年份': i[1], '电影名称': i[2], '票房(万元)': i[3]}return dic
结果展示
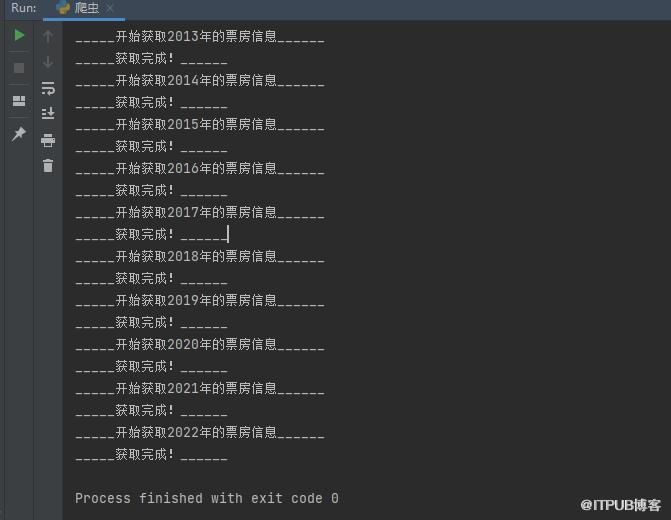
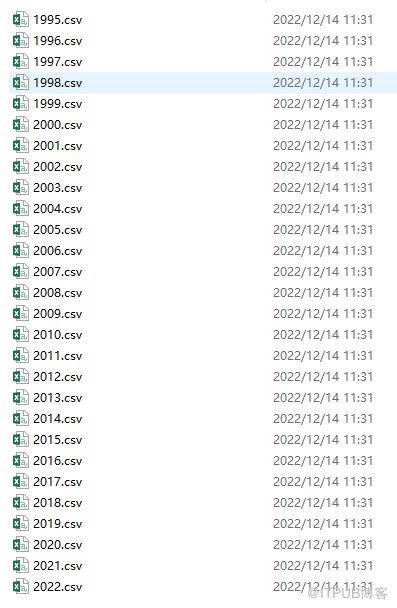
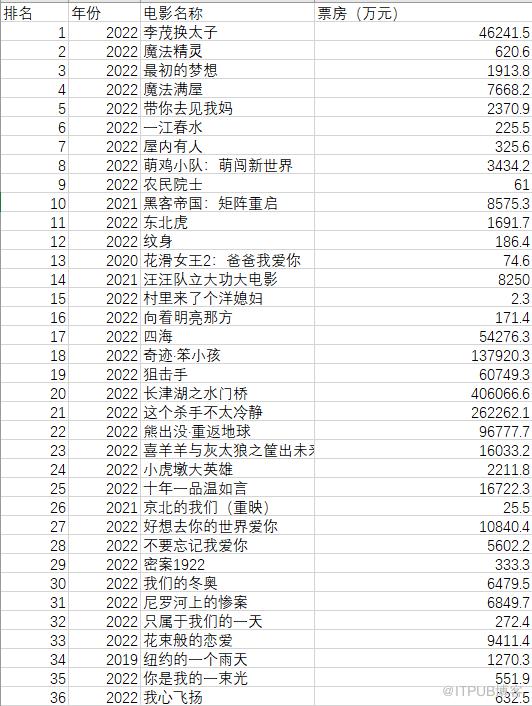
完整代码
import requestsimport bs4'''去访问对应的网页并将网页源码下载下来需要注意网页的编码格式'''def get_web(url):header = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.114 Safari/537.36 Edg/91.0.864.59"}res = requests.get(url, headers=header, timeout=5)# 查看当前网页的编码格式# print(res.encoding)#对网页源码进行编码content = res.text.encode('UTF-8')return content'''对下载下来的网页源码进行解析,然后获取指定内容并存放到一个列表里'''def parse_content(content):soup = bs4.BeautifulSoup(content, 'lxml')movie_list = soup.find_all('tr', attrs={'align': 'left'})list = []for i in movie_list:i = i.text.split('\n')i = i[1:len(i)-1]list.append(i)return list'''将列表中的内容转换成字典,以键值对的形式存放'''def get_content(url):content = get_web(url)list = parse_content(content)dic = {}for i in list:i[1] = i[1].replace(u'\xa0', u' ').replace(u'\u200b', u' ').replace(u'\u200e', u' ')i[2] = i[2].replace(u'\xa0', u' ').replace(u'\u200b', u' ').replace(u'\u200e', u' ')i[3] = i[3].replace(u'\xa0', u' ').replace(u'\u200b', u' ').replace(u'\u200e', u' ')dic[i[0]] = {'年份': i[1], '电影名称': i[2], '票房(万元)': i[3]}return dic'''数据保存'''def data_save(dic,year):file_name = 'D:\movie\\' + str(year) + '.csv'with open(file_name, 'w+') as f:f.write('排名,年份,电影名称,票房(万元)\n')for k, v in dic.items():f.write(k+','+v['年份']+','+v['电影名称']+','+v['票房(万元)']+'\n')if __name__ == '__main__':url = 'http://www.boxofficecn.com/boxoffice'for year in range(1994, 2023):new_url = url + str(year)dic = get_content(new_url)print('_____开始获取%s年的票房信息______' %(year))data_save(dic, year)print('_____获取完成!______')
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。

