哈喽大家好,我是咸鱼
之前写了一篇关于文献爬虫的文章《Python爬虫实战(5) | 爬取知网文献信息》
文章发布之后有很多小伙伴给出了一些反馈和指正,在认真看了小伙伴们的留言之后,咸鱼对代码进行了一些优化
代码在文末,欢迎各位小伙伴给出意见和指正
问题
pycharm 设置 Edge 驱动器的环境报错
“module 'selenium.webdriver' has no attribute 'EdgeOptions”
如果浏览器驱动已经下载,而放在了合适的位置(比如添加到环境变量里,或者放在了 python.exe 同级目录中)
那就可能是因为你使用的是较老的 selenium 版本,Edge 驱动的选项已经被更新了。建议更新 selenium 包以获得最佳的 Edge 选项支持
可以通过以下命令更新 selenium,建议更新到 4.6 以上版本

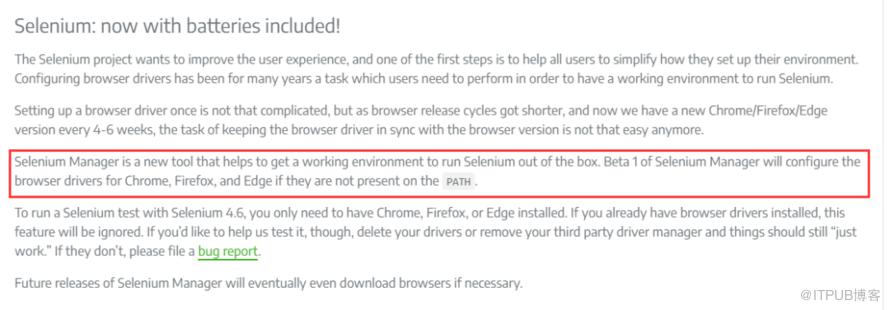
因为 selenium 4.6 版本之后内置了一个组件:Selenium Manager
根据官网介绍,这个 Selenium Manager 可以帮助你获得一个运行 Selenium 的开箱即用的环境
如果在 PATH 中没有找到 Chrome、Firefox 和 Edge 的驱动,Selenium Manager的 Beta 1版将为它们配置。不需要额外的配置
这就意味着自己不需要再去下载安装浏览器驱动
中文文档链接:
https://www.selenium.dev/zh-cn/documentation/webdriver/getting_started/install_drivers/
只能爬取20倍数的文献篇数
有位粉丝发现每次爬取都是爬取 20 倍数的文献篇数(20、40、60)。假设要爬取 21 篇,但是却爬到了 40 篇
排查的时候发现是代码中的逻辑有一些 bug ,已经优化
获取不到网页的 xpath 元素
第一种可能是网页中的 xpath 元素并不是一成不变的,要参考自己的浏览器上的 Xpath。在我这可能是div[3],在你那可能就不是这个了,所以说需要自己先定位一遍
第二种可能是网页加载太慢导致爬虫爬取不到,这种情况的话可以增加等待超时时间
关于网页加载太慢导致程序爬取不到元素报超时异常或者元素不存在异常
我的代码中用的都是显示等待 + 强制等待结合的方式。如果还是不行,小伙伴们可以自行设置超时时间
优化后代码
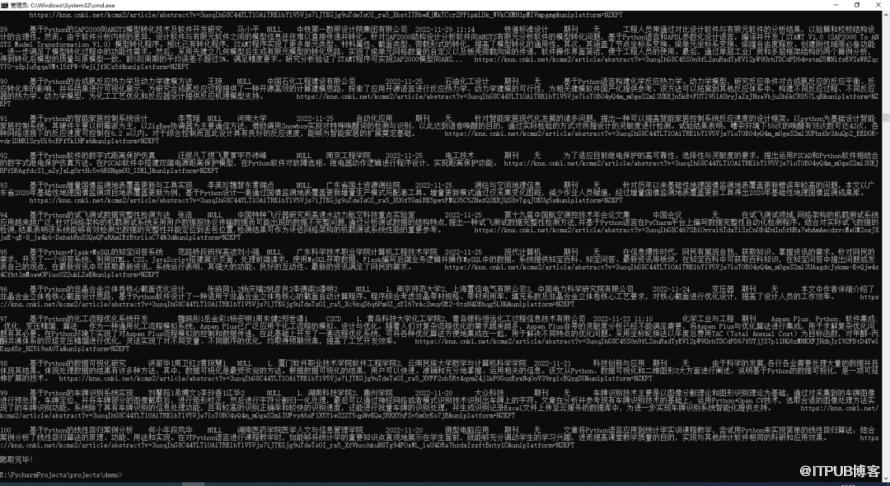
下面给出优化后的源码
import timefrom selenium import webdriverfrom selenium.webdriver.support.ui import WebDriverWaitfrom selenium.webdriver.support import expected_conditions as ECfrom selenium.webdriver.common.by import Byfrom selenium.webdriver.common.desired_capabilities import DesiredCapabilitiesfrom urllib.parse import urljoindef open_page(driver, theme):# 打开页面driver.get("https://www.cnki.net")# 传入关键字WebDriverWait(driver, 100).until(EC.presence_of_element_located((By.XPATH, '''//*[@id="txt_SearchText"]'''))).send_keys(theme)# 点击搜索WebDriverWait(driver, 100).until(EC.presence_of_element_located((By.XPATH, "/html/body/div[2]/div[2]/div/div[1]/input[2]"))).click()time.sleep(3)# 点击切换中文文献WebDriverWait(driver, 100).until(EC.presence_of_element_located((By.XPATH, "/html/body/div[3]/div[1]/div/div/div/a[1]"))).click()time.sleep(3)# 获取总文献数和页数res_unm = WebDriverWait(driver, 100).until(EC.presence_of_element_located((By.XPATH, "/html/body/div[3]/div[2]/div[2]/div[2]/form/div/div[1]/div[1]/span[1]/em"))).text# 去除千分位里的逗号res_unm = int(res_unm.replace(",", ''))page_unm = int(res_unm / 20) + 1print(f"共找到 {res_unm} 条结果, {page_unm} 页。")return res_unmdef crawl(driver, papers_need, theme):# 赋值序号, 控制爬取的文章数量count = 1# 当爬取数量小于需求时,循环网页页码while count <= papers_need:# 等待加载完全,休眠3Stime.sleep(3)title_list = WebDriverWait(driver, 10).until(EC.presence_of_all_elements_located((By.CLASS_NAME, "fz14")))# 循环网页一页中的条目for i in range(len(title_list)):try:if (count % 20) != 0:term = count % 20 # 本页的第几个条目else:term = 20title_xpath = f"/html/body/div[3]/div[2]/div[2]/div[2]/form/div/table/tbody/tr[{term}]/td[2]"author_xpath = f"/html/body/div[3]/div[2]/div[2]/div[2]/form/div/table/tbody/tr[{term}]/td[3]"source_xpath = f"/html/body/div[3]/div[2]/div[2]/div[2]/form/div/table/tbody/tr[{term}]/td[4]"date_xpath = f"/html/body/div[3]/div[2]/div[2]/div[2]/form/div/table/tbody/tr[{term}]/td[5]"database_xpath = f"/html/body/div[3]/div[2]/div[2]/div[2]/form/div/table/tbody/tr[{term}]/td[6]"title = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, title_xpath))).textauthors = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, author_xpath))).textsource = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, source_xpath))).textdate = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, date_xpath))).textdatabase = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, database_xpath))).text# 点击条目title_list[i].click()# 获取driver的句柄n = driver.window_handles# driver切换至最新生产的页面driver.switch_to.window(n[-1])time.sleep(3)# 开始获取页面信息title = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH ,"/html/body/div[2]/div[1]/div[3]/div/div/div[3]/div/h1"))).textauthors = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH ,"/html/body/div[2]/div[1]/div[3]/div/div/div[3]/div/h3[1]"))).textinstitute = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, "/html/body/div[2]/div[1]/div[3]/div/div/div[3]/div/h3[2]"))).textabstract = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.CLASS_NAME, "abstract-text"))).texttry:keywords = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.CLASS_NAME, "keywords"))).text[:-1]cssci = WebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, "/html/body/div[2]/div[1]/div[3]/div/div/div[1]/div[1]/a[2]"))).textexcept:keywords = '无'cssci = 'NULL'url = driver.current_urlres = f"{count}\t{title}\t{authors}\t{cssci}\t{institute}\t{date}\t{source}\t{database}\t{keywords}\t{abstract}\t{url}".replace("\n", "") + "\n"print(res)'''写入文件,有需要的小伙伴可以去掉注释'''# with open(f'CNKI_{theme}.tsv', 'a', encoding='gbk') as f:# f.write(res)except:print(f" 第{count} 条爬取失败\n")# 跳过本条,接着下一个continuefinally:# 如果有多个窗口,关闭第二个窗口, 切换回主页n2 = driver.window_handlesif len(n2) > 1:driver.close()driver.switch_to.window(n2[0])# 爬完一篇计数加 1count += 1if count > papers_need:breakWebDriverWait(driver, 10).until(EC.presence_of_element_located((By.XPATH, "//a[@id='PageNext']"))).click()if __name__ == "__main__":print("开始爬取!")# get直接返回,不再等待界面加载完成desired_capabilities = DesiredCapabilities.CHROMEdesired_capabilities["pageLoadStrategy"] = "none"# 设置浏览器驱动器的环境options = webdriver.EdgeOptions()# 设置浏览器不加载图片,提高速度options.add_experimental_option("prefs", {"profile.managed_default_content_settings.images": 2})# 设置不显示窗口options.add_argument('--headless')# 创建一个浏览器驱动器driver = webdriver.Edge(options=options)# 输入需要搜索的主题# theme = input("请输入你要搜索的期刊名称:")theme = "python"# 设置所需篇数# papers_need = int(input("请输入你要爬取篇数:"))papers_need = 100res_unm = int(open_page(driver, theme))# 判断所需是否大于总篇数papers_need = papers_need if (papers_need <= res_unm) else res_unmcrawl(driver, papers_need, theme)print("爬取完毕!")# 关闭浏览器driver.close()
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。

