哈喽大家好,我是咸鱼
好久没更新 python 爬虫相关的文章了,今天我们使用 selenium 模块来简单写个爬虫程序——爬取某东网商品信息
网址链接:https://www.jd.com/
完整源码在文章最后
我们需要找到网页上元素的位置信息(xpth 路径)

我们首先需要知道搜索框和搜索按钮的位置,然后才能把商品名字输入到搜索框中并点击收缩按钮
打开 F12,通过开发者调试工具检查相应的的位置,可得如下 Xpath 表达式:
# 输入框位置://*[@id="key"]# 搜索按钮位置://*[@class='form']/button
以 python 书籍为例

我们需要获取商品的名字、价格、评价数量以及店铺名
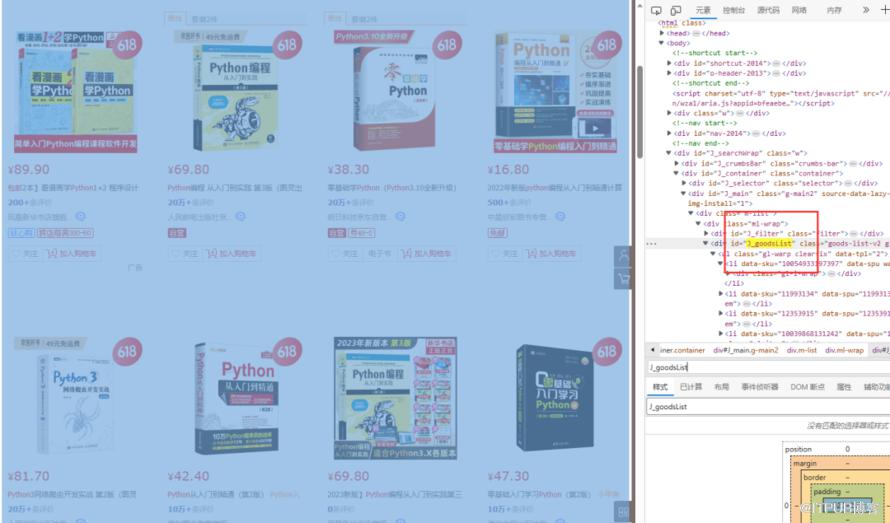
然后通过发者调试工具检查相应的的位置,可得如下 Xpath 表达式:
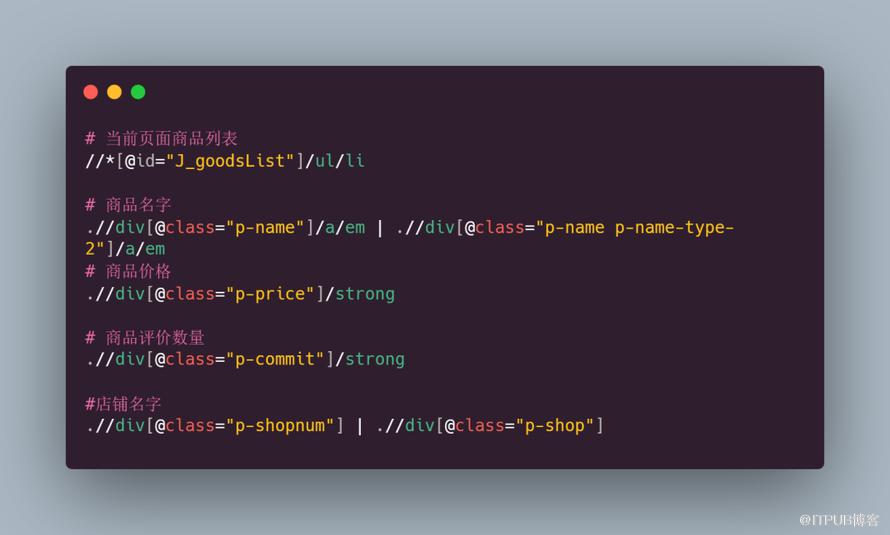
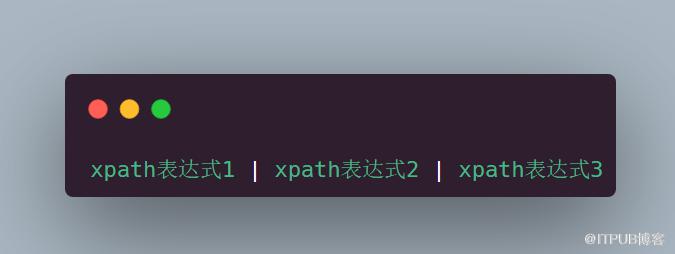
请注意,我在定位商品名字 xpath 的时候用了或(|),这是因为我在爬取其他商品信息的时候发现商品名字的 xpath 路径有多个

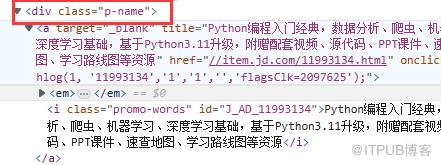
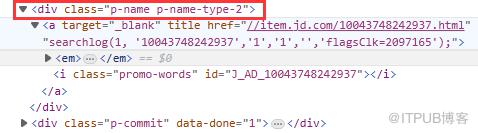
且多个 Xpath 路径表达式可以同时使用,其语法如下:
实现了自动搜索后,接下来就是要抓取页面中的商品信息
需要注意的是你会发现只有将滑动条滚动至底部,商品才会全部加载完毕
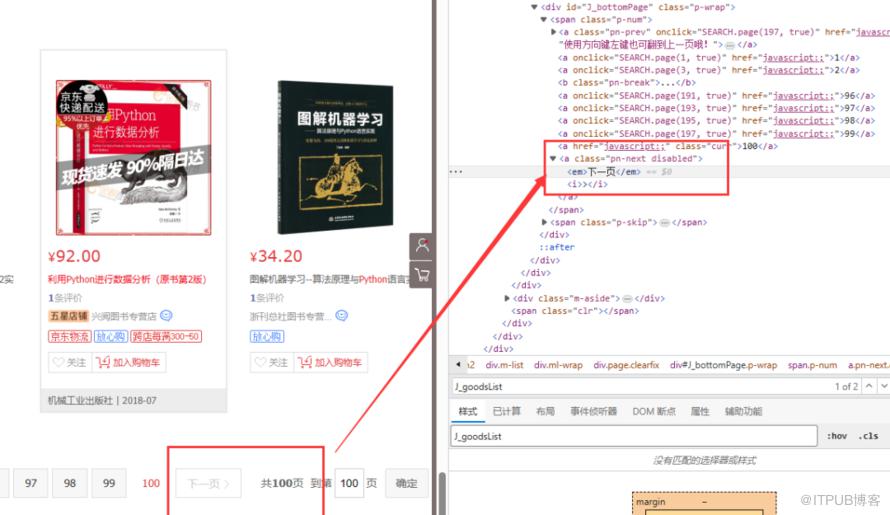
我们还需要做个判断:当爬取到最后一页时,下一页这个按钮是点击不了的,这时候就退出爬虫程序
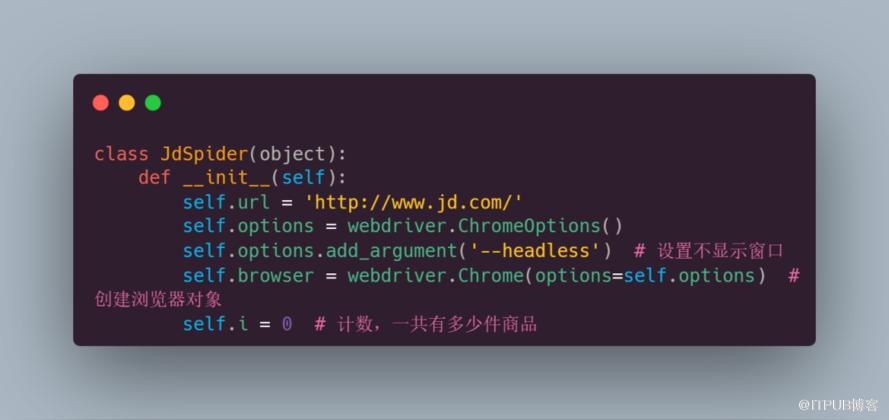
首先我们定义一个类 JdSpider,然后给它初始化
然后是输入商品名字点击搜索按钮的代码实现

获取信息

入口函数

跑一下看看
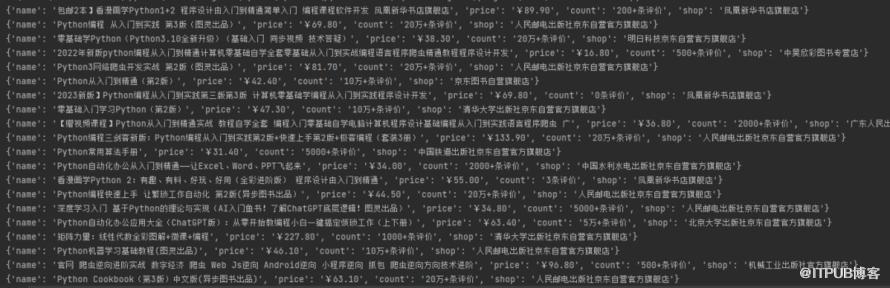
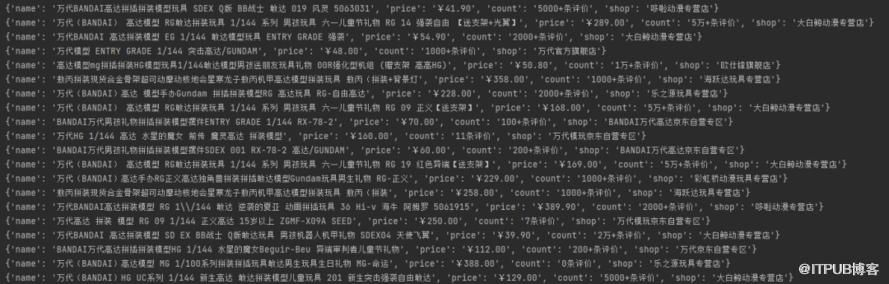
小伙伴们可以对爬取到的数据进行一下数据清洗处理等操作,就能够进行数据分析了
源码如下:
from selenium import webdriverimport timefrom selenium.webdriver.common.by import Byclass JdSpider(object):def __init__(self):self.url = 'http://www.jd.com/'self.options = webdriver.ChromeOptions()self.options.add_argument('--headless') # 无头模式self.browser = webdriver.Chrome(options=self.options) # 创建无界面参数的浏览器对象self.i = 0 # 计数,一共有多少件商品# 输入地址+输入商品+点击按钮,切记这里元素节点是京东首页的输入栏、搜索按钮def get_html(self):self.browser.get(self.url)self.browser.find_element(By.XPATH, '//*[@id="key"]').send_keys('python书籍')self.browser.find_element(By.XPATH, "//*[@class='form']/button").click()def get_data(self):# 把进度条件拉倒最底部+提取商品信息self.browser.execute_script('window.scrollTo(0,document.body.scrollHeight)')# 给页面元素加载时预留时间time.sleep(2)# 用xpath提取每页中所有商品,最终形成一个大列表 \li_list = self.browser.find_elements(By.XPATH, '//*[@id="J_goodsList"]/ul/li')for li in li_list:# 构建空字典item = {}item['name']=li.find_element(By.XPATH, './/div[@class="p-name"]/a/em | .//div[@class="p-name p-name-type-2"]/a/em').text.strip()item['price']=li.find_element(By.XPATH, './/div[@class="p-price"]/strong').text.strip()item['count']=li.find_element(By.XPATH, './/div[@class="p-commit"]/strong').text.strip()item['shop']=li.find_element(By.XPATH, './/div[@class="p-shopnum"] | .//div[@class="p-shop"]').text.strip()print(item)self.i += 1def run(self):# 搜索出想要抓取商品的页面self.get_html()# 循环执行点击“下一页”操作while True:# 获取每一页要抓取的数据self.get_data()# 判断是否是最一页,-1说明没找到,不是最后一页,执行点击 “下一页” 操作print(self.browser.page_source.find('pn-next disabled'))if self.browser.page_source.find('pn-next disabled') == -1:self.browser.find_element(By.CLASS_NAME, 'pn-next').click()# 预留元素加载时间time.sleep(1)else:print('数量', self.i)breakif __name__ == '__main__':spider = JdSpider()spider.run()
感谢阅读,喜欢作者就动动小手[一键三连],这是我写作最大的动力
原文作者:咸鱼运维杂谈;如有侵权,请联系管理员删除。
上一篇:
有关 python 切片的趣事
下一篇:
回学校做了个分享

请登录后发表评论
登录
全部评论
