来源:阿里云开发者
阿里妹导读
一、计算加速的技术
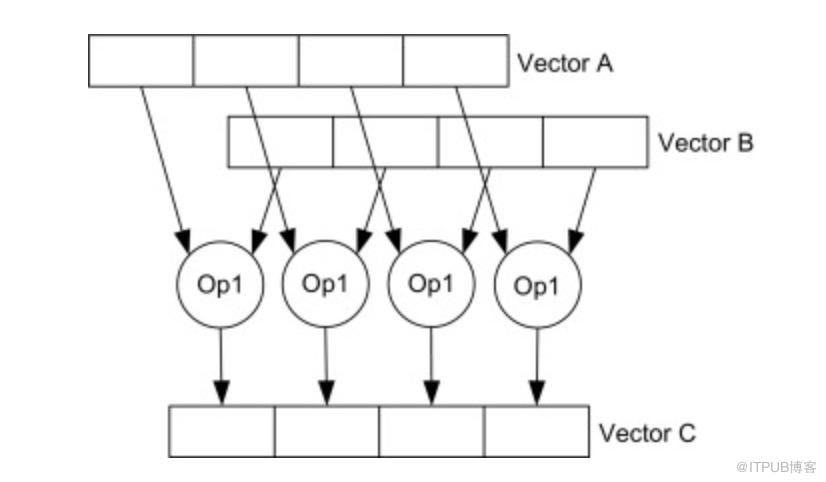
void squre( float* ptr ){ for( int i = 0; i < 4; i++ ) { const float f = ptr[ i ]; ptr[ i ] = f * f; }}void squre(float * ptr){ __m128 f = _mm_loadu_ps( ptr ); f = _mm_mul_ps( f, f ); _mm_storeu_ps( ptr, f );}二、SIMD扩展指令集
指令集需要CPU硬件支持,下面列出了支持各个指令集的CPU。
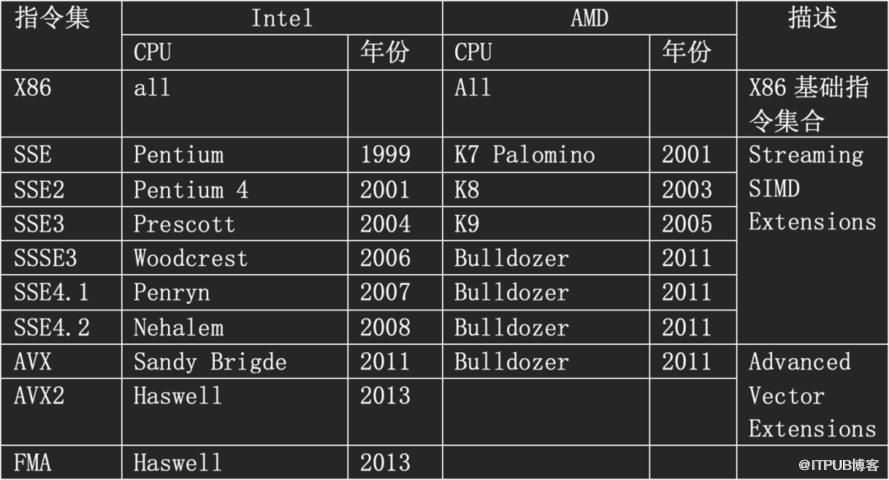
ARM也引入了SIMD扩展指令。典型的SIMD操作包括算术运算(+-*/)以及abs、sqrt等,完整的指令集合请参考英特尔提供的使用文档:
编译器自动向量化 静态编译 即时编译(JIT) 手写SIMD指令
三、编译器静态自动向量化
1、代码满足一定的范式,后续会详细展开介绍各种case;
3.1 编译器选择和选项
只有高版本的编译器才能实现向量化,gcc 4.9.2及以下经测试不支持向量化,gcc 9.2.1支持。gcc对向量化的支持更加友好,clang对某些代码无法转化成向量化,而在某些情况下,clang生成的向量化代码性能比gcc更好(采用更宽的寄存器指令导致的),不一而足。因此,建议编写符合规范的代码,然后分别测试两种编译器的性能。
res[i] = tmpBitPtr[i] & opBitPtr[i]; //使用下标访问地址,clang和gcc都支持*(res + i) = *(tmpBitPtr + i) & *(opBitPtr + i); //使用地址运算访问内存,clang不支持,gcc支持
四、如何写出可向量化的代码
循环的变量初始值和结束值要固定,例如:
for (int i = 0;i < n ;++i ) //总的次数是可以计数的,这种写法可以向量化for (int i = 0;i != n;++i) //总的次数不可计数,这种写法无法向量
for (int i=0; i<SIZE; i+=2) b[i] += a[i] * x[i]; //访问连续空间,可以向量化for (int i=0; i<SIZE; i+=2) b[i] += a[i] * x[index[i]] //访问非连续空间,不能向量化
数据依赖有几种场景:
for (j=1; j<MAX; j++) A[j]=A[j-1]+1;// case 1 先写后读,不能向量化for (j=1; j<MAX; j++) A[j-1]=A[j]+1;// case 2 先读后写,不能向量化for (j=1; j<MAX; j++) A[j-4]=A[j]+1;// case 3 虽然是先读后写,但假如4组数据组成一个向量,那么同一组数据内无依赖的,因而可以向量化 // case 4 先写后写,无法向量化(此处无案例)for (j=1; j<MAX; j++) B[j]=A[j]+A[j-1]+1;//case 5 先读后读,因为没有写操作,不影响向量化for (j=1; j<MAX; j++) sum = sum + A[j]*B[j] //case 6 这种可以向量化,虽然每次都会读同一个变量,再写一个变量,因为可以先用一个宽寄存器表示sum,分别累加每一路数据,循环结束后再累加宽寄存器中的值。 for (i = 0; i < size; i++) { c[i] = a[i] * b[i]; }// case 7这种要确认c的内存空间和a/b的内存空间是否有交集。如果c是a或者b的别名,比如c=a+1,那么c[i] = a[i+1],那a和c就有内存交集了。for(int i = 0;i < 10;i++) a[i] = b[i] //这种较好for(int i =0,index=0;i < 10;i++) a[index++]=b[index] //这种无法向量化
五、手写SIMD代码
5.1 SIMD代码例子和不同编译器性能对比
const static char not_case_lower_bound = 'A';const static char not_case_upper_bound= 'Z';static void lowerStrWithSIMD(const char * src, const char * src_end, char * dst){const auto flip_case_mask = 'A' ^ 'a';const auto bytes_sse = sizeof(__m128i);const auto * src_end_sse = src_end - (src_end - src) % bytes_sse;const auto v_not_case_lower_bound = _mm_set1_epi8(not_case_lower_bound - 1);const auto v_not_case_upper_bound = _mm_set1_epi8(not_case_upper_bound + 1);const auto v_flip_case_mask = _mm_set1_epi8(flip_case_mask);for (; src < src_end_sse; src += bytes_sse, dst += bytes_sse){/// load 16 sequential 8-bit charactersconst auto chars = _mm_loadu_si128(reinterpret_cast<const __m128i *>(src));/// find which 8-bit sequences belong to range [case_lower_bound, case_upper_bound]const auto is_not_case= _mm_and_si128(_mm_cmpgt_epi8(chars, v_not_case_lower_bound), _mm_cmplt_epi8(chars, v_not_case_upper_bound));/// keep lip_case_mask _mm_and_si128(v_flip_case_mask, is_not_case);/// flip case by applying calculated maskconst auto xor_mask = _mm_and_si128(v_flip_case_mask, is_not_case);const auto cased_chars = _mm_xor_si128(chars, xor_mask);/// store result back to destination_mm_storeu_si128(reinterpret_cast<__m128i *>(dst), cased_chars);}for (; src < src_end; ++src, ++dst)if (*src >= not_case_lower_bound && *src <= not_case_upper_bound)*dst = *src ^ flip_case_mask;else*dst = *src;}static void lowerStr(const char * src, const char * src_end, char * dst){const auto flip_case_mask = 'A' ^ 'a';for (; src < src_end; ++src, ++dst)if (*src >= not_case_lower_bound && *src <= not_case_upper_bound)*dst = *src ^ flip_case_mask;else*dst = *src;}
上述两个函数用于把字符串中的大写字母转换成小写字母,第一个函数采用了SIMD实现(采用128位指令),第二个函数采用了普通的做法。第一个是128位指令(16字节),理论上相比非向量化指令,加速比为16倍。但是由于第二个代码在结构上是很清晰的,也可以自动向量化,在这里我们测试下不同编译器的编译性能,g版本9.3.0,clang12.0.0。
5.2 解读SIMD指令
最简单的SIMD指令,实现两个数字的加法:
const __m128i dst = _mm_add_epi32(left,right);
这条指令把4组int类型数字相加,填写到结果中。__m128i代表是128位宽寄存器,存放的是int类型(4字节32位),可以存放4个int类型。_mm_and_epi32是一个SIMD指令,_mm开头表示128寄存器,add表示相加,epi32表示32位整数。SIMD指令的命名规范:在SIMD指令中,需要表达三个含义,分别是寄存器宽度、操作类型和参数宽度。
__m128i bitwiseNot(__m128i x){ const __m128i zero = _mm_setzero_si128(); const __128i one = _mm_cmpeq_epi32(zero, zero); return _mm_xor_si128(x, one);} 对应的SIMD指令是_mm_rsqrt_ps,采用SIMD指令可以在一条指令内完成,速度更快。
5.3 手写SIMD指令的缺点
六、结论
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027828/viewspace-3001751/ ,如需转载,请注明出处,否则将追究法律责任。

