全文共 1965个字,建议阅读 3 分钟
传统上,企业中数据仓库作为全企业数据汇聚的场所,不能直接保留原系统名称,需要进行规范命名,其命名规范也是数据标准的一部门。本文介绍的规范可供大家参考!
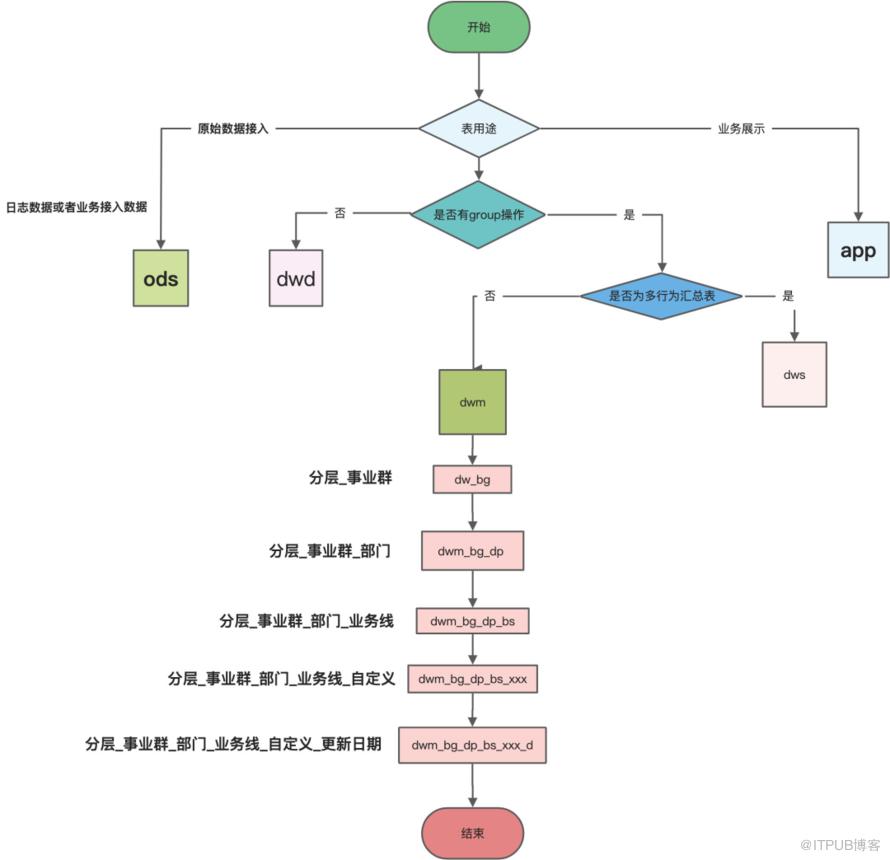
分层:表的使⽤范围 事业群和部门:⽣产该表或者该数据的团队 业务线:表明该数据是哪个产品或者业务线相关 主题域:分析问题的⾓度,对象实体 ⾃定义:⼀般会尽可能多描述该表的信息,⽐如活跃表、留存表等 更新周期:⽐如说天级还是⽉级更新
公⽤维度:dim DM 层:dm ODS 层:ods DWD 层:dwd DWS 层:dws
⽇快照:d 增量:i 全量:f 周 :w 拉链表:l ⾮分区全量表:a
常规表是我们需要固化的表,是正式使用的表,是⽬前⼀段时间内需要去维护去完善的表。 **规范:分层前缀[dwd|dws|ads]部门业务域_主题域XXX更新周期|数据范围** 业务域、主题域我们都可以⽤词根的⽅式枚举清楚,不断完善。 更新周期主要的是时间粒度、⽇ 、⽉ 、年、周等。
中间表⼀般出现在 Job 中,是 Job 中临时存储的中间数据的表,中间表的作⽤域只限于当前 Job 执⾏过程中,Job ⼀旦执⾏完成,该中间表的使命就完成了,是可以删除的 (按照⾃⼰公司的场景自由选择,以前公司会保留⼏天 的中间表数据,⽤来排查问题) 。 **规范:mid_table_name_ [0~9|dim] ** table_name 是我们任务中⽬标表的名字,通常来说⼀个任务只有⼀个⽬标表。这⾥加上表名,是为了防⽌⾃由发挥的时候表名冲突,⽽末尾 ⼤家可以选择⾃由发挥,起⼀些有意义的名字,或者简单粗暴,使⽤数字代替,各有优劣吧,谨慎选择。通常会遇到需要补全维度的表,这里使⽤ dim 结尾。如果要保留历史的中间表,可以加上⽇期或者时间戳。
临时表是临时测试的表,是临时使用一次的表,就是暂时保存下数据看看,后续一般不再使用的表,是可以随时删除的表。 **规范:tmp_xxx ** 只要加上 tmp 开头即可,其他名字随意,注意 tmp 开头的表不要⽤来实际使⽤, 只是测试验证而已。
维度表是基于底层数据,抽象出来的描述类的表。维度表可以⾃动从底层表抽象出来,也可以⼿⼯来维护。 **规范:dim_xxx ** 维度表,统⼀以 dim 开头,后⾯加上,对该指标的描述。
所有单词⼩写 单词之间下划线分割 (反例:appName 或 AppName) 可读性优于长度 (词根,避免出现同⼀个指标,命名⼀致性) 禁止使用 sql 关键字,如字段名与关键字冲突时 +col 数量字段后缀 _cnt 等标识... ⾦额字段后缀 _price 标识 天分区使⽤字段 dt,格式统⼀ (yyyymmdd 或 yyyy-mm-dd) ⼩时分区使⽤字段 hh,范围 (00-23) 分钟分区使⽤字段 mi,范围 (00-59) 布尔类型标识:is_{业务},不允许出现空值
结合指标的特性以及词根管理规范,将指标进⾏结构化处理。
基础指标词根,即所有指标必须包含以下基础词根。 业务修饰词,用于描述业务场景的词汇,例如 trade-交易。 日期修饰词,用于修饰业务发生的时间区间。 聚合修饰词,对结果进⾏聚集操作。 基础指标,单⼀的业务修饰词+基础指标词根构建基础指标,例如:交易⾦额 -trade_amt。 派⽣指标,多修饰词+基础指标词根构建派⽣指标。派⽣指标继承基础指标的特性,例如:安装门店数量-install_poi_cnt。 普通指标命名规范,与字段命名规范⼀致,由词汇转换即可以。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027827/viewspace-2964555/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
