来源:PostgreSQL学徒
前言
现今时序数据的应用场景十分广泛,许多类型的数据都是时序数据,像传感器测量、工厂设备健康、交通物流等等。现代业务对数据价值挖掘的需求已不仅仅停留在简单计算和绘制图表的层面上,而是需要更多精细、复杂的计算分析,高压缩比,高写入吞吐量,以及高速的时间序列查询,是时序数据库相比于关系数据库在处理海量时序数据方面的最基本的能力和优势。随着近几年IoT、IIoT、AIoT和智慧城市快速发展,时序数据库也成为数据架构技术栈的标配。
为什么需要时序数据库
通过保留数据固有的时间序列性质,我们可以记录下事物是如何随时间变化的事实,正因如此,这一反应真实的客观属性使得时序数据在特定的场景中充满了商业价值,通过分析时序数据,为决策者提供依据。一个单纯的温度数字 37.5° 没有任何意义,结合上下文,让一个个"静态画面"变成一个动画,时序便是这样一种视角,以洞悉过去,展望未来,决断现在。想要记录并分析时序数据也带来一个明显的问题:由于时序数据产生的速度非常快,且规模庞大,如何以一种高性能的方式记录、查询和分析如此大规模的数据,成为了一个难题,时序数据库应运而生。
时序数据的特征
多:数据格式多样,时序、空间、JSON、结构化、非结构化等等 大:数据体量庞大,数据存储和处理成本高 高:数据时效性高,对实时处理能力要求高,数据都有统计、聚合等实时计算操作,而不是传统 T+N 的离线分析方式 小:数据价值密度小,获取有效数据代价高 少:数据很少有更新或删除操作,数据已写入操作为主,读操作为辅
因此时序数据的特征决定了一款优秀的时序数据库应具备的特点:
压缩能力:数据压缩可以降低存储成本,同时还不能影响近期数据的写入、更新、明细查询的效率,同时搭配分级存储,热、温、冷多级存储。 留存能力:时序数据的价值随着时间的流逝不断降低,需要过期数据保留策略,自动管理数据生命周期 分片,水平扩展:单节点容易成为瓶颈,需要有水平扩展的能力,分布式支持 写入性能:高写入吞吐量是时序数据的关键特点,并发写入量大 易用性:SQL,多语言连接器,RESTful接口等等 高效分析能力:数据存入之后,最终的目的是挖掘出数据中的价值,单条数据价值低,因此往往是一次查询多条、多个范围的数据,或者进行聚合等,这需要数据库提供强大的分析能力。
TimescaleDB简介
TimescaleDB 是基于 PostgreSQL 打造的一款时序数据库,采用插件的形式,可以跟随社区主版本,融合 PostgreSQL 生态,使得PostgreSQL 也一跃成为一款优秀的时序数据库。TimescaleDB 在 PostgreSQL 的总时间的十五分之一内加载十亿行数据库,并且在更大数据写入量时,吞吐量甚至超过 PostgreSQL 20 倍。
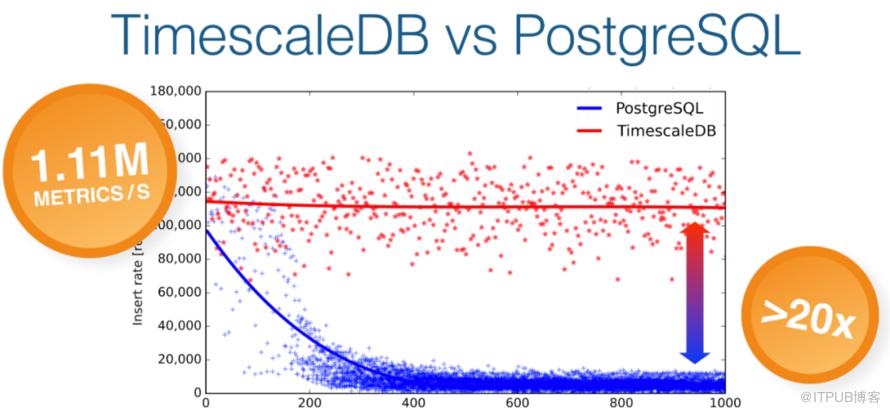
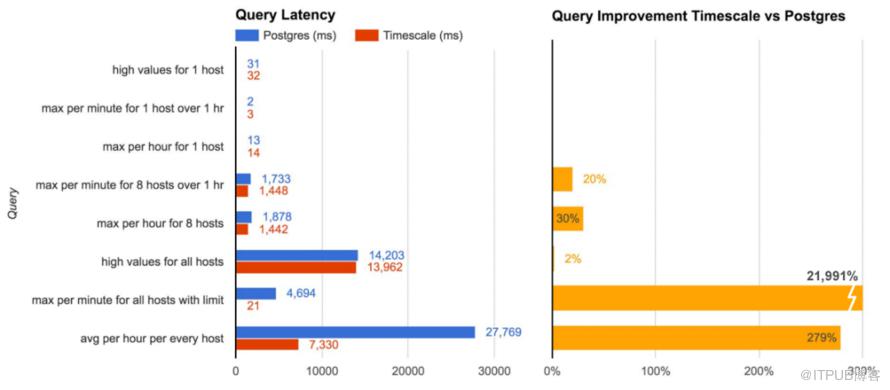
TimescaleDB包含以下特性:
Open source (Apache 2.0, Timescale License) Self-hosted / Cloud (AWS, Azure, GCP) / Fully-managed (SaaS) PostgreSQL ecosystem + TimescaleDB tools (Promscale, Tune, etc) Hypertables and distributed hypertables Full SQL + TimescaleDB hyperfunctions,除了完善的 SQL 能力,还提供了很多面向时序的分析函数,比如 time_bucket,支持任意时间间隔,比如要统计过去 5 分钟的平均车速;last(temperture,time) 根据聚合的时间返回最新的温度值;更多信息可以参考 https://docs.timescale.com/api/latest/hyperfunctions Real-time continuous aggregates,持续聚集、实时聚集,当添加新数据或修改旧数据时,会在后台自动刷新 Data retention,搭配 drop_chunks 和作业实现 Downsampling User-defined actions,User-defined actions let you schedule custom-defined procedures to run within Timescale. Native compression,压缩需要制定 segment_by 和 order by,一般选择有查询需求,有重复值的字段设置为 segment_by;其次支持多样的压缩算法,Delta-delta encoding, Simple-8b, XOR-based compression 等等 Massive scaling Function pipelines*
除此之外,有一点必须要提一下:TimescaleDB 还支持了 Index skip scan,加速 distinct。
另外关于 TimescaleDB 的压缩,也有"列存"的概念,不过并非 CK 这类的原生列存,其本质上就是利用数组存储多值,多条记录,给定一批数据(约 1,000 行),每列数据都会聚合到一个数组中,每个数组元素对应于原始行之一的值,比如原来的数据是
| Timestamp | Device ID | Status Code | Temperature |
|-----------|-----------|-------------|-------------|
| 12:00:01  | A         | 0           | 70.11       |
| 12:00:01  | B         | 0           | 69.70       |
| 12:00:02  | A         | 0           | 70.12       |
| 12:00:02  | B         | 0           | 69.69       |
| 12:00:03  | A         | 0           | 70.14       |
| 12:00:03  | B         | 4           | 69.70       |
通过压缩,转变为如下形式:
| Device ID | Timestamp                      | Status Code | Temperature           |
|-----------|--------------------------------|-------------|-----------------------|
| A         | [12:00:01, 12:00:02, 12:00:03] | [0, 0, 0]   | [70.11, 70.12, 70.14] |
| B         | [12:00:01, 12:00:02, 12:00:03] | [0, 0, 4]   | [69.70, 69.69, 69.70] |
即使在应用压缩算法之前,这种格式也可以通过大大减少 Timescale 的内部每一行的存储开销来节省存储空间 (Tupleheader至少23个字节)。
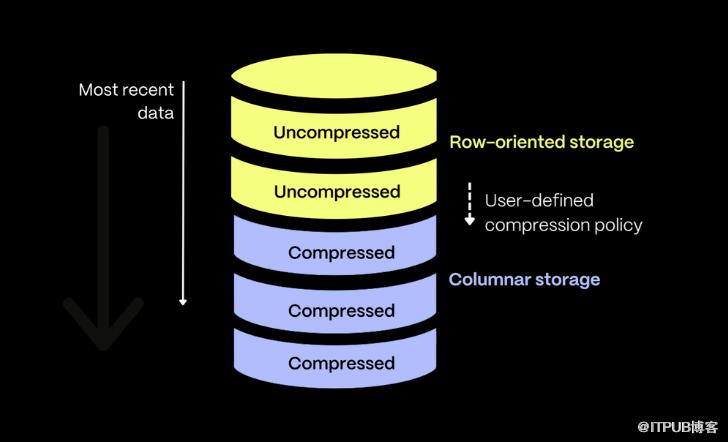
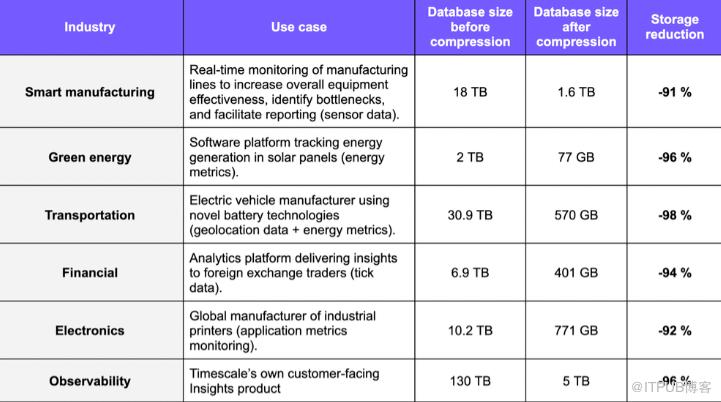
压缩效率杠杠的
架构
TimescaleDB 中的表叫做超表——Hypertable,每个分片叫做一个"chunk",超表可以理解成一个虚拟层、代理层,一个视图,实际是一个分区表,各个 chunk 是通过继承实现的分区表,这些对于用户是完全透明的,使用超表和使用普通的表无异,不过既然是分区表,那么唯一索引必须包含分区列这个限制还是存在的。
In other words, TimescaleDB exposes what look like regular tables, but are actually only an abstraction (or a virtual view) of many individual tables comprising the actual data. This single-table view, which we call a hypertable, is comprised of many chunks, which are created by partitioning the hypertable's data in either one or two dimensions: by a time interval, and by an (optional) "partition key" such as device id, location, user id, etc.
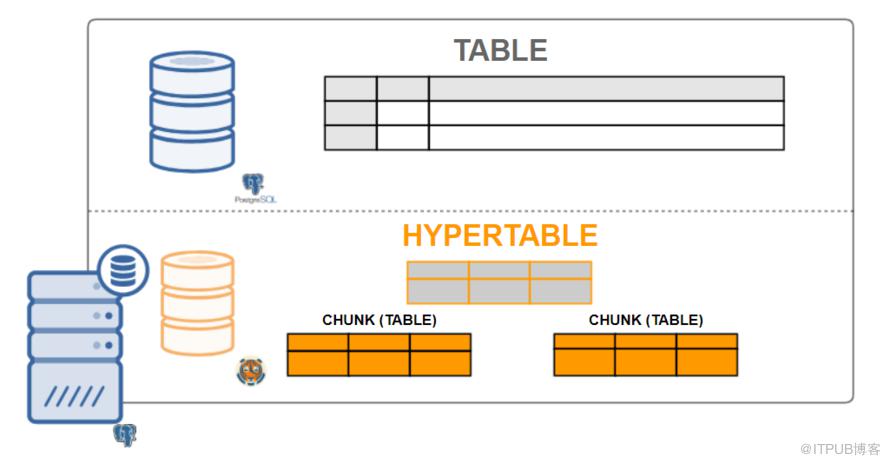
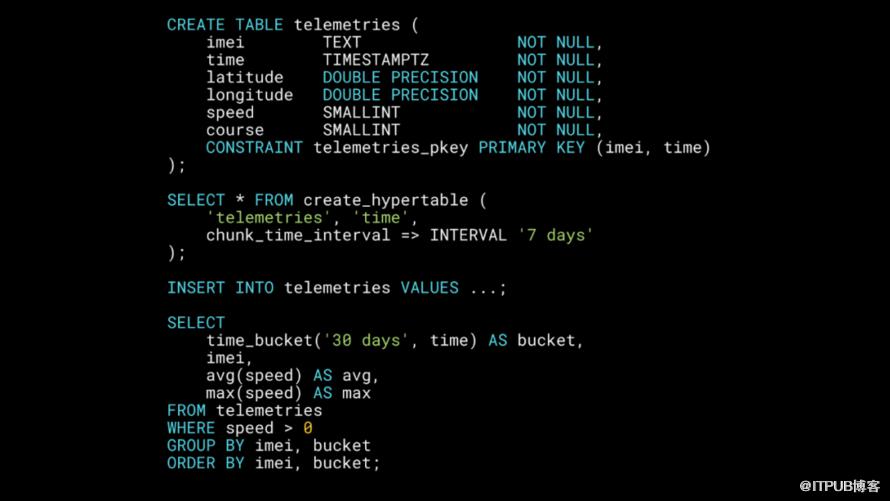
数据会自动按时间和空间分片,当然还可以选择space partition,语法很简单,通过 create_hypertable 将其转化为超表,chunk 实际存储在 _timescaledb_internal 模式下。
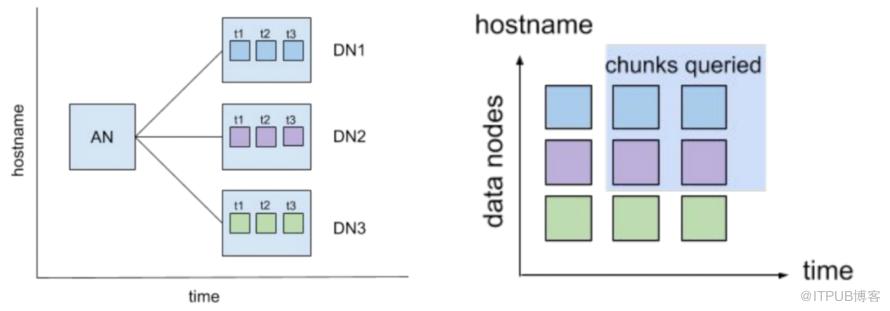
另外,TimescaleDB还支持分布式部署,AN 节点即访问节点 (Access Node),DN (data node) 节点存放分片数据,借助 PG 原生的预备事务实现两阶段事务,保证一致性,因此需要配置 max_prepared_transactions。
不过可惜的是,后续 TimescaleDB 不再维护分布式了,也就意味着后续版本不会再支持集群部署了。TimescaleDB 官方认为分布式实现带来了诸多挑战与限制,并且当前 TimescaleDB 部署中只有 1% 的量是集群模式,维护此功能所涉及的复杂性已成为一个重大障碍,维护需要耗费巨大精力,因此 TimescaleDB 选择的是舍弃集群模式,在单机模式下继续深入,持续优化写入和读取能力,目前 TimescaleDB 已将单节点部署扩展为每秒处理 200 万次插入,并不断利用云技术来解决扩展性问题。
Multi-node support has been deprecated. TimescaleDB 2.13 is the last version that will include multi-node support. Multi-node support in 2.13 is available for PostgreSQL 13, 14 and 15. This decision was not made lightly, and we want to provide a clear understanding of the reasoning behind this change and the path forward.
分布式超表的使用方式也很简单,添加节点,创建分布式超表:
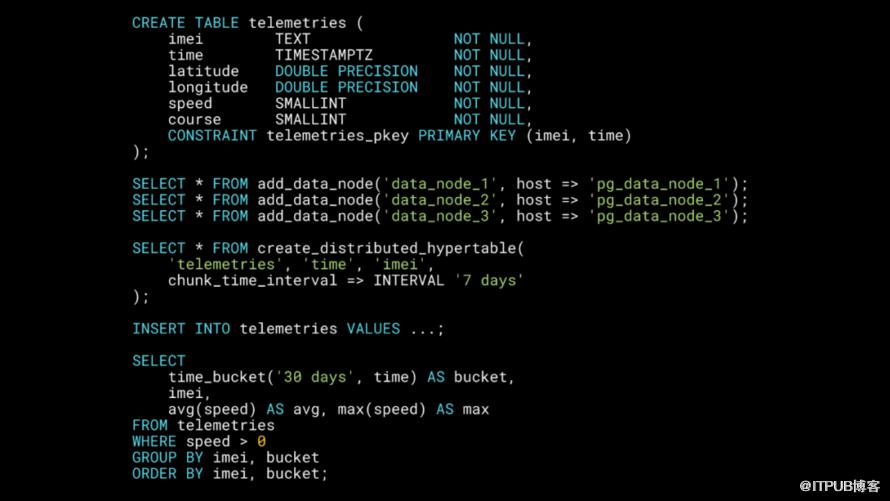
集群模式随着节点的增加,可近线性地提升写入和读取能力,所以 TimescaleDB 官方放弃继续支持集群模式,还是有点令人扼腕的。
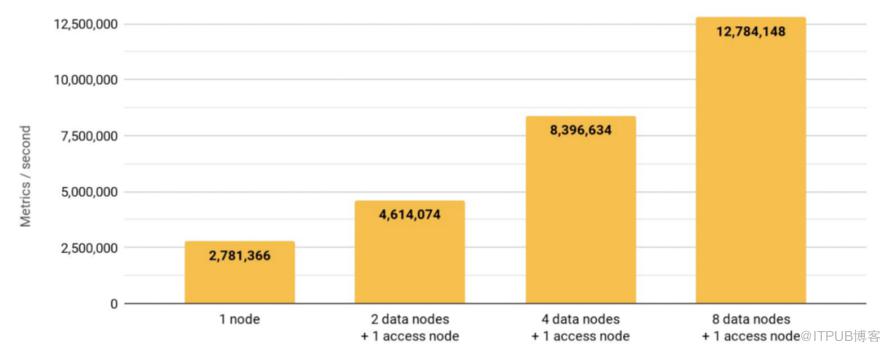
但是另一方面,看一下目前分布式超表的限制,也就能理解为何官方会这么选择了
Distributed scheduling of background jobs is not supported. Background jobs created on an access node are scheduled and executed on this access node without distributing the jobs to data nodes. 在访问节点上创建的后台作业会在此访问节点上调度和执行,而不会将作业分发到数据节点。 Continuous aggregates can aggregate data distributed across data nodes, but the continuous aggregate itself must live on the access node. This could create a limitation on how far you can scale your installation, but because continuous aggregates are downsamples of the data, this does not usually create a problem. 持续聚集可以聚合分布在数据节点上的数据,但持续聚集本身必须存在于访问节点上。 Reordering chunks is not supported. 不支持重排 chunks,类似于 CLUSTER Tablespaces cannot be attached to a distributed hypertable on the access node. It is still possible to attach tablespaces on data nodes. Roles and permissions are assumed to be consistent across the nodes of a distributed database, but consistency is not enforced. Joins on data nodes are not supported. Joining a distributed hypertable with another table requires the other table to reside on the access node. This also limits the performance of joins on distributed hypertables. 数据节点上不支持关联。将分布式超表与另一个表进行关联的话,需要另一个表也存在于访问节点上。 Tables referenced by foreign key constraints in a distributed hypertable must be present on the access node and all data nodes. This applies also to referenced values. Parallel-aware scans and appends are not supported. Distributed hypertables do not natively provide a consistent restore point for backup and restore across nodes. Use the create_distributed_restore_pointcommand, and make sure you take care when you restore individual backups to access and data nodes. 分布式超级表不本质上提供跨节点备份和恢复的一致还原点。For native replication limitations, see the native replication section. User defined functions have to be manually installed on the data nodes so that the function definition is available on both access and data nodes. This is particularly relevant for functions that are registered with set_integer_now_func.
小结
TimescaleDB 是基于 PostgreSQL 的时序数据库插件,完全继承了 PostgreSQL 的功能,可以跟随社区版本,融合 PostgreSQL 生态,使得 PostgreSQL 面对多样复杂的场景也能够游刃有余, TimescaleDB(时序) + Postgis(地理) + Citus(分布式) + pgvector(向量检索) + AGE(图) + pipelinedb(流式处理) ... 表示要打十个。
总而言之,TimescaleDB 通过 hack 存储层,使得 PostgreSQL 摇身一变,成为一个时序数据库,并且有鼻有眼,做的还不赖。Give it a try!
参考
https://www.timescale.com/blog/building-columnar-compression-in-a-row-oriented-database/
TimescaleDB 2.0
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027826/viewspace-3000559/ ,如需转载,请注明出处,否则将追究法律责任。

