来源:木讷大叔爱运维
何其幸哉
人生幸事是什么,就是遇到了“与其锦上添花,不如雪中送碳”的小伙伴。
最近和某位小伙伴聊起了系统的容灾演练,而正好这也是我们所欠缺的,所以就请教了一番。虽然我们都是运维,视角可能没有很多技术大佬、架构师的全面性,但是在容灾演练时,运维却是实际的操控者,因此深知其中的关键性。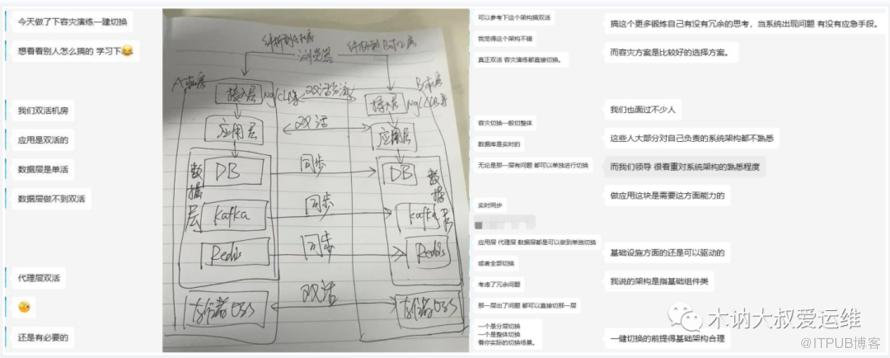
基础架构合理性
虽然我们的应用架构都是以集群高可用为前提进行部署的,考虑的基本都是单机房情况,但是在主备或双活机房情况下切换就会捉襟见肘。因此基础架构在多数据中心是否合理就十分重要,同时这也决定着运维后续如何更快速、更平稳的进行容灾切换。
那么面对多数据中心,我们当前的应用架构应该如何演进呢?这个答案不是我这个运维能够解答的,但是这不妨我们去参考一些过来人的案例,例如「携程的Apollo」 。
Apollo 分布式配置管理中心
Apollo 最首要的功能是能够统一管理不同环境、不同集群的配置。
Apollo提供了一个统一界面集中式管理不同环境(environment)、不同集群(cluster)、不同命名空间(namespace)的配置。 同一份代码部署在不同的集群,可以有不同的配置,比如zk的地址等。 通过命名空间(namespace)可以很方便的支持多个不同应用共享同一份配置,同时还允许应用对共享的配置进行覆盖。
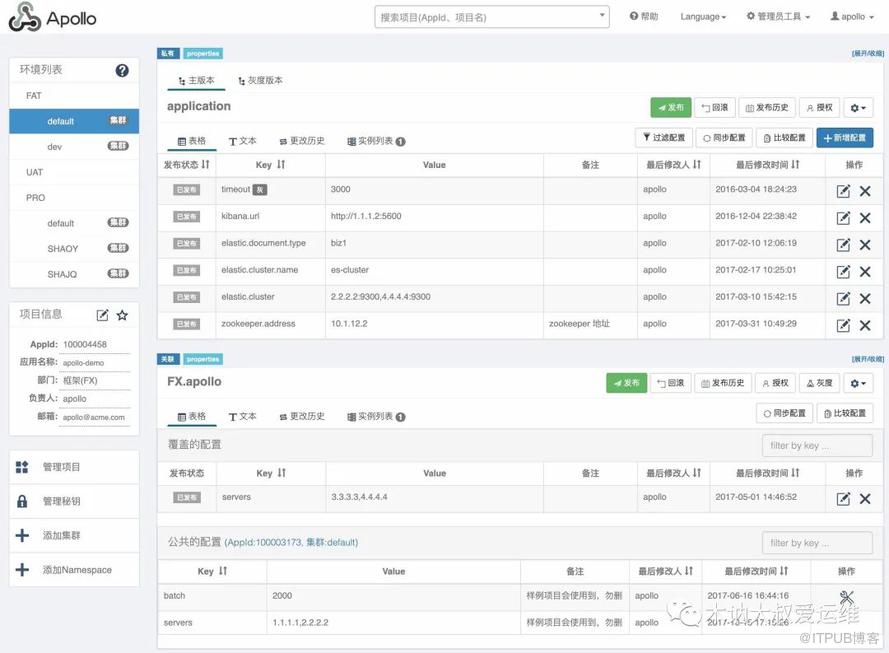 通过上图我们可以看到,环境列表中区分FAT、UAT、PRO等多个环境,而PRO环境又区分了default、SHAOY、SHAJQ多个数据中心的集群。
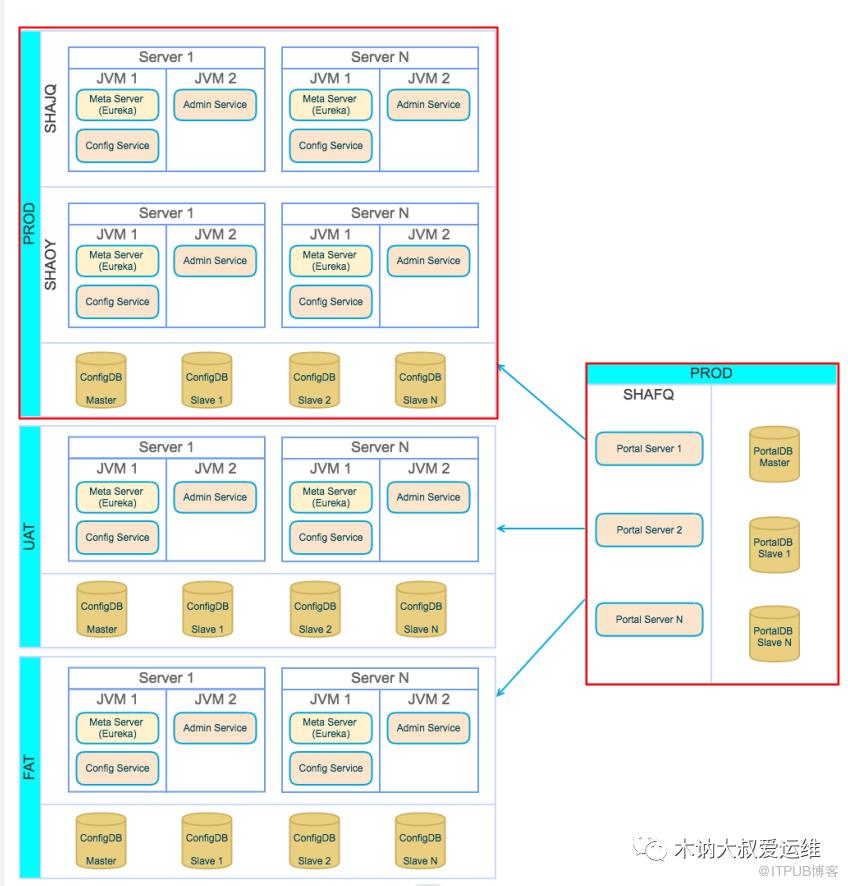
Apollo 多数据中心架构图
Portal部署在生产环境的机房,通过它来直接管理FAT、UAT、PRO等环境的配置。
Meta Server、Config Service和Admin Service在每个环境都单独部署,使用独立的数据库 「Meta Server、Config Service和Admin Service在生产环境部署在两个机房,实现双活。ConfigDB和 PortalDB连接同一个,如SHAOY、SHAJQ两个数据中心使用的都是一套。但需要注意的是要自行选用合适的MySQL架构以及部署方式 。」 Meta Server和Config Service部署在同一个JVM进程内,Admin Service部署在同一台服务器的另一个JVM进程内
❝携程Apollo https://www.apolloconfig.com/#/zh/README https://www.apolloconfig.com/#/zh/deployment/deployment-architecture
❞
架构梳理
从Apollo 的架构模块来看,包含统一门户、应用系统、微服务、注册中心、数据库等组件,我们可将其放大并类比我们的整套应用架构。在PROD 环境下,多数据中心的架构可概括为:
统一门户,可理解为基础组件类服务的管理端,可实现对基础组件多区域管理; 数据库在多数据中心要数据同步,访问的都是一侧数据中心的主库; 微服务的各应用及注册中心在各机房独立部署; 适合多数据中心的一套域名命名规则及相应的DNS API;
试想一下,如果我们把Apollo的这套管理体系应用到数据中心的接入层、应用层、数据层的相关组件,那我们就有了可多区域管理的能力。但是除了平台自身的管理能力,还需要一定的API 管控能力,而且平台管理能力和API管理能力要区分优先级,例如:API管理能力 > 平台管理能力,因为这可能会对后续流水线的编排会有影响。
对于应用架构,运维虽然不能驱动改变,但是我们一定要熟悉系统架构,知道基础架构在一定场景下的合理性,如果条件允许的话,可以向架构师提出自己的一些想法。
一键切换即流水线
当围绕双数据中心的一套基础架构优化完毕后,其实也并不意味着剩下的就是具体的切换工作。因为多数据中心的建设,是对RPO、RTO有一定要求的,一旦出现灾难性的情况,我们就需要进行快速切换,而这是以自动化为前提的。此时运维的自动化建设的重要性就体现出来了:
你写过的每一份标准规范,如目录规范、DNS规范、启动规范等; 你的IaC规划,基于不同运维场景的快速交付; 你的CMDB,提供基于业务级别、集群级别、应用级别的快速查询; 你的监控,对快速切换的应用、基础类组件等不同场景的监控项准确查询;
因此容灾演练下的快速切换是检测我们运维自动化程度的一种非常好的方式,可谓是高低立现!
那么如何让运维的自动化更好的发挥作用?此时就要用到流水线,例如容灾演练场景之一的应用系统一键切换。
流水线规划
 双数据中心环境下,除了apollo、网关、中间件等基础组件外,其他组件区分数据中心,我们在此规划了两条流水线。
cmdb模块无论在 哪个IDC 都会用到,因此我们通过 cmdb-A、cmdb-B区分不同区域的CMDB,当然也可以有一套CMDB,管理多个区域的资产。CMDB此时提供了业务级别、集群级别、应用级别的查询,功能类似DNS,能够给切换带来更高维度的解析。对于A机房、B机房的流水线,功能虽然一样,但具体配置是适配机房的。这将意味着无论使用哪条流水线,都可以实现应用级别的互切。 每个流水线模块,需要各组件提供相应的API 管理能力,这就要求提前规划组件的选择或后续的功能二开需求。
应用切换
以下是主备数据中心的容灾演练场景之一的应用系统切换, app1 虽然在双数据中心都运行,但在B机房不承接流量。应用切换步骤如下:
gw网关将应用由 ”A组“ 切换至”B组 “; 摘除 A机房 应用 连接的 mq 队列; 添加 B机房 应用 连接的 mq 队列;
注意:mq队列相关操作,需要根据要切换的目的区域,需获取不同的CMDB下的应用集群资产列表,以实现批量操作。当然根据切换粒度不同,我们也需要依次从CMDB获取。
借助流水线,可以将上述步骤通过相关模块进行编排,最终实现秒级切换。
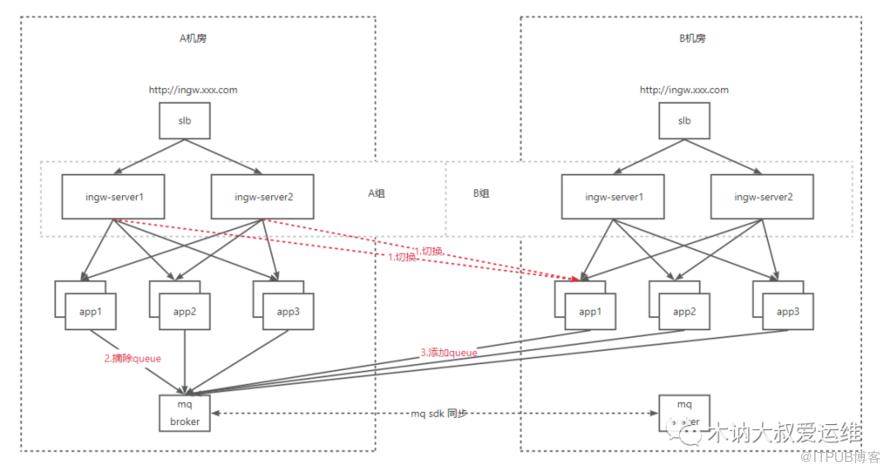 当然以上流水线还不足以覆盖所有的切换场景,只是在一定程度上将运维自动化能力更好的发挥出来。
正如小伙伴提到的“「实际的切换是要区分场景的,例如分层切换、整体切换」”,而且每个层面是否会再细分,也是要根据具体的系统特性去区分,而我们的流水线原子模块也需要去持续适配,这样才能更好的实现一键切换。
总结
“ 向一棵树木学习,或许你就能成为一棵参天大树 ”,这次交流虽然简洁,但却是让我认识到很多:
运维不仅要懂业务,还要懂技术架构; 运维自动化建设,流水线才是灵魂; 运维永远要比其他人多一步的思考,不仅要有冗余方案,还要有应急方案;
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027825/viewspace-2980489/ ,如需转载,请注明出处,否则将追究法律责任。

