来源:大数据技术与数仓
写在前面
决策树是一类常见的机器学习方法。以二分类任务为例,从给定的训练数据集中学得一个模型用以对新的数据进行分类,属于监督学习的一种算法。二分类是分类问题中最简单的一个方法,即通过已有的特征属性判断事物或者事件的类别,其产生的结果只有1或者0,即要么属于该类别,要么不属于该类别。分类模型有着广泛的应用,比如
对图片、视频或者音频进行分类; 对新闻、网页或者其他内容标记类别; 银行对贷款风险的评估,预测是否会拖欠贷款; 信用卡分级,将信用卡分为低、中、高风险; 预测用户是否会购买某个产品或者服务
本文将介绍决策树算法的基本原理和实现过程,通过本文你可以收获:
决策树算法基本原理 如何实现一个决策树算法 决策树算法的应用
希望本文对你有所帮助。
什么是决策树
一般的,一个决策树包含一个根节点、若干个内部节点和若干个叶子节点,叶子节点对应于决策结果,其他每个节点则对应于一个属性测试,决策树学习的目的是为了产生一颗泛化能力强的决策树,其基本流程遵循简单且直观的分而治之的策略。
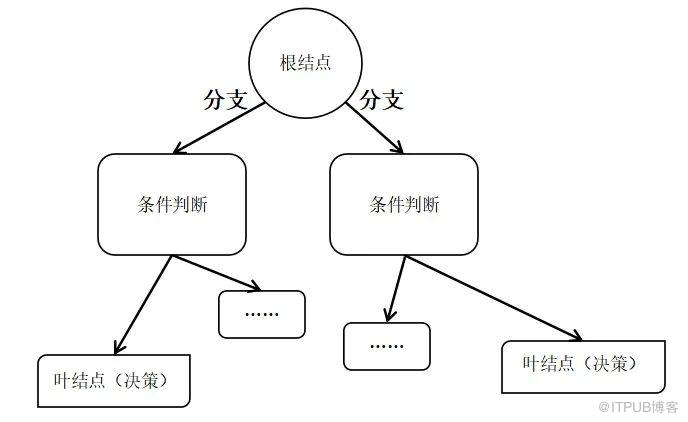
决策树构建
原理
决策树的树型结构决定了构建一个决策树的方法与过程。构建决策树的基本思想是递归地从所有可选的属性中选择最优的分裂属性,直至满足某个结束条件为止。
初始构建决策树时,根节点代表所有的训练样本数据集,对于任意一个节点(包括根节点),如果对应的样本均为同一类,则该节点就成为叶子节点并标记为该类别,否则将会选择分裂属性,分裂属性的每一个值均对应一个要创建的分支,这个分支或连接一个叶子节点(类型),或连接一个内部节点(对应一个分裂属性)。
递归使用上述过程,即可为每个分支赋予一个节点,该节点是将要递归生成的决策树的根节点。在整个构建决策树的过程中,一个属性一旦在某个节点出现,那么它就不会再次出现,因此已经被选中的分裂属性会从候选属性中删除。
下面是一个简单的例子,演示了如何使用决策树算法来构建一个模型:
假设我们有一个水果数据集,其中包含水果的品种、颜色、形状、大小、价格等信息。我们的任务是根据这些信息,将水果分为两个类别:“苹果”和“非苹果”。
首先,我们可以选择一个初始特征(例如颜色),将数据集按照颜色这个特征进行分割。例如,如果颜色为红色,则进入一个分支,如果颜色为非红色,则进入另一个分支。在每个分支上,我们继续选择下一个特征进行分裂,直到达到叶子节点。
分裂属性选择
在构建决策树的构建方法中,如何选择分裂属性是关键,关于分裂属性的选择,通常有两种方式:信息增益方法和基尼系数。两种方法有很多类似的地方,本文将着重介绍信息增益方法。
我们都知道,信息的作用是减少不确定性,训练集的数据中的每个属性都包含了一定的信息,这些信息的作用就是减少整个数据集的不确定性。通常可以使用信息熵来描述这种信息的不确定性。用于度量样本集合纯度的一种指标。信息增益的方法就是通过选择最高信息增益的属性来作为当前节点的分裂属性的,以使得划分的训练样本子集进行分类所需要的信息最少。
具体说来,信息论认为:一个消息所表达的信息量取决于它的的概率P,并且可以用-log2(p) 来表示包含的信息量,log2(p) 表示 p 的以 2 为底的对数。之所以是以2为底,是因为信息论中信息都是按照二进制进行编码的。举个例子:如果有8个出现概率相同的信息,那么它们中的任何一个所表达的信息量都是-log2(1/8)。
假设从一个数据集T中随意抽出一个样本并说明它属于某个类别Ck,那这个消息出现的概率为:freq(Ck,T)/|T|,它所表达的信心量是-log2(freq(Ck,T)/|T|)。式中,|T|表示数据集T中的记录总数,freq(Ck,T)/|T|表示数据集T中属于Ck类别的记录数,为了鉴别T中某个记录的类别所需的平均信息量(信息熵),可定义info(T)如下:
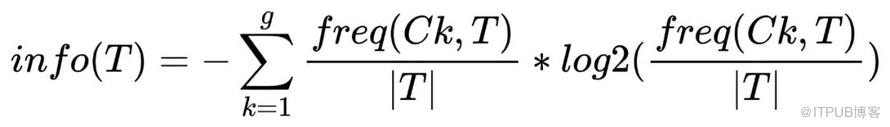
式中,g表示类别的个数。
假设属性A有n个不同的取值,可以将训练的数据集T分为n个子集T1、T2、T3,....Tn。将数据集划分为n个子集之后,期望的平均信息量为:
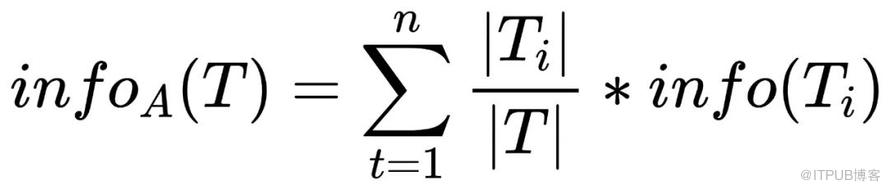
式中,info(Ti)的含义与info(T)类似,区别在于info(Ti)仅仅考虑数据子集Ti中个类别的分布情况。
因此,根据属性A对数据集T进行划分之后所得到信息增益为:

信息增益方法可计算候选属性中的每个属性信息增益,并从中挑选出信息增益最大的属性作为给定集合的分裂属性并由此产生相应的分值节点。所产生的节点被标记为相应的属性,并根据这一属性的不同取值分别产生相应的分支,每个分支代表一个被划分的样本自己。
案例
样本数据集
| 序号 | 食肉 | 产奶 | 有鳍 | 有毒 | 类别 |
|---|---|---|---|---|---|
| 1 | 1 | 0 | 1 | 0 | 鱼类 |
| 2 | 1 | 1 | 0 | 0 | 哺乳动物 |
| 3 | 0 | 0 | 1 | 0 | 鱼类 |
| 4 | 0 | 1 | 0 | 1 | 哺乳动物 |
| 5 | 1 | 0 | 1 | 1 | 鱼类 |
| 6 | 1 | 0 | 0 | 1 | 爬行动物 |
| 7 | 1 | 0 | 1 | 0 | 鱼类 |
| 8 | 1 | 0 | 0 | 1 | 爬行动物 |
| 9 | 1 | 1 | 0 | 0 | 哺乳动物 |
| 10 | 0 | 0 | 0 | 1 | 爬行动物 |
| 11 | 0 | 0 | 0 | 1 | 爬行动物 |
模型训练
以上面的训练数据集为例,其中食肉、产奶、有鳍、有毒分别为四个特征属性,类别则为标签列。目的是通过这些信息训练一个决策树模型,用于对给定的数据集进行分类。该样本数据集记作T,该数据集包含鱼类(C1),爬行动物(C2),哺乳动物(C3)三个类别,有食肉(P)、产奶(M)、有鳍(F)、有毒(V)四个特征属性。根=根据上文的公式:
类别个数g=3,
|T|=11,即总行数
freq(C1,T) = 4,即鱼类出现的频次;freq(C2,T) = 4,即爬行动物出现的频次;freq(C3,T) = 3,即哺乳动物出现的频次;
属性A有n个不同的取值,其中n=2,因为每个属性特征只有0和1两个布尔值。
首先,计算info(T),即所有样本分类需要的期望信息量为:
info(T) = -freq(C1,T)/|T| X log2(freq(C1,T)/|T|) + freq(C2,T)/|T| X log2(freq(C2,T)/|T|) + freq(C3,T)/|T|X log2(freq(C3,T)/|T|)
=-4/11 x log2(4/11) -4/11 x log2(4/11) - 3/11 x log2(3/11) = 1.5726
然后,计算每个属性的期望信息量,以属性P(食肉)为例:
T1= 7,即取值为1的行数,T2=4,即取值为0的行数; 其中freq(C1,T1)=3,即对于鱼类这个类别,食肉属性=1出现的次数,分别对应数据集的序号为1、5、7三行数据 其中freq(C2,T1)=2,即对于爬行动物这个类别,食肉属性=1出现的次数,分别对应数据集的序号为6、8两行数据 其中freq(C3,T1)=2,即对于哺乳动物这个类别,食肉属性=1出现的次数,分别对应数据集的序号为2、9两行数据 其中freq(C1,T2)=1,即对于鱼类这个类别,食肉属性=0出现的次数,分别对应数据集的序号为1的数据 其中freq(C2,T2)=2,即对于爬行动物这个类别,食肉属性=0出现的次数,分别对应数据集的序号为10、11两行数据 其中freq(C3,T2)=1,即对于哺乳动物这个类别,食肉属性=0出现的次数,分别对应数据集的序号为4数据
那么,info(T1) = -freq(C1,T1)/|T1| X log2(freq(C1,T1)/|T1|) + freq(C2,T1)/|T1| X log2(freq(C2,T1)/|T1|) + freq(C3,T1)/|T1|X log2(freq(C3,T1)/|T1|)
=-3/7 x log2(3/7) - 2/7 x log2(2/7) - 2/7 x log2(2/7) = 1.5567
同理,info(T2)= -freq(C1,T2)/|T2| X log2(freq(C1,T2)/|T2|) + freq(C2,T2)/|T2| X log2(freq(C2,T2)/|T2|) + freq(C3,T2)/|T2|X log2(freq(C3,T2)/|T12|)
=-1/4 X log2(1/4) - 2/4 X log2(2/4) - 1/4 X log2(1/4) =1.5000
于是,属性P(食肉)的期望信息量:infoP(T)=|T1|/|T|X info(T1) + |T2|/|T|X info(T2) =7/11*1.5567 + 4/11 * 1.5000 = 1.5361
按照上述方式分别计算infoM(T) = 0.7273,infoF(T) = 0.6270;infoV(T) = 1.1240
因此,根据各个属性对数据集T进行划分之后所得信息增益分别为:
gain(P)= info(T) - infoP(T) = 0.0366 gain(M)= info(T) - infoM(T) = 0.8454 gain(F)= info(T) - infoF(T) = 0.9457 gain(V)= info(T) - infoV(T) = 0.4486
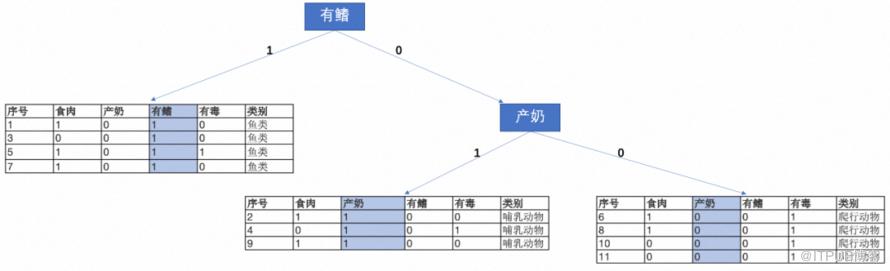
所以,最优分裂属性为数据集T中所有属性信息增益最大的属性,因此本数据集最优的分裂属性为有鳍(F),这样就可以把其作为根节点,并对F的每个属性值引出一个分支,当F=1时,所有的样本均属于同一类别,因此为该分支创建一个叶子节点,标记为鱼类。
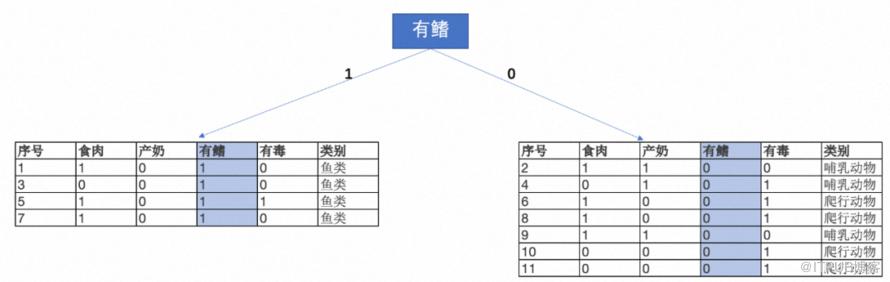
接下来,针对F=0的数据,需要再次选择分裂属性,按照上述的方式重新计算信息熵,可以计算出分裂属性产奶(M),并针对M的每个属性值引入一个分支,当M=1或者M =0时,相应的样本均属于同一类别,如下图所示:
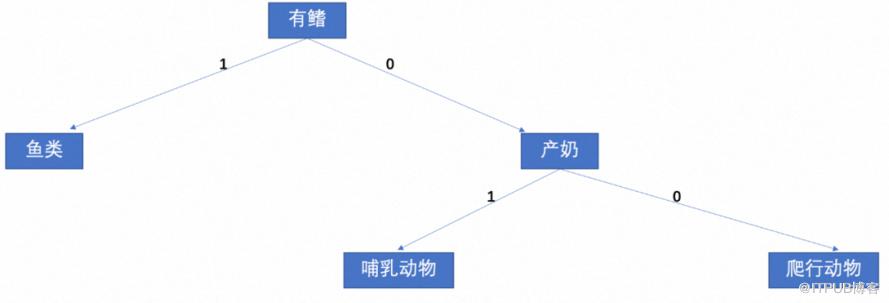
此时决策树符合当前节点的所有样本均为同一类别,则停止改构建过程,最终的决策树模型为:
预测
假设有一行数据,判断数据的分类
| 序号 | 食肉 | 产奶 | 有鳍 | 有毒 | 类别 |
|---|---|---|---|---|---|
| 1 | 1 | 0 | 0 | 0 | ? |
根据上述模型,有鳍特征属性=0,判断产奶特征属性,产奶=0,则归为爬行动物,所以改行数据的预测值为:爬行动物。
算法实现
算法案例
数据集
| ID | 年龄 | 有工作 | 有自己房子 | 信贷情况 | 类别 |
|---|---|---|---|---|---|
| 1 | 青年 | 否 | 否 | 一般 | 否 |
| 2 | 青年 | 否 | 否 | 好 | 否 |
| 3 | 青年 | 是 | 否 | 好 | 是 |
| 4 | 青年 | 是 | 是 | 一般 | 是 |
| 5 | 青年 | 否 | 否 | 一般 | 否 |
| 6 | 中年 | 否 | 否 | 一般 | 否 |
| 7 | 中年 | 否 | 否 | 好 | 否 |
| 8 | 中年 | 是 | 是 | 好 | 是 |
| 9 | 中年 | 否 | 是 | 非常好 | 是 |
| 10 | 中年 | 否 | 是 | 非常好 | 是 |
| 11 | 老年 | 否 | 是 | 非常好 | 是 |
| 12 | 老年 | 否 | 是 | 好 | 是 |
| 13 | 老年 | 是 | 否 | 好 | 是 |
| 14 | 老年 | 是 | 否 | 非常好 | 是 |
| 15 | 老年 | 否 | 否 | 一般 | 否 |
在编写代码之前,我们先对数据集进行属性标注。
年龄:0代表青年,1代表中年,2代表老年; 有工作:0代表否,1代表是; 有自己的房子:0代表否,1代表是; 信贷情况:0代表一般,1代表好,2代表非常好; 类别(是否给贷款):no代表否,yes代表是。
模型训练
根据上述的方式计算,首先是找分裂属性:第一步计算所有样本分类需要的期望信息量为:
总共有15行数据,其中类别为是的有9行,类别为否的有6行,那么info(T) = -9/15 X log2(9/15) -6/15 X log2(6/15)=0.9709505944546686
第二步计算计算每个属性的期望信息量:
以有自己的房子这个属性为例:
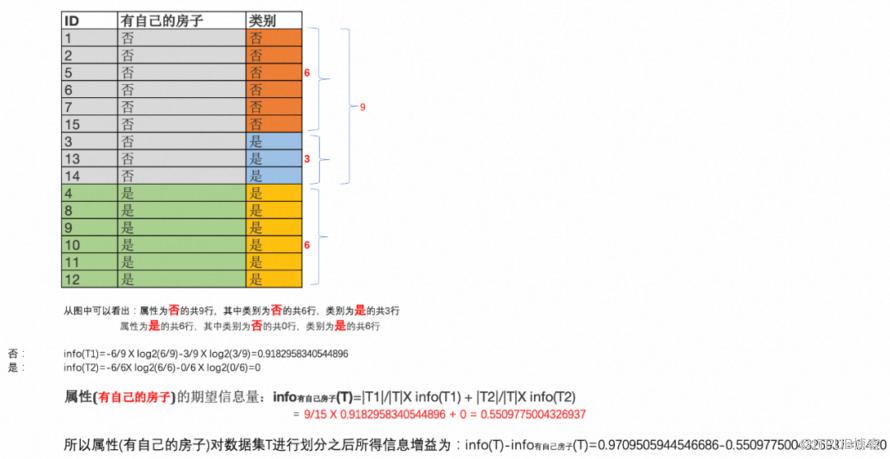
按照此种方式计算的其他属性的信息增益为:
第0个特征(年龄)的信息增益为0.083
第1个特征(有工作)的信息增益为0.324
第2个特征(有自己的房子)的信息增益为0.420
第3个特征(信贷情况)的信息增益为0.363
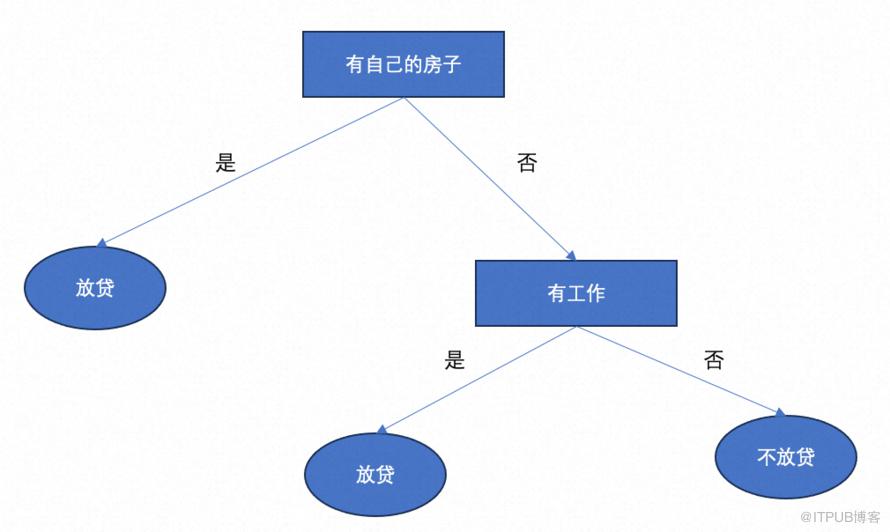
由于特征(有自己的房子)的信息增益为0.420,比其他属性特征的信息增益都大,所以先选择特征(有自己的房子)作为分裂属性。按照上述方式迭代,最终的能到下面的树模型:
Python算法实现
from math import log
import operator
import pickle

##计算T中某个记录的类别所需的平均信息量(信息熵)
def calcShannonEnt(dataSet):
    # 统计数据数量
    numEntries = len(dataSet)
    # 存储每个label出现次数
    label_counts = {}
    # 统计label出现次数
    for featVec in dataSet:
        current_label = featVec[-1]
        if current_label not in label_counts:  # 提取label信息
            label_counts[current_label] = 0  # 如果label未在dict中则加入
        label_counts[current_label] += 1  # label计数

    shannon_ent = 0  # 经验熵
    # 计算经验熵
    for key in label_counts:
        prob = float(label_counts[key]) / numEntries
        shannon_ent -= prob * log(prob, 2)
    return shannon_ent

##根据属性值分割数据集
def splitDataSet(data_set, axis, value):
    ret_dataset = []
    for feat_vec in data_set:
        if feat_vec[axis] == value:
            reduced_feat_vec = feat_vec[:axis]
            reduced_feat_vec.extend(feat_vec[axis + 1:])
            ret_dataset.append(reduced_feat_vec)
    return ret_dataset


def chooseBestFeatureToSplit(dataSet):
    # 特征数量
    num_features = len(dataSet[0]) - 1
    # 计算数据香农熵
    base_entropy = calcShannonEnt(dataSet)
    # 信息增益
    best_info_gain = 0.0
    # 最优特征索引值
    best_feature = -1
    # 遍历所有特征
    for i in range(num_features):
        # 获取dataset第i个特征
        feat_list = [exampel[i] for exampel in dataSet]
        # 创建set集合,元素不可重合
        unique_val = set(feat_list)
        # 经验条件熵
        new_entropy = 0.0
        # 计算信息增益
        for value in unique_val:
            # sub_dataset划分后的子集
            sub_dataset = splitDataSet(dataSet, i, value)
            # 计算子集的概率
            prob = len(sub_dataset) / float(len(dataSet))
            # 计算经验条件熵
            new_entropy += prob * calcShannonEnt(sub_dataset)
        # 信息增益
        info_gain = base_entropy - new_entropy
        # 打印每个特征的信息增益
        print("第%d个特征的信息增益为%.3f" % (i, info_gain))
        # 计算信息增益
        if info_gain > best_info_gain:
            # 更新信息增益
            best_info_gain = info_gain
            # 记录信息增益最大的特征的索引值
            best_feature = i
    print("最优索引值:" + str(best_feature))
    print()
    return best_feature


def majority_cnt(class_list):
    class_count = {}
    # 统计class_list中每个元素出现的次数
    for vote in class_list:
        if vote not in class_count:
            class_count[vote] = 0
            class_count[vote] += 1
        # 根据字典的值降序排列
        sorted_class_count = sorted(class_count.items(), key=operator.itemgetter(1), reverse=True)
    return sorted_class_count[0][0]


def creat_tree(dataSet, labels, featLabels):
    # 取分类标签(是否放贷:yes or no)
    class_list = [exampel[-1] for exampel in dataSet]
    # 如果类别完全相同则停止分类
    if class_list.count(class_list[0]) == len(class_list):
        return class_list[0]
    # 遍历完所有特征时返回出现次数最多的类标签
    if len(dataSet[0]) == 1:
        return majority_cnt(class_list)
    # 选择最优特征
    best_feature = chooseBestFeatureToSplit(dataSet)
    # 最优特征的标签
    best_feature_label = labels[best_feature]
    featLabels.append(best_feature_label)
    # 根据最优特征的标签生成树
    my_tree = {best_feature_label: {}}
    # 删除已使用标签
    del(labels[best_feature])
    # 得到训练集中所有最优特征的属性值
    feat_value = [exampel[best_feature] for exampel in dataSet]
    # 去掉重复属性值
    unique_vls = set(feat_value)
    for value in unique_vls:
        my_tree[best_feature_label][value] = creat_tree(splitDataSet(dataSet, best_feature, value), labels, featLabels)
    return my_tree


def get_num_leaves(my_tree):
    num_leaves = 0
    first_str = next(iter(my_tree))
    second_dict = my_tree[first_str]
    for key in second_dict.keys():
        if type(second_dict[key]).__name__ == 'dict':
            num_leaves += get_num_leaves(second_dict[key])
        else:
                num_leaves += 1
    return num_leaves


def get_tree_depth(my_tree):
    max_depth = 0       # 初始化决策树深度
    firsr_str = next(iter(my_tree))     # python3中myTree.keys()返回的是dict_keys,不在是list,所以不能使用myTree.keys()[0]的方法获取结点属性,可以使用list(myTree.keys())[0]
    second_dict = my_tree[firsr_str]    # 获取下一个字典
    for key in second_dict.keys():
        if type(second_dict[key]).__name__ == 'dict':     # 测试该结点是否为字典,如果不是字典,代表此结点为叶子结点
            this_depth = 1 + get_tree_depth(second_dict[key])
        else:
            this_depth = 1
        if this_depth > max_depth:
            max_depth = this_depth      # 更新层数
    return max_depth


def classify(input_tree, feat_labels, test_vec):
    # 获取决策树节点
    first_str = next(iter(input_tree))
    # 下一个字典
    second_dict = input_tree[first_str]
    feat_index = feat_labels.index(first_str)

    for key in second_dict.keys():
        if test_vec[feat_index] == key:
            if type(second_dict[key]).__name__ == 'dict':
                class_label = classify(second_dict[key], feat_labels, test_vec)
            else:
                class_label = second_dict[key]
    return class_label


def storeTree(input_tree, filename):
    # 存储树
    with open(filename, 'wb') as fw:
        pickle.dump(input_tree, fw)


def grabTree(filename):
    # 读取树
    fr = open(filename, 'rb')
    return pickle.load(fr)


if __name__ == "__main__":
    # 数据集
    dataSet = [[0, 0, 0, 0, 'no'],
               [0, 0, 0, 1, 'no'],
               [0, 1, 0, 1, 'yes'],
               [0, 1, 1, 0, 'yes'],
               [0, 0, 0, 0, 'no'],
               [1, 0, 0, 0, 'no'],
              # [1, 0, 0, 0, 'yes'],
               [1, 0, 0, 1, 'no'],
               [1, 1, 1, 1, 'yes'],
               [1, 0, 1, 2, 'yes'],
               [1, 0, 1, 2, 'yes'],
               [2, 0, 1, 2, 'yes'],
               [2, 0, 1, 1, 'yes'],
               [2, 1, 0, 1, 'yes'],
               [2, 1, 0, 2, 'yes'],
               [2, 0, 0, 0, 'no']]
    # 分类属性
    labels = ['年龄', '有工作', '有自己的房子', '信贷情况']

    print(dataSet)
    print()
    print(calcShannonEnt(dataSet))
    print()

    featLabels = []
    myTree = creat_tree(dataSet, labels, featLabels)
    print(myTree)
    print(get_tree_depth(myTree))
    print(get_num_leaves(myTree))

    #测试数据
    testVec = [0, 1, 1, 1]
    result = classify(myTree, featLabels, testVec)

    if result == 'yes':
        print('放贷')
    if result == 'no':
        print('不放贷')

    # 存储树
    storeTree(myTree,'classifierStorage.txt')

    # 读取树
    myTree2 = grabTree('classifierStorage.txt')
    print(myTree2)

    testVec2 = [1, 0]
    result2 = classify(myTree2, featLabels, testVec)
    if result2 == 'yes':
        print('放贷')
    if result2 == 'no':
        print('不放贷')
阿里云PAI实现
模型训练
DROP TABLE IF EXISTS gbdt_lr_test_input_${bizdate};
--数据集
CREATE TABLE gbdt_lr_test_input_${bizdate}
LIFECYCLE 1 AS
SELECT  *
FROM    (
            SELECT  CAST(0 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(0 AS DOUBLE) AS f4
                    ,CAST(0 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(0 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(1 AS DOUBLE) AS f4
                    ,CAST(0 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(0 AS DOUBLE) AS f1
                    ,CAST(1 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(1 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(0 AS DOUBLE) AS f1
                    ,CAST(1 AS DOUBLE) AS f2
                    ,CAST(1 AS DOUBLE) AS f3
                    ,CAST(0 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(0 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(0 AS DOUBLE) AS f4
                    ,CAST(0 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(1 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(0 AS DOUBLE) AS f4
                    ,CAST(0 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(1 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(1 AS DOUBLE) AS f4
                    ,CAST(0 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(1 AS DOUBLE) AS f1
                    ,CAST(1 AS DOUBLE) AS f2
                    ,CAST(1 AS DOUBLE) AS f3
                    ,CAST(1 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(1 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(1 AS DOUBLE) AS f3
                    ,CAST(2 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(1 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(1 AS DOUBLE) AS f3
                    ,CAST(2 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(2 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(1 AS DOUBLE) AS f3
                    ,CAST(2 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(2 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(1 AS DOUBLE) AS f3
                    ,CAST(1 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(2 AS DOUBLE) AS f1
                    ,CAST(1 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(1 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(2 AS DOUBLE) AS f1
                    ,CAST(1 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(2 AS DOUBLE) AS f4
                    ,CAST(1 AS BIGINT) AS label
            FROM    dual
            UNION ALL
            SELECT  CAST(2 AS DOUBLE) AS f1
                    ,CAST(0 AS DOUBLE) AS f2
                    ,CAST(0 AS DOUBLE) AS f3
                    ,CAST(0 AS DOUBLE) AS f4
                    ,CAST(0 AS BIGINT) AS label
            FROM    dual
        ) a
;

--READ gbdt_lr_test_input_${bizdate};
--训练
DROP OFFLINEMODEL IF EXISTS gbdt_lr_test_model_${bizdate};
DROP TABLE IF EXISTS gbdt_lr_test_output_importance_${bizdate};

PAI -name gbdt_lr
    -project algo_public
    -DoutputImportanceTableName='gbdt_lr_test_output_importance_${bizdate}'
    -DfeatureSplitValueMaxSize="10"    --一个特征分裂的最大数[1,1000] 可选,默认500
    -DrandSeed="1"                      --随机数种子 [0,10] 可选,默认0
    -Dshrinkage="1"                     --学习速率 (0,1] 可选,默认0.05
    -DmaxLeafCount="30"                 --最大叶子数,必须为整数 [2,1000] 可选,默认32
    -DlabelColName="label"              --输入表标签列列名,目前要求是数值列 列名 必选
    -DinputTableName="gbdt_lr_test_input_${bizdate}"  --输入表 表名 必选
    -DminLeafSampleCount="1"                          --叶子节点容纳的最少样本数,必须为整数 [100,1000] 可选,默认500
    -DsampleRatio="1"                                 --训练采集样本比例 (0,1] 可选,默认0.6
    -DmaxDepth="10"
    -DmodelName="gbdt_lr_test_model_${bizdate}"       --输出模型名
    -DmetricType="0"
    -DfeatureRatio="1"
    -DtestRatio="0"
    -DfeatureColNames="f1,f2,f3,f4"                 --输入表中选择的用于训练的特征列名 ,目前要求为数值列
    -DtreeCount="5"                                 --树数量 [1,10000] 可选,默认值500

--READ gbdt_lr_test_output_importance_${bizdate}
预测
--预测
DROP TABLE IF EXISTS gbdt_lr_test_prediction_result_${bizdate};
PAI -name prediction
    -project algo_public
    -DdetailColName="prediction_detail"             --预测的值与概率
    -DmodelName="gbdt_lr_test_model_${bizdate}"     --预测的模型名
    -DitemDelimiter=","
    -DresultColName="prediction_result"             --预测的值,需要输入表的目标列支持多分类
    -Dlifecycle="1"
    -DoutputTableName="gbdt_lr_test_prediction_result_${bizdate}"
    -DscoreColName="prediction_score"               --预测值的概率
    -DkvDelimiter=":"
    -DinputTableName="gbdt_lr_test_input_${bizdate}" --预测输入表的表名
    -DenableSparse="false"
    -DappendColNames="f1,f2,f3,f4,label";           --生成的新表中要显示的列名

 READ gbdt_lr_test_prediction_result_${bizdate}
预测结果
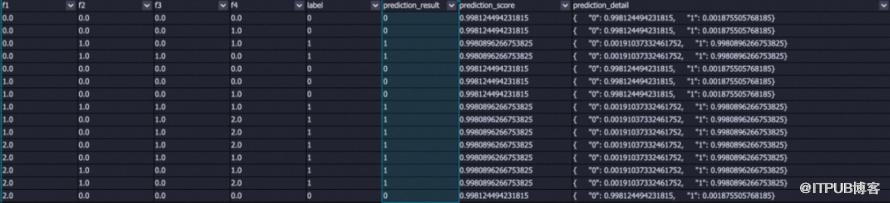
该模型最终预测的结果是分数,即对某行数据判定为某个分类的分数是多少,如下图所示:
总结
本文主要介绍了决策树算法的实现原理,并给出了两个具体的案例,详细地给出了计算过程,最后通过Python和阿里云的PAI平台对改算法进行了实现。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027824/viewspace-2960615/ ,如需转载,请注明出处,否则将追究法律责任。

