如何将 MySQL 数据快速、完整地迁移出来,是不少用户在初次使用 KaiwuDB 时都需要面临的问题。好在 KaiwuDB 很好地兼容 MySQL 协议,支持不同场景下多种迁移策略。今天我们就带着大家详细聊走一遍整个迁移旅,一篇帮助大家捋顺模型差异分析、数据类型映射、表结构迁移、数据迁移、校验回滚等关键步骤,并以实际电商订单 管理场景为大家详细介绍 KaiwuDB 数据迁移工具(KaiwuDB Data Transformer,简称 KDTS)图形化迁移、DataX 脚本迁移和 CSV 离线兜底三种方案。
一、先看:MySQL 与 KaiwuDB 关系引擎的模型差异
在开始迁移前,我们需要先确认两端数据库对象和 SQL 行为的一致性。MySQL 是单机或主从式关系数据库,核心对象包含库、表、索引、约束、视图、存储过程与触发器。KaiwuDB 同样提供标准关系数据库对象,支持关系库和关系表的创建与管理,通过 SQL 操作数据结构与数据。
差异主要集中在三个方面:第一,数据类型与默认值表达方式不同。第二,自增主键、索引、外键、触发器、存储过程等对象的兼容程度。第三,事务边界、锁等待、分页排序、字符集与时区等运行时行为上的差异。迁移前将这些差异梳理清楚,后续的结构迁移和数据校验才能有据可依。

二、再看:对象兼容与 SQL 改造重点
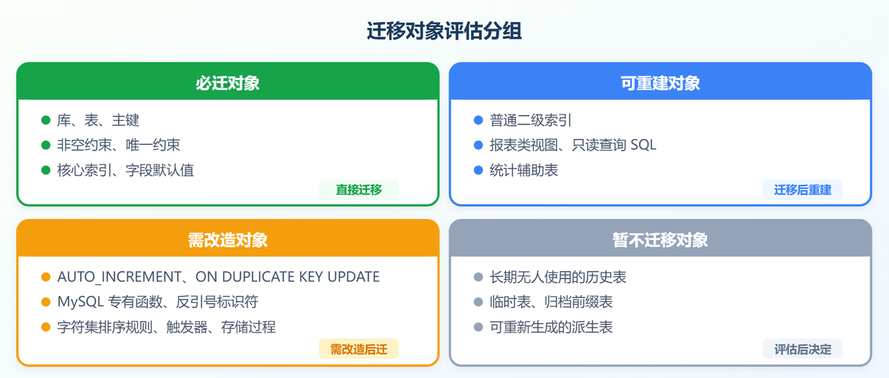
从 MySQL 向 KaiwuDB 迁移时,容易出问题的往往不是表数据,而是表周边的附属对象。我们可以按照以下分组评估:
• 必迁对象:库、表、主键、非空约束、唯一约束、核心索引、业务必需字段默认值。
• 可重建对象:普通二级索引、报表类视图、只读查询 SQL、统计辅助表。
• 需改造对象:AUTO_INCREMENT、ON DUPLICATE KEY UPDATE、MySQL 专有函数、反引号标识符、字符集排序规则、触发器、存储过程。
• 暂不迁移对象:长期无人使用的历史表、临时表、归档前缀表、可从主业务表重新生成的派生表。
|
温馨提示: 结构迁移前先跑一次对象盘点脚本,输出表行数、主键、索引、外键、默认值、字符集、最大字段长度、近 30 天访问情况。这样可以避免把历史包袱原样搬到新库。 |
三、迁移前须知
1、两种迁移工具
KDTS
KDTS(KaiwuDB Data Transformer)是KaiwuDB 基于当前主流的 DataX 框架开发的企业级异构数据库迁移解决方案。KDTS 提供了图形化操作界面和命令行执行模式,支持多种主流数据库(如MySQL、PostgreSQL、TDengine、InfluxDB 等)迁移同步至 KaiwuDB 的数据迁移和同步。
详细配置参考:https://doc.kaiwudb.com/template_version/pc/doc/db-migration/overview.html
DataX
DataX 是一款相对主流且使用较多的离线数据同步工具,同样能够实现 MySQL、SQL Server、Oracle、PostgreSQL等异构数据同步。DataX 能够将不同数据源,同步抽象为从源数据源读取数据的 Reader 插件,以及向目标数据源写入数据的 Writer 插件,从而实现不同数据源的数据同步工作。基于 DataX 框架,KaiwuDB 提供了用于写入和读取数据的 KaiwuDBWriter 和 KaiwuDBReader 插件。
详细配置参考:https://doc.kaiwudb.com/template_version/pc/doc/third-party-tools/datax.html
2、对齐数据类型映射
迁移过程中,绝大多数小故障都来自数据类型不匹配,比如无符号整型越界、DECIMAL 精度丢失、零日期解析失败、JSON 字段写入异常、二进制字段导出后编码变化。这里为大家整理了MySQL 和 KaiwuDB 的用映射清单。
|
MySQL |
KaiwuDB |
处理建议 |
|
BOOLEAN / TINYINT(1) |
BOOL |
布尔字段建议在源端先统一 0/1 与 true/false 表达。 |
|
TINYINT / SMALLINT |
INT2 |
无符号小整数建议放大到 INT2/INT4 ,避免越界。 |
|
INT / MEDIUMINT |
INT4 |
常规业务主键和状态字段可直接映射。 |
|
INT UNSIGNED / BIGINT |
INT8 |
自增主键迁移后需重新设计序列或写入策略。 |
|
BIGINT UNSIGNED |
NUMERIC(20) |
关系引擎建议保留为 NUMERIC(20) ,避免超过 INT8 上限。 |
|
DECIMAL |
DECIMAL |
金额、计量结算字段优先保留 DECIMAL ,不建议改为浮点。 |
|
FLOAT / DOUBLE |
FLOAT4 / FLOAT8 |
报表指标可映射为浮点,需确认精度要求。 |
|
DATE / DATETIME / TIMESTAMP |
TIMESTAMP |
迁移前统一时区、默认值和零日期处理策略。 |
|
TIME |
TIME |
仅保留时间段语义;若代表事件时间建议改为 TIMESTAMP 。 |
|
CHAR / VARCHAR / LONGTEXT |
CHAR / VARCHAR / TEXT |
按最大长度和查询习惯设置字段类型。 |
|
BINARY / VARBINARY / BLOB |
BYTEA / VARBYTES / BYTES |
二进制字段建议先评估是否继续放在数据库主表。 |
|
JSON |
JSON |
复杂 JSON 建议补充关键字段的冗余列,便于后续查询优化。 |
• KaiwuDB 数据类型映射参考:https://doc.kaiwudb.com/template_version/pc/doc/db-migration/reference.html
3、三种数据迁移方案
MySQL 数据库可迁至 KaiwuDB 的时序引擎或关系引擎,鉴于 MySQL 绝大多数使用关系数据管理场景,本文主要介绍关系引擎的迁移实践。结合上述介绍的两种工具,我们提供如下的迁移方案来适配不同的场景,大家可以按需选择。
|
方案 |
适用场景 |
实现思路 |
风险控制 |
|
方案一:KDTS 结构 + 数据 |
首 次迁移、对象较多、希望可视化配置 |
在 KDTS 中配置源端 MySQL 、目标 KaiwuDB 关系引擎,执行结构 + 数据迁移。 |
迁移前确认类型映射和对象过滤,迁移后做一致性校验。 |
|
方案二:DataX 直连 |
已有 DataX 运维经验、希望脚本化执行 |
使用 mysqlreader 读取 MySQL ,使用 kaiwudbwriter KaiwuDBWriter 写入关系表。 |
字段顺序、批大小、并发通道、失败重试策略必须固化到作业文件。 |
|
方案三:CSV 离线 |
网络隔离、源端只能导出文件 |
MySQL 导出 CSV ,清洗后通过 KaiwuDB 侧导入流程写入。 |
处理 NULL 、分隔符、换行、引号、编码、时间格式和文件权限。 |
四、开始迁移
接下来,我们以电商订单表为例演示具体的迁移过程:
先创建 KaiwuDB 关系库和关系表
源端 MySQL 表 orders 保存订单主数据,包含订单号、用户、金额、状态、创建时间、更新时间与扩展 JSON 信息。目标端使用 KaiwuDB 关系数据库承载同类业务表。
1. 源端表说明
|
MySQL CREATE TABLE orders ( id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT, order_no VARCHAR(64) NOT NULL, user_id BIGINT NOT NULL, total_amount DECIMAL(18,2) NOT NULL, status TINYINT NOT NULL DEFAULT 0, ext JSON NULL, created_at DATETIME NOT NULL, updated_at DATETIME NOT NULL, PRIMARY KEY (id), UNIQUE KEY uk_order_no (order_no), KEY idx_user_created (user_id, created_at) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4; |
2. 创建并切换关系库
|
SQL CREATE DATABASE IF NOT EXISTS commerce COMMENT = 'MySQL business migration target';
USE commerce; |
3. 创建关系表
这里将 MySQL 的 BIGINT UNSIGNED 映射为 NUMERIC(20),保留金额字段 DECIMAL 精度;AUTO_INCREMENT 不直接照搬,建议通过应用侧 ID、序列服务或迁移前生成好的 id 写入。
|
SQL CREATE TABLE orders ( id NUMERIC(20) NOT NULL, order_no VARCHAR(64) NOT NULL, user_id INT8 NOT NULL, total_amount DECIMAL(18,2) NOT NULL, status INT2 NOT NULL DEFAULT 0, ext JSON NULL, created_at TIMESTAMP NOT NULL, updated_at TIMESTAMP NOT NULL, CONSTRAINT pk_orders PRIMARY KEY (id), CONSTRAINT uk_orders_order_no UNIQUE (order_no) );
CREATE INDEX idx_orders_user_created ON orders (user_id, created_at); |
4. 校验表结构
|
SQL SHOW CREATE DATABASE commerce; SHOW CREATE TABLE orders; |
KDTS 图形化迁移
如果希望降低手写作业配置的成本,优先使用 KDTS。它适合首 次迁移、对象较多、需要实时查看进度和日志的场景。操作时建议先在测试环境跑一轮结构迁移,再对照生成的 DDL 调整字段类型和索引。
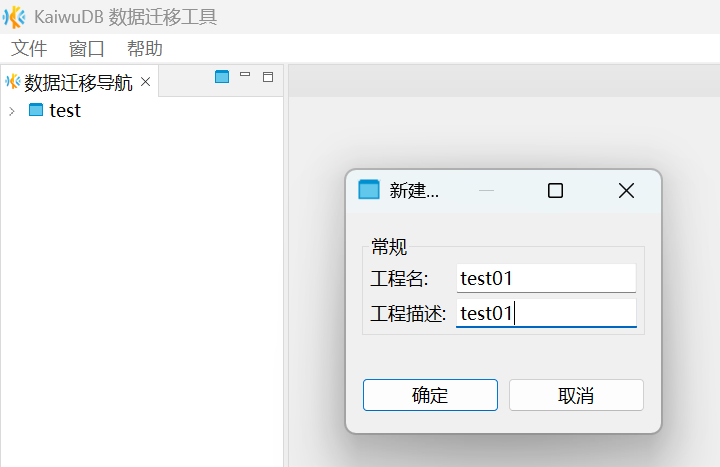
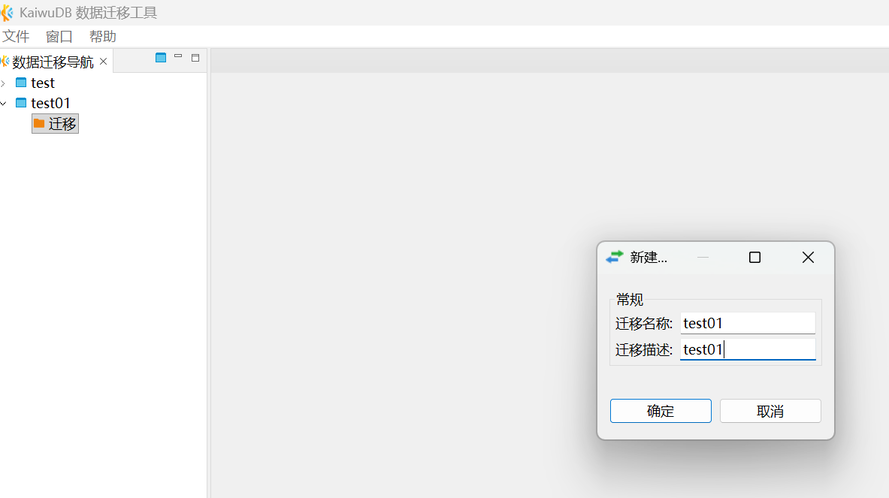
1. 新建迁移工程与迁移任务,选择结构化数据迁移。
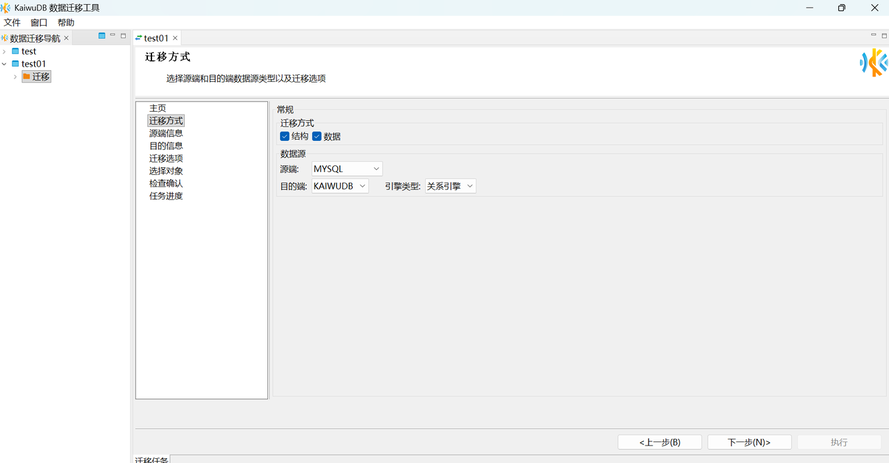
2. 迁移方式选择“结构+数据”;源端选择 MySQL;目标端选择 KaiwuDB 关系引擎。
3. 配置 MySQL 主机、端口、库名、用户名、密码,完成连接校验。

4. 配置 KaiwuDB 目标端连接信息,确认目标库、写入用户和权限。
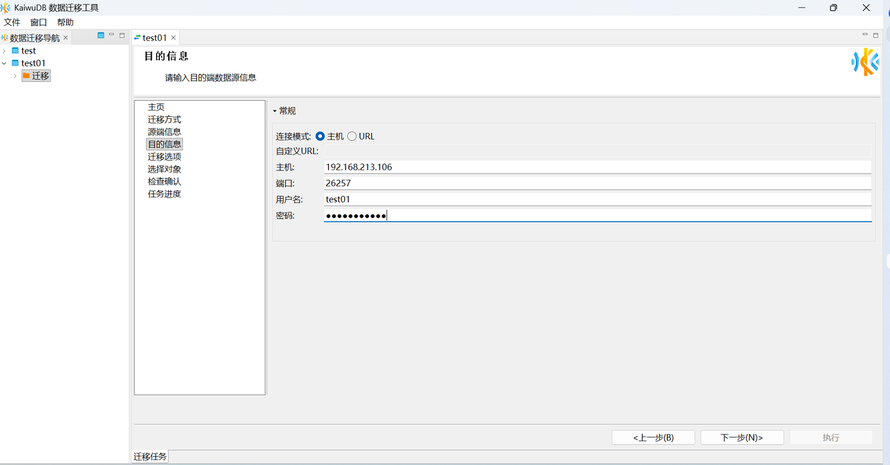

5. 在对象选择页面勾选待迁移表,排除临时表、归档表、无需迁移的中间表。

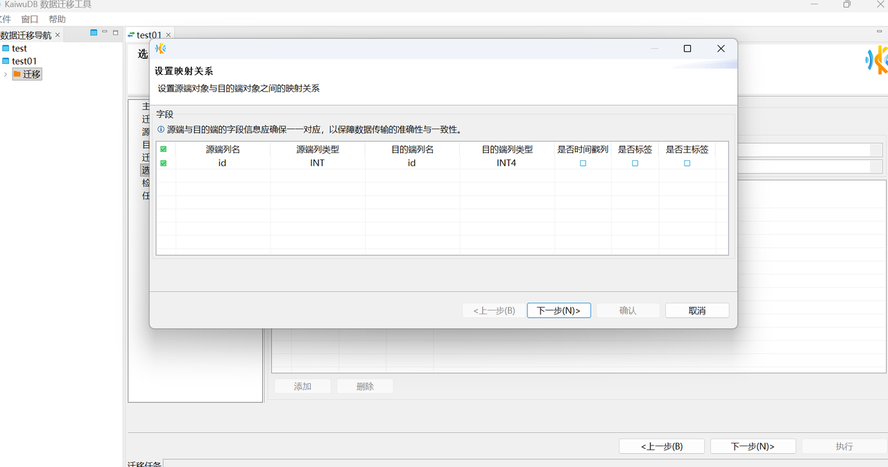
6. 在映射关系页面检查字段类型、字段长度、主键、索引和默认值。
7. 执行迁移任务,迁移完成后查看日志与一致性校验结果。
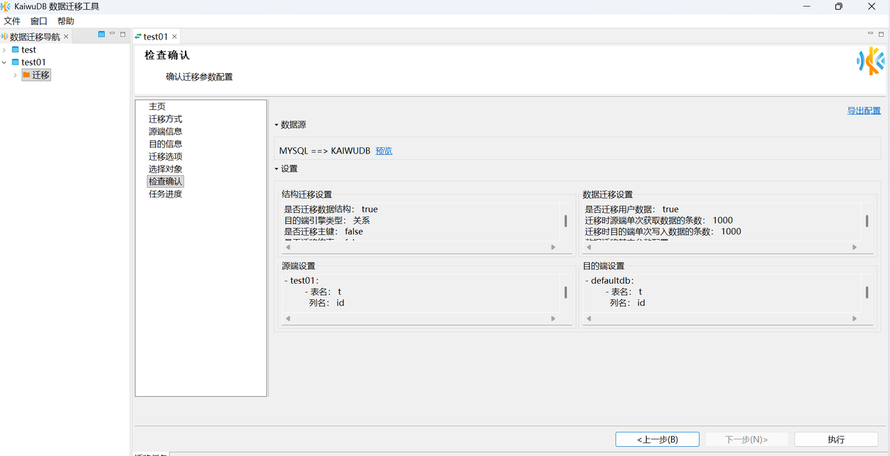
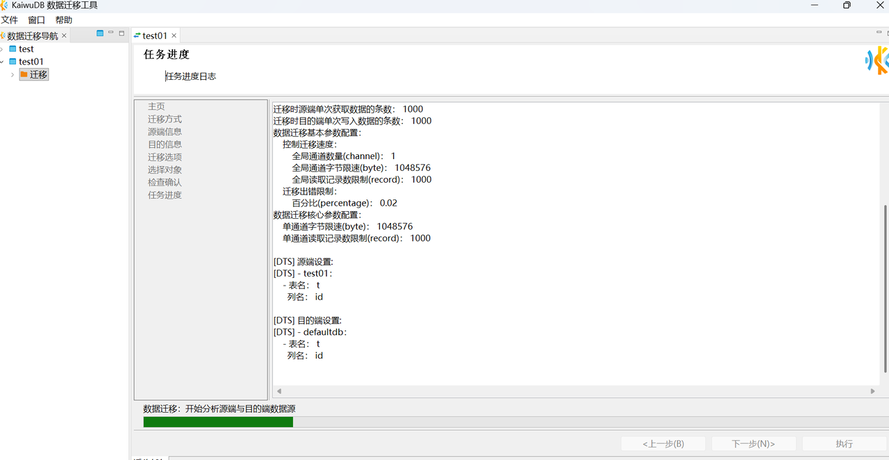
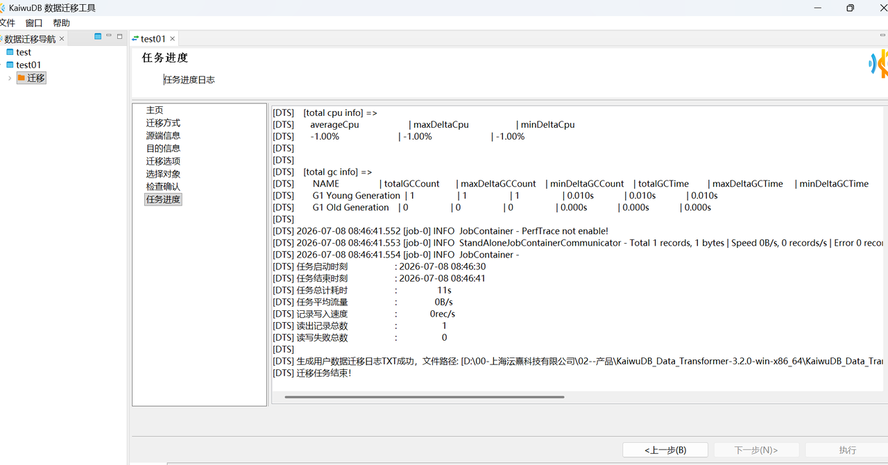
更多详情可前往官方文档:https://www.kaiwudb.com/docs/#/v3.2.1/db-migration/overview.html
DataX 直连数据迁移
基于 DataX 框架,KaiwuDB 提供 KaiwuDBWriter 插件,可将 Reader 读取的数据写入 KaiwuDB 的时序表和关系表。MySQL 到 KaiwuDB 关系表迁移时,reader 使用 mysqlreader,writer 使用 KaiwuDBWriter。
1. 配置 KaiwuDBWriter
• 迁移服务器提前部署 Linux、Java、Python3 和 DataX 基础环境。
• 获取 KaiwuDB DataX 插件包,并将 KaiwuDBWriter 复制到 datax/plugin/writer/ 目录。
• 在 KaiwuDB 中提前创建目标关系库和关系表,并确认写入用户拥有 INSERT/UPSERT 相关权限。
• 使用 DataX 模板命令查看配置样例,例如 python ./bin/datax.py -r mysqlreader -w kaiwudbwriter。
2. 配置 DataX 作业文件
|
JSON { "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "mysql_user", "password": "mysql_password", "column": [ "id", "order_no", "user_id", "total_amount", "status", "ext", "created_at", "updated_at" ], "splitPk": "id", "where": "updated_at >= '2026-01-01 00:00:00'", "connection": [ { "table": ["orders"], "jdbcUrl": [ "jdbc:mysql://127.0.0.1:3306/commerce?useSSL=false&useUnicode=true&characterEncoding=utf8" ] } ] } }, "writer": { "name": "kaiwudbwriter", "parameter": { "username": "kaiwudb_user", "password": "kaiwudb_password", "jdbcUrl": "jdbc:kaiwudb://127.0.0.1:26257/commerce", "table": "orders", "column": [ "id", "order_no", "user_id", "total_amount", "status", "ext", "created_at", "updated_at" ], "writeMode": "INSERT", "batchSize": 1000 } } } ], "setting": { "speed": { "channel": 4 } } } } |
|
温馨提示:writer.column 必须和 reader.column 或 querySql 的输出顺序保持一致。只要顺序错位,迁移任务可能不报结构错误,但数据语义会写偏。 |
3. 启动迁移任务
|
Bash cd /home/kaiwudb/datax python3 ./bin/datax.py ./job/mysql_orders_to_kaiwudb.json --jvm="-Xms4G -Xmx4G" |
4. 查看迁移日志与结果
|
SQL -- KaiwuDB 侧检查 SELECT COUNT(*) FROM orders; SELECT MIN(created_at), MAX(created_at) FROM orders; SELECT status, COUNT(*) FROM orders GROUP BY status ORDER BY status; |
CSV 离线迁移兜底方案
当源端和目标端网络无法直连,或生产环境不允许在源库附近部署 DataX 时,可以采用 MySQL 导出 CSV + KaiwuDB 离线导入的兜底方案。重点不是导出命令本身,而是导出格式必须稳定、可重复、可校验。
1. MySQL 导出 CSV
|
MySQL SELECT id, order_no, user_id, total_amount, status, COALESCE(JSON_UNQUOTE(JSON_EXTRACT(ext, '$')), '') AS ext, DATE_FORMAT(created_at, '%Y-%m-%d %H:%i:%s') AS created_at, DATE_FORMAT(updated_at, '%Y-%m-%d %H:%i:%s') AS updated_at FROM orders INTO OUTFILE '/tmp/orders.csv' FIELDS TERMINATED BY ',' ENCLOSED BY '"' LINES TERMINATED BY ' '; |
2. 文件清洗与设置权限
• 统一文件编码为 UTF-8,避免中文、特殊符号和 JSON 文本乱码。
• 确认字段分隔符、引号、换行符不会与业务文本冲突。
• 将 NULL 与空字符串区分清楚;无法区分时要在导出 SQL 中显式处理。
• 按目标端导入目录要求放置文件,并设置 KaiwuDB 进程可读取的 owner/group 权限。
迁移后校验与回滚
|
校验项 |
校验 SQL/ 方法 |
通过标准 |
|
行数 |
源端 COUNT(*) 与目标端 COUNT(*) |
全量迁移必须一致;增量迁移按时间窗口一致。 |
|
主键 |
COUNT(DISTINCT id) |
与总行数一致,无重复主键。 |
|
金额 |
SUM(total_amount) 、 MAX/MIN |
金额汇总误差为 0 。 |
|
时间范围 |
MIN/MAX(created_at) |
源端和目标端时间窗口一致。 |
|
抽样 |
按 id 、 order_no 抽样比对 |
核心字段逐项一致。 |
|
应用查询 |
高频 SQL 回放 |
结果、耗时、排序和分页行为符合预期。 |
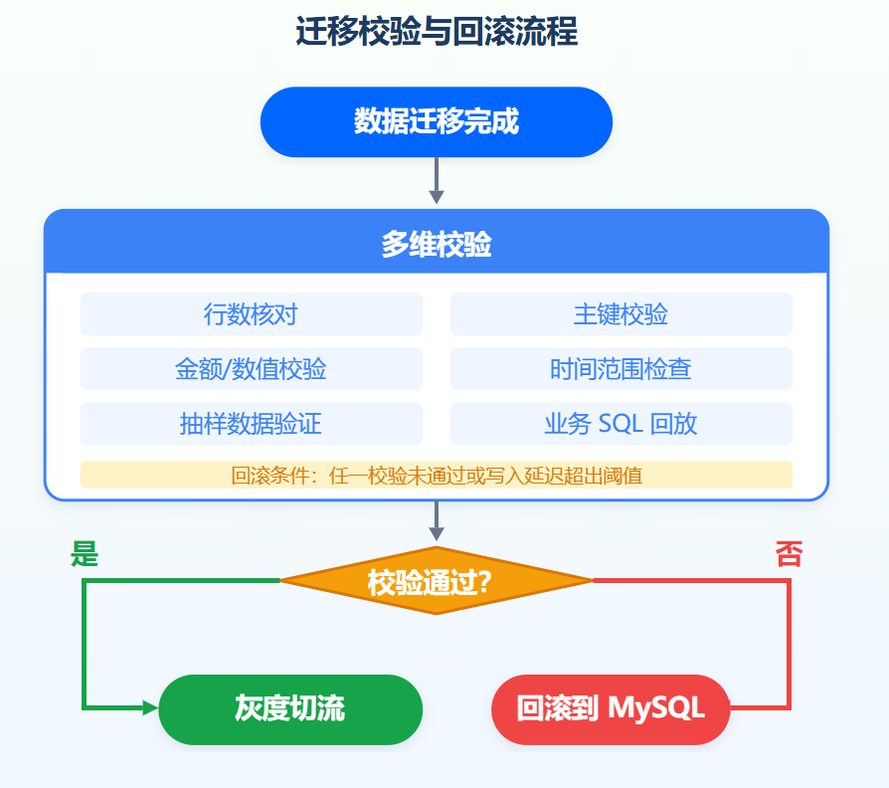
• 保留 MySQL 只读窗口:割接后一段时间内不要立即下线源库,至少保留可回查能力。
• 双写或增量补偿:若割接窗口较长,建议先全量迁移,再按 updated_at 迁移增量。
• 灰度切流:先让只读报表或内部服务读 KaiwuDB,再逐步切换核心交易链路。
• 回滚条件:关键表行数不一致、金额校验失败、核心 SQL 结果不一致、写入延迟超出阈值时,停止切换并回滚到 MySQL。
五、总结回顾
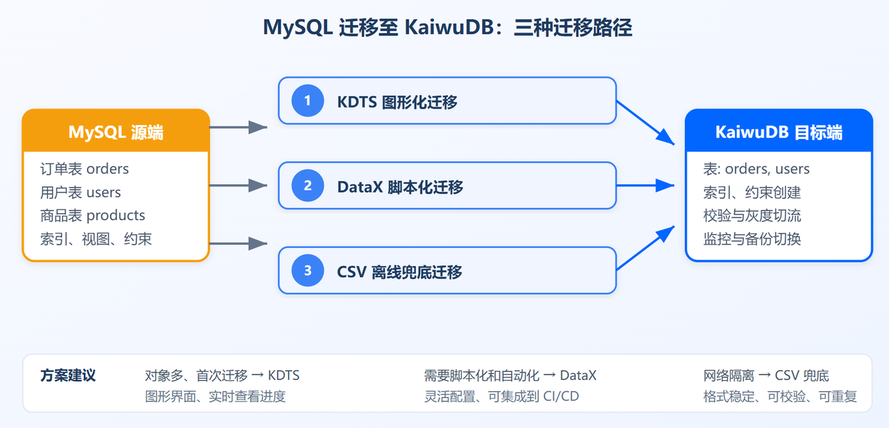
MySQL 迁移到 KaiwuDB 关系引擎的核心,不是简单把表搬过去,而是把关系对象、数据类型、SQL 方言、主键生成、校验回滚一起规划好。网络互通、对象较多时优先 KDTS;需要脚本化和自动化时选择 DataX;网络隔离时使用 CSV 离线迁移兜底。
此外,还有以下要点需要关注:
• 网络互通且对象较多时优先选用 KDTS,图形化操作可降低配置成本。
• 需要脚本化和自动化流程时选择 DataX,灵活度更高。
• 网络隔离场景下使用 CSV 离线迁移,流程可控。
• 数据类型需严格匹配,重点关注 BIGINT UNSIGNED、DECIMAL、JSON、DATETIME、BLOB。
• 字段顺序必须一致,DataX 的 column 配置与 reader 输出顺序不可错位。
• 存储过程、触发器与 MySQL 专有语法需先评估再改造,避免盲目迁移。
• 迁移完成后必须执行行数核对、主键校验、金额校验、时间范围检查、抽样验证和业务 SQL 回放。
互动时间
各位技术小伙伴,你们在数据库迁移过程中,还遇到过哪些奇葩报错、疑难问题?欢迎在评论区留言交流,一起探讨踩坑经验!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027415/viewspace-3175670/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业级异构数据库迁移的数据库选型实践:KaiwuDB 社区版 KWDB 数据迁移 Skill 解析
- 企业级边缘场景数据库高可用选型:KaiwuDB DRBD + Pacemaker 方案架构与运维要点
- InfluxDB ®版退市后的企业级迁移方案:KaiwuDB 迁移路径与信创考量
- KWDB MVP 招募令 | 寻找 KaiwuDB 开源社区的中坚力量!
- 征文大赛 |「KWDB 创作者计划」—— KaiwuDB 开源两周年特别季,来了!
- 2026数博会|KaiwuDB 获央视关注,多模数据库的企业级选型价值分析
- 两年生长,开源同行 | KWDB 开源两周年
- 企业级时序数据库降本之道:KaiwuDB 双副本仲裁架构的选型与落地
- 企业级 AIoT 平台的数据库架构演进:KaiwuDB V3.2.2 高可用与数据安全实践
- 企业级时序数据库迁移实践:从 InfluxDB 到 KaiwuDB 的架构选型与落地路径
