工业传感器数据天然适合用 SQL 聚合:数一数上报了多少条,算一算平均温度,找出最高值和最低值。但真落到时序场景里,问题会变复杂:设备可能漏报,字段可能是
NULL
,同一时间段内不同设备的采样间隔也未必一致。
KWDB SampleDB 的
aggregate
示例把这些边界放进了一套可运行的数据里。它用一张传感器时序表,把基础统计聚合和时序专属聚合放在同一个业务背景下观察。
样例数据如下:

01 示例数据如何组织
直接从
aggregate
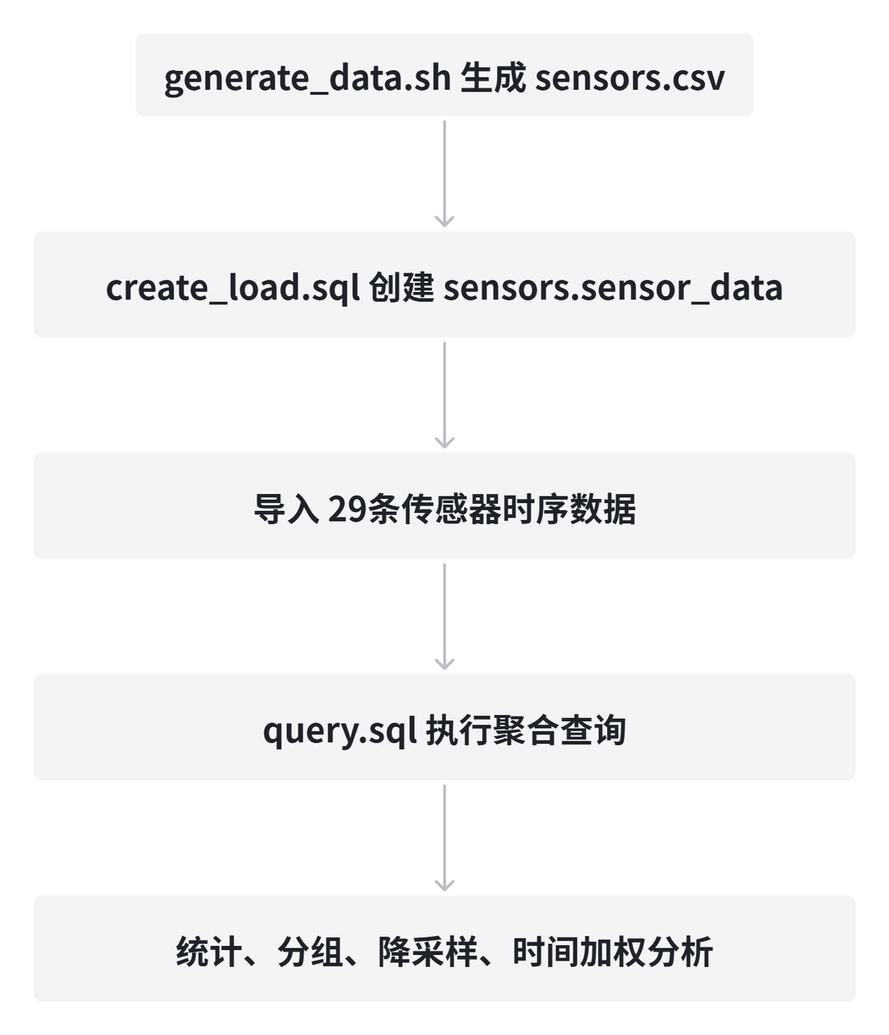
目录开始:
generate_data.sh
生成 CSV,
create_load.sql
建库建表并导入数据,
query.sql
执行聚合查询。
表结构的核心是
sensors.sensor_data
。
ts
是采集时间,
temperature
、
temperature2
、
temperature3
表示不同整数精度的温度值,
stress
、
stress2
表示不同浮点精度的压力值,
ptagID
是传感器编号,并作为主标签区分设备。
这组数据只有 29 行,但设计得有针对性:
•
ptagID=1/2/3
是比较规整的递增数据,适合观察基础聚合结果。
•
ptagID=5
包含负数,能验证最小值、最大值、平均值是否按真实数值计算。
•
ptagID=6/7/8
包含大量空值,并在 16:00 到 20:00 附近制造了不完全一致的采样时间,适合观察
NULL
处理、末值和时间加权平均。
写时序 SQL 时容易漏掉这一层: 聚合函数处理的不只是列值,还包含“哪些行参与计算”、“时间顺序如何解释”、“设备标签是否要分组”等业务约束。
02 基础统计聚合:先回答数据概况
基础聚合函数回答常见问题:数据有多少、均值是多少、总量是多少、边界在哪里、波动大不大。
COUNT:先确认数据是否完整
COUNT(*)
统计行数,适合做数据上报完整性检查。示例里用它查看
ptagID=3
的记录数:
SELECT COUNT(*)FROM sensors.sensor_dataWHERE ptagid = 3;
这类查询的价值来自前置校验。设备本来应该每分钟上报一次,如果
COUNT(*)
明显偏少,后面的平均值、最大值再漂亮也可能没有解释意义。
需要注意的是,
COUNT(*)
和
COUNT(column)
不是一回事。前者统计行,后者统计指定列的非空值。SampleDB 里后半段数据刻意放入了很多空字段,所以在真实排障时,二者往往应该一起看。
AVG、SUM:聚合前先想清楚维度
平均温 度通常不能只 算全局值,因为不同设备的工况可能完全不同。示例里按传感器编号分组:
SELECT ptagid, AVG(temperature)FROM sensors.sensor_dataGROUP BY ptagid;
这条 SQL 的业务含义是“每台设备自己的平均温度”。如果去掉
GROUP BY ptagid
,得到的就是所有设备混在一起的平均值,适合看总体水平,却不适合定位单台设备异常。
SUM(stress)
则更像累计量分析:
SELECT SUM(stress)FROM sensors.sensor_dataWHERE ts > '2024-12-01';
这里先通过
WHERE
限定时间范围,再聚合压力值。这个顺序决定了哪些采样点进入统计口径。
MIN、MAX:边界值更接近告警语义
MIN
和
MAX
常用于异常低点、超温、过载这类场景。SampleDB 的写法仍然按
ptagid
分组:
SELECT ptagid, MIN(temperature), MAX(temperature)FROM sensors.sensor_dataGROUP BY ptagid;
按设备分组更贴近排障。全局最大温度只能告诉你“有设备到过高位”,按设备分组后才知道是哪台设备,以及它自己的上下界是否异常。
ptagID=5
的负数数据值得保留。它提醒我们,传感器输出数值不一定都是正数;不要在应用层用“负数就是脏数据”的先验去覆盖数据库里的真实观测。
STDDEV:均值稳定不代表运行稳定
平均值只能说明中心位置,标准差才更接近“波动程度”。
SELECT ptagid, AVG(temperature), STDDEV(temperature)FROM sensors.sensor_dataGROUP BY ptagid;
如果两台设备平均温度接近,但其中一台标准差明显更大,排查方向就不应该只盯着均值,而要看它是否存在周期性抖动、采样异常或工况切换。
SampleDB 把
AVG
和
STDDEV
放在同一条查询里,提醒你同时看中心值和离散程度。
03 时序专属聚合:把时间顺序纳入计算
普通聚合把一批行压缩成一个结果,时序聚合则进一步追问:这些行在时间轴上是怎么排列的?
FIRST、LAST:不是最小值和最大值
FIRST
和
LAST
关注的是时间顺序,不是数值大小。
SELECT first(temperature) AS first_tempFROM sensors.sensor_data;SELECT last(temperature) AS last_tempFROM sensors.sensor_data;
这两个函数适合回答“最早采集到的值是什么”以及“最新有效值是什么”。在监控面板里,
LAST
往往比
MAX
更接近实时状态;在设备启动分析里,
FIRST
又比
MIN
更接近初始工况。
真实业务中通常还会把它们和设备标签一起使用,例如按
ptagid
分组查看每台设备的最新值。否则全表级别的
LAST
只能代表整个数据集的最后状态,不一定能代表每一台设备。
time_bucket:把高频数据压成固定窗口
时序数据一旦进入高频采集,直接看原始点会很吵。
time_bucket
的作用是把时间轴切成固定窗口,再在窗口内做聚合。SampleDB 用 2 小时窗口取末值:
SELECT time_bucket(ts, '2h') AS bucket, last(temperature)FROM sensors.sensor_dataGROUP BY bucketORDER BY bucket;
time_bucket
完成降采样:保留趋势,减少点数。它适合画折线图、日报看板或长周期巡检报表。
有一个规则不能省:
time_bucket()
生成的是分组维度,必须配合
GROUP BY
使用。否则数据库不知道每个时间桶应该如何合并多行数据。
TWA:非均匀采样下,普通平均值可能误导
AVG
默认每条记录权重相同。但时序数据里,采样点之间的时间间隔可能不同。一个温度值持续 5 分钟,另一个温度值持续 50 分钟,如果简单平均,它们会被当成同等重要。
TWA
解决的是这个问题:把时间间隔纳入平均值计算,更适合非均匀采样数据。
SELECT twa(ts, temperature)FROM sensors.sensor_data;SELECT twa(ts, temperature * 2)FROM sensors.sensor_data;
第二条查询也说明,KWDB 支持先对字段做算术表达式,再参与聚合。工业场景经常需要先换算单位、套用校准系数,或者把原始采集值转换成业务指标后再统计。
04 实操技巧
SampleDB 查询逻辑简洁,这里整理几条可复用的实践要点:
1. 定好统计口径:全表聚合看总量, ptagid 分组对比设备差异, time_bucket 分桶分析时序趋势,口径模糊会导致结果误判。
2. 明确 NULL 业务意义:聚合函数自动忽略空值,但 NULL 代表未上报、字段无效、采集/导入失败,数据库不会自动解读空值背后的业务场景。
3. 分清两类边界函数: MIN / MAX 取数值极值, FIRST / LAST 按时间取首尾;监控、告警、设备排查、复盘等场景对边界数据需求不同。
4. 非均匀采样慎用 AVG :采样间隔不均会扭曲均值结论,推荐使用 TWA 时间加权平均,这是时序库聚合区别于普通关系库的关键能力。
05 小结
KWDB SampleDB 的
aggregate
示例覆盖了两类聚合能力:
COUNT
、
AVG
、
SUM
、
MIN
、
MAX
、
STDDEV
负责基础统计;
FIRST
、
LAST
、
time_bucket
、
TWA
则把时间顺序、窗口和采样间隔纳入分析。
这组示例的价值,来自它把聚合函数放进了传感器数据的真实约束里: 多设备、空值、负数、非均匀采样、时间窗口。理解这些约束,再去写聚合 SQL,结果才更接近业务事实。
SampleDB 项目后续还会持续更新,更多信息可查阅 KWDB SampleDB 官网: https://kwdb.tech/sampledb 及 开源仓库: https://gitee.com/kwdb/sampledb。
欢迎在社区微信群、Gitee/GitHub Issue 提出反馈与建议,期待与您共同完善项目。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027415/viewspace-3174430/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业级异构数据库迁移的数据库选型实践:KaiwuDB 社区版 KWDB 数据迁移 Skill 解析
- 企业级边缘场景数据库高可用选型:KaiwuDB DRBD + Pacemaker 方案架构与运维要点
- InfluxDB ®版退市后的企业级迁移方案:KaiwuDB 迁移路径与信创考量
- KWDB MVP 招募令 | 寻找 KaiwuDB 开源社区的中坚力量!
- 征文大赛 |「KWDB 创作者计划」—— KaiwuDB 开源两周年特别季,来了!
- 2026数博会|KaiwuDB 获央视关注,多模数据库的企业级选型价值分析
- 两年生长,开源同行 | KWDB 开源两周年
- 企业级时序数据库降本之道:KaiwuDB 双副本仲裁架构的选型与落地
- 企业级 AIoT 平台的数据库架构演进:KaiwuDB V3.2.2 高可用与数据安全实践
- 企业级时序数据库迁移实践:从 InfluxDB 到 KaiwuDB 的架构选型与落地路径
