物理计划是根据逻辑计划(逻辑计划讲解参考往期博客)生成的树形结构,执行引擎需要按照 物理计划进行实际查询,根据逻辑计划的不同逻辑算子生成物理算子,通过记录处理链路,即数据流来记录算子的执行顺序,根据顺序进行执行。
0 1 物理计划结构
- 物理计划组成
- 算子组成
- 算子规格组成
- 数据流组成
0
2
物理计划构建
以三节点集群执行一条查询语句为样例解析物理计划构建和执行流程,结构如下:
SQLcreate table a(a1 int, a2 int, a3 bool);insert into a values( 1, 1, false),( 2, 2, false),( 3, 3, false);create table b(b1 int, b2 int, b3 bool);insert into b values( 1, 2, false),( 3, 4, true),( 5, 6, true);select * from a join b on a.a1=b.b1;
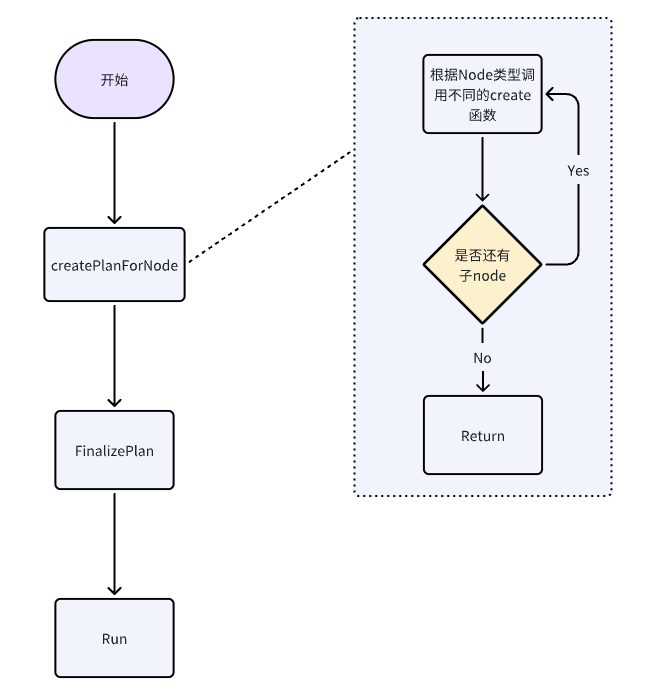
整体流程示意图
- 算子组成
- 根据逻辑算子生成物理算子
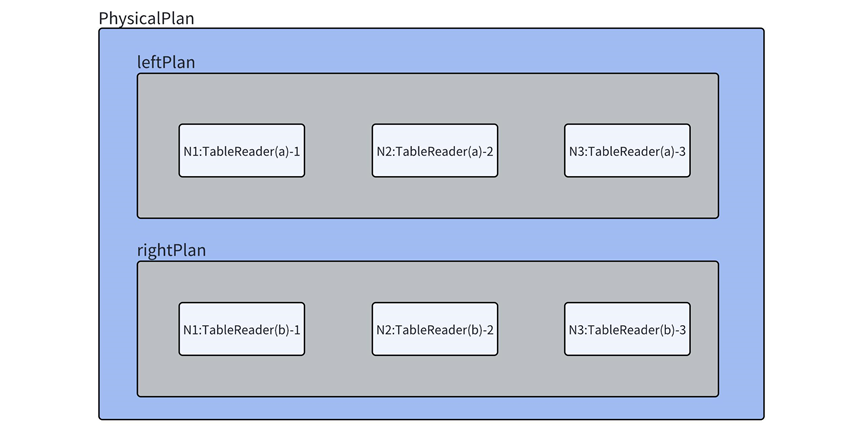
在构建 scanNode 时,会构建表读取算子 TableReader (createTable R ead ers),它会确认表数据的分布信息,根据数据分布所在节点创建出对应数量的 Table R ead er 算子,最终左右的物理计划将各生成的 3个 Table R ead er 算子加入到 PhysicalPlan 当中,如图所示。
- 算子组成合并左右子计划
MergePlans 将左右计划进行合并,整体变成一个物理计划,该物理计划中有 6 个 Table R ead er 算子。

-
根据节点数构建 Join 算子 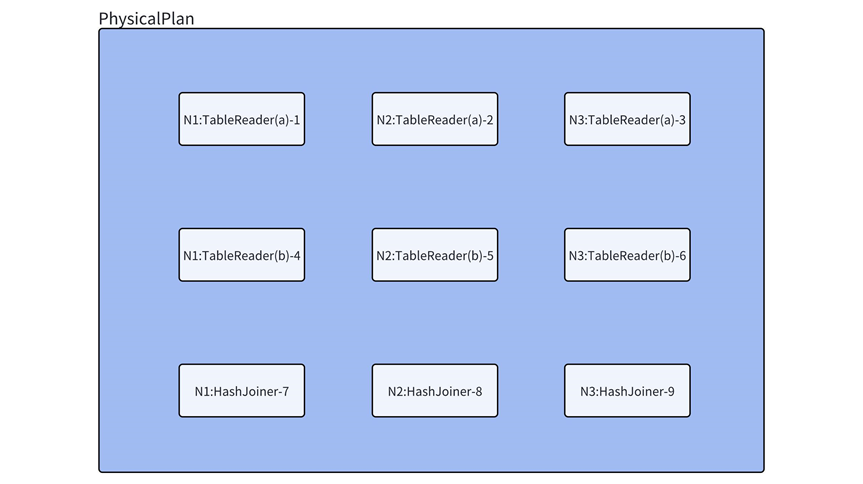
- 构建数据流
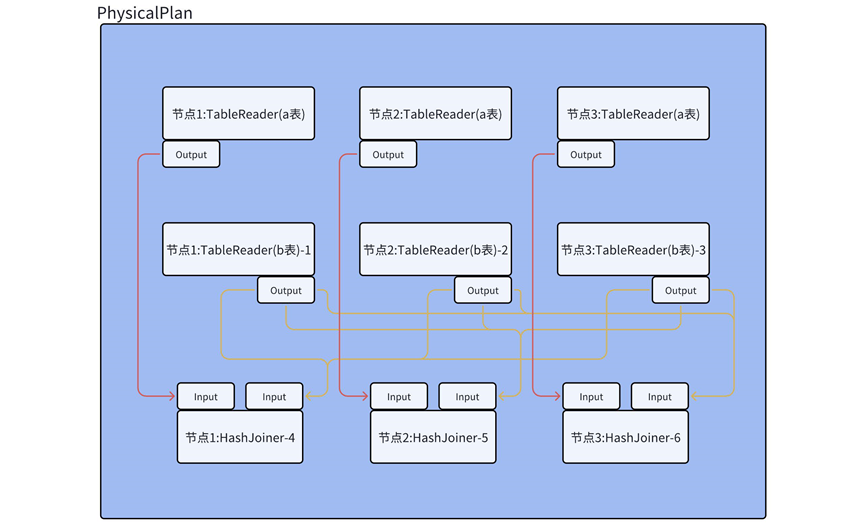
每个 HashJoiner 算子都需要有左右两个 Input,在每个节点上执行时都需要获取到两个表的 TableReader 算子的输出,所以需要调用 MergeResultStreams 方法按照节点数量将 a 表和 b 表的各 3 个 Table R eader 连接到各个 HashJoiner 的 Input 左右两端。
如图所示, 跨节点 Hash 数据重分布方式 (OutputRouterSpec_BY_HASH) 是要将三个节点上每个 HashJoiner 算子的 Input 每个表的数据做到基本平均分配,例: a表在节点 1 有 3000 条数据,节点 2 有 5000 条数据,节点 3 有 1000条 数据,节点 2需要将数据传输一部分到节点 1 和节点 3,最终三个节点的 HashJoiner 算子的 a 表 Input 都有 3000 条数据。
有向箭头表示数据流 (Stream),Stream 起于一个算子的 Output,终于另一个算子的Input,图中的 Output 类型均为上一小节所说的 OutputRouterSpec_BY_HASH。
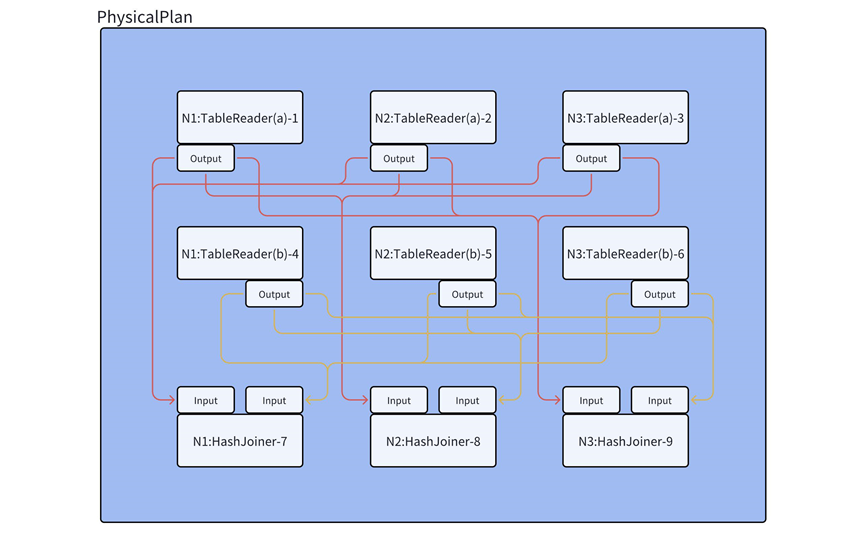
另外,除本样例中提到跨节点 Hash 重分布 (OutputRouterSpec_BY_HASH) 分布方式,还有一种镜像 Hash 分布方式 (OutputRouterSpec_MIRROR),此方式会将表数据完全广播到每一个节点上,不需要根据节点数进行数据重分布,此 Hash 分布方式的计划如图所示,具体采用哪种分布方式,需要根据表数据量,节点数等进行数据传播和接受的代价计算,两种方式哪个代价更小就使用哪种分布方式。
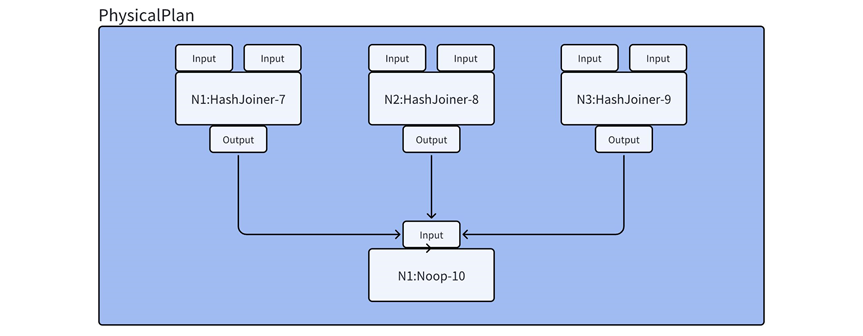
createPlanForNode 函数完成后,物理计划的基本结构就生成完毕,但还需要一个最终汇总结果返回的算子,FinalizePlan 函数便会在已有的物理计划基础上增加一个 Noop 算子,用于汇总最终的执行结果,还需要设置每个算子的 Input 和 Output 所关联的 StreamID,以及 Stream 的类型(Stream 如果连接相同节点的算子为 streamEndpointSpec_LOCAL,否则为 streamEndpointSpec_REMOTE)为之后物理计划的执行做准备,此阶段物理计划如图所示。
至此,物理计划构建全部完成,而后将进行物理计划的分布式执行,此模块将在后续博客进行介绍。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70027415/viewspace-3016864/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 企业级异构数据库迁移的数据库选型实践:KaiwuDB 社区版 KWDB 数据迁移 Skill 解析
- 企业级边缘场景数据库高可用选型:KaiwuDB DRBD + Pacemaker 方案架构与运维要点
- InfluxDB ®版退市后的企业级迁移方案:KaiwuDB 迁移路径与信创考量
- KWDB MVP 招募令 | 寻找 KaiwuDB 开源社区的中坚力量!
- 征文大赛 |「KWDB 创作者计划」—— KaiwuDB 开源两周年特别季,来了!
- 2026数博会|KaiwuDB 获央视关注,多模数据库的企业级选型价值分析
- 两年生长,开源同行 | KWDB 开源两周年
- 企业级时序数据库降本之道:KaiwuDB 双副本仲裁架构的选型与落地
- 企业级 AIoT 平台的数据库架构演进:KaiwuDB V3.2.2 高可用与数据安全实践
- 企业级时序数据库迁移实践:从 InfluxDB 到 KaiwuDB 的架构选型与落地路径
