AntDB设计之CheckPoint——设计实现
3. 设计实现
下文介绍CheckPoint 是如何实现其设计目标以及设计要求的。
1. 不影响业务
CheckPoint 在执行过程中,不能阻塞数据库服务的正常访问。这意味着在 CheckPoint 的过程中,数据是一直在发生变化的。为了不阻塞对数据的修改,保障导出数据的一致性,我们在此引入 CheckPoint 状态和表缓存来解决这个问题。
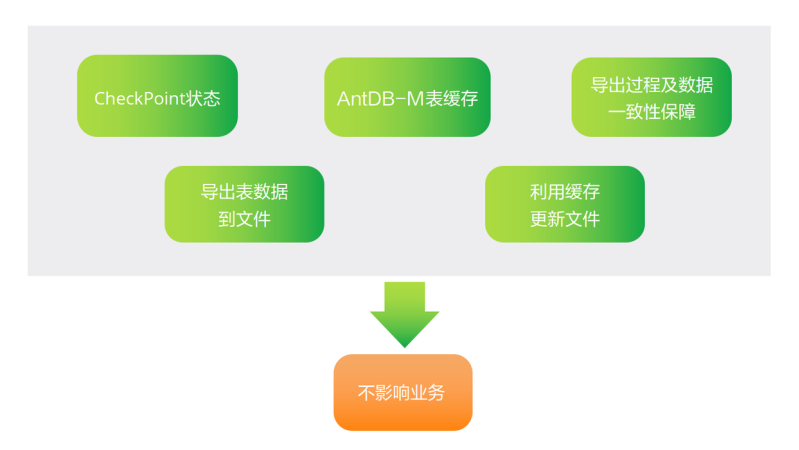
图
2
:设计实现
-
不影响业务
(1 ) CheckPoint 状态
AntDB-M 与 CheckPoint 的相关状态分为三个: 1 )数据导出; 2 )导出文件处理; 3 )导出完成。状态 “1- 数据导出 ” 代表正在将内存中的数据导出到文件。这个状态对于保障导出数据的一致性非常重要。后文将介绍如何参考该状态对数据一致性进行保障。
(2 ) AntDB-M 表缓存
AntDB-M 在数据管理上分为两部分: 1 )表缓存; 2 )表数据(含表元数据)。通常情况下,所有对数据的修改只会修改 “2- 表数据 ” 。表缓存只在状态为 “1- 数据导出 ” 时进行 AntDB-M 服务的 CheckPoint 。
(3 )导出过程及数据一致性保障
AntDB-M 按如下步骤,来实现 CheckPoint 的导出,并确保导出数据的一致性。
状态设置
在进行CheckPoint 时,我们可以先将 AntDB-M 服务的 CheckPoint 状态设置为 “1- 数据导出 ” 。一旦进入该状态, AntDB-M 将开始对表缓存进行特殊处理。
未提交事务数据备份
进入 “1- 数据导出 ” 状态后,我们需在开始导出数据前,将当前所有未提交事务相关记录的原始数据保存一份到表缓存中。表缓存中的这份数据能够确保未提交事务的数据不会被导出,这是保障数据一致性的措施之一。
表缓存修改
一旦进入CheckPoint 的 “1- 数据导出 ” 状态,所有数据的增、删、改将同时修改表缓存和表数据。操作类型不同,表缓存的动作也不同,但表数据的操作逻辑保持不变。
-insert :在表缓存中记录下新插入数据的记录 ID (后文会介绍记录 ID )。
-delete :在表缓存中记录下被删除数据的记录 ID ,以及记录数据。
-update :在表缓存中记录下被更新数据的记录 ID ,以及记录数据。对于多次更新,只有第一次更新进入表缓存。
(4 )导出表数据到文件
在表数据的处理上,我们将除了CheckPoint 过程中新创建的数据块,其余都全量导出到文件中。由于服务是不阻塞等待的,所以在这个过程中表数据会被持续更新。在此,我们并不关心数据块中的数据是否一致,数据的一致性将在后续步骤 5 处理。
(5 )利用缓存更新文件
由前文2 、 3 两点可知,在 CheckPoint 状态为 “1- 数据导出 ” 期间,所有变更在表缓存中都有记录。在表数据导出到文件后,使用表缓存的记录更新文件,这样就保证了数据的一致性。即 CheckPoint 文件就是进入 CheckPoint“1- 数据导出 ” 状态的时间点的一个数据快照。这里的更新可能存在随机写,但 CheckPoint 过程较快,随机写的数据量不大,其造成的影响基本可以忽略。
文件更新规则:
-insert :删除
-update :用原记录复原
-delete :用被删除记录复原
2. 高效、简洁
CheckPoint 的高效体现在两个方面: 1 )导出高效; 2 )导入高效。下文介绍实现简洁、高效的相关设计。
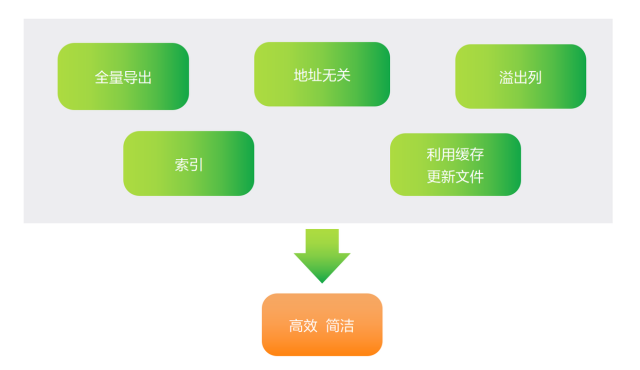
图3 :设计实现 - 高效简洁
(1 )全量导出
AntDB-M 的 CheckPoint 为全量导出,与 MySQL Innodb 的 CheckPoint 有着很大的不同。下面将从 4 个方面来介绍为什么采取全量导出。
内存开销压力
作为一款内存数据库,AntDB-M 的所有数据都存放于内存之中,不需要考虑数据消耗过多内存的问题(仅数据本身而言)。因此我们不需要因为数据占用内存而实时地考虑将数据导出到文件。
高可用保障
作为一款高可用分布式数据库,AntDB-M 采用了多副本机制,因此我们可以通过多服务达到高可用的目的。数据的导出主要是为了降低服务重启时较长的加载时间以及主从数据同步时间,所以 CheckPoint 文件并不是高可用的主要手段。即 CheckPoint 文件导出不要求较高的实时性,较低的导出频率对高可用的影响不大。
读写性能
影响数据导出、导入效率的最大因素为磁盘的读写性能,磁盘采取顺序读写的效率最高。因此我们在进行数据导出、导入时,不对数据在内存、文件间做格式转换,直接进行读写的效率最高。如果做增量同步,就可能会出现频繁的随机读写、复杂的转换及文件存储空间占用等问题。这些都对效率的提升、系统的复杂度有着极大的负面影响。
导出时间
由于AntDB-M 的内存结构设计非常紧凑、内存地址无关,因此数据可以不做转换地进行导出、导入。数据导出、导入的效率非常高,一次导出时间可控制在接受时间范围内。
综合以上几点,AntDB-M 采取全量导出具有更大的效率、成本优势。
(2 )地址无关
AntDB-M 的内存结构非常紧凑,这避免了数据空间的浪费。导出的数据量,除了必要的数据存储空间,不需要额外的管理空间。另外一个实现高效的导出、导入的设计就是地址无关,这避免了在导出、导入时大量的地址映射转换。
记录ID
记录ID 是内存结构中一个非常重要的设计。所有数据记录都有一个的记录 ID 。通过对记录 ID 进行简单、高效的取模、取余运算即可获取到记录所在的内存地址。这使得表数据的存储可以与地址无关,确保导出、导入时不需要做地址转换。
多级管理
AntDB-M 中每个表都有各自独立的表空间,每个表空间采取三级管理。其中,第一、二级均为只存在于内存中的地址空间,第三级为地址无关的数据块。在导出时,我们只需导出数据块即可。在导入时,按照内存块的顺序,我们需在内存中申请好三级内存空间,并建立三级空间之间的关系。在这部分,数据量很少,速度很快。
由于数据块内的内容地址无关,我们在导出时将数块整体写入文件,在导入时将文件中的数据直接原样读入到对应内存数据块中即可。这样就极大提升了导出、导入效率。
空闲记录
数据块的空闲地址的管理数据也是在数据块本身上记录,不需要额外的管理单元。所有空闲记录构成一个双向链表,只需额外记录最后一个空闲位置即可。另外,我们需要对每行记录保留额外的1 个字节标识当前记录状态。
通过以上设计,数据块的管理在紧凑、简洁的同时,效率也非常高。
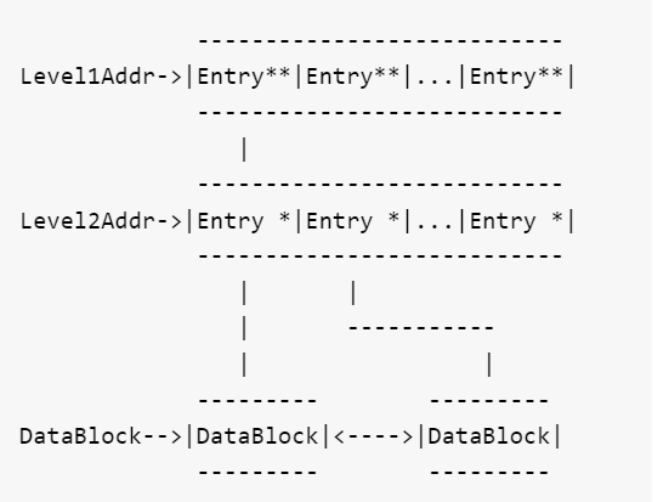
图4 :表空间多级管理
(3 )溢出列
AntDB-M 以溢出列的方式对可变长度列进行单独管理,有自己的内存空间及结构。数据块中仅保存固定长度列,以及溢出列的长度、记录 ID 。
溢出列的结构设计和数据块类似,同样保持多级、地址无关的设计。同时,为了节省内存和实现高效,溢出列每行长度固定,不同列长度可能不同。每行额外保留一个记录ID ,当长度超过 1 行长度时,记录数据的下一行保存位置。
(4 )索引
AntDB-M 支持两种索引: 1 ) Hash ; 2 ) Btree 。 CheckPoint 导出时只会导出索引的元数据。数据会在内存中重新构造。
(5 ) CheckPoint 文件结构
CheckPoint 最终会将每个表单独生成一个文件,大致分为 5 个部分: 1) 表元数据; 2 )溢出列; 2 )数据块; 4 )列元数据; 5 )索引。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70026696/viewspace-3002530/ ,如需转载,请注明出处,否则将追究法律责任。

