1.执行计划简介
执行计划(execution plan,也叫查询计划或者解释计划)是数据库执行SQL语句的具体步骤。简单而言,SQL的执行计划类似于解数学题中不同的方法,好的优化器能找到良好的执行方法,并且选择该方法将SQL执行完。当然,部分AI优化器还能做到执行计划动态调整,能够随着执行过程中数据量以及数据分布动态调整更合适的执行计划然后重新执行。
QianBase MPP数据库采用CBO(Cost-Based Optimization,基于代价)在不同执行计划中选择成本(Cost)较低的执行计划,然后使用该计划将SQL执行完并返回给客户端。
注意:
1)首先优化器生成不同种类执行计划
2)然后选择代价 较低执行计划
执行计划所做的事包括(但不限于):
-
扫描方式(索引扫描还是全表扫描)
-
Join的方式(hash还是merge还是nested loop)
-
Join的顺序
-
Join的实现(广播或者重分布)
-
聚合的方式
在查看执行计划时,QianBase MPP同大部分数据库一样,提供了explain命令,帮助用户分析数据库执行计划如何执行、是否合理等等。
2.explain的使用
2.1explain介绍
解释计划是一份报告,它详细描述了QianBase MPP数据库优化器确定的执行查询要遵循的步骤。计划是一棵由结点构成的树,应该从底向上阅读,每一个结点表示计划中的一个步骤,并且都会将其结果传递给其直接上层结点,单个结点对应的那行信息标识了在该步骤中执行的操作,例如:
-
扫描
-
连接
-
聚集
-
排序
结点还标识了用于执行该操作的方法。例如,扫描操作的方法可能是顺序扫描或者索引扫描,而连接操作可以执行哈希连接或者嵌套循环连接。
2.2explain示例
下面是一个简单查询的解释计划。我们以TPCH测试的query3为例
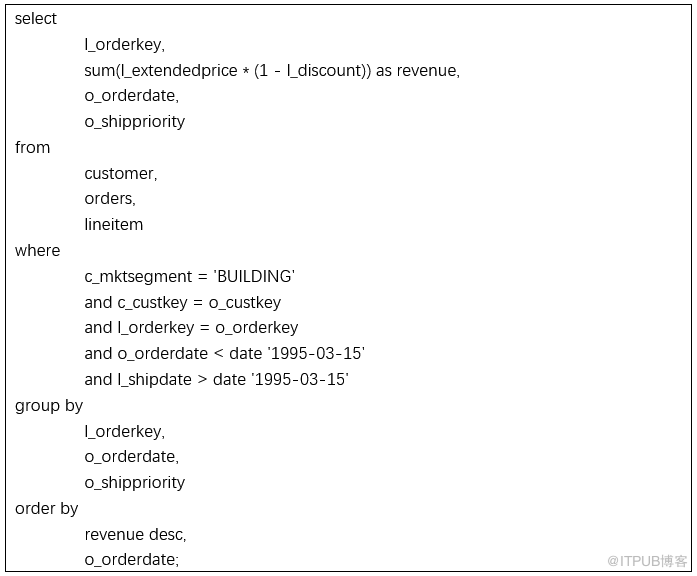
执行计划如下:
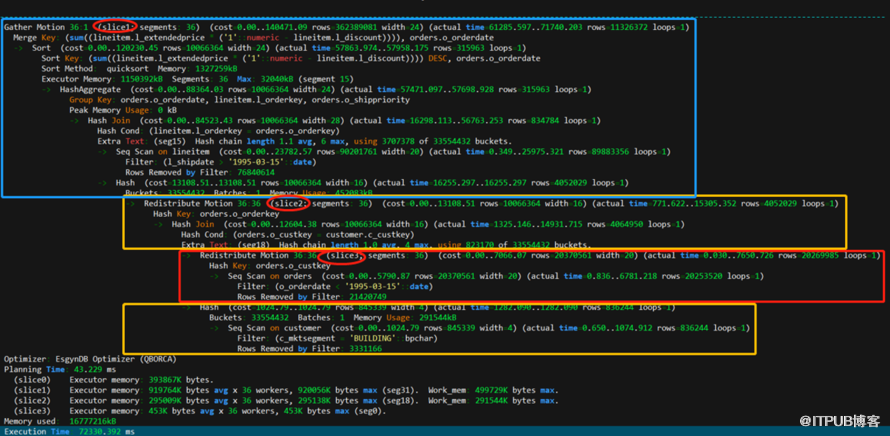
注意:
1)查看执行计划时,请先找到对应slice关键字;
2)每个slice包含自身行以及缩进行;
3)上述红色框表示slice3、黄色框表示slice2、蓝色框表示slice1。
2.3explain阅读
我们自下而上地阅读执行计划:
-
slice3
对orders表进行顺序扫描,过滤出o_orderdate < '1995-03-15'的数据,然后以o_custkey为分布键进行redistribute motion以实现下一步与表customer的关联(关联条件:c_custkey = o_custkey)。
-
slice2
顺序扫描customer表,过滤出c_mktsegment = 'BUILDING'的数据,与slice3的结果进行hash join,然后将这里的join结果按o_orderkey为分布键进行redistribute motion,以实现下一步与表lineitem的关联(关联条件:l_orderkey = o_orderkey)。
-
slice1
顺序扫描lineitem表,过滤出l_shipdate > '1995-03-15'的数据,与slice2的结果进行hash join,并将该join结果按l_orderkey,o_orderdate,o_shippriority进行group by,最后再对group by的结果进行排序。
2.4explain总结
将query3的执行计划抽象为下图,可以看到整个查询被两次Redistribute Motion切分为3个slice,不同的slice之间并行处理可以 max化整个查询的并行度,即3张表可以同时开始扫描。
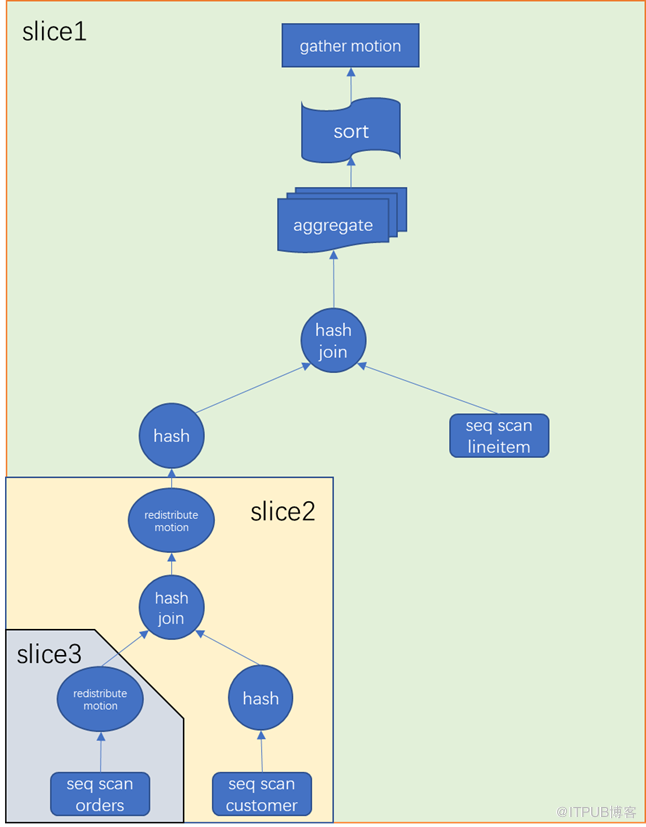
其中有一些关于执行计划的概念
-
Motion:motion算子负责在不同的segment实例之间移动数据。包括redistribute motion、broadcast motion、gather motion
-
Slice:motion算子将执行计划切割成不同的slice,不同的slice之间可以并行处理
3.explain参数解释
3.1ANALYZE
执行命令并显示实际运行时间和其他统计信息。 如果省略此参数,则默认为FALSE。 指定ANALYZE true可以启用它。
3.2VERBOSE
显示有关计划的其他信息。具体来说,包括计划树中每个结点的输出列列表,模式限定表和函数名称, 始终在表达式中使用范围表别名标记变量,并始终打印要显示其统计信息的每个触发器的名称。 如果省略此参数,则默认为FALSE; 指定VERBOSE true启用它。
3.3COSTS
包括有关每个计划 结点的估计启动成本和总成本以及估计的行数和估计的每行宽度的信息。 如果省略此参数,则默认为TRUE; 指定COSTS false禁用它。
3.4BUFFERS
包括有关缓冲区使用情况的信息。 具体来说,包括命中,读取,弄脏和写入的共享块的数量,命中,读取,弄脏和写入的局部块的数量以及读写的临时块的数量。 命中表示避免读取,因为在需要时已在高速缓存中找到该块。 共享块包含来自常规表和索引的数据;本地块包含来自临时表和索引的数据; 临时块包含用于排序,哈希,物化计划 结点和类似情况的短期工作数据。 被弄脏的块数表示此查询已更改的先前未修改的块数; 而写入的块数则表示此后端在查询处理期间从缓存中逐出的先前处理的块数。 上级 结点显示的块数包括其所有子 结点使用的块数。 在文本格式中,仅打印非零值。 仅当还启用了ANALYZE时,才可以使用此参数。 如果省略此参数,则默认为FALSE; 指定BUFFERS true启用它。
3.5TIMING
在输出中包括实际的启动时间和在每个 结点上花费的时间。 重复读取系统时钟的开销可能会在某些系统上显著降低查询速度, 因此,当仅需要实际的行计数而不是确切的时间时,将此参数设置为FALSE可能会很有用。 即使使用此选项关闭了 结点级计时,也始终会测量整个语句的运行时间。 仅当还启用了ANALYZE时,才可以使用此参数。 默认为TRUE。
3.6FORMAT
指定输出格式,可以是TEXT,XML,JSON或YAML。 非文本输出包含与文本输出格式相同的信息,但程序更易于解析。 此参数默认为TEXT。
3.7boolean
指定是打开还是关闭所选选项。 您可以写入TRUE,ON或1以启用该选项, 而可以写入FALSE,OFF或0以禁用该选项。 布尔值也可以省略,在这种情况下,假定为TRUE。
3.8statement
您希望查看其执行计划的任何SELECT,INSERT,UPDATE, DELETE,VALUES,EXECUTE, DECLARE或CREATE TABLE AS语句。
4.执行计划中的术语
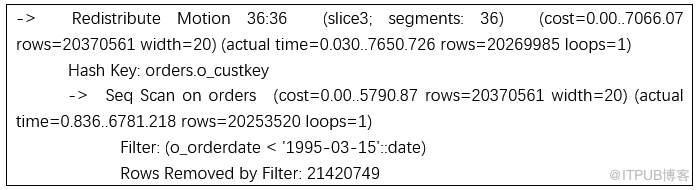
以执行计划中下述片段为例:
4.1扫描方式
在slice3中以Seq Scan的方式对orders表进行全表扫描,使用Filter: (o_orderdate < '1995-03-15'::date)条件对扫描结果进行过滤,Rows Removed by Filter: 21420749 显示单个segment 结点上filter移除的行数。
4.2sql成本
样例一:(cost=0.00..5790.87 rows=20370561 width=20)
-
cost:优化器根据预设的参数评估出的SQL执行代价
-
rows:优化器根据统计信息评估出的数据行数
-
width:评估的一行数据的宽度
样例二:(actual time=0.836..6781.218 rows=20253520 loops=1)
-
actual time:执行explain analyze时会显示当前算子的实际执行时间actual time,时间格式为“开始时间..结束时间”,时间单位为毫秒。
-
rows:单个segment实际扫描的行数
-
loops:当前算子循环执行的次数
4.3motion操作
-
gather motion
将各segment 结点计算的数据结果收集到master 结点。比如在求某张表max值时,通常是所有segment执行完 max值之后再将结果汇总给master 结点,最后由master 结点统计出最终的结果。
-
broadcast motion
将数据广播到所有segment 结点。比如在小表与大表关联的时候,如果分布键不同,优化器会选择将小表的数据广播到大表所在的segment上,然后每个segment对被广播的小表数据再加上大表在该segment上的数据进行关联操作。
-
redistribute motion
将数据根据新的分布键在所有segment 结点上打散。在多表join时按照join条件进行重分布,使同一个关联键的数据分布在同一个segment 结点上。比如处理分布键不同的两张大表的join操作,通过广播的方式很明显会加大网络流量与每个segment处理的数据量,所以系统会对两张大表按照关联键将数据进行重分布到每个segment,然后每个segment各自处理对应数据后汇总给master 结点。
5.如何根据explain analyze发现sql的执行问题
5.1观察执行计划是否合理
由于SQL优化器本身算法的限制,优化器选择出的结果并不保证是全局独一无二的优解,适当的情况下可以人工进行干预。
5.2观察整个SQL中执行时间长的部分是否正常
观察每一步执行的actual time,找到整条SQL中的的瓶颈点,考虑有没有更好的配置或者实现方式能够更好地实现目的,另外即使在执行计划是最完美的情况下,sql的执行还会受物理环境的限制,并不能说计划合理便代表SQL执行的时间正常,因此需要对耗时长的步骤仔细评估。
5.3观察是否存在配置不足导致的问题
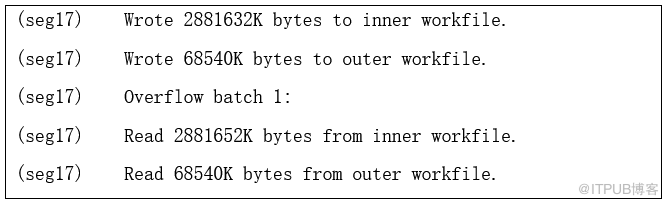
充分地调用资源才能发挥出更好的数据库性能,某些配置不合理的情况下,会在explain analyze中展示出来,比如如下的例子中出现了关联时溢出到磁盘的操作,适当地增加内存分配消除此阶段可以减少性能开销。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70026636/viewspace-2938003/ ,如需转载,请注明出处,否则将追究法律责任。

