LLM
(
Large Language Model
)是指大型语言模型,是一类使用深度学习技术构建的自然语言处理(
NLP
)模型。
LLM
模型可以处理各种语言任务,如文本生成、文本分类、机器翻译等。
为帮助大家更好地了解这一领域的相关知识要点,今天精选了5 篇关于 LLM 领域的优秀文章。为便于大家阅读,我们仅列出文章标题、主要内容概要以及核心要点。如果您对某篇文章感兴趣,可以点击后面的链接访问完整内容。
一、LLM 训练 -pretrain
本文探讨了自研预训练模型的意义、数据准备、模型结构选择、训练技巧、评估方法和流程,介绍Megatron 和 deepspeed 训练框架的利弊以及训练效率优化和评估指标。
自研预训练模型的意义在于掌握 pretrain 的技术能力,满足特定需求、控制数据和模型质量,并且可以实现宣传科研能力、埋彩蛋等非技术性价值。数据获取、清洗、去重、配比和顺序等流程都对预训练模型质量有着关键影响,作者建议组建数据团队来获取数据,爬虫或购买是必须的,网上开源数据集在清洗之后根本不够使用, “ 清洗 ” 作为数据环节最最核心的工作,可以利用模型对 pretrain 数据的质量进行打分,以及要尽可能对数据进行脱敏,把训练数据中涉及到的人名、电话号码、邮箱等剔除出去,避免构成隐私侵犯。对 T 级别的数据进行去重是数据环节最考研工程能力的环节,需要选择合适的去重粒度和实现方式避免重复数据对模型训练的影响,使用 BERT 家族模型进行数据分类,根据不同类别调整处理策略,打好类别后再进行配比工作。 pretrain 的本质是一个教模型学知识的过程,数据顺序很重要,作者推荐 llama 的 In context pretrain 工作:利用语义相似度,优先将最相似的 document 进行拼接,从而构成语义更加连贯流畅的上下文。数据处理和模型训练独立进行,保证 GPU 持续训练,应该标记数据使用次数,降低高频数据被选中概率,合理设置数据块大小和检查点保存机制。在数据环节都串起来后,不要盲目去开始训练,先在小模型上做好实验, pretrain 阶段的实验需要做得更加鲁棒。
除此之外,文章在模型训练、模型评估等方面也做了相应探讨。
https://zhuanlan.zhihu.com/p/718354385
作者: ybq
二、LLM 训练 -sft
本文探讨了大模型sft 的训练、评估和调试方法。强调数据多样性和质量的重要性,介绍利用 GPT4 生产数据、特殊 token 标记和复杂指令处理等技术,通过实战经验和案例分析,提出夹逼准则和人机结合评估策略,旨在优化模型性能和解决过拟合问题。
SFT 主要通过标注数据来引导模型遵循指令。 SFT 过程中的关键在于使用特殊的标记来定义对话角色。 SFT 面临的挑战包括模型生成速度与生成 token 数量的关系,以及如何避免模型产生幻觉 —— 即模型生成错误信息。对于幻觉问题,文章指出,虽然完全消除广义幻觉较为困难,但可以通过 SFT 和强化学习( RLHF )使模型学会在不确定时拒绝回答。 SFT 训练数据的核心是数据多样性和数据质量。数据多样性包括 “ 数据用途 ” 和 “ 数据形式 ” ,每一条 SFT 训练数据必须要 task_type 类型,数据形式不能让模型找到规律。关键信息在 prompt 中的位置分布要足够随机。模型上线后的用户反馈是优化 SFT 的重要来源,形成用户日志到数据更新再到模型迭代的数据飞轮是保持模型性能的关键。另外,文中提到构建模型时应考虑鲁棒性,即模型应对表述不清或含有错误的提示仍能给出合理回应。对于特定领域的任务,如检索增强( RAG )、长文本处理等,则需要专门的数据集和技术手段来应对。例如, RAG 需要建立有效的知识库检索机制,数据库知识准确率高于模型自己具备的知识。并确保模型在面对不同检索结果时的表现。而对于长文本处理,则需调整模型架构以支持更长的序列长度,并准备相应的训练数据。在监督微调 (SFT) 中,直接使用标准 SFT 方法比 Lora 更可靠。训练时遵循 “ 小模型大学习率,大模型小学习率 ” ,重视 warmup ,关注 loss 曲线变化。适度过拟合有助于指令遵循,但要避免对特定答案过拟合。通过优化训来数据来缓解过拟合,主要措施是删减对应 task_type 的数据,或是扩充该 task_type 的数据多样性。
SFT 工作相对简单,只要有计算机基础并保持积极态度,即可胜任此类任务。
https://zhuanlan.zhihu.com/p/809229182
作者: ybq
三、LLM 预训练与 SFT 数据配比调研
文章讨论了LLM 预训练数据增强与清洗技术,如 Qwen 和 LLAMA 的数据处理方法,以及 SFT 数据配比实验。强调数据质量、多样性的重要性,并介绍不同模型的数据使用情况。
分析Qwen2 和 LLAMA3.1 的数据预处理、数据增强、数据配比策略以及一些用于监督微调( SFT )的技术细节。重点强调 Qwen2 和 LLAMA3.1 在数据清洗、过滤、增强方面的方法,包括但不限于使用启发式过滤、模型过滤、数据扩充和长上下文训练等方式来提高数据质量。报告指出, LLM 的训练数据量从几万亿 token 增长至数十万亿 token ,并且探讨了不同类型数据(如代码、数学推理、多模态数据)在总体数据中的比例分配。还提到了一种名为退火训练的技术,它可以用来评估小规模领域数据的价值。对 SFT 数据, LLAMA 与 Qwen 用了相似的数据处理技术,包括 RS 、清洗、话题分类、质量打分、难度打分、语义去重和合成数据,规模达 2.7M 。
随着模型规模的增长,数据配比策略逐渐成为商业秘密的趋势。
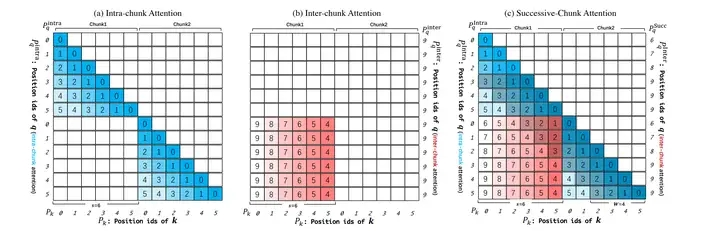
Dual Chunk Attention
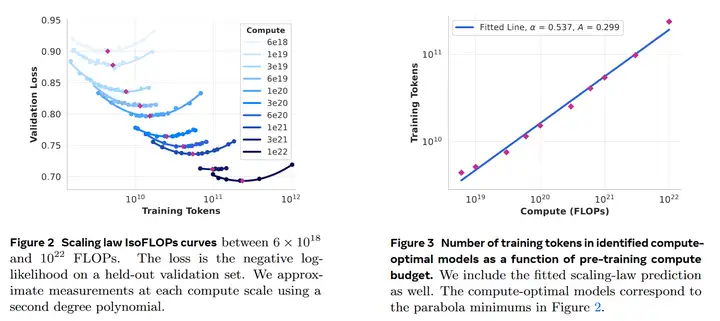
Scaling Law 实验

左图为浮点计算量与Loss 的 scaling law 曲线,右图是 loss 与 accuracy 之间的曲线。有趣的一点是, loss 与 acc 的关系,不是一个线性的!这点值得关注。
https://zhuanlan.zhihu.com/p/703825827
作者:天晴
四、LLM 数据合成之后训练篇
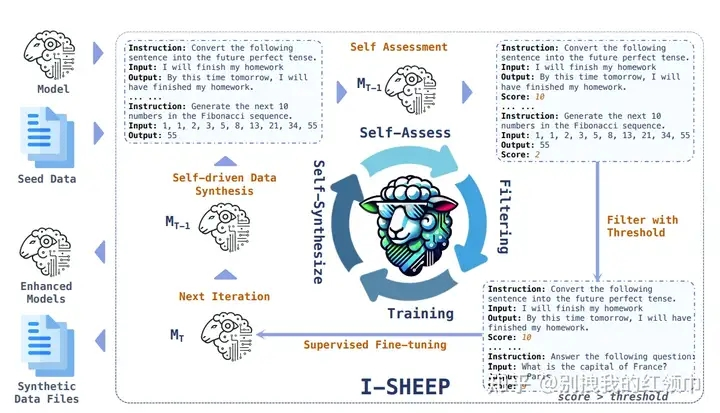
文章探讨了利用LLM 进行数据合成的三种方法:直接生成 pair 、生成问题或答案、以及模型自身迭代。通过 Nemotron-4 、 META-REWARDING 和 I-SHEEP 等实验,强调数据合成在提升模型性能中的作用,以及对生成数据质量评估的需求。
Nemotron-4 340B 模型的训练中,超过 98% 的数据是合成生成的,通过人工标注部分数据训练 reward 模型,再利用此模型评估生成的 pair 质量,选择高质量的数据用于下一轮训练。这种方法与传统自训练方法的主要区别在于使用了强大的 reward 模型来选择高质量数据,而非简单的阈值规则。另一项研究提出了 meta-judge 的概念,模型在同一时间承担 actor (生成响应)、 judge (评估响应质量)和 meta-judge (评估 judge 的判断质量)的角色,通过迭代训练提升模型性能。而 I-SHEEP 方法则更加简洁有效,通过生成响应、自我评估、过滤和监督微调的流程,实现了从无到有的持续自我对齐,尽管没有引入额外信息,但在实验中显示了显著的改进。
数据合成方法的核心在于如何准确评估生成响应的质量,这可以通过强大的reward 模型或模型自我评估来实现。
https://zhuanlan.zhihu.com/p/715155768
作者:别拽我的红领巾
五、大模型SFT 数据精选方法串讲: IFD 、 Supperfiltering 、 MoDS 、 CaR 、 Nuggets 与 LESS
本文探讨了大模型SFT 数据的精选方法一些方法,包括 IFD 、 Supperfiltering 、 MoDS 、 CaR 、 Nuggets 和 LESS 等。强调数据质量、多样性和必要性的重要性,并推荐结合多种方法以提高模型性能。
非目标导向的方法,如IFD 和 Superfiltering ,主要适用于无特定优化场景的通用模型。 IFD 通过计算 Instruction-Following Difficulty ( IFD )指标来评估数据集的价值,选取高 IFD 的数据以构建高质量训练集。 Superfiltering 则通过使用较小模型替代大模型来提高筛选效率。 MoDS 和 CaR 方法综合考虑数据质量、覆盖面和必要性,前者通过多步筛选实现,后者简化流程,但两者均需依赖外部评分模型。目标导向的方法,如 Nuggets 和 LESS ,侧重于特定应用场景的优化。 Nuggets 方法通过评估训练数据对测试集的增益效果来选择高质量数据。 LESS 方法则直接考察训练数据对测试集损失的影响,选择那些能最大化降低损失的数据作为训练集。这两类方法更贴近实际业务需求,能够针对具体场景优化模型性能。
确保数据集的高质量、多样性和必要性是关键。在实际工业落地中,推荐使用目标导向的方法,因为它们更贴合具体业务场景。同时,可以使用多种筛选方法结合的方法来增强模型的鲁棒性。需要注意数据叠加可能带来的非线性效应,避免数据冗余或相互冲突的问题。
通过上述方法的组合应用,可以有效提升SFT 数据集的质量,从而更好地引导大模型生成高质量输出。
https://zhuanlan.zhihu.com/p/692647330
作者:周星星

景联文科技|数据采集标注|智能标注平台
助力人工智能技术,赋能传统产业智能转型升级
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70025739/viewspace-3039982/ ,如需转载,请注明出处,否则将追究法律责任。

