目前,大语言模型的发展已经取得了显著的成果,如 OpenAI的GPT系列模型、谷歌的BERT模型、百度的文心一言模型等。这些模型在文本生成、问答系统、对话生成、情感分析、摘要生成等方面都表现出了强大的能力,为自然语言处理领域带来了新的突破。

然而,这些大语言模型也存在一些有关数据方面的难题。
幻觉问题: 大模型在处理输入时,会根据大量的训练数据学习语言规则和模式,生成看似合理和准确的回答。然而,在某些情况下,这些模型可能会过于自信地回答问题,或者在回答中包含不准确的信息。 为了减少幻觉, 我们需要针对特定领域和场景进行更加精细的训练和调整,以提高模型的准确性和可靠性 。度量幻觉的度量标准也有助于评估和比较不同模型的表现。
数据质量和标注多样性: 大语言模型的训练需要高质量的多模态数据,这些数据需要经过精确的标注和处理,以确保模型的训练效果。由于多模态数据的复杂性和多样性,数据质量和标注准确性很难得到保证。
数据偏见和歧视: 大语言模型的训练数据也可能存在偏见和歧视问题,这会影响模型的公正性和准确性。例如,如果训练数据中存在性别、种族、文化等方面的偏见,那么训练出的模型也会存在类似的问题。
数据更新和适应性: 大语言模型的训练数据需要不断地更新和调整,以适应语言的变化和发展。然而,由于模型的结构和参数通常非常庞大,对数据进行调整和更新需要花费大量时间和资源。
数据隐私和安全: 大语言模型的训练需要大量的数据,如何在保证数据隐私和安全的前提下,利用数据进行模型训练是一个重要的问题。
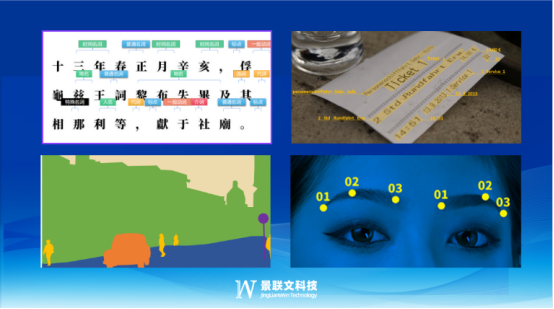
景联文科技提供高质量结构化数据, 助力 大语言模型 提高 性能和可靠性。 主要类别包括:
l K12教育题库,大学职业题库
l 医疗医学知识数据库
l 多场景多轮对话数据
l 文生图训练数据
l 文章校阅编写训练数据
l 等等
同时景联文科技提供大语言模型训练数据的标注服务,建立一系列 数据分发、清洗、标注、质检 、交付的标准化操作流程 , 为全球数千家人工智能从业公司和高校科研机构交付海量、高质量的AI 大语言模型 训练数据。
景联文科技|数据采集|数据标注
助力人工智能技术,赋能传统产业智能化转型升级
文章图文著作权归景联文科技所有,商业转载请联系景联文科技获得授权,非商业转载请注明出处。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70025739/viewspace-3003592/ ,如需转载,请注明出处,否则将追究法律责任。

