8月22日Facebook的母公司Meta Platforms发布 了 一种能够翻译和转录数十种语言的人工智能模型——SeamlessM4T , 可以 在日常生活中 或者 商务交流中为用户提供更便捷的翻译和转录服务 。
相较于传统的文本翻译,这项技术的最大区别在于它可以实现端到端的语音翻译,即将一种语言的语音直接翻译成另一种语言,使得人们可以直接交流,而无需经过复杂的中间转换过程。
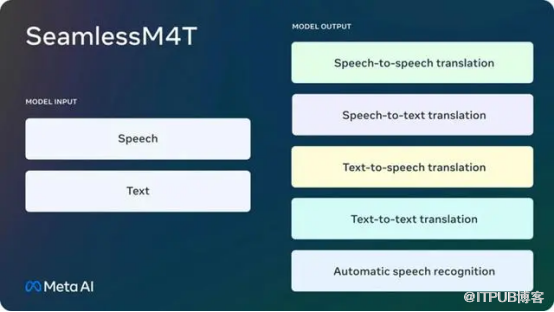
SeamlessM4T支持:
1、近100种语言的语音识别。
2、近100种输入和输出语言的语音到文本翻译。
3、支持近100种输入语言和36种输出语言的语音到语音翻译。
4、支持近100种语言的文本到文本翻译。
5、支持近100种输入语言和35种输出语言的文本到语音翻译。
SeamlessM4T支持的语音到语音翻译模型需要大量高质量的端到端数据。满足近100种语言语音翻译的需求,仅依靠人工转录和翻译语音是困难的,因为构建语音翻译数据集的流程既复杂又成本高昂。在获得授权音频的前提下,需要进行对应的转录和翻译,然后将音频、转录和翻译进行切分,最后进行对齐和过滤以获得有效数据。
景联文科技拥有丰富的语音数据采集标注项目经验,自建专业语音采集录音室 , 有高度还原真实场景能力,在全国 30多个省市有近一万人的被采集人员储备,全球范围内也有采集渠道,支持多语种、多方言语音采集。 自有的 数据 管理 平台 , 打通数据闭环, 可 有序进行数据分发、清洗、标注、质检、等环节, 交付高质量的训练数据 ,提高企业 AI数据训练效率 , 加速人工智能相关应用的落地迭代周期 。
景联文科技|数据采集|数据标注
助力人工智能技术,赋能传统产业智能化转型升级
文章图文著作权归景联文科技所有,商业转载请联系景联文科技获得授权,非商业转载请注明出处。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70025739/viewspace-2981901/ ,如需转载,请注明出处,否则将追究法律责任。

