MapTask工作机制
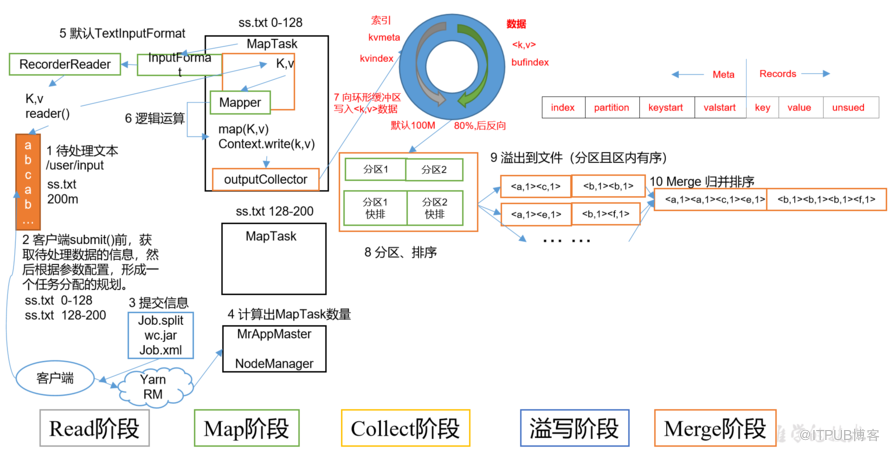
Read阶段:MapTask通过用户编写的RecordReader,从输入的InputSplit中解析出一个个key/value。
Map阶段:将解析出的key/value交给用户编写的map()函数处理,并产生一系列新的key/value。
Collect阶段:在用户编写的map()函数中,数据处理完成后,一般会调用outputCollector.collect()输出结果,在该函数内部,它会将生成的key/value分片(通过调用partitioner),并写入一个环形内存缓冲区中。
Spill阶段:即“溢写”,当环形缓冲区满后,MapReduce会将数据写到本地磁盘上,生成一个临时文件。需要注意的是,将数据写入本地磁盘之前,先要对数据进行一次本地排序,并在必要时对数据进行合并、压缩等操作。
Combine阶段:当所有数据处理完成后,MapTask对所有临时文件进行一次合并,以确保最终只会生成一个数据文件。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70024433/viewspace-2986717/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
Flink提交Job的方式以及参数设置
下一篇:
Hadoop maptask 工作机制

请登录后发表评论
登录
全部评论
