Spring Blog
Spring AI 2.1 Message Parts:可完整往返的推理内容
Spring AI:Message Parts 文档 | 升级说明 | OpenAI Responses 文档 | Session 文档
推理模型不仅会在回答前进行思考,还会将部分思考内容返回给你,并期望在下一个请求中收到这些内容。Claude 会对其思考块进行签名。Gemini 会在其函数调用上附加思考签名。OpenAI 的 Responses API(应用程序编程接口) 会返回加密的推理项。如果你丢弃、重排或修改它们,结果轻则返回 HTTP 400,重则模型会悄然丢失先前的推理内容并重新开始。
在此之前,Spring AI 的消息只是一段文本,附带工具调用和媒体的旁路列表。这些数据无处存放,更不用说它们的顺序了。Spring AI 2.1 改变了数据模型本身:现在每条消息都将其内容保存为有序的消息部件(message parts)列表。一个部件是响应中的一部分,例如一段文本、一个推理块或一个工具调用。各提供商将这些部件称为内容块(Anthropic、Bedrock)、部件(Gemini)、项(OpenAI Responses)或块(Mistral),Spring AI 将它们全部映射为消息部件。
在 2.1.0-RC1 候选版本中,主要聊天模型已能生成和消费部件:OpenAI Responses、Anthropic、Google GenAI、OpenAI Chat Completions、Ollama、Bedrock Converse、DeepSeek 和 Mistral AI。该版本还新增了 Session 记忆,可持久化这些部件。本文介绍这一新抽象、Responses API 为何需要它,以及各聊天模型从中获得了什么。归结为三条规则:保持顺序、原样重放收到的内容、持久化部件而非文本。
为什么字符串不够用
Claude 在启用思考功能时,在单次工具调用轮次中返回的内容:
thinking   "The user wants the weather in Paris. I should call get_weather..."   signature: "EqQBCgIYAhIM..."
text       "Let me check that for you."
tool_use   get_weather {"location": "Paris"}
当你发送工具结果时,Anthropic 希望这一轮次原样返回:相同的块、相同的顺序,包括签名。在 2.1 之前,AssistantMessage 无法做到这一点:
- 跨类型无顺序。文本、工具调用和媒体存放在不同字段中,因此重放时必须猜测顺序。
- 不透明数据无处存放。签名和加密推理是不透明的:客户端无法读取它们,必须原样发回。它们被放在提供商特定的元数据键下或包私有的子类中。
- 流式处理丢失了它们。聚合器逐键合并块元数据,因此思考内容通常只保留了最后一个片段。
- 记忆丢失了它们。JdbcChatMemoryRepository 只存储文本和消息类型。
MessagePart 抽象
AbstractMessage 现在持有一个 parts: List<MessagePart>,由所有消息类型共享:
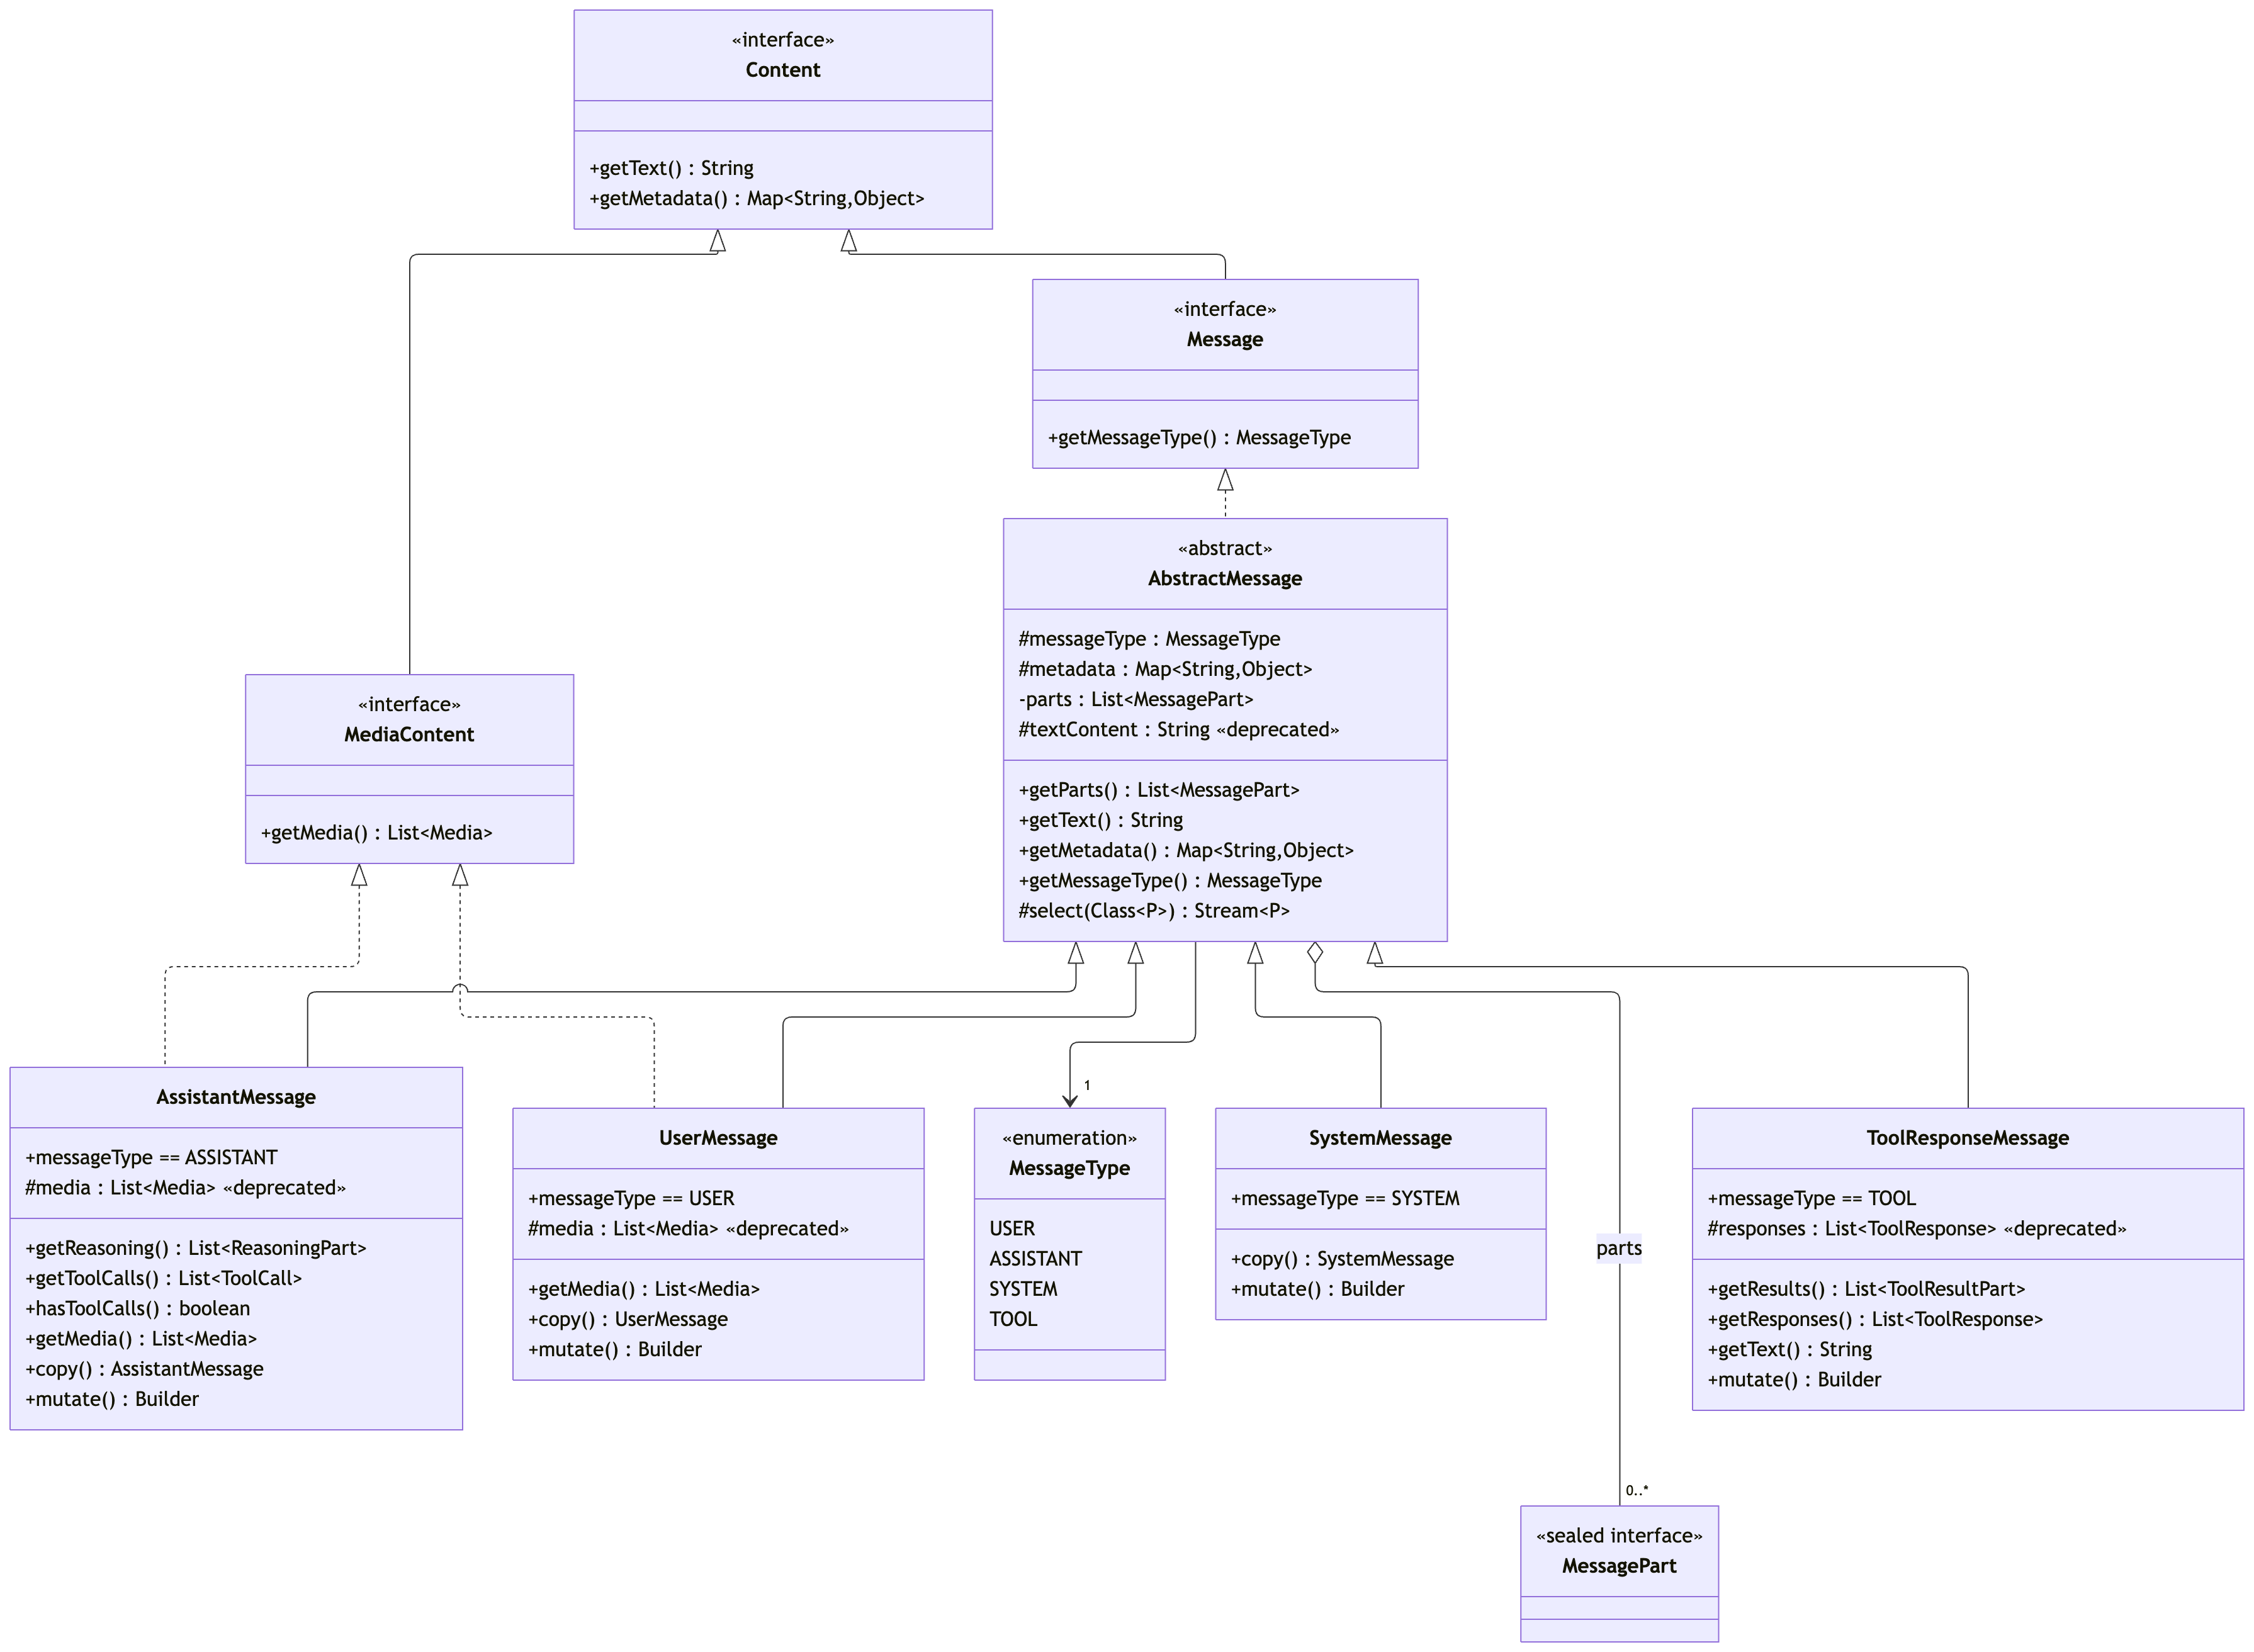
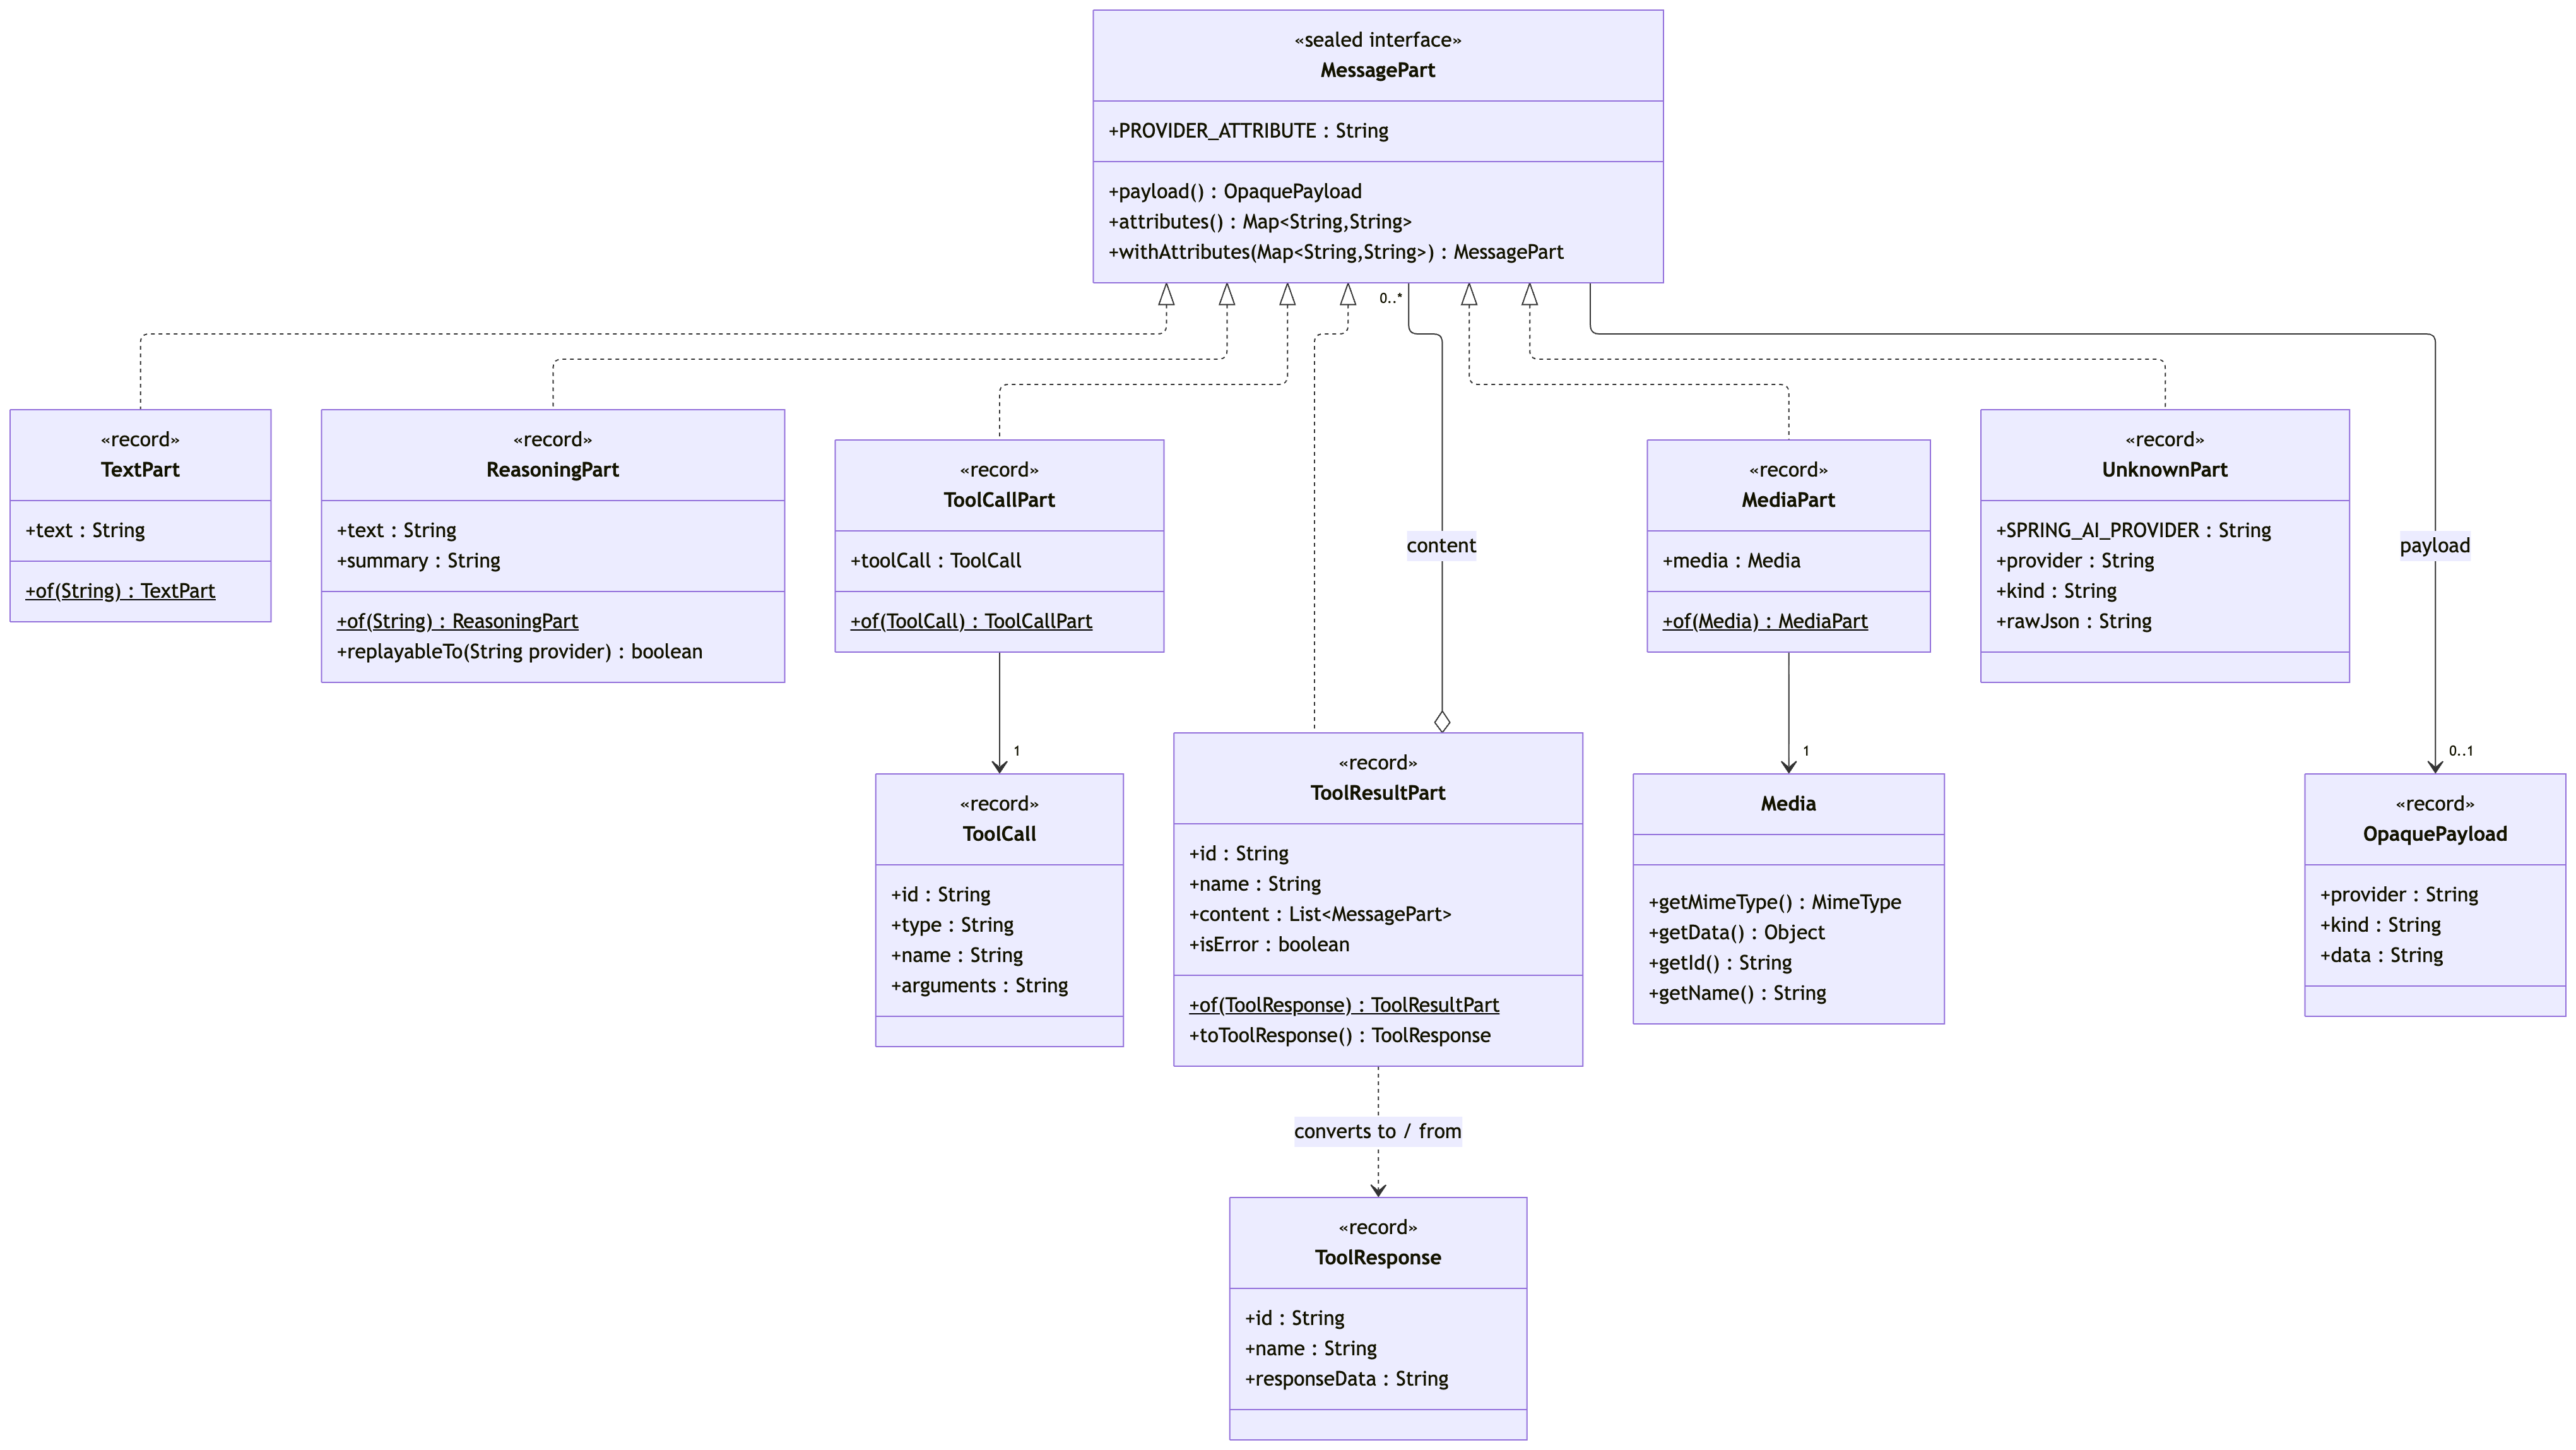
MessagePart 是一个密封接口,包含六个 record 实现:
| Part | 持有内容 | 用途 |
| --- | --- | --- |
| TextPart | 一段文本 | 回答、提示词 |
| ReasoningPart | 推理文本、可选的摘要、可选的载荷 | Claude thinking、Gemini thoughts、DeepSeek reasoning_content |
| ToolCallPart | 一个 AssistantMessage.ToolCall、可选的载荷 | 函数调用 |
| ToolResultPart | 一个工具结果,其内容是其他 MessagePart 的列表 | 携带文本以外内容的工具结果 |
| MediaPart | 一个 Media:图像、音频、视频、文档 | 多模态输入和输出 |
| UnknownPart | Spring AI 未建模的块的原始 JSON | 服务器工具调用、引用、代码执行 |
引入 MessagePart 实现了:
- 顺序即数据。各部分保持提供方生成它们时的顺序,因此 thinking 块会保留在它所引导的工具调用之前。
- 不透明载荷会被原样回放,绝不会被解释。一个部分可以携带 OpaquePayload(provider, kind, data),例如 Anthropic signature、Gemini thought_signature 或 OpenAI encrypted_content。生成它的 ChatModel 会将其原样发回,其他所有聊天模型都会跳过它。这使得历史记录可以安全地在不同提供方之间迁移。
- 不会静默丢弃任何内容。ChatModel 不理解的块会变成 UnknownPart,并原样回放给生成它的提供方。
此变更向后兼容。构造函数和 builder 方法继续可用,并按 2.0 使用的顺序生成各部分:文本、工具调用、媒体。getText()、getToolCalls() 和 getMedia() 现在是对各部分的视图,与新增的 getReasoning() 并列,而 getParts() 按顺序返回所有内容。读取推理内容的代码最可能需要更新,因为在 2.1 之前,每个聊天模型暴露它的方式都不同:
ChatResponse response = chatModel.call(prompt);

// Before 2.1: each chat model exposed reasoning its own way
List<String> thoughts = response.getResults().stream()              // Google GenAI
    .filter(g -> Boolean.TRUE.equals(g.getOutput().getMetadata().get("isThought")))
    .map(g -> g.getOutput().getText())
    .toList();
String reasoning = ((DeepSeekAssistantMessage) response.getResult().getOutput())
    .getReasoningContent();                                          // DeepSeek

// 2.1: one accessor for every chat model
List<String> thoughts = response.getResult().getOutput().getReasoning().stream()
    .map(ReasoningPart::text)
    .toList();
String answer = response.getResult().getOutput().getText();          // unchanged
升级说明列出了每个聊天模型的其余变更。在流式传输时,每个部分都会标记其内容块索引和 partial 标志,并由 MessageAggregator 合并增量。聚合后的消息与阻塞调用返回的消息相等,包括签名。
消息部分如何使 Responses API 成为可能
Spring AI 实现了两个 OpenAI 聊天模型端点。OpenAiChatModel 使用 Chat Completions,这是 OpenAI 最初的聊天 API,许多其他服务器也实现了它。OpenAiResponsesChatModel 是 2.1 新增的,使用 Responses API,这是 OpenAI 面向推理模型和智能体的较新 API,采用其无状态模式。
Responses API 不返回消息。每次调用返回一个由 items 组成的 output 数组:reasoning、function_call 和 message,以及 OpenAI 自身运行的工具(如 web search)对应的 items。每个 reasoning item 都带有自己的 id 和 encrypted_content。
OpenAiResponsesChatModel 在设计上是无状态的:它不会在 OpenAI 侧保留对话,而是在每次调用时回放全部内容,因此 memory、advisors 和 RAG(检索增强生成) 的工作方式与 OpenAiChatModel 完全相同。对于推理模型,只有当回放包含模型先前的推理内容时,回放才能良好工作。OpenAI 的推理指南要求包含自最后一条用户消息以来的 reasoning items、function calls 和 function call outputs。
在 2.1 之前,AssistantMessage 无法忠实持有这些 items:
- 它无法表达“先推理,再函数调用,再消息”。
- 它无法将数据附加到单个 item。每个 reasoning item 都有一个 id,并以加密形式(encrypted_content)携带模型的推理内容,两者都必须随该 item 一起发回。而一条消息对整个响应只有一个 metadata map。
- 它没有地方保存 OpenAI 自身运行的工具(如 web search)的 items,除非将它们伪装成本地工具调用。
使用 parts 时,映射是一对一的,并保持输出数组的顺序:
| Responses API 条目 | 消息 part |
| --- | --- |
| reasoning | ReasoningPart,包含摘要、OpaquePayload("openai.responses", "encrypted_content", …) 和条目 id |
| function_call | ToolCallPart,包含条目 id |
| message | TextPart |
| image_generation_call | MediaPart |
| web search、file search、code interpreter、MCP、任何其他条目 | UnknownPart,包含原始 JSON |
在下一次请求中,聊天模型会按相同顺序从 parts 重建输入条目。这种重放是值得的。OpenAI 现已归档的关于推理模型更佳性能的 cookbook 报告称,包含推理条目“带来了约 3% 的提升”(在 SWE-bench 上)。Responses 也是当前 OpenAI 模型上智能体的端点。从 GPT-5.4 开始,Chat Completions 不支持推理力度不为 none 的工具调用。
每个聊天模型获得什么
其他每个聊天模型都遵循相同的模式:将每个响应块映射到一个 part,按顺序从 parts 重建请求,并且只重放自己的 payload。这能带来什么取决于每个提供商的要求:
| 聊天模型 | 现在重放的内容 | 改进 |
| --- | --- | --- |
| Anthropic | 按块顺序的签名和脱敏思考;服务器工具块 | Claude 接受的工具轮次、推理连续性、缓存命中 |
| Google GenAI | 每个 thought signature 附加在承载它的 part 上 | Gemini 3+ 函数调用无错误,其他 part 保持完整推理质量 |
| OpenAI Chat Completions | reasoning_content | 在 vLLM、gpt-oss、Kimi 和其他兼容服务器上的连续性 |
| Ollama | thinking 字段 | gpt-oss 和 qwen3 工具循环中的连续性 |
| Bedrock Converse | 签名、脱敏和未签名推理,流式时也是如此 | 带扩展思考的流式工具循环可正常工作 |
| DeepSeek | 流式和恢复消息的 reasoning_content | 带工具的思考模式无错误 |
| Mistral AI | 按块顺序的思考块 | Mistral 表示没有它们会丢失的输出质量 |
Anthropic
在工具使用轮次中,Claude 要求返回其思考块,并且你“不能重新排列、编辑或部分丢弃它们”:修改过的块会被拒绝并返回 HTTP 400。在 2.1 之前,Spring AI 会按文本、思考、工具使用的顺序重建轮次,无论 Claude 使用的是什么顺序。它还会丢弃服务器工具块,并且流式思考从未完全到达聚合消息。现在每个块都是一个 part,按顺序连同其签名一起重放。Anthropic 还提到另外两个好处:保留思考“让 Claude 从上次中断的地方继续推理”,保留思考块“在工具使用期间启用缓存命中”。Claude Opus 4.5 及更高版本,以及 Sonnet 4.6 及更高版本,还会在上下文中保留更早轮次的思考,这就是 Session memory 的用武之地。
Google GenAI
Google 的 thought signatures 指南要求将每个签名“返回到接收它的确切 part 中”。在 Gemini 3 及更高版本上,函数调用缺少签名会导致请求“以 400 错误失败”。在其他 part 上,“性能可能会下降”。Spring AI 之前将所有签名收集到一个列表中,并按位置重新附加到函数调用。它还会从工具循环中丢弃函数调用之前的思考和文本。现在每个签名都随其自己的 part 传递,代码执行和服务器端工具 part 按接收时的原样发回。
OpenAI Chat Completions
OpenAI 自己的 Chat Completions API 不返回推理文本,因此 OpenAI 推理模型应使用 Responses。OpenAiChatModel 服务于确实返回 reasoning_content 的兼容服务器,例如 vLLM、gpt-oss 部署和 Kimi。OpenAI 的 harmony 指南要求你在工具调用期间传回 gpt-oss 的思维链。这种重放在 2.0.x 中已经通过元数据键存在。现在它承载在 parts 上,因此可以在持久化后保留。由其他提供商签名的推理永远不会被转发,对于拒绝该字段的服务器,可以使用 replayReasoningContent(false)。
Ollama
在 2.1 之前,thinking 仅存在于响应元数据中,且从未被回传。在流式传输时,只有其最后一段片段得以保留。现在,它会在 assistant 消息的 thinking 字段中重放,正如 Ollama 的工具调用文档所要求的那样:“在后续请求中将这些字段与任何工具结果一起返回”。收益取决于模型。gpt-oss 和 qwen3 模板使用当前工具循环的推理。
Bedrock Converse
Bedrock 应用 Claude 规则:“在工具使用期间,你必须将 thinking 块传回 API 以用于最后一条 assistant 消息”。BedrockProxyChatModel 此前会丢弃流式响应中的推理内容。现在,响应是按块顺序排列的单一生成部分,流式传输携带推理内容、签名和经过脱敏的推理内容,来自 gpt-oss 的未签名推理内容也会被重放。
DeepSeek
在 thinking 模式下,携带工具的请求必须回传先前 assistant 消息的 reasoning_content,否则 API 会返回 400。在 2.1 之前,Spring AI 仅对 DeepSeekAssistantMessage 实例发送该内容,因此流式响应和从内存恢复的消息在发送时都不包含它。现在,任何 assistant 消息都会重放其 ReasoningPart,无论是否流式传输,并且 DeepSeekAssistantMessage 已被弃用。
Mistral AI
Mistral 的推理文档指出:“始终重放完整的 assistant 消息(包括 ThinkChunk)”。他们警告说,丢弃推理轨迹会“降低模型性能”。在 2.1 之前,MistralAiChatModel 从不回传 thinking。现在,thinking、文本、引用和图像块都会成为部分,并按块顺序重放,包括在工具循环的各轮之间。
保留部分的记忆:Spring AI Session
在一次 ChatClient 调用内重放只是故事的一半。在调用之间,历史记录存在于聊天记忆中,而在 ChatMemory 仓库中,只有内存中的仓库会保留这些部分。使用其他任何仓库时,模型在每次恢复的轮次中都会从头开始推理。
Spring AI Session 现已作为 Spring AI 2.1 的一部分,填补了这一空白。会话是一个仅追加的事件日志。每条消息都存储为其完整的部分列表,包括负载和属性,JDBC 存储将它们保存为 JSON。JdbcChatMemoryRepository 是 ChatMemory 背后的 JDBC 存储,它仅保留文本,并完全丢弃工具调用和工具结果。对于推理模型,还有两个属性很重要:
- 每一轮工具都会被记录。SessionMemoryAdvisor 在工具调用循环内运行,因此它会存储每一轮的工具调用和结果,而不仅仅是最终答案。每一轮的提示都会从会话重建,因此签名会通过存储完成往返。
- 压缩尊重轮次。当历史记录被裁剪或摘要时,切割点总是落在轮次边界上。工具调用永远不会丢失其结果,其前面的推理内容也会随之保留。
添加 spring-ai-starter-model-session-jdbc starter,注册会话 advisor,并在每次调用时传入会话 id:
@Bean
ChatClient chatClient(ChatClient.Builder builder, SessionService sessionService) {
    return builder
        .defaultAdvisors(SessionAdvisors.builder(sessionService)
            .compaction(new TurnCountTrigger(20),
                    WindowCompactionStrategy.builder().lastTurns(10).build())
            .build())
        .build();
}

String answer = chatClient.prompt()
    .user("Find the cheapest flight to Lisbon next Friday")
    .advisors(SessionAdvisors.session("session-42"))
    .call()
    .content();
完成这些配置后,上述收益即可跨调用和重启保持。Claude 仍能看到其先前的思考内容,Gemini 能在正确的部分取回各自的签名,DeepSeek 的思考模式规则在重新部署后依然生效。ChatMemory 及其 repository 在 2.1 中已弃用,并将在 3.0.0 中移除。迁移指南提供了将一个 API 映射到另一个 API 的方法。
⚠️ 注意事项 每个响应只生成一个 Generation。在 2.1 之前,Anthropic、Google GenAI 和 Bedrock Converse 会将一个响应拆分为分别对应思考、工具调用和文本的多个 Generation。现在它们为每个候选返回一个 Generation。使用 getResult().getOutput().getReasoning() 读取推理内容。2.1 之前存储的历史记录不包含推理部分。早期版本写入聊天记忆的消息在返回时不带推理内容,因此不会被重放。跨提供商历史是安全的,但并非无损。由一个提供商签名的推理内容绝不会发送给另一个提供商。在对话中途切换模型时,文本和工具调用会保留,但另一家厂商的推理内容不会保留。保留 part 属性。Mistral 以及 Bedrock 对未签名推理,仅当 part 的 provider 属性指明它们时才重放推理。如果你自行存储历史记录,不要剥离属性。
结论
消息 part 将 Spring AI 消息从带附件的字符串转变为对模型所生成内容及其顺序的忠实记录。关键要点如下:
- 顺序是数据的一部分。推理模型会检查你回传内容的顺序和完整性。带附属列表的字符串两者都无法承载。
- 原样重放你收到的内容。OpaquePayload 让每个聊天模型原样返回自己的签名,并跳过其他模型的签名。
- 持久化 part,而非文本。会话记忆存储每一轮工具调用的每个 part,因此推理内容可跨调用和重启保留。
资源
- Message Parts 和 Upgrading to 2.1.0,含各提供商的变更
- OpenAI Responses
- Session memory 和 Migrating to Session Memory
相关 Spring AI 文章
- Spring AI Agentic Patterns (Part 7): Session API
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Spring Blog
原创地址:https://spring.io/blog/2026/10/28/spring-ai-message-parts-reasoning-replay
原文作者:Spring Blog;如有侵权,请联系管理员删除。

最新文章
- InfoComm China 视听链接会再次走进上海,直击CIO视角下的AV+AI“规模化落地”
- 北京InfoComm China迈向20周年:领航产业, 打造全年常态化专业视听商贸服务平台
- 智能体作为“数字员工”如何落地,这篇文章帮你破局
- CDIE2026 圆满收官 以AI生产力落地书写数字化转型新答卷
- 倒计时12天!CDIE2026数字化创新博览会上海启幕!共赴AI生产力变革盛会
- 倒计时32天!CDIE2026“将AI,转化为生产力”峰会启幕在即!
- 开源云原生数据库PolarDB PostgreSQL 15兼容版本正式发布
- 去哪儿秒级监控预警落地实践
- 从打点平台谈打点治理
- 这 10 种架构师,不合格!
