基于AWS HealthOmics和Amazon Bedrock AgentCore的智能体抗菌药物耐药性监测 | Amazon Web Services
使用 AWS HealthOmics 和 Amazon Bedrock AgentCore 的智能体抗菌药物耐药性监测
将公共测序数据转化为关于耐药基因的通俗语言答案,无需编写生物信息学代码或 SQL。
细菌抗菌药物耐药性(AMR)是当今最重大的公共卫生威胁之一。发表在《柳叶刀》上的一项系统性分析估计,2019 年 AMR 直接导致 127 万人死亡,并与 495 万人死亡相关(Murray 等,2022)。监测项目通过追踪哪些耐药基因在传播、存在于哪些生物体中以及情况如何随时间变化,来努力减缓这一趋势。
这项工作的原材料已经是公开的。诸如 NCBI Sequence Read Archive(SRA)等测序档案库保存着数十万份细菌全基因组测序运行数据,这些数据在 AWS 上的开放数据注册表中也有镜像。制约因素不在于数据的获取,而在于将原始测序运行转化为答案的工作。这条路径通常意味着组装基因组、使用专业工具筛查耐药基因、将结果加载到分析存储中,并编写 SQL 来探索它们。每一步都需要生物信息学技能,因此提出流行病学问题的人往往依赖专家来回答这些问题。
在本文中,我们提出了一种缩短这条路径的参考架构。研究人员登录 Web 应用程序,提交一个公共 SRA 登录号,在流水线完成后用通俗语言提问:“在沙门氏菌中发现了哪些 AMR 基因?”系统会回答检测到的基因、发现每个基因的工具,以及从数据中获取的置信度值。该架构完全使用 AWS Cloud Development Kit(AWS CDK)定义,并可通过一条命令部署到账户中。这是一个演示架构而非临床系统,随附的代码可供您部署和调整。
此架构与变异解读有何不同
此前的一篇 AWS 文章《使用 AWS HealthOmics 和 Amazon Bedrock AgentCore 加速基因组变异解读》建立了一种模式,本解决方案与之相同:基因组流水线将数据以 Apache Iceberg 格式馈送到 Amazon S3 Tables(Amazon Simple Storage Service(Amazon S3)的一项功能),Amazon Athena 查询这些表,Amazon Bedrock AgentCore 上的 Strands 智能体将问题转化为 SQL。我们复用这种查询模式,而不是重新发明它。不同之处在于基因组学问题及其周围的流水线形态。
变异解读解决方案从 Variant Call Format(VCF)文件开始,其中变异已经被调用,然后对其进行注释。本解决方案从更早的一步开始,从原始测序读段出发,在结果可供存储之前执行读段质量控制、从头组装和基因检测。它增加了一个摄取阶段,直接从公共档案库拉取读段,并在多次运行之间去重,同时将检测输出幂等地合并到 Iceberg 中,以便重新处理某个分离株时能就地更新其行。这些差异——公共数据摄取、基于组装的检测和幂等存储——正是本架构工程工作的核心所在。
解决方案概述
该解决方案由一组松耦合的阶段组成,数据从摄取经过处理和存储单向流向对话式查询层。以下阶段对应图 2 中编号的区域。
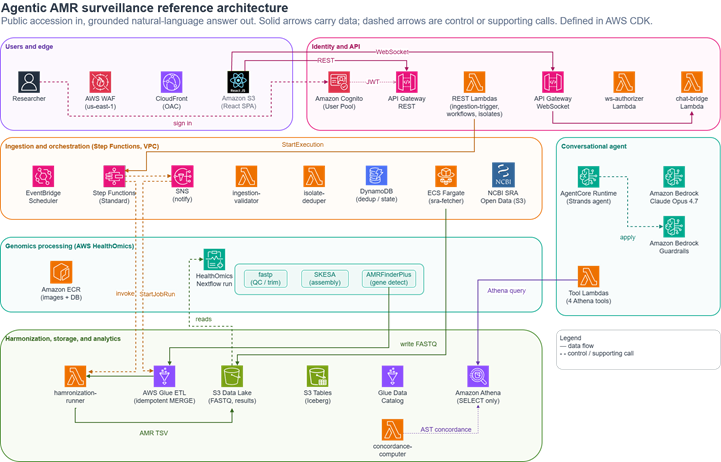
图 2:解决方案架构,按数据经过的五个阶段组织
数据摄取:Amazon EventBridge Scheduler 规则或按需 REST 调用启动 AWS Step Functions 工作流。AWS Fargate 上的 Amazon Elastic Container Service (Amazon ECS) 任务从开放数据注册表(Registry of Open Data)中的 NCBI SRA 镜像获取并转换所请求登录号的测序运行数据,Amazon DynamoDB 记录已处理的分离株,以便重复运行跳过已完成的工作。
基因组学处理:AWS HealthOmics 运行单个托管 Nextflow 工作流,将使用 fastp 的读段质量控制、使用 SKESA 的从头组装以及使用 AMRFinderPlus 的耐药基因检测串联起来。容器镜像来自 Amazon Elastic Container Registry (Amazon ECR),AMRFinderPlus 参考数据库内置于镜像中,因为 HealthOmics 任务在没有互联网访问的情况下运行。
协调与存储:AWS Lambda 函数将检测输出规范化为社区 hAMRonization 模式(PHA4GE 用于报告 AMR 检测结果的标准),AWS Glue 作业将其合并到 Amazon S3 Tables 上的 Iceberg 表中。合并是幂等的,因此重新运行某个分离株会更新行而不是重复它们。
分析存储:Amazon Athena 通过 AWS Glue Data Catalog 查询 Iceberg 表,这为智能体提供了对协调结果的快速 SQL 接口。
对话式智能体与 Web 应用程序:托管在 AgentCore 运行时上的 Strands 智能体通过一组由 Athena 支持的工具回答问题,Amazon Bedrock Guardrails 确保响应有据可依。Amazon S3 和 Amazon CloudFront 上的 React 单页应用程序,受 AWS WAF 保护并使用 Amazon Cognito 进行身份验证,是前端入口。Amazon API(应用程序编程接口) Gateway 提供 REST 调用并通过 WebSocket 流式传输聊天。
摄取公共测序数据
数据摄取只有一个任务:给定一个登录号,将读段获取到账户中,无需手动下载或凭据。由于 SRA 镜像是开放数据注册表的一部分,匿名 Amazon S3 读取就足够了。Step Functions 工作流驱动该过程。它启动一个 Fargate 任务,从公共存储桶下载该登录号的测序运行数据,并将其转换为暂存存储桶中的双端 FASTQ,然后移交给基因组学阶段。
两个设计选择使该阶段保持可预测。DynamoDB 表记录每个已处理的分离株,因此每周定时运行或重复的手动提交不会重新处理相同的登录号。Fargate 将复制作为长时间运行的任务执行,因为获取和转换大型测序运行数据可能需要远超几分钟的时间。结果是一个按计划或从 Web 应用程序按需运行的循环,中间无需操作员。
使用 AWS HealthOmics 检测耐药基因
将读段转换为耐药基因列表是流水线中计算密集的部分。AWS HealthOmics 运行 Nextflow 工作流,无需预置或扩展集群,这适合没有自己运行生物信息学系统的团队。
该工作流是单个 HealthOmics 运行,包含三个由 Nextflow 通道连接的任务。fastp 从原始读段中修剪接头和低质量碱基。SKESA 将修剪后的读段组装成重叠群。AMRFinderPlus 筛选这些重叠群以寻找已知耐药基因。将组装和筛选合并到一次运行中,避免了两次独立运行之间脆弱的交接,并与社区 AMR 流水线的结构相匹配。
在 HealthOmics 上运行第三方生物信息学工具需要一些值得明确说明的调整:
HealthOmics 任务没有互联网访问,因此 AMRFinderPlus 数据库被烘焙到容器镜像中,而不是在运行时下载。
容器镜像 URI 作为工作流参数传递,而不是硬编码,这使工作流独立于账户和 AWS 区域,并允许 HealthOmics 在运行开始前验证镜像访问权限。
任务输出发布到 HealthOmics 导出到 Amazon S3 的运行输出路径,而不是任意位置。
每个容器镜像都基于官方工具发布版本构建,并固定版本,使用 Amazon ECR 镜像扫描进行扫描,因此流水线不依赖于浮动的 latest 标签。
协调与存储结果
AMRFinderPlus 为每个分离株输出一个制表符分隔的文件,这在跨多个样本分析时很不方便。Lambda 函数首先将该输出规范化为 hAMRonization 模式。然后 AWS Glue 作业将协调后的数据重塑为 Amazon S3 Tables 上的两个 Iceberg 表:amr_profiles,每个检测到的基因一行;isolate_metadata,每个分离株一行,携带其来源和许可证信息。
AWS Glue 作业以 isolate 和 gene 为键执行 MERGE 写入,因此对同一 isolate 处理两次会更新现有行,而不是追加重复数据。这种幂等性对监测至关重要,因为同一 accession 可能通过计划运行再次到达,并且它无需单独的去重步骤即可保持表的一致性。将结果存储为 Iceberg 为智能体提供了一个列式、事务性的查询界面,具有低延迟,并且由于 Amazon S3 Tables 在 AWS Glue Data Catalog 中注册了 schema,Athena 无需额外设置即可读取相同的表。将每个样本的文件转换为结构化存储,正是使跨整个语料库的对话式查询成为可能的关键。
用自然语言提问
对话层使用 Strands Agents SDK,并运行在 Amazon Bedrock AgentCore 上,这是一个用于大规模构建、连接和优化智能体的平台,支持任何框架或模型。此解决方案使用 AgentCore runtime,即其无服务器智能体托管环境。它为每个用户会话提供隔离环境,与 AWS Identity and Access Management (IAM) 集成,并追踪智能体的推理和工具调用。团队无需管理服务器或扩展逻辑即可运行智能体。
智能体基于四个工具进行推理,每个工具都将自然语言请求转换为针对 Iceberg 表的有针对性 Athena 查询:
query_amr_profiles 查找某个生物体在可选日期范围内的耐药基因。
get_resistance_trends 汇总基因检测结果逐月的趋势。
compare_isolates 比较不同 isolate 之间的耐药谱。
lookup_gene_info 返回特定耐药基因的详细信息。
接地在两个地方强制执行。系统提示要求智能体为每个声明引用基因 ID、检测工具和置信度值。它还必须在没有数据支持答案时明确说明,而不是猜测。Amazon Bedrock Guardrails 增加了第二层保护,通过上下文接地检查和拒绝主题,使响应与返回的行保持一致,并避免涉及医疗或患者建议。智能体使用 Amazon Bedrock 上的 Anthropic Claude Opus 4.7,通过跨区域推理配置文件调用,用于这些规则所依赖的推理和综合。模型可用性因 AWS 区域而异。请参阅 Amazon Bedrock 按区域划分的模型支持文档以了解当前可用性。
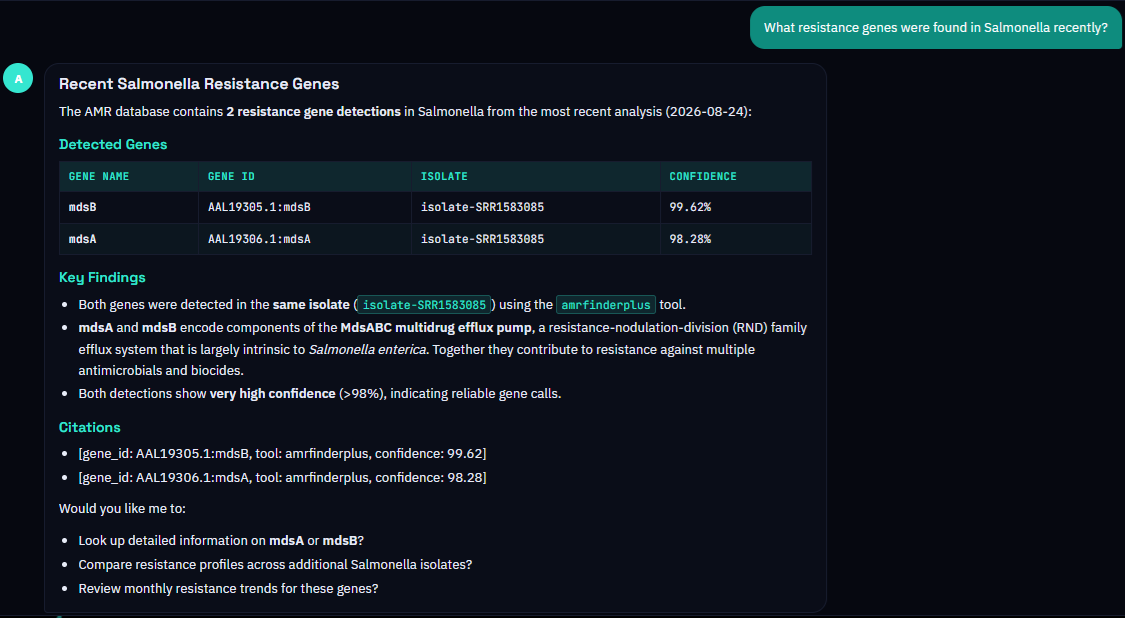
在 isolate 被处理后,研究人员通过对话而非 SQL 来探索它。当被问及“在 Salmonella 中发现了哪些 AMR 基因?”时,智能体调用 query_amr_profiles,通过 Athena 从 Iceberg 中检索匹配的行,并回复检测到的基因。每个基因都标注了检测工具及其置信度值,以及对基因所代表含义的简短解读。诸如“告诉我更多关于 mdsB 的信息”之类的后续问题会触发 lookup_gene_info,而用户无需考虑表或查询。
优势
该架构将四个反复出现的痛点转化为可管理、可重复的步骤。
| 挑战 | 架构如何应对 |
| --- | --- |
| 手动获取和组装公共测序数据 | Step Functions 工作流从 AWS Open Data SRA 镜像拉取 reads,并在托管的 HealthOmics 计算上运行组装和筛查。 |
| 协调多个样本的检测输出 | Lambda 函数统一结果,AWS Glue 将其幂等地合并到 Amazon S3 Tables 上的 Iceberg 表中。 |
| 提问需要 SQL 和生物信息学技能 | AgentCore 上的 Strands 智能体将通俗语言问题转换为 Athena 查询,并附上引用的证据作答。 |
| 在另一个账户中复现环境 | 该解决方案在 AWS CDK 中定义,没有硬编码标识符,因此只需一条命令即可部署。 |
由于这是参考架构而非客户部署,其证明在于任何人都可以搭建它。CDK 应用程序配置了此处描述的每个组件,从摄取工作流到 Iceberg 表,再到智能体运行时和 Web 前端。它不需要硬编码的账户标识符或手动设置步骤。运行成本取决于您处理多少 isolate 以及频率,因为 HealthOmics 运行、AWS Glue 作业和智能体调用按使用量计费。该架构在空闲时保持低成本。
结论
将用于托管基因组学处理的 AWS HealthOmics 与用于有依据解读的 Amazon Bedrock AgentCore 配对,使监测团队能够在一个连续流程中从公共登录号直接获得关于耐药基因的答案。组装、基因检测、协调和存储无需手动步骤即可完成,分析层通过对话而非查询控制台即可访问。该模式复用了先前工作中的 S3 Tables 和智能体查询方法,并将其应用于不同的基因组学问题。该问题始于原始读段,并依赖于公共数据摄取和幂等存储。
如需深入了解,请参阅 AWS HealthOmics 和 Amazon Bedrock AgentCore 产品页面,以及相关文章 Accelerating genomics variant interpretation with AWS HealthOmics and Amazon Bedrock AgentCore 。
该解决方案完全在 AWS CDK 中定义,并部署到您自己的账户中。请探索 GitHub 上的配套仓库,并将该模式适配到您自己的监测和生命科学用例中。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Nicolo Cosimo Albanese;如有侵权,请联系管理员删除。

