在 Amazon Bedrock 上使用 Grok 4.7 构建长时程智能体 | Amazon Web Services
在 Amazon Bedrock 上使用 Grok 4.7 构建长时程智能体
SpaceXAI 的 Grok 4.7 现已在 Amazon Bedrock 上可用,该平台提供来自多个提供商的基础模型(FM)供选择。据 SpaceXAI 称,Grok 4.7 经过训练,能够在更困难的任务上工作更长时间,并且知道何时检查自己的工作。这对智能体来说最为重要,因为智能体需要将任务贯穿多个步骤,并且必须验证沿途发现的内容。
以这种方式工作的智能体不能只是查找信息。它必须形成一个候选答案,将其与已学到的内容进行核对,并不断改进直到答案合适。Grok 4.7 提供了一个推理力度(reasoning effort)设置,用于控制每次响应前进行多少思考,而对于智能体工作负载,一个实际问题是应该运行在哪个级别。
在本文中,我们在 Grok 4.7 上构建了一个工具调用智能体,并在三个需要搜索而非查找的任务上对其进行评估。这些任务分别是:根据告警诊断双服务故障、在相互作用的约束下安排维护,以及在预算内选择最优的迁移集合。每个任务都恰好有一个正确答案,并通过暴力法验证。我们在每个推理力度级别上运行了全部三个任务,每个任务运行六次,共 72 次智能体运行。
智能体在 72 次运行中正确回答了 67 次。在 xhigh 级别下,它正确回答了全部 18 次;在 low 级别下,它正确回答了 18 次中的 15 次,同时使用的输出 token 约为八分之一。这提供了一个清晰的权衡,你可以根据每个请求进行调整,我们还将展示如何在你自己的任务上衡量它,以及如何在生产环境中监控它。
我们在全文中报告 token 数量而非货币金额。Token 价格会变化,而数量是你自身成本的计算基础,因此以 token 表示的测量结果始终有效。
SpaceXAI 对 Grok 4.7 的报告
据 SpaceXAI 称,Grok 4.7 使用了比 Grok 4.6 更大的基础模型,并在更困难的任务组合上进行了更长时间的强化学习训练。该任务组合偏向于需要数小时才能完成的问题。SpaceXAI 报告称,该模型更擅长验证自己的工作以及管理更长的上下文。
SpaceXAI 发布的基准测试结果也体现了这一重点。相比 Grok 4.6 的最大报告提升出现在衡量持续工作而非单轮回答的类别中。
| 基准测试 | 类别 | Grok 4.6 | Grok 4.7 |
| --- | --- | --- | --- |
| Terminal-Bench 4.0 | 多小时终端工作 | 20.3% | 37.6% |
| EEBench | 电气工程 | 53.0% | 64.0% |
| Harvey Legal Agent(智能体) Benchmark | 法律工作 | 15.8% | 19.6% |
| CursorBench 4.0 | 长时间运行的编码 | 40.4% | 46.3% |
| HealthBench Professional | 临床推理 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 多小时办公工作 | 1,546 | 1,657 |
来源:SpaceXAI,Introducing Grok 4.7( https://x.ai/news/grok-4-7 )。分数为 SpaceXAI 在模型发布时发布的数据。
基准测试展示了模型在标准任务上的表现。对于你自己的负载,有用的下一步是在与你类似的任务上进行测量,这正是本文后续内容将要介绍的。
SpaceXAI 列出 Grok 4.7 具有 500K token 上下文窗口,支持文本和图像输入以及文本输出。在 Amazon Bedrock 上,该模型支持可配置的推理强度、工具调用和结构化输出。
如何在 Amazon Bedrock 上访问 Grok 4.7
Grok 4.7 运行在 bedrock-runtime 端点上,并通过跨区域推理配置文件进行访问。有两个配置文件可用:
| 推理配置文件 | 路由 | 适用场景 |
| --- | --- | --- |
| us.xai.grok-4.7 | 美国地理范围内 | 你有美国数据驻留要求 |
| global.xai.grok-4.7 | 商业 AWS 区域 | 你没有驻留限制,并希望获得最广泛的容量 |
跨区域推理会在多个 AWS 区域之间路由请求,从而为你提供更高的吞吐量,而无需逐个区域管理容量。请求需指定其中一个推理配置文件,而不是裸模型 ID。
该模型支持 OpenAI 兼容的 Chat Completions 和 Responses API(应用程序编程接口),以及 Amazon Bedrock Converse API。在 Converse 上,推理会作为 reasoningContent 块与文本块一起返回。在 inferenceConfig 中,仅设置 maxTokens,并将模型特定参数(例如推理强度)放入 additionalModelRequestFields。
有关受支持区域、服务层级和 token 价格的当前列表,请参阅 Amazon Bedrock 用户指南中的 Grok 4.7 模型卡以及 Amazon Bedrock 定价页面( https://aws.amazon.com/bedrock/pricing/ )。
先决条件
一个可访问 Amazon Bedrock 的 AWS 账户,并且已为 Grok 4.7 启用模型访问权限。
Python 3.9 或更高版本,并安装 openai、boto3 和 aws-bedrock-token-generator。
已在你的环境中配置 AWS 凭证。
你的 AWS Identity and Access Management (IAM) 身份需要在推理配置文件和你账户的默认项目上具有 bedrock:InvokeModel 权限:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7 或 global. 对应项。
arn:aws:bedrock:{region}:{account-id}:project/default 。
在策略声明中同时包含这两个资源。除了推理配置文件外,还需要默认项目权限。
连接到模型
对于生产环境使用,我们建议从现有的 AWS 凭证生成短期 bearer token,这样身份验证始终与您的 IAM 身份绑定,不会存储长期有效的密钥:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
推理 token 计入输出 token,并在生成答案文本之前消耗 max_completion_tokens,因此设置限制时要为两者都留出空间。如果在推理过程中达到限制,响应将不包含答案文本返回,因此在智能体代码中检查空内容,如果发现则提高限制。我们的运行使用了 32,768 个 token 的限制,在每个 effort 级别都留有裕量。
Grok 4.7 支持四个 effort 级别:low、medium、high 和 xhigh。Effort 级别可能随模型版本变化,因此值得向服务确认,而不是硬编码列表:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
设计需要推理的任务
许多智能体评估测试的是勤勉程度:读取一条记录、过滤它、把它加起来。这些任务值得保留,但要看出推理 effort 的贡献,任务必须要求搜索:答案不能直接从数据中读出,必须提出假设然后验证。
我们构建了一个包含 20 个服务的合成环境,通过七个工具暴露,并在其上设计了三个任务。每个任务恰好有一个正确答案,且每个任务的设计都使得快速启发式方法不足以找到答案。
| 任务 | 智能体需要做什么 | 为什么这是推理任务 |
| --- | --- | --- |
| two_fault_diagnosis | 两个服务在 03:00 静默失败,另外 12 个服务触发了告警。找出失败的两个服务 | 失败的服务不触发告警,因此答案不在告警服务之中。190 种可能的配对,只有一种能精确解释观察到的告警 |
| maintenance_schedule | 在四个晚上为八个服务打补丁,每晚两个,受十个约束和一条规则限制:同一团队的两个服务不能在同一晚 | 2,520 种可能的排期,只有一种有效。团队规则依赖于智能体必须查找的数据 |
| migration_budget | 在预算内选择迁移候选者以最大化风险降低,包括传递性前置条件 | 53 个可行集合,只有一个最优。优先选择最佳比率会得到一个比最优解低九分的集合 |
四项实践使这样的测量值得信赖,它们适用于大多数智能体评估。
明确说明评分器依赖的每一条规则。如果提示词留下了未定义的边缘情况,一个合理的答案可能被判定为错误,评估最终测量的是规范而不是模型。例如,诊断提示词明确说明失败的服务不会触发自身的告警。
证明每个任务只有一个答案。每个环境都小到可以枚举,因此我们在运行任何内容之前检查了每一个候选答案。对于排期任务,这只需要几行代码:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
对必需的最终行进行评分,而不是对整个响应评分。每个提示都要求智能体以一行内容结尾,例如 FINAL: auth, checkout 。评分器只读取该行,因此,即使某个响应在解释推理过程时讨论了其他候选方案,也仅根据其结论进行评分:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
将格式与正确性分开跟踪。缺少最终行与最终行不正确是两种不同的信号。在我们的运行中,全部 72 个响应都包含可评分的最终行。
在有效值已知的情况下,使用枚举约束工具参数,以便每次工具调用都指向真实资源:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
系统提示被有意设计得很短,并要求智能体在给出答案前先检查答案:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
智能体循环是标准的工具调用循环:在设置 reasoning_effort 的情况下调用模型,执行每个返回的工具调用,追加以 tool_call_id 为键的结果,并重复此过程,直到模型不再请求工具。在整个循环中跟踪 prompt_tokens 和 completion_tokens,即可得到下一节中报告的 token 计数。
结果
每个任务在每个 effort 级别下运行六次,总共 72 次运行。智能体正确回答了 67 次。
| 任务 | low | medium | high | xhigh |
| --- | --- | --- | --- | --- |
| two_fault_diagnosis | 6 次中 5 次 | 6 次中 6 次 | 6 次中 6 次 | 6 次中 6 次 |
| maintenance_schedule | 6 次中 5 次 | 6 次中 5 次 | 6 次中 5 次 | 6 次中 6 次 |
| migration_budget | 6 次中 5 次 | 6 次中 6 次 | 6 次中 6 次 | 6 次中 6 次 |
| 全部三个任务 | 18 次中 15 次 | 18 次中 17 次 | 18 次中 17 次 | 18 次中 18 次 |
| 每次运行 | low | medium | high | xhigh |
| --- | --- | --- | --- | --- |
| 平均输出 token 数 | 1,184 | 6,430 | 6,778 | 9,147 |
| 输出 token 数相对于 low | 1.0x | 5.4x | 5.7x | 7.7x |
| 平均工具调用次数 | 17.2 | 18.7 | 17.8 | 18.1 |
| 耗时中位数 | 18s | 98s | 89s | 106s |
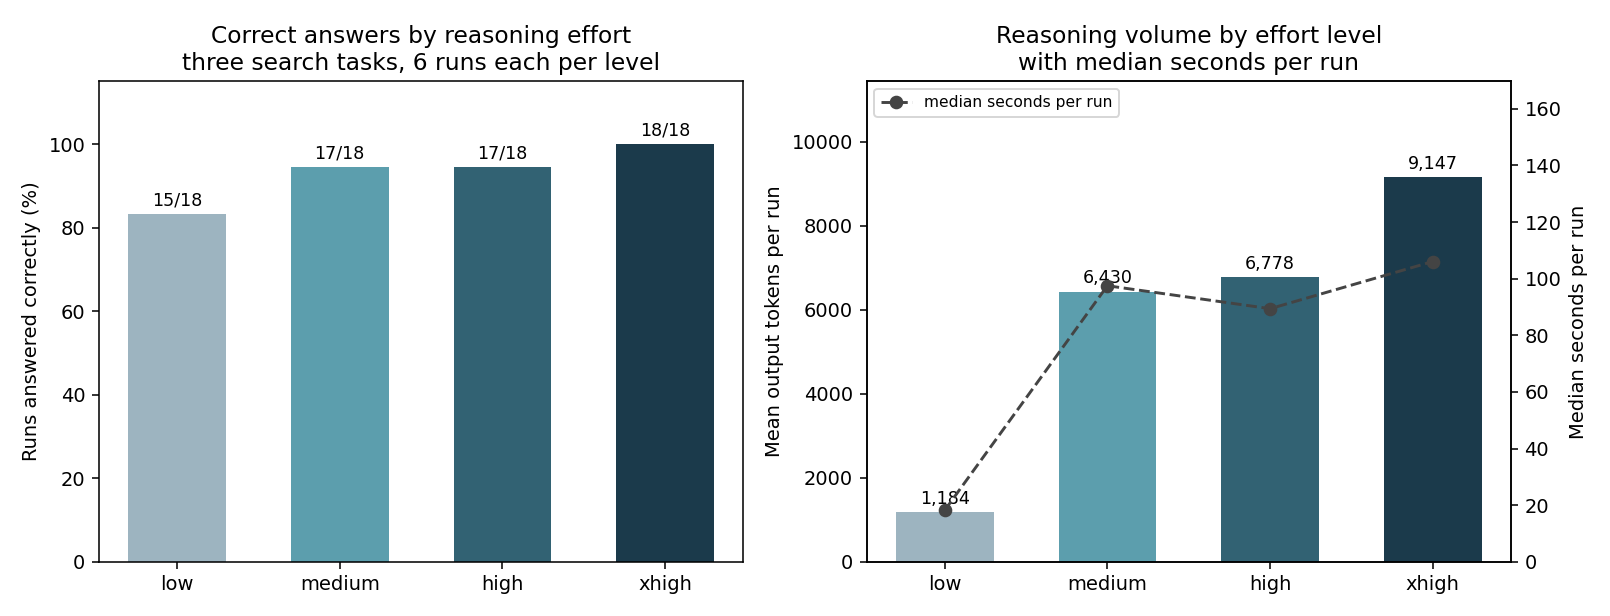
图 1:每个推理 effort 级别下正确回答的运行占比(左),以及每次运行的平均输出 token 数,并叠加每次运行的耗时中位数(右)
xhigh 在每次运行中都正确回答。三个任务在 xhigh 下的全部 18 次运行均正确,而 medium 和 high 各正确回答了 18 次中的 17 次。由于每个任务和每个级别只有六次运行,这些级别之间的差异具有指示性,而非统计上的结论性,但方向在三个任务中是一致的。
Effort 改变的是智能体进行多少推理,而不是它进行多少探索。工具调用基本持平,在每个级别下均为每次运行 17.2 到 18.7 次。无论 effort 如何,智能体收集到的事实相同,变化在于它对事实应用了多少推理,输出 token 数从 low 下的 1,184 上升到 xhigh 下的 9,147。
low 提供了出色的成本质量比。在 low 级别下,智能体在 18 次运行中正确回答了 15 次,使用的输出 token 约为 xhigh 的八分之一,中位运行时间为 18 秒。在稍低的完成率可以接受,或者答案会在下游被审查的场景中,low 是一个高效的选择。在每一个答案都需要一次就正确的场景中,更高级别是更安全的默认选择。
努力程度如何影响答案
这些任务围绕一种特定类型的难度而设计,观察每个努力级别如何处理它们,可以明确额外的推理在何时是值得的。
优化。迁移任务奖励的是考虑组合,而不是一次一个地对选项进行排序。选择具有最佳个体比率的候选者会产生一个合理的答案,但比最优解低九个百分点。在 medium 及以上级别,智能体在所有 18 次运行中都找到了最优集合。
假设检验。诊断任务要求双向检查候选对:每个告警都必须得到解释,每个保持静默的服务都必须与答案一致。在 medium 及以上级别,智能体在所有 18 次运行中都识别出了正确的配对。
约束满足。调度任务将十个列出的约束与一个依赖于查询到的所有权数据的团队规则结合在一起。xhigh 在每次运行中都生成了有效的调度,这也是最高级别产生最明显差异的任务。
这三者呈现出的模式是:当智能体必须权衡多个候选答案,而不是沿着单一路径得出结论时,额外的推理努力最有价值。
在生产环境中监控推理过程
在生产环境中,你没有已知答案可以用来评分,但你知道每次运行使用了多少输出 token 和工具调用。这些为你提供了有用的运营信号。
每个级别下的正确运行都保持在明确的推理量下限之上。在 medium 及以上级别,每次正确运行至少使用了 1,739 个输出 token,典型运行则使用了数千个。一次没有进行任何工具调用,或者产生的输出远低于其级别正常水平的运行,值得标记以供审查:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
根据你已经评分的运行来校准基线,按任务和努力级别分别进行,然后将其应用于尚未评分的运行。将标记视为检查或重新运行的提示。在 low 级别下,每次运行都很简短,输出量是较弱的信号,因此应将其与抽查结合使用。
在系统提示中要求智能体验证其答案是值得保留的,因为这使得你在审查运行时,智能体的推理过程易于跟进。在存在已知答案的情况下,将其与自动评分结合使用,以便质量独立于对话记录进行衡量。
选择推理强度
这些结果提示了一些实用规则。
让强度与任务类型相匹配。涉及搜索、优化或验证假设的任务最适合使用 medium 或更高强度。遵循单一路径,或答案会在下游被审查的任务,可以在 low 下高效运行。
按请求设置强度,而不是按智能体设置。强度是一个请求参数,因此智能体可以在更高强度下运行其规划和验证步骤,并在 low 下运行其机械性步骤,例如格式化工具结果。这样可以将更高强度的许多可靠性与更低的 token 成本结合起来。
在你自己的任务上测量,并重复进行。每种配置只运行一次只会得到一个观测结果。将每种配置重复多次可以显示其一致性。
监控推理量。按强度级别跟踪每次运行的输出 token 和工具调用,可以为你提供一个早期信号,以便在结果被使用之前审查该次运行。
此测量的局限性
每个任务和强度级别运行六次。足以在三个任务上显示出一致的方向,但不足以给出置信区间。请将这些级别之间的差异视为指示性的。
合成环境。工具从代码生成的数据中读取,这正是能够证明每个任务恰好只有一个答案并自动评分的原因。真实工具会增加延迟、部分结果和错误,而这些都未在此测试。
以分钟计,而非小时。中位运行时间从 low 下的 18 秒到 xhigh 下的 106 秒不等。这是对长周期工作的缩小版代理。方法可以迁移。绝对数值不能。
一个模型版本、一个区域、每个任务一个提示。同一任务的不同措辞可能会改变结果,这也是为什么明确说明每条规则很重要的一部分原因。
统计的是 token 数量,而不是成本。要转换为货币,请根据 Amazon Bedrock 定价页面中适用于你的推理配置文件和服务层级的当前费率进行计算。Global 和 US Geo 配置文件的定价不同,Flex 和 Priority 服务层级会应用乘数。
智能体工作负载的运维控制
内置重试机制。发起大量调用的智能体应将重试视为设计的一部分。设置请求超时,仅对可重试的错误进行重试,采用带抖动的指数退避,并在返回 Retry-After 标头时遵循该标头:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
按需吞吐量会随时间逐步扩展,因此应以渐进方式提升新的高流量工作负载,而不是一开始就以满速率运行。
审计一次运行。模型调用日志会将请求和响应数据写入 Amazon Simple Storage Service (Amazon S3) 或 Amazon CloudWatch Logs。这让你可以在事后查看想要审查的完整运行记录。
大规模监控推理量。Amazon CloudWatch 指标提供 token 使用量的聚合视图,这正是前面描述的按级别基线可以用于设置告警的地方。
按智能体归因支出。AWS Cost Explorer 和 AWS Cost and Usage Report 中的成本明细可按模型拆分用量,结合每任务 token 计数,你既能获得单位经济性,也能获得总账单。
将成本与紧急程度匹配。服务层级按请求设置,因此一次部署可以将夜间分析通过 Flex 层级发送,并将交互式请求通过 Priority 发送。对于以更高 effort 级别运行的工作负载,层级选择是进一步控制成本的杠杆。
选择路由配置文件。跨区域推理扩大了长时间运行所依赖的容量池。Global 配置文件从你选择的商业 AWS 区域提供服务,且每 token 定价通常低于地理路由。US 配置文件将处理限制在美国境内。请根据你的数据驻留要求以及成本进行选择。
清理
本文中的示例不会创建除按请求 token 用量之外的可计费 AWS 资源。如果你生成了长期 Amazon Bedrock API 密钥,请在完成后于 Amazon Bedrock 控制台中将其删除,因为它在被撤销之前一直有效。由 IAM 凭证生成的短期令牌会自行过期。
如果你在测试期间启用了向 Amazon S3 的模型调用日志,请检查该存储桶并删除不再需要的对象。
结论
SpaceXAI 训练 Grok 4.7 在更困难的任务上投入更长时间,并知道何时检查自己的工作。在三个需要搜索而非查找的任务中,该智能体在 72 次运行中正确回答了 67 次,并且在 xhigh 下每次运行都正确。由于推理努力程度是按请求设置的,你可以选择智能体的每一步在彻底性与 token 成本之间的权衡中处于什么位置。
有三件事值得带入你自己的评估中。设计具有一个可证明答案的任务,并说明评分器所依赖的每条规则。重复运行,这样你就能看到每种配置的一致性如何。并按努力程度监控输出 token 和工具调用,这样你就能在质量测量之外拥有一个运营信号。
延伸阅读
在 Amazon Bedrock 上推出 Grok
Grok 4.7 现已在 Amazon Bedrock 上可用
使用跨区域推理在 AWS 区域之间路由模型推理请求
Amazon Bedrock 入门
Chat Completions API
Amazon Bedrock 定价
推出 Grok 4.7(SpaceXAI)
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Suheel Farooq;如有侵权,请联系管理员删除。

