Spring AI 2.1.0-M1 现已发布
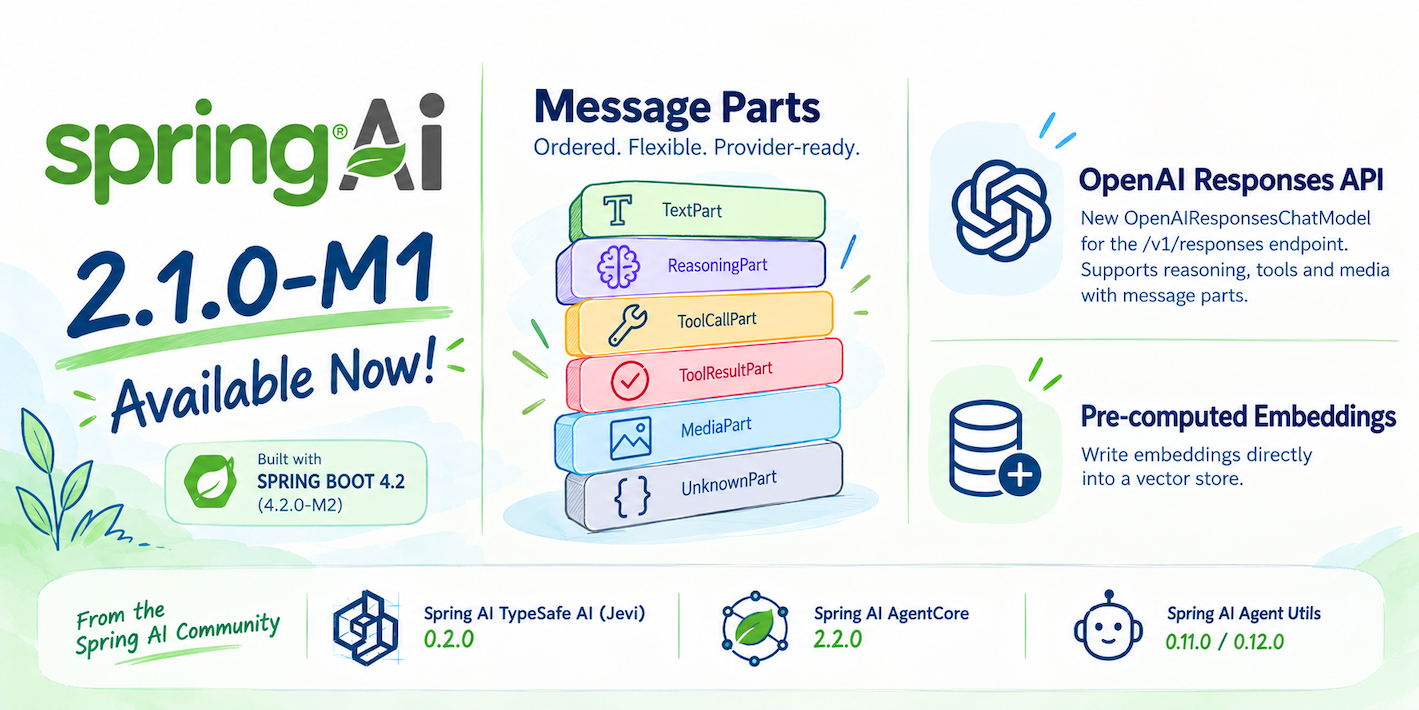
我代表 Spring AI 团队以及所有贡献者,很高兴地宣布 Spring AI 2.1.0-M1 已发布,现可从 Maven Central 获取!
发布说明 | 升级说明 | 参考文档
2.1.0-M1 是 2.1 系列的第一个里程碑版本。它基于 2.0.1 中发布的所有内容构建,将基线迁移至 Spring Boot 4.2(此里程碑版本基于 4.2.0-M2 构建),并引入了三项新能力:对结构化、有序的消息内容模型的初步支持,对 OpenAI Responses API(应用程序编程接口) 的支持,以及将预计算嵌入写入向量存储的方法。
与任何里程碑版本一样,新 API 已可供试用,但在 GA 之前仍可能发生变化。您当前的反馈将塑造它们的最终形态。
本次发布的新特性
在此之前,Spring AI 消息是文本加上工具调用和媒体的附属列表。这种形态无法表示当前模型实际返回的内容:推理与工具调用交错、图像之间的文本,或必须在下一轮原样回传的提供商特定块。
AssistantMessage、UserMessage 和 ToolResponseMessage 现在将其内容保存为有序的 MessagePart 条目列表:TextPart、ReasoningPart、ToolCallPart、ToolResultPart、MediaPart 和 UnknownPart。各部分保持提供商生成它们的顺序,因此对话可以忠实地往返传输。ReasoningPart 或 ToolCallPart 可以携带 OpaquePayload,其中保存了诸如 Anthropic thinking signature 或 Gemini thought signature 等必须原样重放的数据。UnknownPart 保留适配器尚未建模的任何块的原始 JSON,因此不会有任何内容被静默丢弃。
熟悉的访问器(getText()、getMedia()、getToolCalls() 以及新的 getReasoning())现在是对各部分的视图,现有的构造函数和构建器继续按旧有顺序生成它们。要自行控制顺序,可直接添加部分:
UserMessage question = UserMessage.builder()
    .part(TextPart.of("What changed between these two charts?"))
    .part(MediaPart.of(firstChart))
    .part(MediaPart.of(secondChart))
    .build();

AssistantMessage answer = chatModel.call(new Prompt(question)).getResult().getOutput();
for (ReasoningPart reasoning : answer.getReasoning()) {
    System.out.println("Reasoning: " + reasoning.text());
}
System.out.println(answer.getText());
流式模型现在可以增量传递部分内容:块携带带索引的部分部分和响应 ID,MessageAggregator 从中重建完整部分。仅读取 getText() 的订阅者看到的文本增量与之前相同,工具调用仍会被缓冲并作为完整调用一次性传递。请参阅参考文档中的 Message Parts 部分。
这是初步的消息部分支持:只有新的 OpenAiResponsesChatModel 原生生成和消费部分。其他 ChatModel 实现将在 2.1.0-RC1 中重构以使用它们。
OpenAI Responses API
新的 OpenAiResponsesChatModel 与现有的基于 Chat Completions 的 OpenAiChatModel 一起,与 OpenAI 的 /v1/responses 端点通信。使用它的主要原因是正确性:从 GPT-5.4 开始,Chat Completions 不支持工具调用与除 none 以外的推理努力(reasoning effort)组合使用,而 Responses 支持。如果你正在当前 OpenAI 旗舰模型上构建智能体(Agent(智能体)),这就是应该使用的端点。
切换只需一个属性,其余的 spring.ai.openai 连接设置保持不变:
# chat-completions (default) | responses
spring.ai.openai.chat.api=responses
该模型基于消息部分(message parts)构建。Responses 回复中的每一项按顺序成为一个部分,加密的推理内容承载在 ReasoningPart 中,并在工具调用之间原样传递回去,因此模型在工具循环中保持其思维链。OpenAiResponsesChatModel 被有意设计为无状态的:每次调用都发送完整的 Prompt,因此 ChatMemory、advisors 和 RAG(检索增强生成) 的工作方式与 OpenAiChatModel 完全相同。
OpenAiResponsesChatOptions 暴露了推理努力和推理摘要、详细程度(verbosity)、结构化输出以及图像和 PDF 输入。HostedTool 启用了 OpenAI 在其侧运行的工具:网络搜索、文件搜索、代码解释器、远程 MCP 和图像生成。可观测性和自动配置也已包含。OpenAI Responses 参考页面涵盖了配置属性以及何时选择哪个端点。
聊天记忆存储库(Chat memory repositories)目前尚不持久化消息部分,因此只有 InMemoryChatMemoryRepository 能在对话轮次之间保留推理内容。与其他存储库的对话仍然可以工作,但模型在每一轮都会从头开始推理。持久化存储库支持计划在 2.1.0-RC1 中提供。
写入预计算的 Embeddings
VectorStore.add() 始终使用存储库自身的嵌入模型来计算嵌入。有时你已经有了向量:某个提供商的批量 API 在夜间以折扣价计算了它们,另一个团队拥有嵌入管道,一个多模态模型嵌入了图像,或者你正在从同时导出文本和向量的系统迁移。
新的 VectorStore.upsert() 接受一个 EmbeddedDocument,将 Document 与其 float[] 向量配对,并按给定内容存储向量:
float[] embedding = ...; // computed elsewhere
Document document = new Document("8f14e45f-ceea-467a-9a3e-5b1c2d6f7a90", "some text",
        Map.of("source", "manual"));

vectorStore.upsert(List.of(new EmbeddedDocument(document, embedding)));
顾名思义,再次写入相同的 id 会替换该行,因此具有稳定 id 的摄取任务在失败后可以安全地重新运行。每个批次在写入任何内容之前都会根据索引宽度进行检查。pgvector、Redis(内存数据结构存储系统)、Elasticsearch 和 Qdrant 在此里程碑中支持 upsert;其他存储库在加入支持之前会抛出异常。新的 DocumentMetadata.CONTENT_REF 键允许你指向存储在存储库之外的内容,适用于向量来自图像或太大而无法内联的文件的行。参见 Writing User-Supplied Embeddings。
无状态 MCP 服务器现在可以通过 McpStatelessSyncServerCustomizer 和 McpStatelessAsyncServerCustomizer bean 进行调优,与有状态服务器已有的定制器相对应。此前,你必须排除并重新声明整个服务器 bean。
Redis 向量存储自动配置接受作为 bean 贡献的自定义元数据字段。
向量存储过滤器解析器将超出范围的整数字面量解析为 Long,而不是抛出 NumberFormatException。
修复
spring.ai.openai.timeout 和 spring.ai.openai.chat.timeout 再次生效。自 2.0.1 起,每个请求都携带一个 60 秒的每次调用超时,覆盖了配置值,导致超过一分钟的流式回合被中止并抛出 OpenAIIoException: Stream failed。
OpenAI 严格模式工具 schema 在每个对象层级回填 additionalProperties: false。这修复了并非来自 Spring AI 自身生成器的 schema 的严格模式问题,例如 MCP 工具 schema 或手写输入 schema。
携带媒体但不携带文本的 Bedrock 用户消息不再发送空文本块,Converse API 曾以 400 错误拒绝该空文本块。
TextReader 关闭其读取的资源流,而不是每个文档泄漏一个文件描述符。
InMemoryChatMemoryRepository 在保存时复制消息列表,因此调用方列表的后续更改不再改变已存储的对话。
MariaDBVectorStore schema 验证在未配置 schema 名称时正常工作,而不是将已存在的表报告为在 schema null 中缺失。
空的 OpenAI 图像响应被报告为生成失败,而不是无关的异常。
文档、依赖项与构建
MCP 客户端文档新增了关于客户端作用域和会话边界的章节(自动配置的 bean 共享什么,以及需要时如何获得按用户隔离),并完善了关于 MCP 与本地工具名称冲突的指导。OpenAI reasoning effort 属性现已记录在文档中。
Spring AI 现在跟踪 Spring Boot 4.2,Anthropic Java SDK 升级到 2.64.0。构建现在配置为可重现构建,并且假设 Unix 行尾的测试已修复,因此项目可在 Windows 上构建。
贡献者
感谢所有参与此版本工作的人:
@CryoThrust、@JamesBLewis、@Lubaoshuai、@chabinhwang、@chensishang、@dimitarproynov、@dlwldn30、@fatan、@herder、@ilayaperumalg、@jhpark1227、@kezhenxu94、@martin-grofcik、@pengmoubuaixuexi、@sdeleuze、@sobychacko 和 @tzolov
来自 Spring AI 社区
Spring AI TypeSafe Jev 0.2.0 延续了本周推出的使用 TypeSafe Jev 进行快速、结构化决策的功能。模型即评判器(model-as-a-judge)新增了代码标准、类型化输入、条件标准和自优化修复,以及实验性的 JevChatModel。请参阅参考文档。
MCP Security 0.1.14 通过 Origin 头验证、缺少 API 密钥时返回 401 响应以及 CIMD 流程中的颁发者 URL 验证来加固 MCP 服务器。
Spring AI Agent Utils 发布了两个版本。0.11.0 新增 Auto-Dream 记忆整合,支持跨会话回忆。0.12.0 新增可插拔的 ExecBackend,带有用于沙箱化命令执行的 Docker 后端、Workspace 抽象、搜索工具的目录限制,以及用于控制智能体循环的 InterruptAdvisor 和 ToolCallListener。
Spring AI Session 0.7.0 和 0.8.0 使 appendEvent 幂等,通过 CrossSessionRecallTools 新增跨会话的关键词和模式搜索,并阻止在工具调用循环内运行记忆顾问时出现重复的提示历史。
Spring AI AgentCore 2.2.0 新增对 AgentCore memory 和 AgentCore identity 的 Spring AI Session API 支持。
下一步
2.1.0-RC1 的工作已经开始。消息部件(Message parts)是其中大部分工作的基础:
Spring AI Agents。我们计划于 2026 年 11 月将新的智能体支持作为 Spring Projects Experimental 下的独立项目发布,并计划在明年年中将其合并到 Spring AI 3.0 中。
跨所有提供商的消息部件。我们将重构现有的 ChatModel 实现,以原生方式生成和消费 MessagePart 内容,同时为使用当前访问器的代码保留向后兼容性。
核心中的会话管理。我们正在将 Spring AI Session 的关键部分引入 Spring AI 本身。除了高级对话历史管理、压缩和回忆之外,其 SessionRepository 实现将持久化完整的 MessagePart 结构。这样,推理也将通过持久化存储跨对话回合保留,而不仅仅是通过内存存储库。
MCP 2026-07-28。对 MCP 2026-07-28 规范的支持工作正在进行中,包括 MCP Java SDK 以及构建于其上的 Spring AI MCP 抽象和注解。
快速开始
在现有应用程序中尝试该里程碑版本,或在 start.spring.io 上创建一个新项目。消息部分模型和 Responses API 正是我们希望在 GA 之前获得反馈的那类变更——如果发现问题,请提交 issue;如果想告诉我们接下来希望看到什么,请发起 discussion。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Spring Blog
原创地址:https://spring.io/blog/2026/09/25/spring-ai-2-1-0-M1-available-now
原文作者:Spring Blog;如有侵权,请联系管理员删除。

