当你不再追求与生产环境完全一致时,沙箱测试才能发挥最佳效果。了解环境漂移的实际代价,以及哪些部分值得修复。
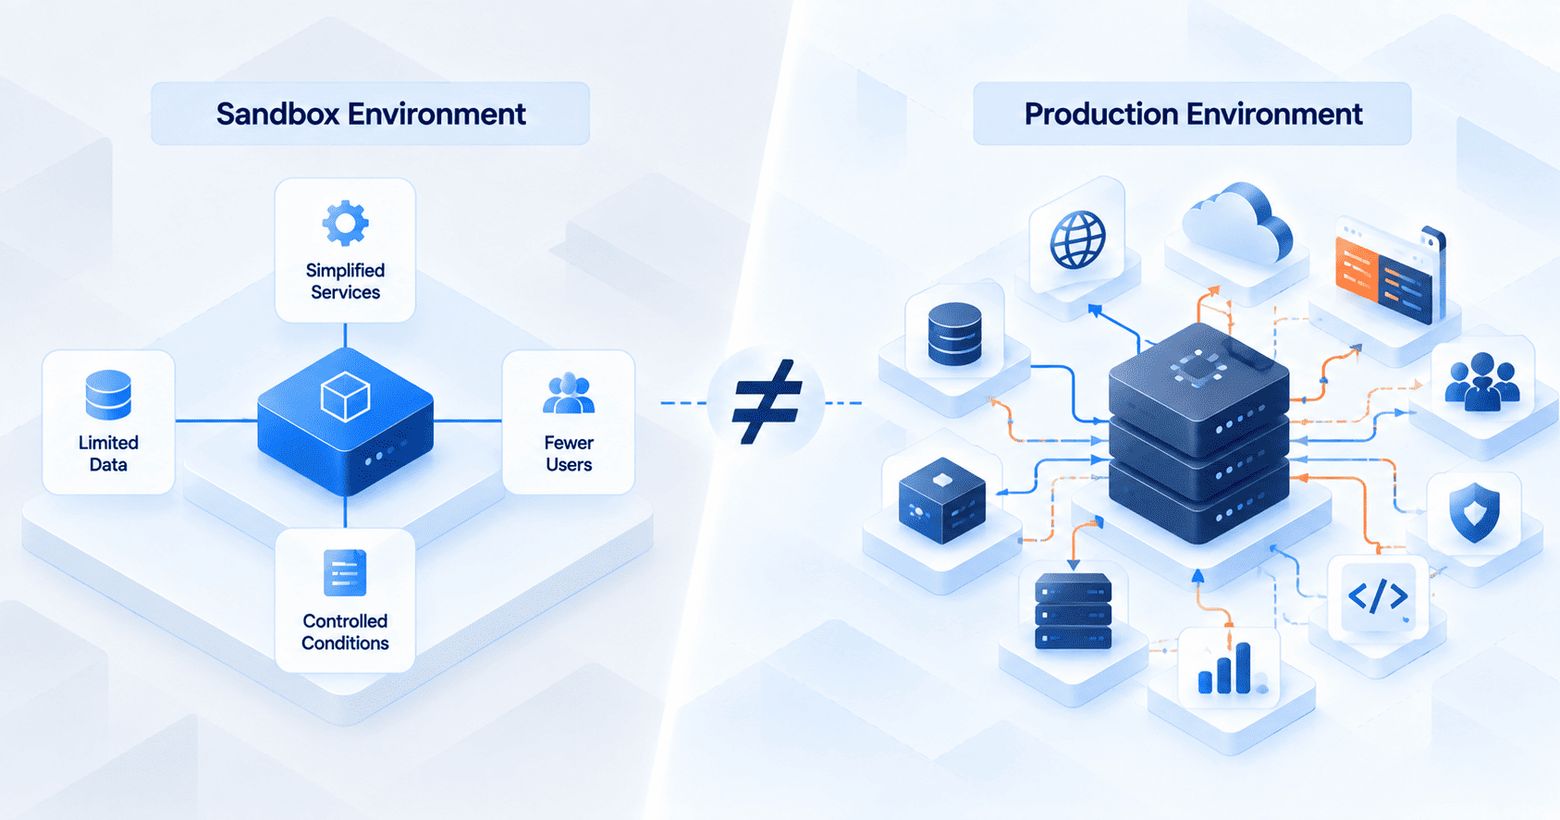
沙箱从未与生产环境完全匹配过。你的没有,任何人的都没有。一个配置变量的设置不同。一个数据库种子数据跳过了真实用户实际拥有的旧格式记录。一个上游服务上周四部署了新的响应模式,但没有人更新模拟。这些不是边缘情况——它们出现在每个环境、每个团队、每种规模中。这种差距是结构性的,是与生俱来的。当你接受这一点时,改变的是你把维护工作放在哪里。
环境漂移究竟是什么
漂移之所以累积,是因为生产环境和沙箱按照不同的时间表、由不同的触发条件发生变化,而没有人足够刻意地去协调两者。
生产环境持续演进。应用部署、基础设施更新、上游服务 API(应用程序编程接口) 变更、数据库模式迁移、第三方集成更新——每一项都在某个维度上推动生产环境向前发展。沙箱在有人明确更新它时能捕获其中一些变化,但会遗漏那些没有触发更新的变化。
将漂移归咎于环境的团队通常归咎错了对象。环境之所以漂移,是因为没有人更新它。沙箱不会自动跟踪生产环境——必须有人刻意地、按照与真实事件挂钩的时间表让它跟踪生产环境。没有这一点,漂移就是默认结果。
更好的问题不是“我们如何消除差距”,而是“差距中哪些部分实际上导致测试失败时遗漏了真实的生产故障”。这个答案比大多数团队假设的要窄得多。
差距中真正重要的部分
并非所有漂移都是等同的。沙箱可能以永远不会导致测试遗漏真实故障的方式与生产环境产生分歧,也可能以保证测试必然遗漏故障的方式产生分歧。
基础设施差异——不同的实例类型、不同的内存限制、不同的网络规则——在纸面上看起来很重要。更小的机器、不同的子网、缩减的副本。但在实践中,这些几乎都不会改变集成测试能捕获什么。测试验证的是应用程序如何处理支付服务的响应。无论测试运行在 t3.medium 还是生产级实例上,都不会改变响应处理是否正确。
行为契约漂移才是真正会破坏东西的类别。当订单服务模拟的支付依赖返回的响应结构不再匹配真实支付服务返回的内容时,测试验证的是应用程序基于一个生产环境将会否定的假设。测试通过了。集成失败了。沙箱并没有失职——是模拟错了,而没有人注意到它已经错了。
追求基础设施一致性令人满足,因为进展是可衡量的。你可以对比配置、弥合差距,并宣布环境是等价的。行为契约的准确性更难,因为它需要持续了解真实上游服务当前返回什么——不是模拟编写时它返回什么,不是文档说它返回什么,而是已部署版本今天实际产生什么。
为什么模拟比任何人预想的都更快过时
当团队首次构建沙箱时,模拟的依赖关系是准确的。有人研究了上游服务实际返回的内容,构建了反映这些观察结果的模拟,并将其提交。在那一刻,模拟是正确的。
然后上游服务持续部署。
当支付服务发布模式变更时,没有人会通知你。当一个原本可选的字段变为必填,或者错误格式被重构,或者响应中出现了一个你的应用程序现在需要处理的新字段时,不会有任何通知到达。你针对旧版本构建的模拟继续运行。测试继续通过。你进行部署。生产环境在那些依赖于已变更字段的代码路径上遇到了新格式。
测试套件运行干净。全线绿色。但它是错的——不是不稳定的错,不是间歇性的错,而是系统性的错,且看起来与正确完全相同。这才是更昂贵的失败模式。一个可靠地针对过时假设进行验证的测试套件看起来并不像坏了。它看起来值得信赖,直到生产环境反驳它。
管理得最好的团队并不是那些最初构建更准确模拟的团队。而是那些将模拟更新与上游部署事件而非测试失败联系起来的团队。触发条件决定一切。“测试失败时更新模拟”意味着从每次上游部署的那一刻起,直到下一次失败暴露出偏差——通常是在生产环境中——沙箱都是错误的。“上游服务部署时更新模拟”意味着偏差窗口以小时而非周来衡量。
基于观察的模拟生成方法在这里有所帮助。那些在与预发布环境交互期间捕获上游服务实际返回内容的工具——而不是要求开发者编写他们认为服务返回的内容——从观察到的现实出发,而非从可能已经漂移的文档出发。例如,Keploy 通过 eBPF 在内核级别捕获真实的 HTTP 流量,这意味着模拟反映的是服务在录制会话期间实际返回的内容,而不是开发者认为它返回的内容。先前模拟与更新后模拟之间的差异精确地揭示了上游响应中哪些字段发生了变化,这正是下游团队评估应用程序代码是否需要随模拟刷新一起更新所需的信息。
机制不如触发条件重要。在上游部署事件时更新的模拟保持准确。在测试失败后更新的模拟保持过时。
你真正需要的对等性
完全的生产对等性不是目标。针对集成测试旨在验证的特定行为进行有针对性的准确性才是目标。
沙箱不需要复制生产环境的数据量。它不需要复制生产环境的流量模式。它不需要以生产环境的基础设施规模运行。这些形式的对等性维护成本高昂,且很少决定测试是否能捕获真正的故障。
沙箱需要做的是准确表示被测服务之间的行为契约——请求和响应结构、错误条件、状态转换——并具有足够的保真度,使得沙箱中的测试失败表明生产环境中会发生的真实故障,而通过的测试反映了一个将持续成立的集成。
为了让沙箱测试实现这一目标,团队需要明确两件事:沙箱所代表的是哪些行为契约,以及随着上游服务不断演进,这些契约如何保持最新。
第一个是在搭建阶段就要回答的设计问题。第二个是维护问题,在搭建阶段没有答案。
“足够好”究竟在哪里
在这个问题上花了足够长的时间,因此有一个明确的观点:被坑的团队并不是在运行糟糕的沙箱。他们运行的是曾经准确、但在上游服务变更后无人更新的沙箱。
让模拟保持最新。确保测试数据包含生产环境中实际存在的记录形态,而不仅仅是初始搭建时的那些干净数据。这种组合能捕获值得捕获的集成故障——那些不需要生产环境来暴露的故障。
它并不能捕获所有故障类别。它捕获的是分布式系统中最重要的一类:关于某个依赖如何行为的假设,而该依赖后来已不再遵守这一假设。
生产环境所揭示的其余内容——真实负载下的涌现行为、实际用户数据中的边缘情况、需要真实流量模式才能暴露的故障模式——这些都需要通过生产环境观测来理解。沙箱测试的目标不是消除这一类学习。而是以低成本、早发现的方式,消除那些不需要生产环境来揭示的故障。
正是这个框架让沙箱与生产环境之间的差距变得清晰可辨。它不是需要解决的问题,而是需要理解的边界。沙箱覆盖其内部的一切。生产环境揭示沙箱在结构上无法覆盖的内容。两者都在各司其职。维护工作是让沙箱的覆盖范围在其边界内保持准确,而不是将边界扩展到与生产环境完全一致。
环境漂移不是敌人。集成测试所依赖的行为契约中未被检测到的漂移——一直未被注意到,直到它导致生产故障——才是值得预防的特定故障模式。在投资于旨在实现永远无法达到的一致性的沙箱基础设施之前,值得先做出这一区分。
这些文章采用 Creative Commons Attribution-ShareAlike 4.0 International 许可协议授权。
creativecommons.org/licenses/by-sa/4.0/deed.en
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Stack Overflow Blog
原文作者:Sancharini Panda;如有侵权,请联系管理员删除。

