GPT‑6 系列模型指南
在管理时间和成本的同时,从 GPT‑6 模型获得最佳结果的实用技巧
GPT‑6 是我们迄今为止最先进的模型套件,为你提供适用于不同类型工作的模型选择。
无论你是将想法转化为可运行的原型、构建和测试功能,还是跨代码仓库、数据库和外部 API(应用程序编程接口) 编排多步骤工作流,本指南都将说明如何选择 GPT‑6 模型、给出有效指令、管理长时间运行的工作,并为生产环境做好准备。
GPT-6 Astra 我们最智能的模型,可获得最佳结果。输入 $10.00 输出 $50.00 缓存输入 $1.00
GPT-6.1 Sol 接近 Astra 的智能水平,价格仅为其五分之一。输入 $2.00 输出 $10.00 缓存输入 $0.10
GPT-6 Luna 快速高效,适合大规模日常工作。输入 $0.10 输出 $0.50 缓存输入 $0.01
TL;DR
在生产环境中高效运行。使用缓存 (opens in a new window) 和压缩 (opens in a new window) 来管理上下文和成本。衡量任务成功率和延迟,并规划监控和数据控制。
将模型与工作负载匹配。通过选择适合任务的模型、推理投入 (opens in a new window) 和速度,平衡能力、成本和延迟。
调整你的提示词和技能。保持提示词、技能和仓库指令在以下方面一致:模型应交付什么、它可以独立做什么,以及什么算作完成。
让长时间运行的工作保持在正轨上。使用引导 (opens in a new window) 、异步工具 (opens in a new window) 和委派 (opens in a new window) 来处理更新和独立工作。为模型何时应请求输入设定清晰的边界。
1. 在生产环境中高效运行
为生产环境准备工作流
在部署之前,你需要落实若干检查和最佳实践。
牢记效率。削减任务不需要的上下文 (opens in a new window) ,同时保留它确实需要的证据。在你的应用支持的情况下,将独立任务一起运行 (opens in a new window) ,这样某个缓慢步骤就不会拖住不相关的工作。
通过提示词缓存 (opens in a new window) 为重复性工作复用共享上下文。根据模型不同,缓存输入 token 的成本比未缓存输入 token 低最多 95% (opens in a new window) 。将稳定指令和参考材料放在变化的任务细节之前,并保持工具定义一致。缓存仪表盘 (opens in a new window) 和诊断指南 (opens in a new window) 可帮助你查看这种复用在哪里失效。在估算完整工作流的成本时,将缓存写入和任何长上下文费率纳入考虑。
对于较长的对话,压缩 (opens in a new window) 可减小上下文大小,同时保留继续所需的状态。
决定你将如何监控行为 (opens in a new window) ,并查看你的应用的数据控制 (opens in a new window) 。
部署前测试:运行代表性任务,并衡量任务成功率、延迟和每个成功任务的成本。查看我们的 API 部署清单 (opens in a new window) 。
将模型与工作负载匹配
将模型选择和推理级别视为智能与价格之间的权衡。
模型:GPT‑6 Astra (在新窗口中打开)用于需要最大智能的最难推理工作。GPT‑6.1 Sol (在新窗口中打开)用于复杂编码、研究和计算机使用。GPT‑6 Luna (在新窗口中打开)用于规模化聚焦任务和具有明确目标的日常重复性工作,例如提取发票字段、分类请求或生成结构化摘要。
在评估最适合任务的模型时,比较每个模型的定价 (在新窗口中打开)。
推理级别:在 API 中,选择模型在任务上投入多少精力。低:常规任务,例如提取事实或进行小幅编辑。中:需要判断力的工作,例如规划功能或比较选项。高:困难调试、更深入分析或仔细审查。超高 / 最高:在支持的情况下,当“高”不够时进行测试,并且仅在改进足以证明增加的时间和成本合理时才保留。
在 API 中,你可以在对话中途更改推理投入 (在新窗口中打开),而不会破坏缓存。
在 Codex 中,先使用该模型的默认推理级别,然后对更简单的任务降低级别,或对更深入的分析提高级别。
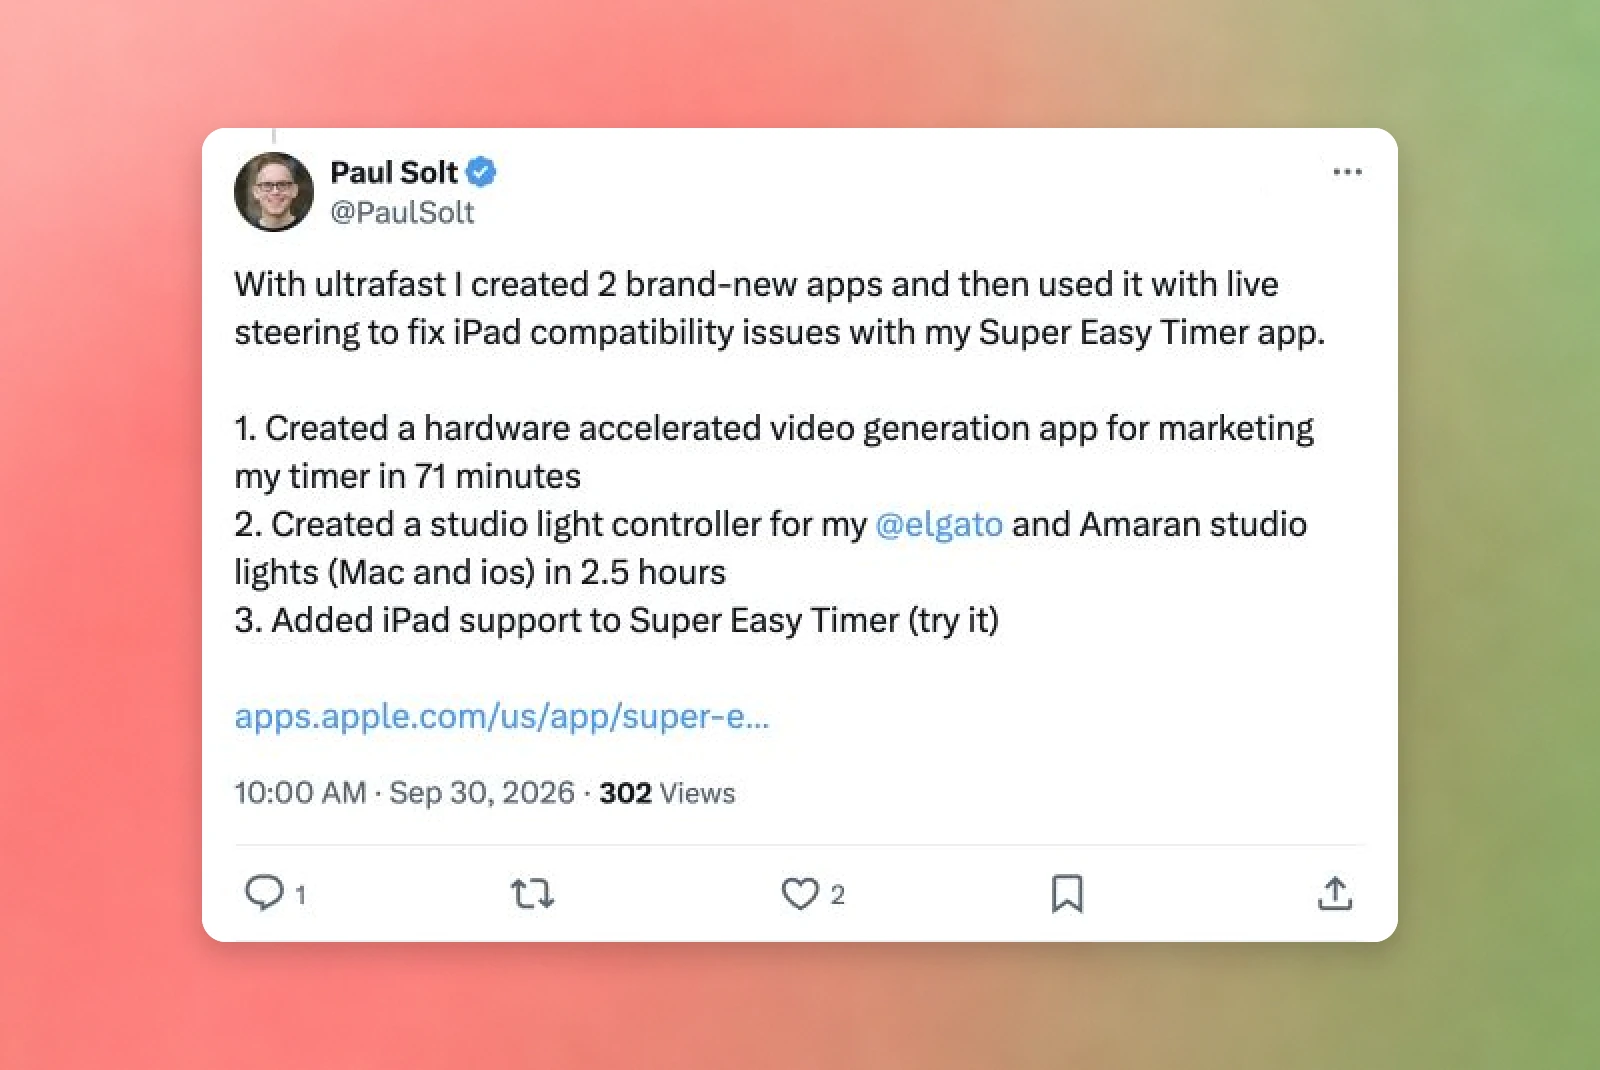
速度:在 API 中,当响应时间很重要时,例如在聊天应用或编码工具中,使用 Fast 模式 (在新窗口中打开)。与 Standard 处理相比,它以更高的每 token 成本提供更快、更一致的响应时间。在 Codex 和 API 中,当更快的响应值得支付溢价时,例如快速编码迭代,使用 Ultrafast (在新窗口中打开)。它会独立于推理投入加速 token 生成。适用于 GPT‑6 Astra (在新窗口中打开)。
2. 调整你的提示词和技能
给模型一个清晰的任务
“模型在理解细微差别和歧义方面已经好得多,因此过去有帮助的过度具体指导现在反而可能妨碍结果。” (在新窗口中打开)
—Eric Provencher,OpenAI 开发者体验
从一个清晰的任务开始:你想要的结果、它面向谁、相关背景和约束,以及什么算完成。然后查看这四个方面,它们总结自 Rethinking skills and prompts for GPT‑6 Astra (在新窗口中打开),以便更深入地了解如何更新你的指令:
创建更好的技能:保持描述简短,并明确说明每个技能应在何时运行,仅在需要时加载支持性细节,并用适合你团队所用模型的指导取代僵化的固定流程。
更新你的 AGENTS.md:说明特定文档和测试在何时相关,并明确授权安全的常规工作流,例如使用一次性数据运行本地测试且不访问生产环境。
设定决策边界:说明哪些操作可以独立进行,哪些需要批准,用清晰的边界取代一概而论的“始终询问”规则。
对持久性做出明确规定:定义“完成”包括哪些内容——实现更改、运行更改、检查结果并修复失败——并确定任何需要你审查的决策。
如需更多指导,请参阅推理最佳实践(在新窗口中打开)。
定义你需要的输出
无论你是在 Codex 中工作,还是使用 API 进行构建,都要明确模型可以做出哪些决策、何时应请求输入,以及什么样的响应才算有用。
给模型足够的指导,让工作持续推进,同时不要对重要决策进行猜测。告诉它哪些选择可以自行做出,以及何时应请求你的输入(在新窗口中打开),例如,它可以决定如何组织摘要,但在更改项目范围之前应先与你确认。描述什么样的响应才算有用(在新窗口中打开),例如使用通俗语言、适合你受众的技术细节,以及一份简短交接,涵盖更改了什么、检查了什么,以及还有什么仍需关注。
3. 优化长时间运行的任务
让复杂工作持续推进
借助 GPT‑6 系列模型,你现在可以承担持续数小时或数天的任务。使用以下功能来更好地管理长时间运行任务中的智能体。
API
在 API 中,使用引导、异步工具和并行工作来让长时间运行的任务持续推进。
在运行过程中更新指令:回合中引导(在新窗口中打开)让你可以在模型工作时通过 Responses WebSocket API(在新窗口中打开)发送更正。更新会排队;它们不会取消正在运行的工具,也不会撤销已完成的操作。
在工具运行时继续工作:异步工具调用(在新窗口中打开)让模型可以在你的应用运行较慢任务(例如测试)时继续独立工作。你的应用在结果准备好后返回结果。在开始依赖该结果的工作之前,先等待该结果。
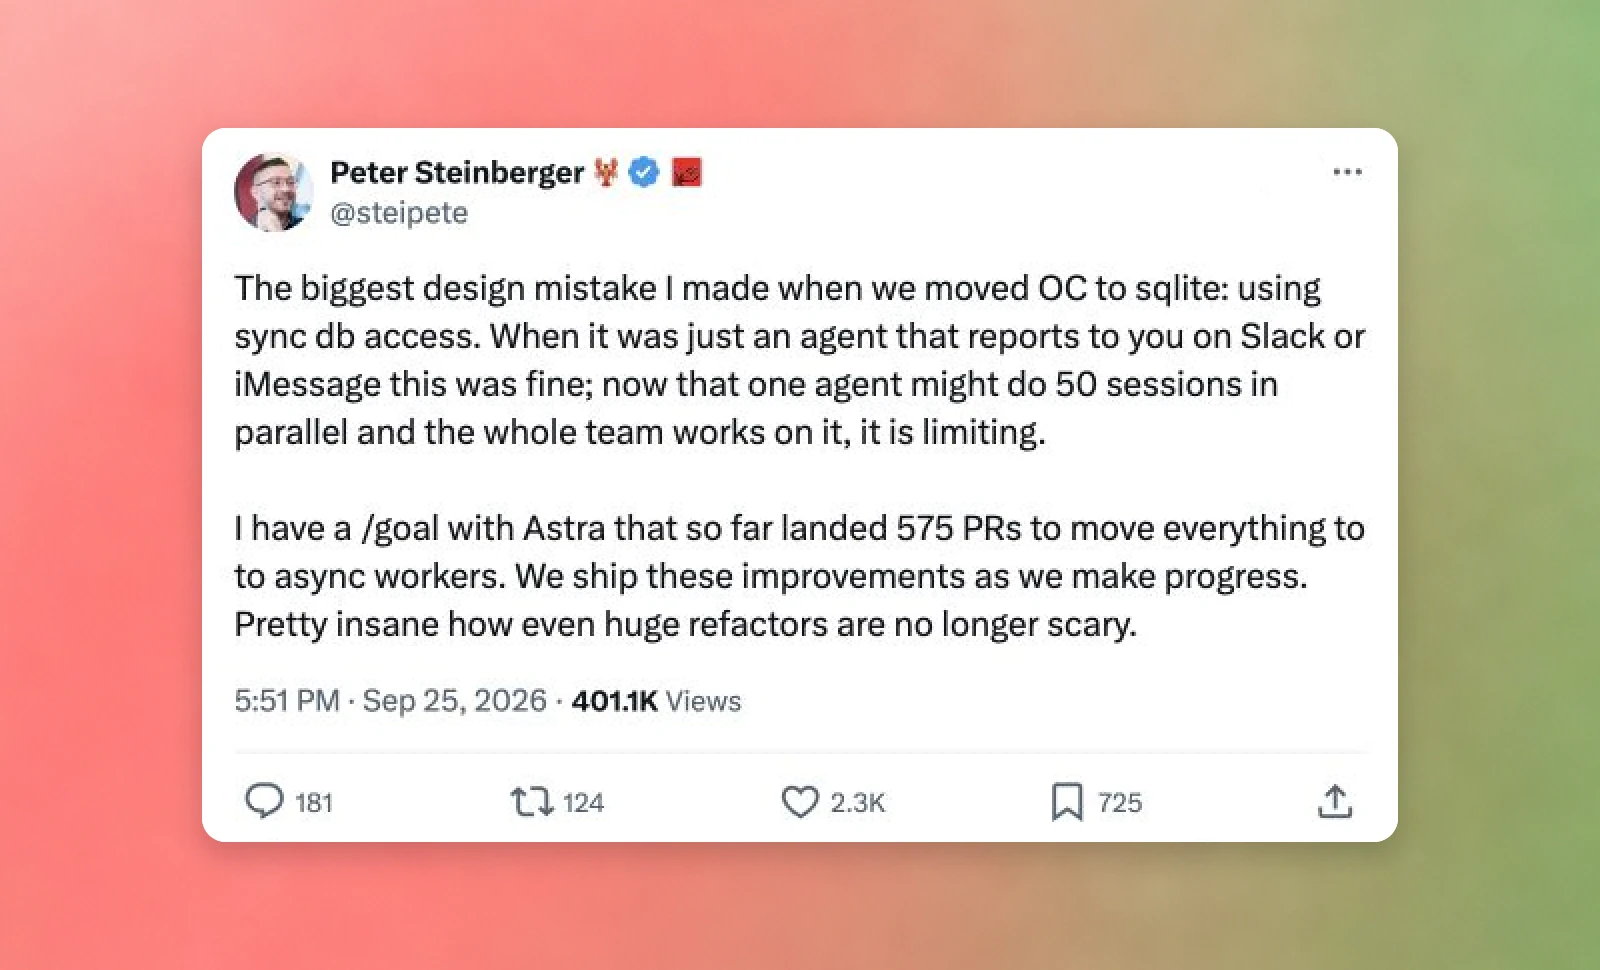
委派独立子任务:GPT‑6.1 Sol 支持 Responses API(在新窗口中打开)中的多智能体工作流。它可以将独立工作分配给子智能体(例如调查代码库的不同部分),并将其发现整合为最终响应。多智能体目前处于测试阶段。
Codex
长时间运行的任务可能会暴露出你在初始提示中未必能预料到的决策。使用澄清和引导来让工作保持正轨。
随着工作推进回答问题:借助 GPT‑6 Astra,Codex 可以在工作时请求澄清(在新窗口中打开)。解决影响下一步的问题,并明确在你做决定期间哪些独立工作可以继续。如果你将离开,告诉 Codex 哪些任务可以继续,以及它应在何时暂停等待你的回答。
当需求变化时重定向工作:用新信息引导当前任务(在新窗口中打开),说明哪些应该改变、哪些应保持不变。这有助于避免在不再满足你需求的方法上花费更多时间。
利用计算机使用完成更多工作
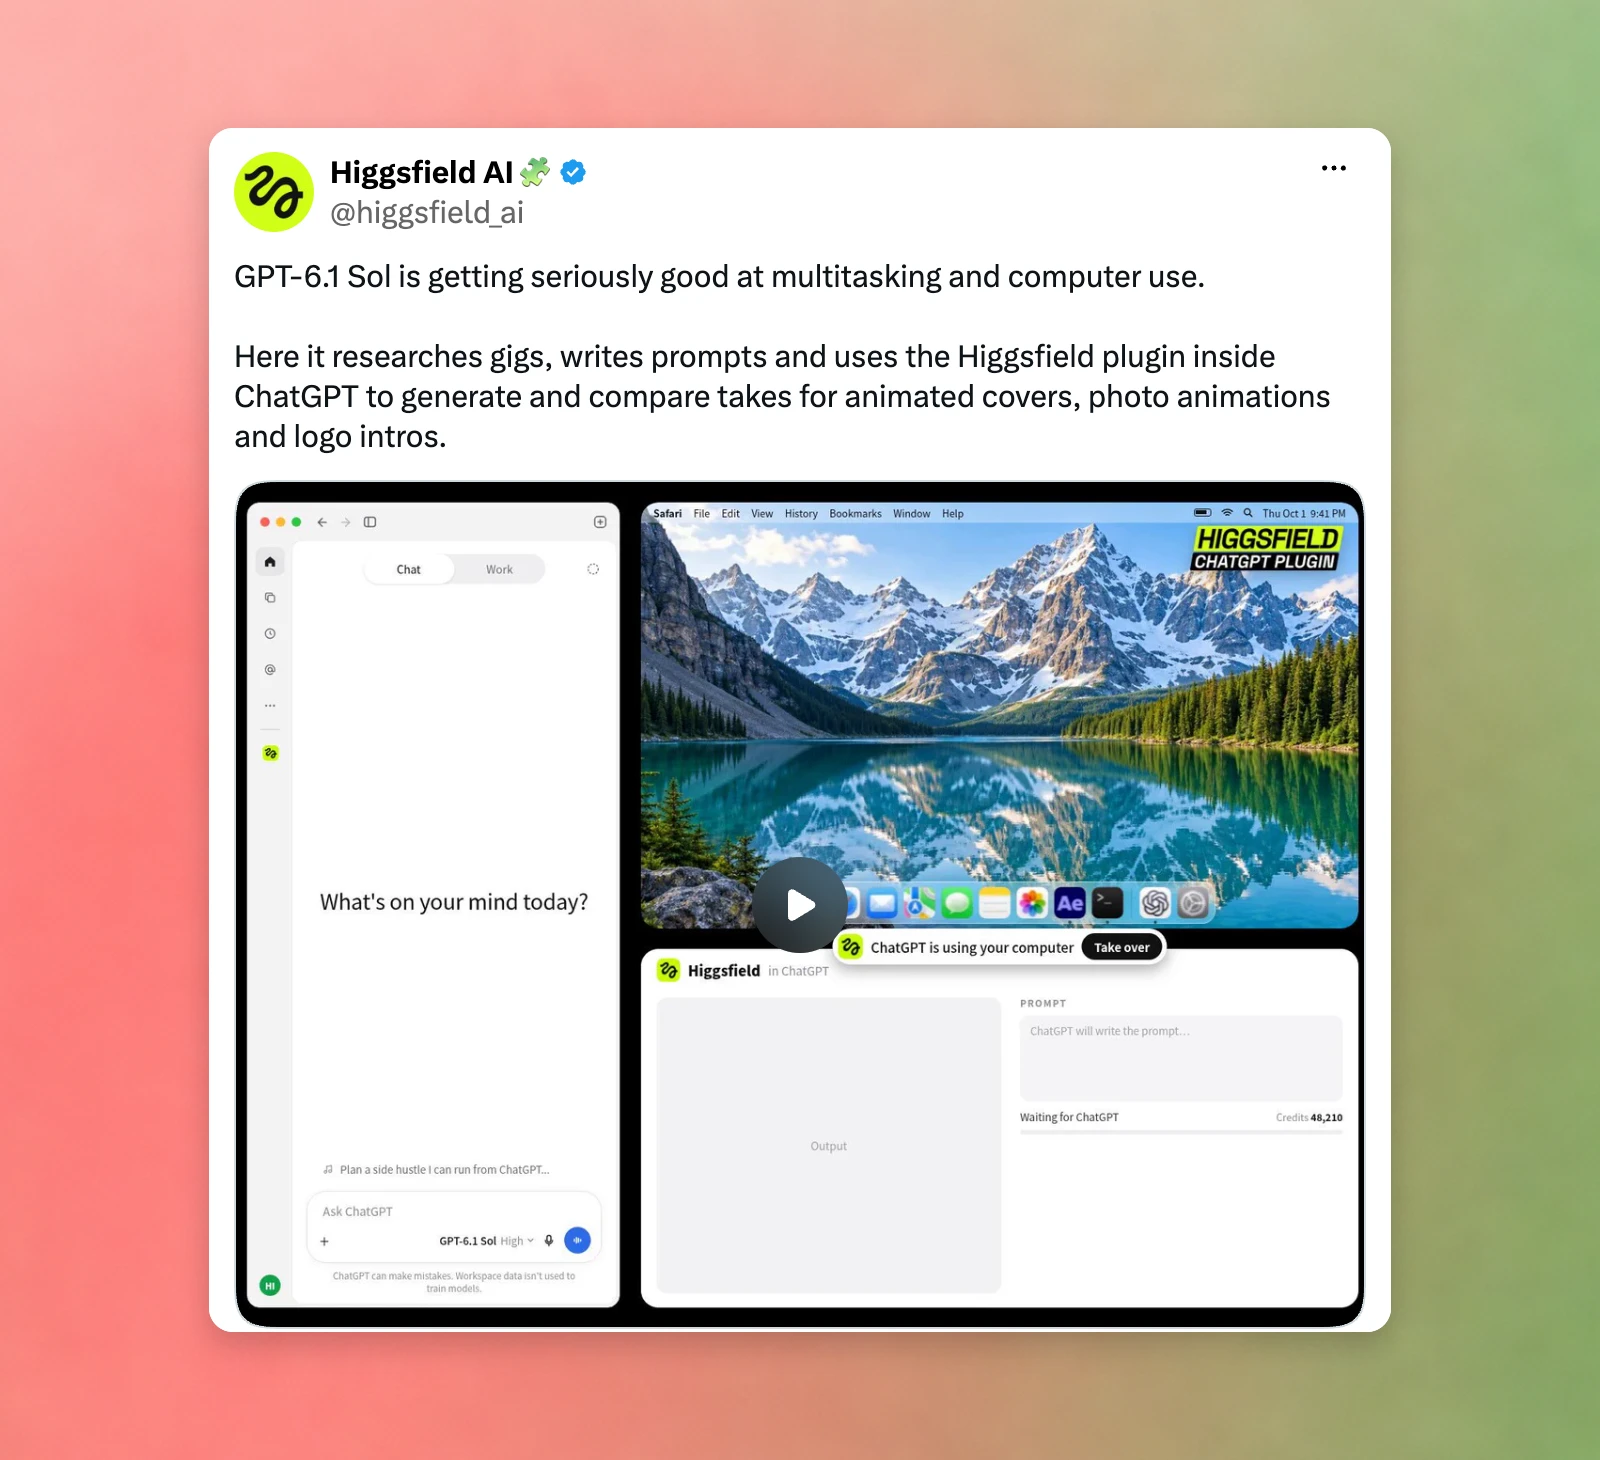
计算机使用(在新窗口中打开)让 GPT‑6 Astra、GPT‑6.1 Sol 和 GPT‑6 Luna 能够直接与网站和桌面应用交互,甚至包括没有 API 的应用程序。例如,你可以要求模型调查一个 bug、修复代码,并在浏览器中打开你的产品以检查修复是否有效。
为每个步骤选择最简单可靠的方式:
当 API 或已连接工具可以直接完成工作时,就使用它。
当模型需要为你读取屏幕、点击按钮或填写表单时,使用计算机使用。
如果你要将计算机使用构建到自己的应用中,给模型一个可以运行代码来控制浏览器或桌面的工具。Playwright 可用于浏览器(在新窗口中打开);PyAutoGUI 可用于桌面应用。
从测试到生产:团队如何用 GPT‑6 Astra 构建
Harvey:更多上下文,更有用的草稿。 Harvey 结合法院信息、判例法、律所文档和律师偏好来定制其草稿。“我们可以为模型提供更多上下文,并生成越来越好、结构更清晰的输出,”联合创始人 Gabe Pereyra 说。
Cognition:工程师可以审查的测试结果。 Cognition 在 Devin 中使用 GPT‑6 Astra 来测试软件并返回证据。在一个 iPhone 游戏示例中,Devin 生成了模拟器录制和一份报告,将通过的检查与未测试的区域分开,使剩余工作更容易看清。
Hex:从业务问题到交互式仪表板。 Hex 使用 GPT‑6 Astra 将关于销售渠道表现的问题转化为书面发现和交互式仪表板,包括地理细分。它还要求模型检查数字是否合理,以及分析是否回答了业务问题。
Invideo:对最终剪辑有更多控制。 Invideo 使用 GPT‑6 Astra 来规划时间线编辑并创建编辑人员可以细化的自定义效果。该公司报告称,在调色和校正任务上的成功率大约提高了三倍。几位编辑还在一天内创建了约 50 个效果。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:OpenAI Blog
原创地址:https://openai.com/index/practical-guide-building-gpt-6
原文作者:OpenAI Blog;如有侵权,请联系管理员删除。

