使用TLX优化锯齿状Flash Attention:迈向Blackwell上SOTA FA4之路 - PyTorch
TL;DR
在这篇博客文章中,我们介绍了在 NVIDIA Blackwell (B200) 上关于 Jagged Flash Attention (JFA) 的工作——这是 Meta 的生成式广告模型 (GEM) 背后的注意力内核——该内核使用 TLX (Triton Low-level Extensions) 构建,TLX 在 Triton 高层次的、基于 tile 的编程模型之上增加了显式的、硬件感知的控制。
注意力是 GEM 中最慢的单个内核,而要在 Blackwell 上达到峰值性能,传统上需要手写 CuteDSL 或 CUDA(NVIDIA 并行计算平台和编程模型)——开发缓慢且难以扩展到新的变体。我们展示了 TLX 在这两方面都弥补了这一差距。在开发效率方面,TLX 注意力内核大约有 3.2K 行简洁的 Triton 级别代码——比最先进的 FlashAttention-4 (FA4) 约 10K 行的 CuteDSL 内核少约 3 倍。在性能方面,它在对 GEM 至关重要的 jagged 形状上优于 FA4(2026 年 5 月版本)——前向传播约提升 13%,反向传播约提升 50%。并且通过保持在 Triton 的高层次模型中,该内核足够平易近人,不仅内核专家,建模工程师也能阅读、扩展和融合。
我们将这项工作组织为两部分——TLX 重写所带来的结构性变化,以及我们在其上叠加的优化——所有这些都在 B200 上以 bfloat16 针对 FA4(Blackwell 上当前最先进的技术)进行了基准测试。
代码可在以下地址获取:https://github.com/facebookresearch/ads_model_kernel_library/tree/main/tlx_jfa
引言
Meta 的广告模型,包括生成式广告模型 (GEM) [2] 和昆仑架构 [5],在 jagged(可变长度或不规则)用户序列上运行注意力。正如我们在 GEM 训练深度解析中所描述的,将这些序列填充到固定长度可能会浪费高达 50% 的计算量。GEM 改为将序列连续打包,并在 offsets 张量中记录每个序列的边界。
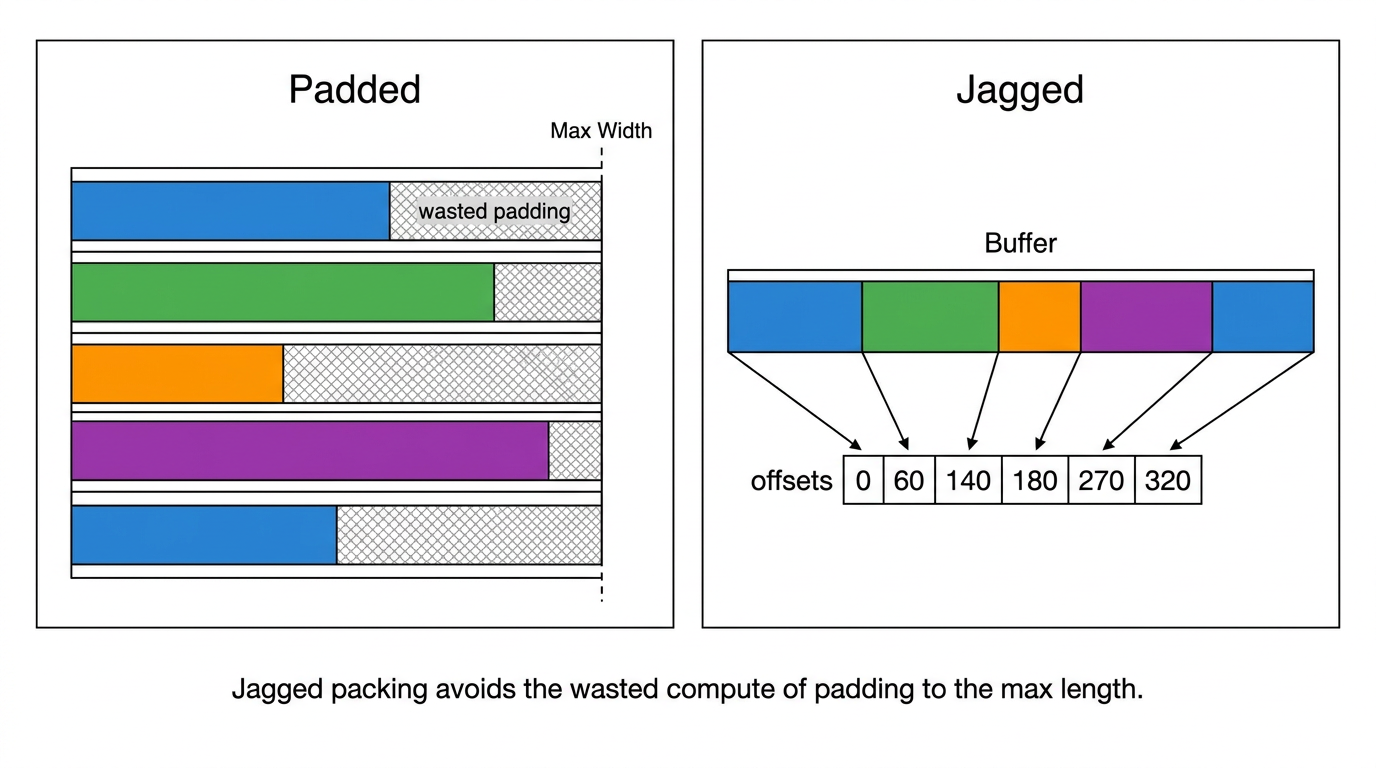
在 Blackwell 上达到峰值吞吐量意味着要让张量核心持续得到供给。普通 Triton 将大部分这些决策留给编译器;TLX [1] 将它们作为一等原语暴露出来(显式的 SMEM/TMEM 分配、async_task warp 特化、屏障、异步 TMA 和 MMA,以及 CLC)。本文的其余部分利用这种控制,将一个由编译器调度的、受内存限制的内核转变为一个紧密流水线化、warp 特化的内核。
1. 挑战:在 Blackwell 上实现高性能且可扩展的注意力
在 Blackwell 上优化注意力意味着同时解决两个问题。第一个是性能:注意力是 GEM 中最慢的单个内核,只有当全局内存加载、softmax 和矩阵乘法紧密重叠时,它才能达到峰值吞吐量。第二个是迭代速度:注意力是新建模思想落地的地方(滑动窗口、块稀疏和其他变体),因此该内核经常被修改——然而达到这种性能的最先进路径是手写的 CuteDSL/CUDA 内核,难以阅读、扩展或融合。我们使用 TLX 的目标是取得平衡:在一个保持易于迭代的内核中实现有竞争力的性能。
为什么编译器调度的基线不够好。我们的起点是一个成熟的基于 Triton 的 JFA 内核——算法上正确,但它将所有片上数据移动和调度都留给编译器:无法控制共享内存分配或流水线深度,没有显式的屏障或 warp 特化,并且单个同构 warp 组同时执行加载、softmax 和矩阵乘法,因此每当它不发出 MMA 时,张量核心就会停顿。打破这一上限正是 TLX 的显式控制所能实现的。
生产用例 broadcast-Q 进一步塑造了设计:单个稠密 Q 被广播到批次中的每个序列,因此其梯度 dQ 必须在整个批次上求和——这使 dQ 尾声(epilogue)变成了一个高度争用的跨程序归约(cross-program reduction),我们的若干优化正是为了让它变快而存在。除非另有说明,本文后续内容均假设 broadcast_q=True。
2. 使用 TLX 优化 Jagged Flash Attention
我们的工作分为两类。结构性变更(§2.1)是 TLX 使能的、对内核从底层进行的重新组织——它们改变了工作和内存在 CTA 各 warp 之间的布局方式。优化(§2.2)则保持该结构不变,进一步榨取性能,主要通过消除停顿和无效工作。我们按每项优化所针对的瓶颈来阐述其动机,而非其实现机制。
2.1 结构性变更
Warp 特化、显式的共享内存/张量内存管理以及屏障流水线是任何高性能 Blackwell attention 内核的标准要素,因此我们在此简要说明——关键在于 TLX 让我们能够用高层 Triton 代码表达它们,而非手写 CuteDSL 或 CUDA,这正是 §2.2 优化得以快速原型化的原因。具体而言,我们将 CTA 拆分为角色特化的异步任务——用于 TMA 加载、张量核心矩阵乘法、softmax/校正数学以及尾声存储的专用 warp,并在反向传播中增加一个专用的 dQ 归约 warp——从而使张量核心在 softmax 并发运行时持续获得背靠背的 MMA 供给,而不是像基线那样由一个 warp 组阻塞矩阵乘法。
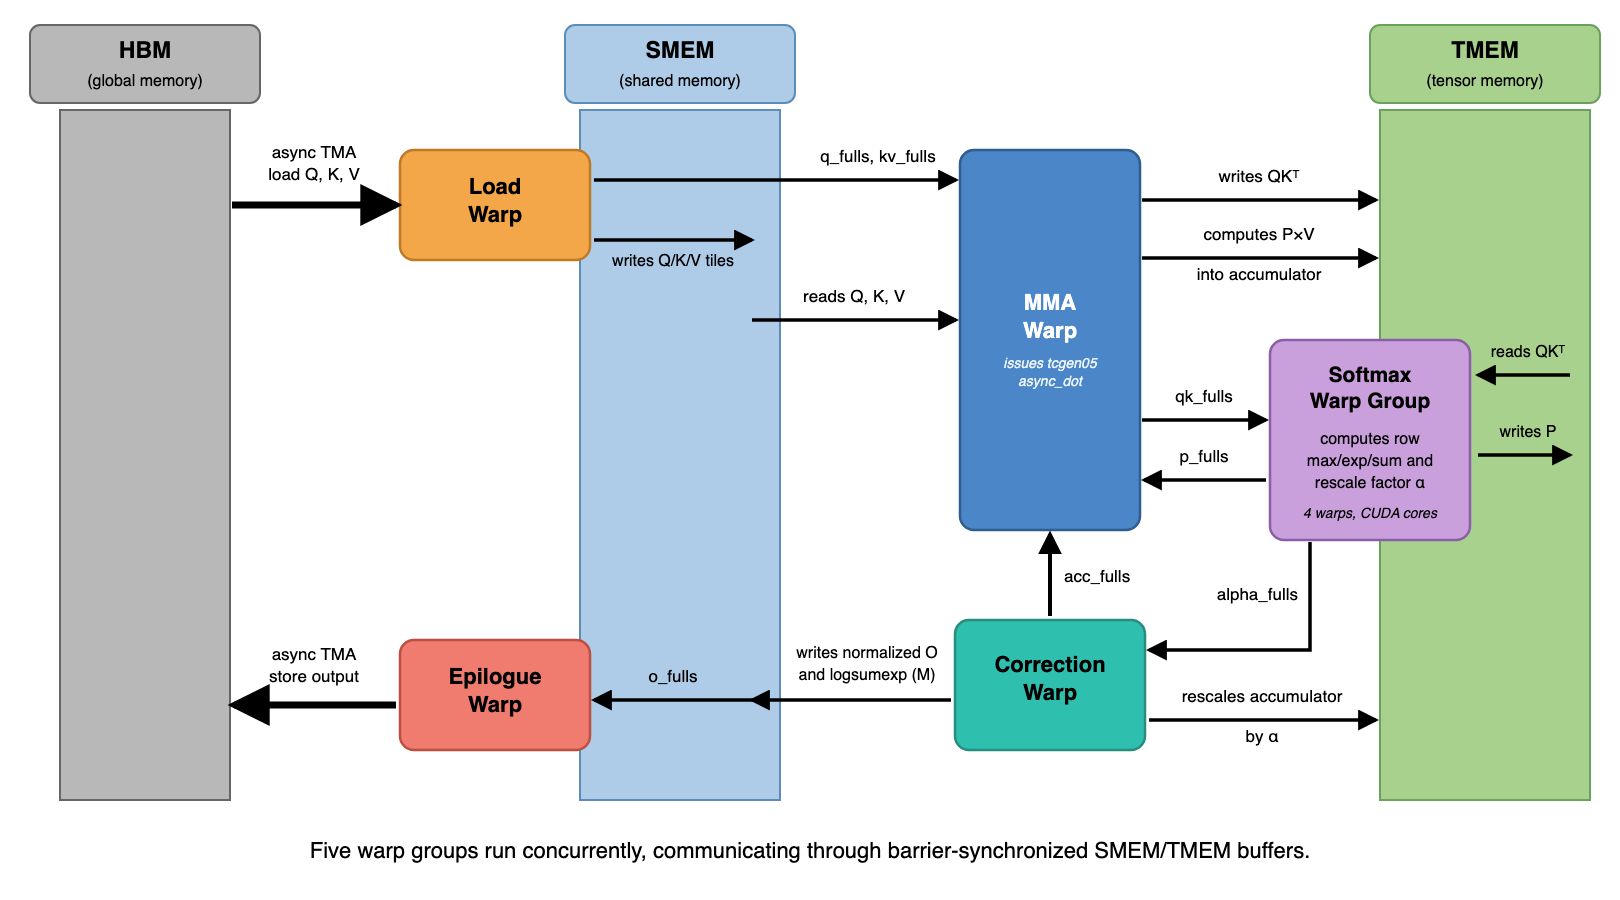
同样的显式控制也延伸到内存和调度:我们手动分配每个片上缓冲区并选择其流水线深度(例如对 K/V 使用三重缓冲,使加载 warp 提前运行),将生命周期不重叠的 TMEM 缓冲区进行别名复用(QK 分数、P 和 softmax 统计量共享一个分配,而 PV 累加器保留自己的分配),通过显式的生产者/消费者屏障在 warp 之间传递数据以实现确定性的流水线,并使两个 pass 都持久化——每个 SM 一个 CTA 循环处理 tile。这些在普通 Triton 中都无法表达,尤其是持久化结构为我们提供了一个自行做出调度决策的位置——这是 §2.2 的基础。
2.2 优化
在 warp 特化、持久化结构就位后,剩余工作就是消除那些使张量核心无法保持忙碌的停顿和无效工作。以下优化基本相互独立,每项针对一个特定瓶颈。
我们以一致的方法论发现了它们:使用 NVIDIA Nsight Compute (NCU) 读取硬件计数器,如张量核心/TMEM 流水线利用率、SM 忙碌度和寄存器溢出(表现为本地内存流量);使用 ptxas dump 日志确认溢出;使用 TritonBench 的 profiler-measure 模式获得干净的优化前后 A/B 延迟对比。这些优化分为两组。一些借鉴自 FA4 实现——它本身表明 TLX 能用可读的 Python 表达手写 CuteDSL 内核所使用的相同技术。另一些则由我们自己推导,来自对我们自己内核的剖析和分析,专门针对 jagged broadcast-Q 工作负载。
概览而言,以下优化包括:
跨 SM 调度 jagged tile——软件负载均衡加上 Cluster Launch Control,使每个 SM 在 jagged 输入存在数量级长度偏斜的情况下仍保持忙碌(前向和反向)。
多阶段 dQ 暂存——双缓冲 SMEM 暂存流水线隐藏了高度争用的 broadcast-Q dQ 归约加法,这是反向传播的头号瓶颈。
提前释放张量内存——在最终存储之前释放 dQ 张量内存缓冲区,使 MMA warp 能更早开始下一个 tile 的 dQ 矩阵乘法。
循环剥离——将 KV 循环拆分为无分支的批量 pass 和极小的掩码尾部,消除了每次迭代的掩码开销及其导致的寄存器溢出。
CTA 协作 MMA——两个 CTA 在单个矩阵乘法上协作,以提高矩阵乘法密集的反向传播中的张量核心利用率(借鉴自 FA4)。
跨 SM 调度 jagged tile
不规则输入会在各 SM 之间造成严重的负载不均衡:当序列长度相差数个数量级时,朴素的 tile 到 SM 映射会让一些 SM 空闲,而另一些 SM 则要艰难处理长序列。SM 占用热力图(Triton-MPP)让这一点变得直观——少数几行在其余行早已空闲后仍长时间处于高负载。真正贪心的重新平衡接近最优,但无法向量化,因此会导致主机端启动开销激增。
在前向传播中,外层循环遍历稠密的 Q,内层循环遍历不规则的 K/V,因此一个 tile 的成本与其批次的 key 长度成正比——这些 tile 高度不均匀。针对不规则情况,平衡这一点是我们自己的思路:在主机端,我们按 KV 工作负载对所有 tile 降序排序,并以之字形(牛耕式)模式将它们交给 SM——偶数轮从左到右填充 SM,奇数轮从右到左——这样每个 SM 最终都能以可忽略的 CPU 成本获得长短 tile 的均衡混合。这在前向 kernel 上大约恢复了 20%。
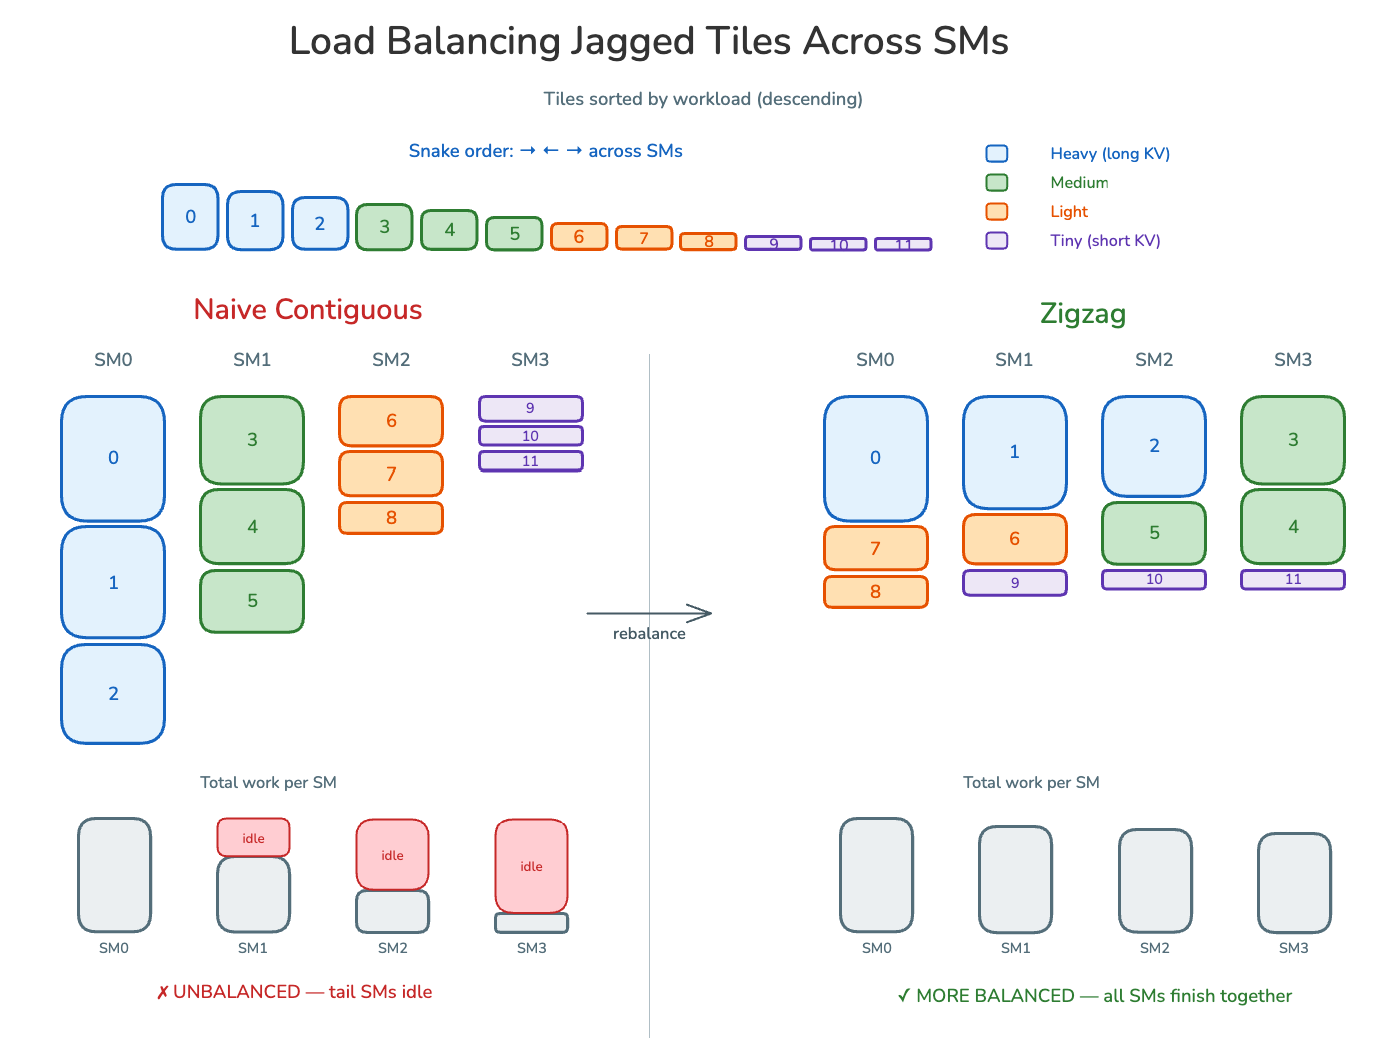
反向传播需要不同的策略。它的 dK/dV pass 外层循环遍历 K/V 块,内层循环遍历稠密的 Q,所以现在 K/V 块才是 tile:每个 tile 的成本大致均匀(一个 K/V 块对共享的稠密 Q),但每个批次的 tile 数量会随不规则的 key 长度而变化。按工作负载排序不再有帮助——相反,我们在主机端预计算有效的 (batch, head, K/V-block) tile 列表,并以轮询方式将它们分配到各 SM,使用块最内层排序,使连续 tile 在 L2 中复用相同的 K/V,并将每个 head 的块数填充到 cluster 大小的倍数,以适配 2-CTA 路径。以这种方式分配数量可变但成本相等的 tile,可以让每个 SM 都保持忙碌,而无需任何排序。
静态平衡处理我们能够提前预测的偏斜;只在运行时才显现的残余方差则由 Cluster Launch Control (CLC) [3] 动态处理。CLC 是 Blackwell 的一项特性,它按需分发下一个 tile 索引,因此无论哪个 SM 先完成,都会抓取下一块工作,不会让任何单个长序列拖住整个 grid。
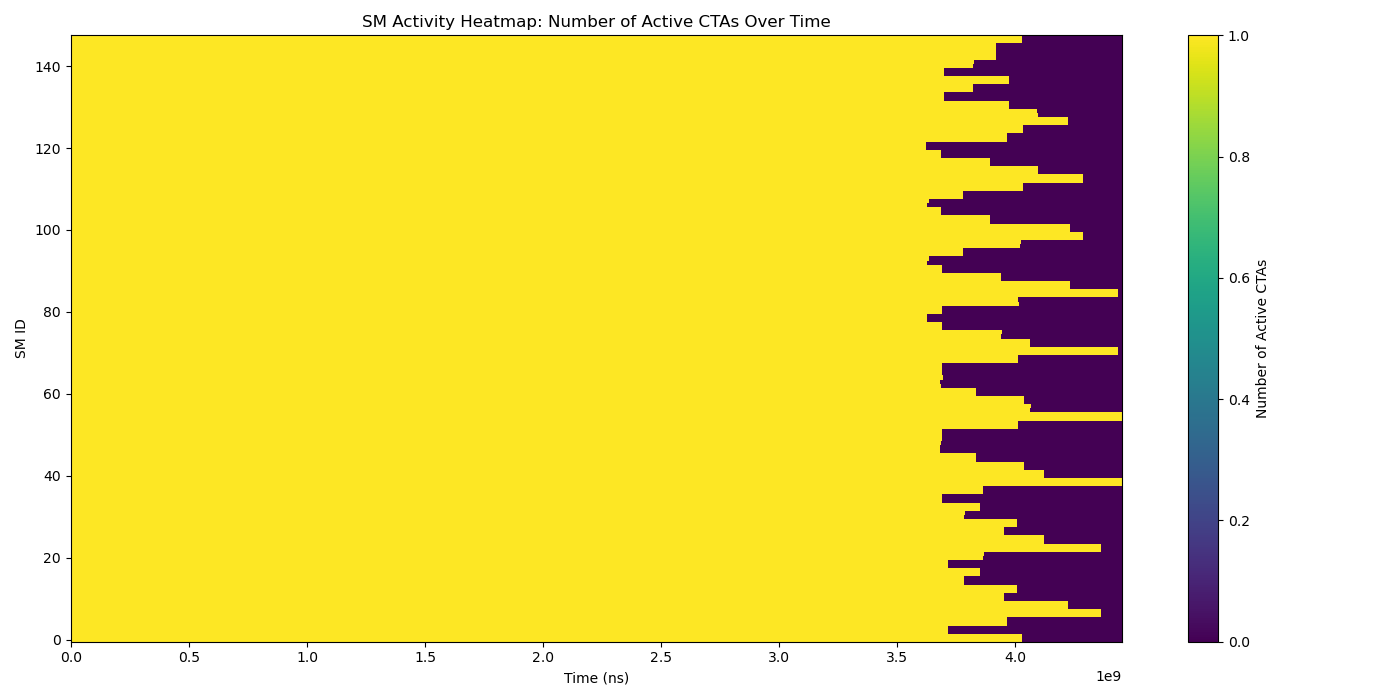
不使用 CLC 时 CTAs 工作负载热力图
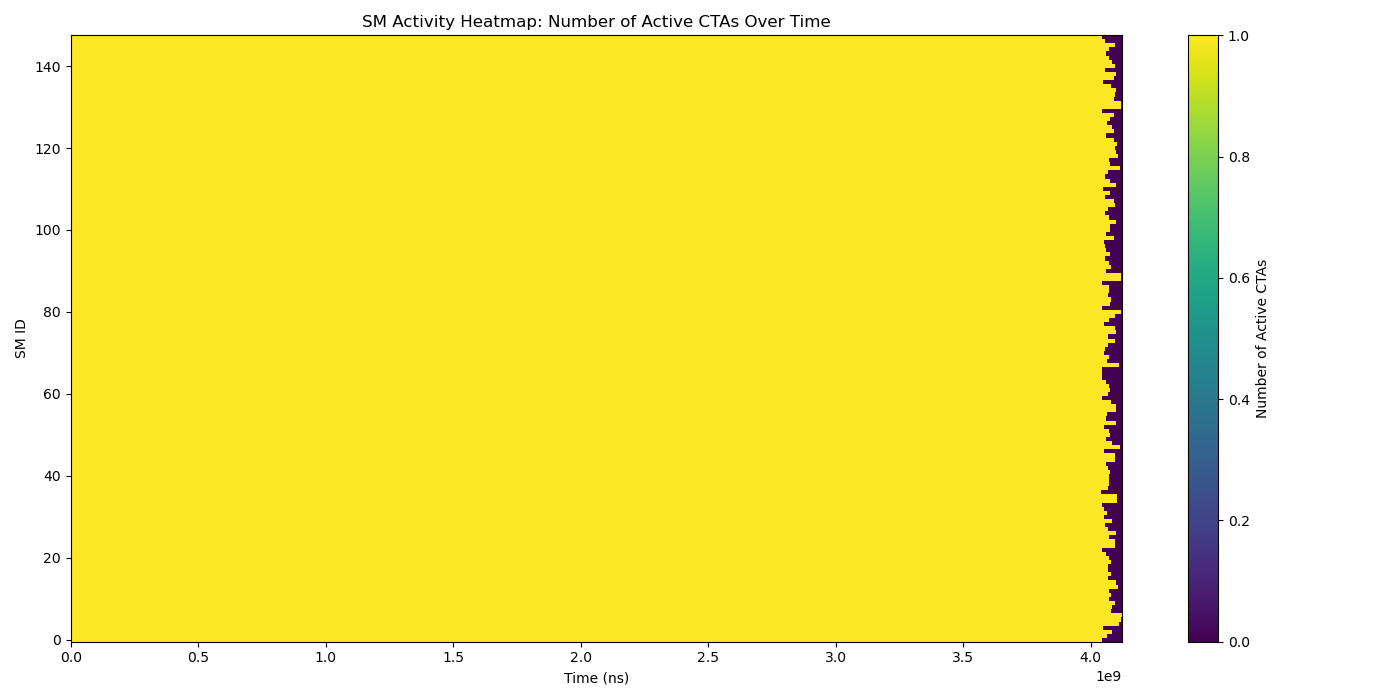
使用 CLC 时 CTAs 工作负载热力图
我们将 CLC 应用于前向和反向 kernel;在 TLX 中,它是基于共享调度上下文的一种轻量级生产者/消费者协议。
尽管软件负载均衡和 CLC 看起来可能冗余——两者都将工作分散到各 SM——但它们是互补的:CLC 动态调度,却无法分辨哪些 tile 是空的,因此在不规则(尤其是稀疏)输入上,它仍会花费周期分发由 padding 引入的哨兵/空 tile,而我们在主机端预计算有效 tile 会提前剪除这些。这就是为什么即使在支持 CLC 的 kernel 上,软件负载均衡仍然有价值。
多阶段 dQ 暂存
对反向传播的 Triton-MPP barrier 分析将 dQ epilogue 确定为第一大瓶颈:其对 HBM 的 reduce-add 约占 tensor-core 利用率损失的 9–11%,是单个最大的可操作缺口。有两点让它变慢。首先,由于 dQ 会在整个批次上求和,每个 SM 都会向相同的 dQ 位置发出 reduce-add——竞争激烈。其次,高层 reduce-add API 会将它们串行化——每个列切片的 add 必须完成后,下一个才能开始,没有流水线化。
我们将暂存显式化并采用双缓冲,使一个切片对 HBM 的 reduce-add 与下一个切片从 TMEM 的拷贝重叠,从而始终保持有一个 store 在途:
NCOL   = BLOCK_D // (EPILOGUE_SUBTILE * 2)   # narrow column slices, sized to fit SMEM
STAGES = 2                                   # double-buffered staging
dq_smem = tlx.local_alloc((BLOCK_M, NCOL), dq.dtype, STAGES)

for s in range(BLOCK_D // NCOL):
    # TMEM -> registers
    dq = tlx.local_load(dq_tmem[:, s * NCOL : (s + 1) * NCOL]) * LN2

    # registers -> SMEM (ping-pong)
    tlx.local_store(dq_smem[s % STAGES], dq.to(dq.dtype))
    tlx.fence_async_shared()

    tlx.async_descriptor_store(desc_dq, dq_smem[s % STAGES],
                               offsets, store_reduce="add")  # SMEM -> HBM, accumulating

    # keep at most 1 store in flight
    tlx.async_descriptor_store_wait(STAGES - 1)
该技术可推广到任何受共享内存限制的 reduce-store epilogue,而不仅限于 attention。
提前释放张量内存
同样的分析揭示了该收尾阶段为何会从 TMEM 侧阻塞数学运算:归约 warp 持有 dQ 张量内存缓冲区,直到其所有切片都被排空到 HBM,因此 MMA warp 在 dq-empty 屏障上阻塞,无法开始下一个 tile 的 dQ matmul。一个简单地移除 dQ 存储的瀑布测试证实了这一点,在不同序列长度上恢复了 +8–11% 的张量核心利用率。
改进方法是将最后一片或两片预加载到寄存器中,并在发出存储之前释放 TMEM 缓冲区,这样 MMA warp 可以在归约 warp 完成写入 HBM 的同时开始复用该内存:
# Drain most slices the normal way
# (TMEM -> SMEM -> async reduce-add to HBM).
for
s
in range
(N_SLICES - EARLY_RELEASE_SUBTILES):
    reduce_add_slice(s)
# Pre-load the final 1-2 slices into registers FIRST, then release
# the dQ TMEM buffer immediately
# so the MMA warp can start the next tile's dQ matmul.
dq_tail = tlx.local_load(dq_tmem[:, last_slice])
# TMEM -> registers
tlx.barrier_arrive(dq_empties[buf])
# <-- TMEM freed early
reduce_add_from_registers(dq_tail)
提前释放多少片是自动调优的(1 或 2);最优选择很小,因为释放更多会增加寄存器压力,足以造成损害。结合多阶段暂存,这使 MMA warp 可以在前一个 tile 的 dQ 仍在写出时开始下一个 dQ matmul。
循环剥离
NCU 分析显示前向是 MMA 发射饥饿——不是内存或计算受限——张量核心(TMEM)流水线利用率约为 57%,而 FA4 在相同形状上约为 82%,丢失的周期来自 softmax-warp 开销冒泡到 MMA 发射间隙中。因此,任何缩小或简化 softmax 主体的操作都能让 MMA warp 更早地接手工作。
两个信号指向了罪魁祸首。首先,ptxas 转储和 NCU 显示寄存器密集的 softmax warp 中存在寄存器溢出(本地内存流量)——在较早的一轮中,仅仅给 warp 分配更多寄存器就将该流量减少了约 40%,带来约 6% 的前向增益,证实了压力确实存在。其次,最严重的问题在于 KV 循环中每次迭代的掩码分支,它只在部分最后一个 tile 上才有意义。
这个分支代价高昂的原因很微妙,且特定于编译器分配寄存器的方式:Triton/TLX 静态地为变量分配寄存器,因此热循环内的掩码分支迫使编译器在整个循环中为仅在极少执行的掩码路径中使用的变量(列偏移、掩码张量、select)保留寄存器。这种永久保留增加了寄存器压力,并可能触发溢出——对寄存器密集的 softmax warp 尤其有害。
修复方法是将循环剥离为无分支的批量处理加上一个小的掩码尾部。由于掩码标志是编译时常量,批量主体完全不包含掩码变量,因此编译器可以释放这些寄存器并调度更紧凑的 MMA 发射节奏:
# APPLY_MASK is constexpr: with APPLY_MASK=False the compiler statically removes the
# comparison, the offs_n / mask tensors, and the select -> a branch-free body that
# does not reserve registers for the (rare) masked path.
aligned = (klen // BLOCK_N) * BLOCK_N
for
start_n
in
tl.
range
(lo, aligned, BLOCK_N):
# bulk: straight-line, no mask code
softmax_iter(start_n, ..., APPLY_MASK=False)
for
start_n
in
tl.
range
(aligned, klen, BLOCK_N):
# tail: 0 or 1 iteration
softmax_iter(start_n, ..., APPLY_MASK=True)
# mask only the partial last tile
我们对前向 softmax 循环和后向中寄存器密集的路径应用相同的剥离,收益并非来自跳过一个廉价的运行时分支,而是来自它所释放的寄存器压力减少;在后向中,它特别回收了正确性掩码否则会增加的约 9% 延迟。
2-CTA 协作 MMA(后向)
后向是 matmul 密集型的——计算 dQ、dK 和 dV 每个 K/V 块需要五次 GEMM——单个 CTA 无法独自充分利用 Blackwell 张量核心。我们采用 FA4 的 2-CTA(配对 CTA tcgen05)方案:集群中的两个 CTA 在同一 (batch, head) 的两个相邻 K/V 块上协作进行一个更宽的协作 matmul,将累加器行拆分到两个 SM 上,并通过分布式共享内存(DSMEM)而非全局内存交换 dS 中间结果。从两个 SM 馈送单个 MMA 提高了后向的张量核心利用率。
我们这里所做的是 TLX 实现:将该方案移植到我们的不规则、broadcast-Q 布局上,并在我们的持久化和 CLC 多 tile 调度器下运行。
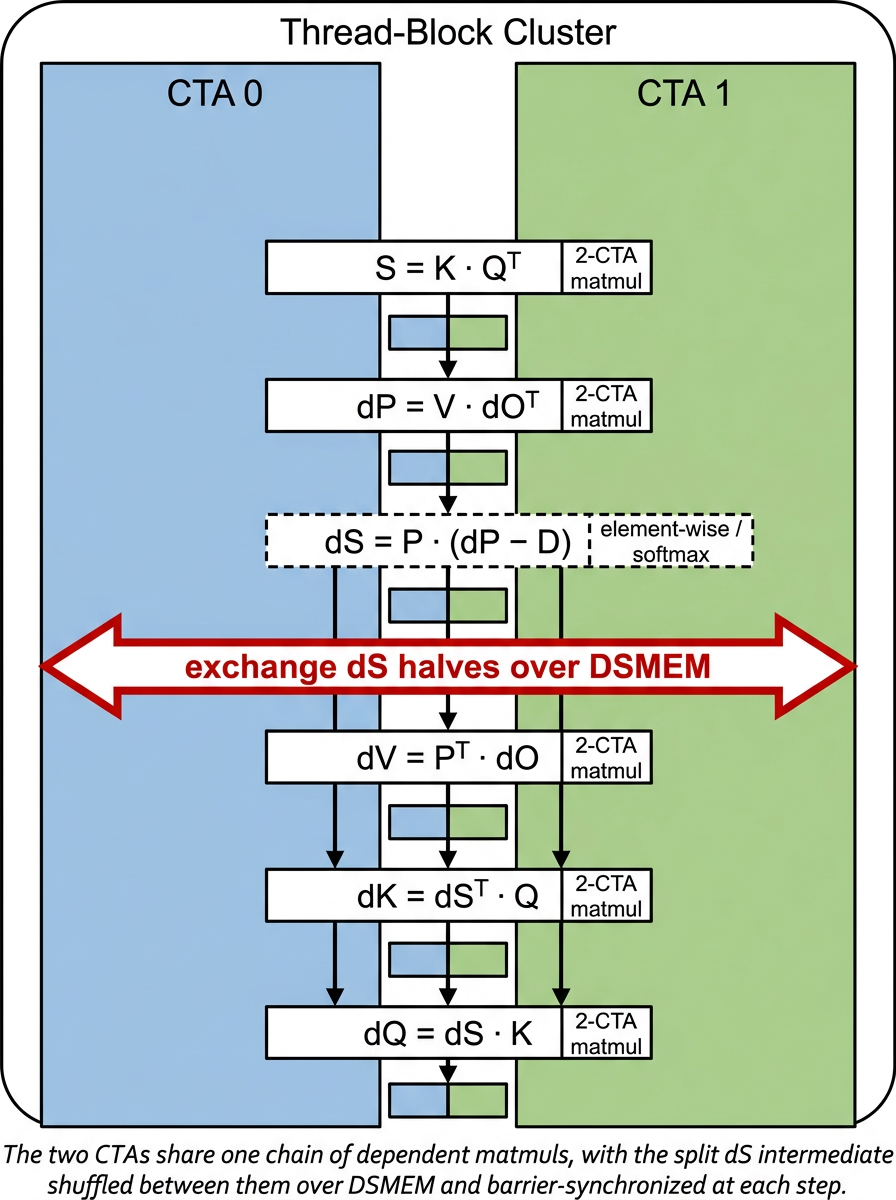
在生产环境的 broadcast-Q、HEAD_DIM=128 场景下,相比单 CTA 路径,它在反向传播中带来了约 +12% 的吞吐量提升(−11% 延迟)。
性能
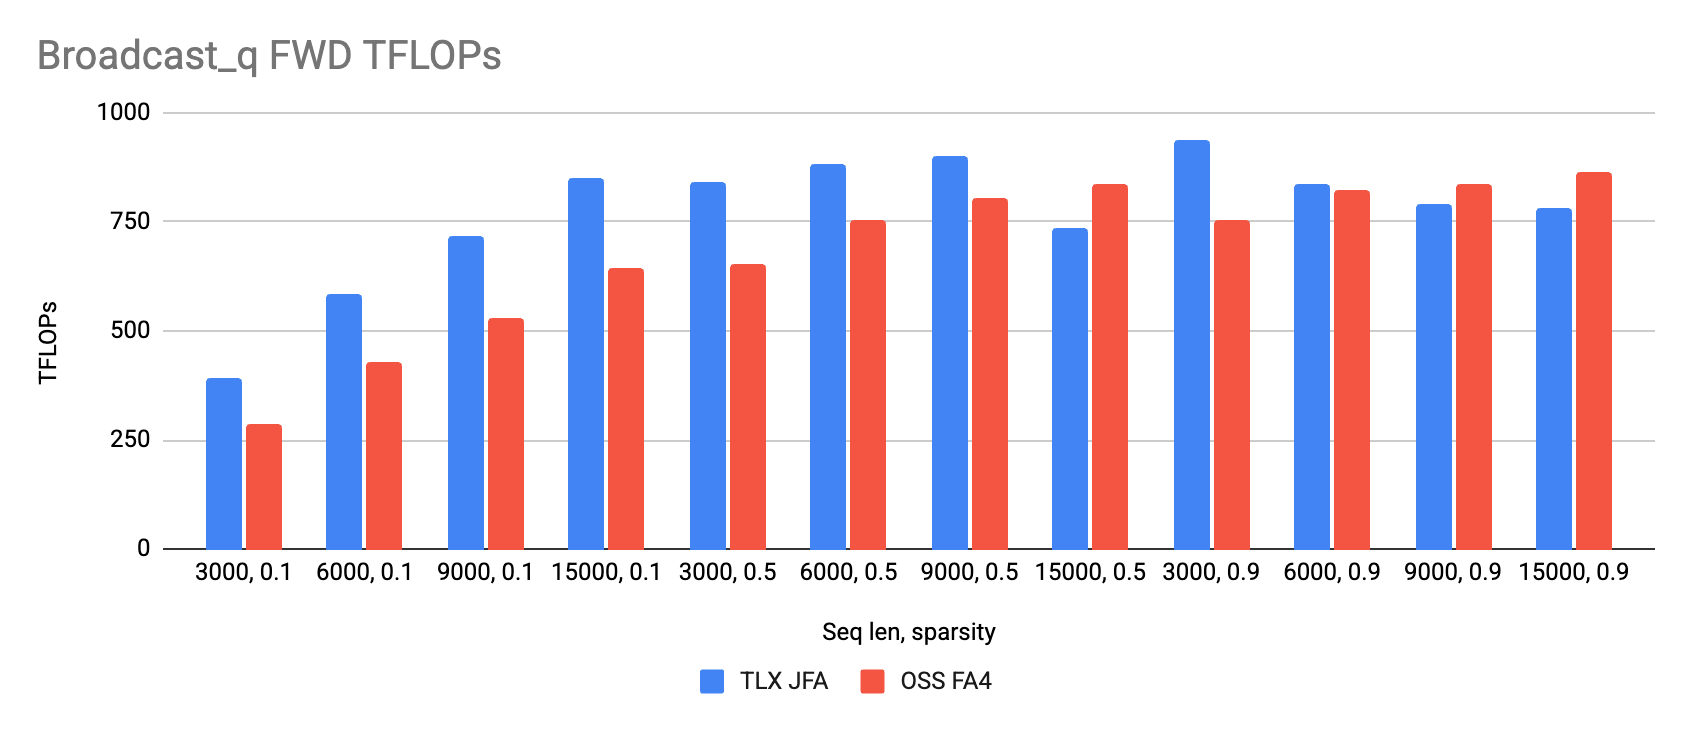
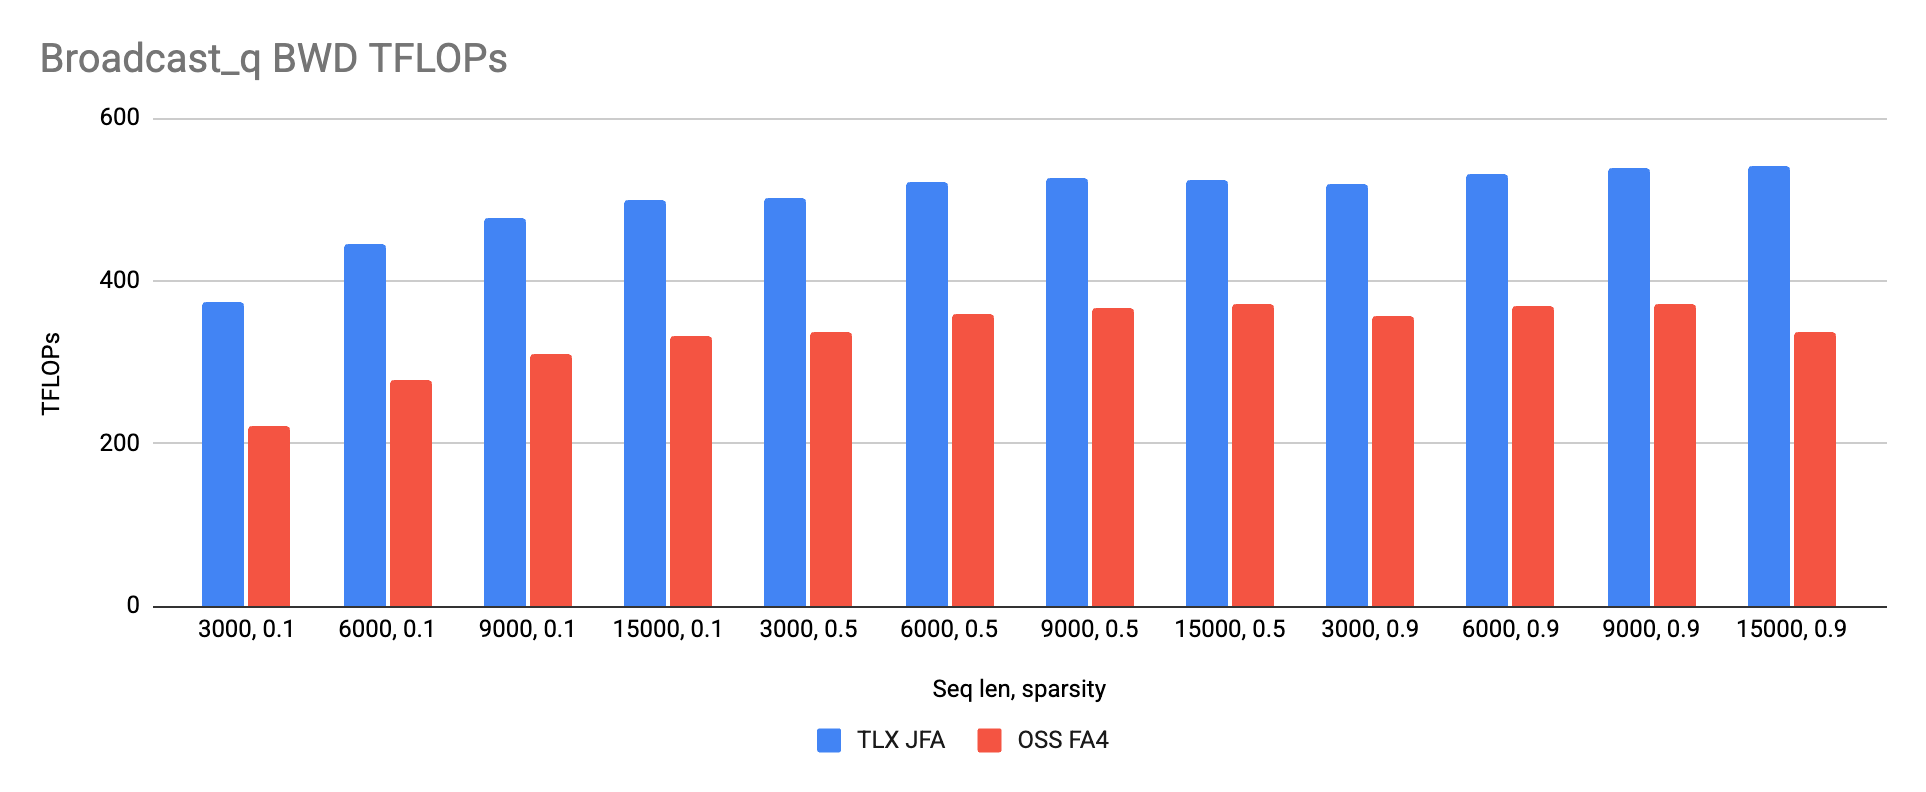
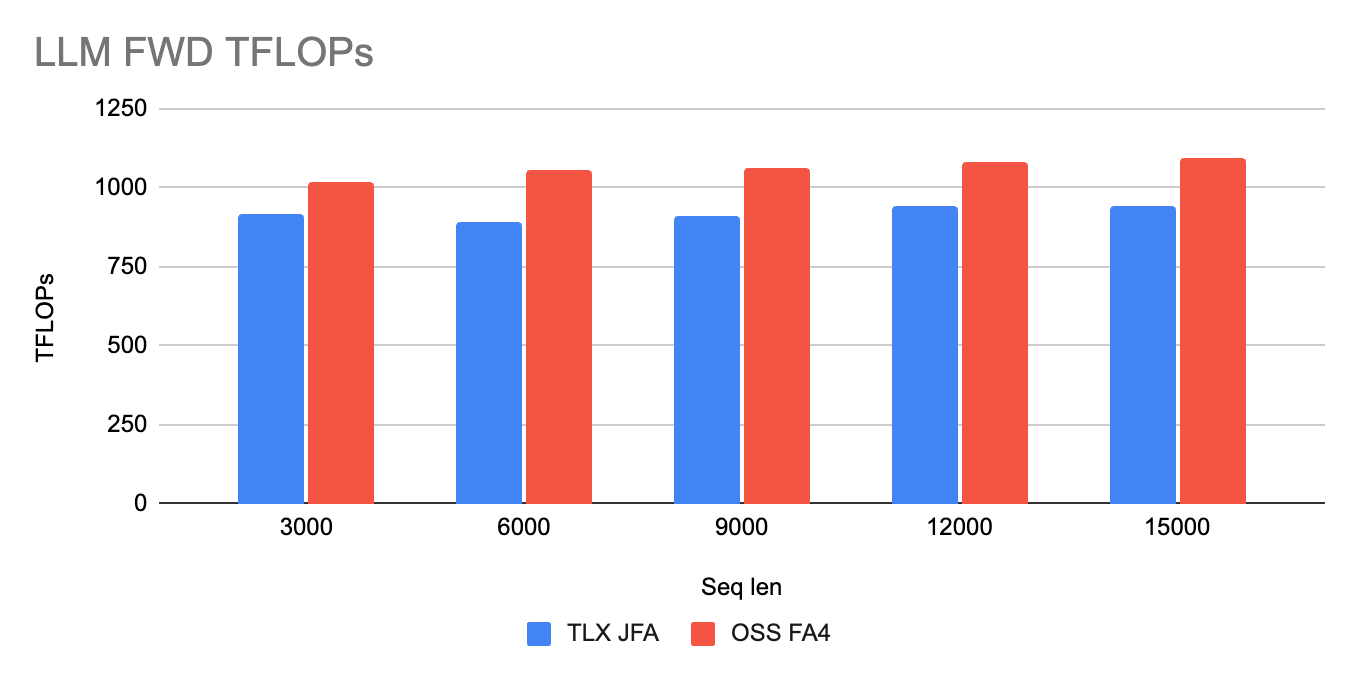
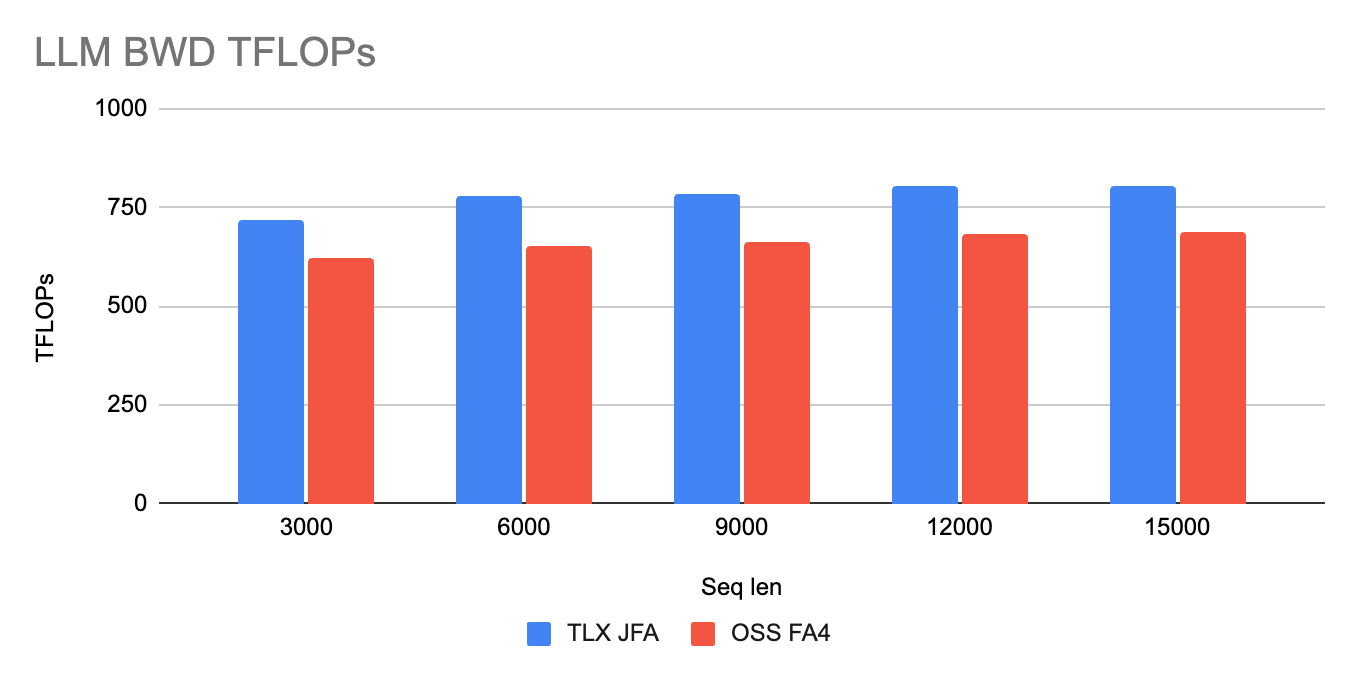
我们在 B200(bf16)上针对两种场景进行基准测试:生产环境的不规则场景(Hierarchical Seed Pooling (HSP)——broadcast 稠密 Q 对不规则 K/V)和 LLM 风格的稠密场景(等长 Q/K/V),两者均与 FA4 对比,FA4 是最先进的开源 CuteDSL FlashAttention-4 [6] 内核(2026 年 5 月版本)。在不规则形状上——即对广告至关重要的那些形状——TLX 在正向和反向传播中均优于 FA4:正向在大多数形状和稀疏度下更快(平均约 +13%,仅在高密度下最长序列上略逊),反向在所有情况下都更快,平均约 +50%。在稠密形状上,正向具有竞争力(约为 FA4 的 87%),而反向再次胜出(约 +17%)。不规则图表将稀疏度从 0.1(长度高度可变)扫到 0.5 再到 0.9(长度几乎均匀,1.0 表示所有序列长度相同)——这是生产环境中观察到的范围。
不规则(broadcast-Q)——正向 TFLOPS(bf16,B200)
不规则(broadcast-Q)——反向 TFLOPS(bf16,B200)
LLM 稠密——正向 TFLOPS(bf16,B200,B=768,H=4,head_dim=128)
LLM 稠密——反向 TFLOPS(bf16,B200,B=768,H=4,head_dim=128)
3. 注意力变体:TLX 的灵活性
基于 TLX 构建的一个实际好处是,内核的结构足够清晰,可以在不从头重写的情况下为满足新需求而分叉。由于 warp 特化、内存分配、屏障和调度都以可读的 Python 级代码编写一次,将内核重新定位到新的数值格式或新的注意力模式主要归结为更改数学部分,而非机制部分。两个变体可以说明这一点。
低精度(MXFP8)注意力
对于容忍 FP8 的训练,我们通过将 BF16 矩阵乘法替换为 TLX 的块缩放 MMA(FP8 E4M3 数据,E8M0 逐块缩放因子),构建了正向和反向的 microscaling-FP8 变体,复用了相同的 warp 特化骨架、屏障和 TMEM 布局。softmax 输出 P 被即时量化为 FP8,其缩放因子保存在张量内存中,以便块缩放 MMA 可以直接使用它们。
调优后,MXFP8 前向性能超过 FA4 自身的 FP8 kernel,反向在 dense 场景下与 FA4 持平——两者都轻松超越 BF16 基线——这一大幅吞吐量提升主要来自更改 GEMM 调用,而非 kernel 结构。
块稀疏注意力
对于完整 O(N²) 注意力占主导的长不规则历史序列,我们构建了一个两阶段稀疏变体 [4]。一个低成本评分 kernel 对每个 Q 和 K 块进行平均池化,并为每个 Q 块选择 top-k 最相关的 KV 块(可调的选择比例);随后一个 TLX 注意力 kernel——从 dense 版本 fork 而来并添加了逐 tile 稀疏块迭代——仅对选中的块运行注意力。
它复用了相同的 warp 特化结构、CLC 调度和软件负载均衡(此处用于跳过未选中和空的 tile),保持 PT2 友好,并且仍然支持 broadcast-Q、GQA 和窗口化。在选择比例为 0.5 时,前向在我们测试的序列长度上比 dense 快约 1.3–1.5 倍。
在这两种情况下,kernel 的主体部分基本保持不变;不同的只是数学部分——GEMM 精度,或每个 tile 访问的 KV 块集合。这种复用正是 TLX 的实际收益:同一个 kernel 可以在 Python 层面重新定位到新的精度和稀疏模式,而无需下沉到手写 CUDA。
4. 总结与未来工作
结构性变更——warp 特化、持久化执行、带复用别名的显式 SMEM/TMEM 分配,以及屏障介导的流水线——奠定了基础,而在此基础上叠加的优化——软件负载均衡、Cluster Launch Control、多阶段 dQ 暂存、TMEM 提前释放、循环剥离和 2-CTA 协作 MMA——回收了剩余的大部分性能空间。它们共同使 TLX kernel 在生产不规则形状上两个 pass 均能匹配或超越 FA4,同时保留完整的 broadcast-Q、滑动窗口和 GQA 支持。
除了原始性能之外,最大的收益是开发效率。CuteDSL 手工编写的许多底层管道——异步流水线、屏障管理、tcgen05 MMA 设置——改由 TLX 编译器处理,因此我们表达的是意图而非机制,代码量仅为一小部分。这种杠杆效应使团队能够快速原型设计、分析和落地上述每一项优化,然后以极少的额外代码将同一 kernel fork 为 MXFP8 和块稀疏变体。综合来看——在不规则 Ads 形状上两个 pass 都更快、在 dense 上具有竞争力,且构建和维护成本低得多——TLX JFA 比 SOTA 开源 FA4 更适合我们的 Ads 模型。
参考文献
[1] TLX: Enabling Cluster Launch Control with Triton — https://pytorch.org/blog/enabling-cluster-launch-control-with-tlx/
[2] GEM: Meta’s Generative Ads Model — https://engineering.fb.com/2025/11/10/ml-applications/metas-generative-ads-model-gem-the-central-brain-accelerating-ads-recommendation-ai-innovation/
[3] NVIDIA Blackwell Tuning Guide (thread-block clusters) — https://docs.nvidia.com/cuda/blackwell-tuning-guide/index.html#thread-block-clusters
[4] TLX Block Attention:一种面向固定块稀疏自注意力的 Warp 专用 Blackwell 内核 — https://pytorch.org/blog/tlx-block-attention-a-warp-specialized-blackwell-kernel-for-fixed-block-sparse-self-attention/
[5] Kunlun:通过统一架构设计为大规模推荐系统建立缩放定律 — https://arxiv.org/abs/2602.10016
[6] FlashAttention-4:面向非对称硬件扩展的算法与内核流水线协同设计 — https://arxiv.org/abs/2603.05451
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PyTorch Blog
原文作者:bsterling;如有侵权,请联系管理员删除。

