理解卷积神经网络初学者指南 第2部分
这是卷积神经网络全面入门介绍的第二部分。阅读完第一部分后,请继续阅读。
编者注:在继续阅读之前,您可能想先查看本教程的第1部分。
引言
在这篇文章中,我们将深入探讨ConvNets的更多细节。免责声明:我意识到其中一些主题相当复杂,完全可以单独成文。为了保持简洁同时兼顾全面性,我将提供研究论文的链接,以便更详细地解释这些主题。
步长与填充
好的,让我们回顾一下我们熟悉的卷积层。还记得滤波器、感受野、卷积吗?很好。现在,有2个主要参数可以改变以修改每一层的行为。在选择滤波器大小之后,我们还需要选择步长和填充。
步长控制滤波器如何在输入体积上卷积。在第1部分的示例中,滤波器通过在输入体积上每次移动一个单位来进行卷积。滤波器移动的量就是步长。在那种情况下,步长隐式设置为1。步长通常设置为使输出体积为整数而非分数的值。让我们看一个例子。假设有一个7 x 7的输入体积,一个3 x 3的滤波器(为简单起见忽略第3维),步长为1。这是我们习惯的情况。
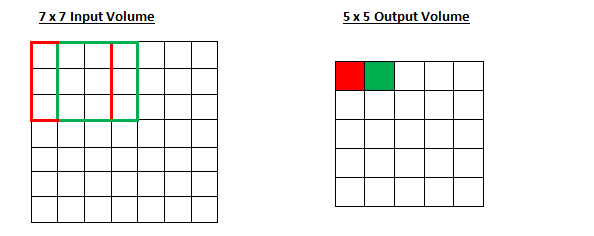
老样子,对吧?看看你能否猜出当步长增加到2时输出体积会发生什么变化。
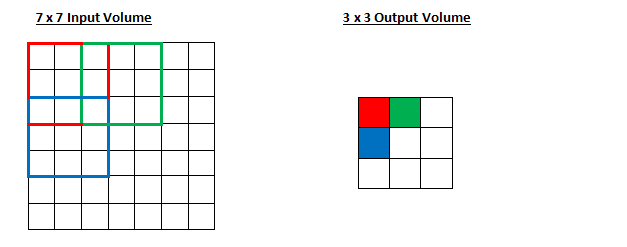
所以,如你所见,感受野现在移动了2个单位,输出体积也缩小了。注意,如果我们尝试将步长设置为3,那么在间距和确保感受野适配输入体积方面就会遇到问题。通常,如果程序员希望感受野重叠更少并且希望空间维度更小,他们会增加步长。
现在,让我们来看看填充。在深入之前,让我们思考一个场景。当你将三个5 x 5 x 3的滤波器应用于一个32 x 32 x 3的输入体积时会发生什么?输出体积将是28 x 28 x 3。注意空间维度减小了。随着我们不断应用卷积层,体积的大小将比我们希望的速度更快地减小。在网络的前几层中,我们希望尽可能保留原始输入体积的信息,以便提取那些低级特征。假设我们想应用相同的卷积层,但希望输出体积保持为32 x 32 x 3。为此,我们可以对该层应用大小为2的零填充。零填充在输入体积的边界周围用零进行填充。如果我们考虑大小为2的零填充,那么这将导致输入体积变为36 x 36 x 3。
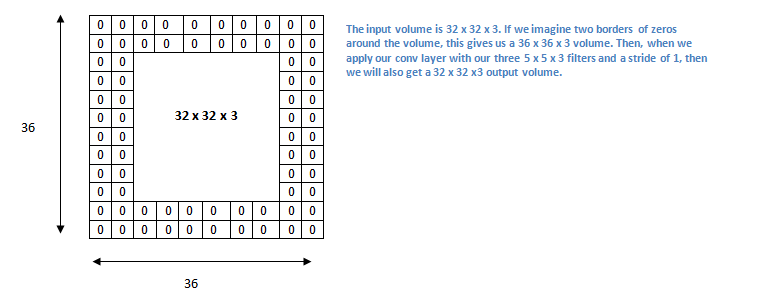
如果步长为 1,并且将零填充的大小设置为
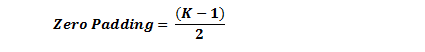
其中 K 是滤波器大小,那么输入和输出体积将始终具有相同的空间维度。
计算任意给定卷积层输出大小的公式是
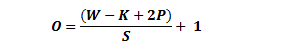
其中 O 是输出高度/长度,W 是输入高度/长度,K 是滤波器大小,P 是填充,S 是步长。
选择超参数
我们如何知道要使用多少层、多少个卷积层、滤波器大小是多少,或者步长和填充的值是多少?这些都不是简单的问题,也没有所有研究人员都使用的固定标准。这是因为网络在很大程度上取决于你所拥有的数据类型。数据可能因大小、图像复杂度、图像处理任务类型等因素而有所不同。在查看数据集时,思考如何选择超参数的一种方法是找到正确的组合,以适当的尺度创建图像的抽象。
ReLU(修正线性单元)层
在每个卷积层之后,按照惯例会立即应用一个非线性层(或激活层)。这一层的目的是向一个基本上在卷积层期间只进行线性运算(只是逐元素乘法和求和)的系统引入非线性。过去,人们使用 tanh 和 sigmoid 等非线性函数,但研究人员发现 ReLU 层效果要好得多,因为网络能够训练得快得多(由于计算效率),而不会对准确率产生显著影响。它还有助于缓解梯度消失问题,即网络的较低层训练得非常缓慢,因为梯度在穿过各层时呈指数下降(解释这一点可能超出了本文的范围,但请参见这里和这里以获得很好的描述)。ReLU 层将函数 f(x) = max(0, x) 应用于输入体积中的所有值。简单来说,这一层只是将所有负激活值改为 0。这一层增加了模型和整个网络的非线性特性,而不影响卷积层的感受野。
由伟大的 Geoffrey Hinton(又名深度学习之父)撰写的论文。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

