4种改进TensorFlow模型的方法——你需要了解的关键正则化技术
正则化技术对于防止模型过拟合至关重要,并能使其在验证集和测试集上表现更好。本指南通过代码全面概述了在TensorFlow中可用于正则化的四种关键方法。
照片由Jungwoo Hong在Unsplash上拍摄。
正则化
根据维基百科,
在数学、统计学和计算机科学中,特别是在机器学习和逆问题领域,正则化是通过添加信息来解决不适定问题或防止过拟合的过程。
这意味着我们添加一些额外信息来解决问题并防止过拟合。
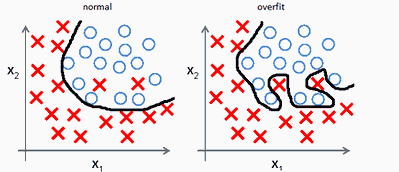
过拟合简单来说就是我们的机器学习模型在一些数据上训练,它在该数据上表现极好,但无法泛化到新的未见示例上。
我们可以在这个简单例子中看到过拟合
http://mlwiki.org/index.php/Overfitting
我们的数据严格依附于训练示例。这导致在测试/开发集上表现不佳,而在训练集上表现良好。
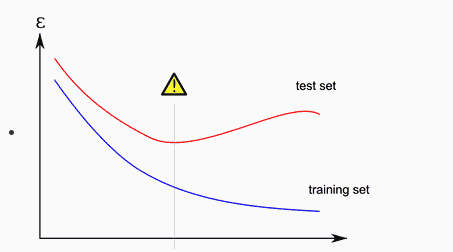
http://mlwiki.org/index.php/Overfitting
因此,为了提高模型的性能,我们使用不同的正则化技术。有几种技术,但我们将讨论4种主要技术。
L1 正则化
L2 正则化
Dropout
批量归一化
我将简要解释这些技术的工作原理以及如何在 Tensorflow 2 中实现它们。
为了对这些技术的工作原理和原因有良好的直觉,我推荐您观看 Andrew NG 教授关于所有这些主题的讲座,这些讲座在 Youtube 上很容易找到。
首先,我将编写一个没有正则化的模型,然后我将展示如何通过添加不同的正则化技术来改进它。我们将使用 IRIS 数据集来展示使用正则化可以大大改进同一个模型。
无正则化的模型
基本预处理
模型构建
Model: "sequential"
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
dense_6 (Dense)              (None, 512)               2560
_________________________________________________________________
dense_7 (Dense)              (None, 256)               131328
_________________________________________________________________
dense_8 (Dense)              (None, 128)               32896
_________________________________________________________________
dense_9 (Dense)              (None, 64)                8256
_________________________________________________________________
dense_10 (Dense)             (None, 32)                2080
_________________________________________________________________
dense_11 (Dense)             (None, 3)                 99
=================================================================
Total params: 177,219
Trainable params: 177,219
Non-trainable params: 0
_________________________________________________________________
训练模型后,如果我们使用 Tensorflow 中的以下代码评估模型,我们可以在测试集上找到我们的准确率、损失和 mse。
loss1, acc1, mse1 = model1.evaluate(X_test, y_test)
print(f"Loss is {loss1},\nAccuracy is {acc1*100},\nMSE is {mse1}")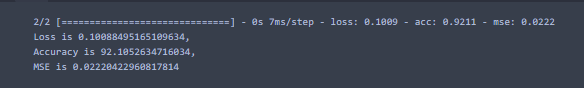
让我们检查验证损失和训练损失的图表。
import matplotlib.pyplot as plt
plt.style.use('ggplot')
plt.plot(hist.history['loss'], label = 'loss')
plt.plot(hist.history['val_loss'], label='val loss')
plt.title("Loss vs Val_Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.legend()
plt.show()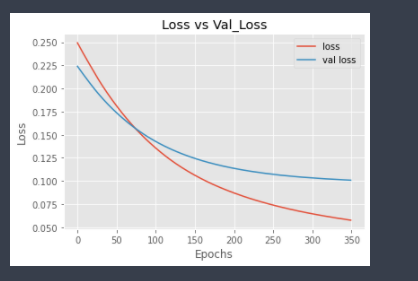
在这里,我们可以看到验证损失在约 60 个 epoch 后与训练损失相比逐渐增加。这表明我们的模型过拟合了。
同样地,对于模型准确率图,
plt.plot(hist.history['acc'], label = 'acc')
plt.plot(hist.history['val_acc'], label='val acc')
plt.title("acc vs Val_acc")
plt.xlabel("Epochs")
plt.ylabel("acc")
plt.legend()
plt.show()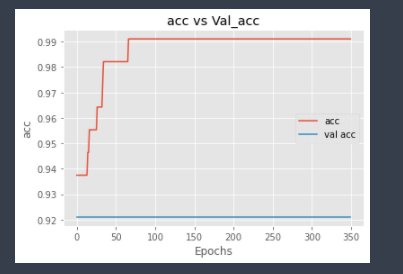
这再次表明验证准确率低于训练准确率,这同样显示出过拟合的迹象。
L1 正则化:
一种常用的正则化技术是 L1 正则化,也称为 Lasso 正则化。
L1 正则化的主要概念是,我们必须通过在损失函数中加入权重的绝对值乘以正则化参数 lambda λ 来惩罚权重,其中 λ 被手动调整为大于 0。
L1 的公式为
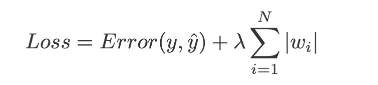
图片来源:Towards Data Science。
在这里,我们添加了一个额外的参数 kernel_regularizer,我们将其设置为 'l1' 以进行 L1 正则化。
现在让我们评估并绘制模型。
loss2, acc2, mse2 = model2.evaluate(X_test, y_test)
print(f"Loss is {loss2},\nAccuracy is {acc2 * 100},\nMSE is {mse2}")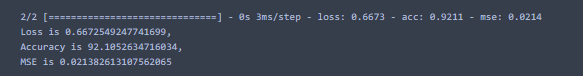
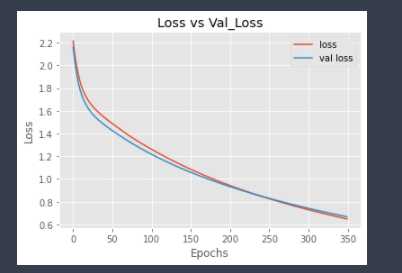
嗯,准确率几乎相同,让我们检查图表以获得更好的直观理解。
plt.plot(hist2.history[‘loss’], label = ‘loss’)
plt.plot(hist2.history[‘val_loss’], label=’val loss’)
plt.title(“Loss vs Val_Loss”)
plt.xlabel(“Epochs”)
plt.ylabel(“Loss”)
plt.legend()
plt.show()
plt.figure(figsize=(15,8))
plt.plot(hist2.history['acc'], label = 'acc')
plt.plot(hist2.history['val_acc'], label='val acc')
plt.title("acc vs Val_acc")
plt.xlabel("Epochs")
plt.ylabel("acc")
plt.legend()
plt.show()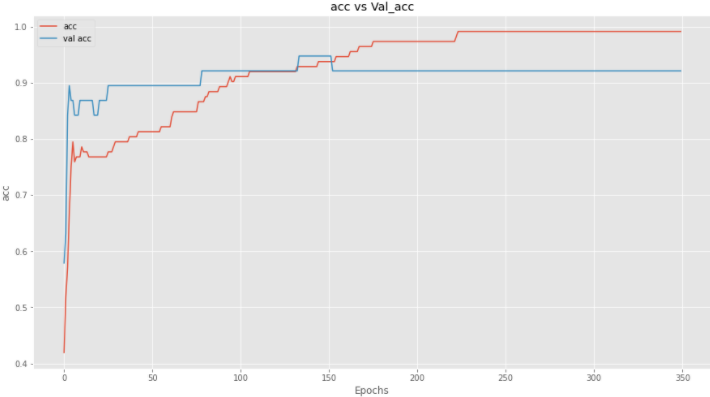
嗯,我想这算是不错的改进,因为验证损失不再像之前那样增加得那么多,但验证准确率并没有提高多少。让我们在更多层中添加 l1,以检查是否能改善模型。
model3 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape, kernel_regularizer='l1'),
    Dense(512//2, activation='tanh', kernel_regularizer='l1'),
    Dense(512//4, activation='tanh', kernel_regularizer='l1'),
    Dense(512//8, activation='tanh', kernel_regularizer='l1'),
    Dense(32, activation='relu', kernel_regularizer='l1'),
    Dense(3, activation='softmax')
])
model3.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist3 = model3.fit(X_train, y_train, epochs=350, batch_size=128, validation_data=(X_test,y_test), verbose=2)
训练后,让我们评估模型。
loss3, acc3, mse3 = model3.evaluate(X_test, y_test)
print(f"Loss is {loss3},\nAccuracy is {acc3 * 100},\nMSE is {mse3}")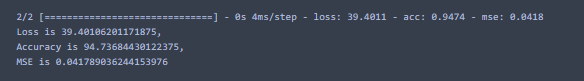
嗯,现在准确率有了相当大的提升,从92跃升到了94。让我们来看看图表。
plt.figure(figsize=(15,8))
plt.plot(hist3.history['loss'], label = 'loss')
plt.plot(hist3.history['val_loss'], label='val loss')
plt.title("Loss vs Val_Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.legend()
plt.show()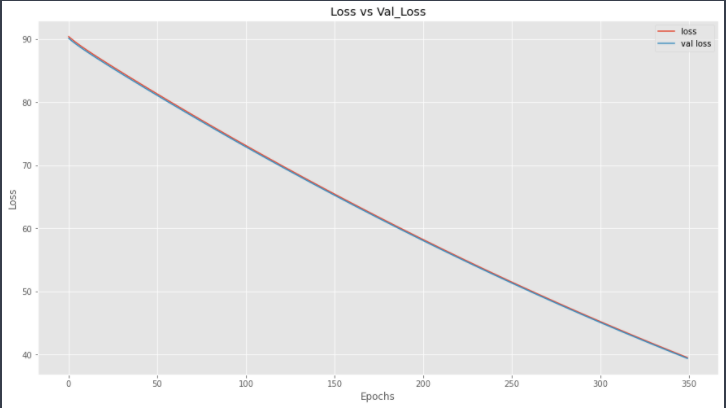
现在,两条线大致重合,这意味着我们的模型在测试集上的表现与在训练集上的表现一样好。
plt.figure(figsize=(15,8))
plt.plot(hist3.history['acc'], label = 'ACC')
plt.plot(hist3.history['val_acc'], label='val acc')
plt.title("acc vs Val_acc")
plt.xlabel("Epochs")
plt.ylabel("acc")
plt.legend()
plt.show()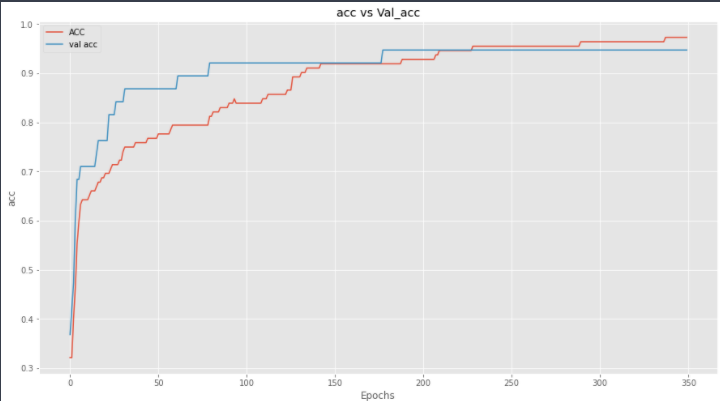
我们可以看到,与训练损失相比,模型的验证损失并没有增加,同时验证准确率也在提高。
L2正则化
L2正则化是另一种正则化技术,也被称为岭回归(Ridge regularization)。在L2正则化中,我们通过添加权重的平方幅度来惩罚损失函数。
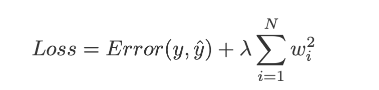
图片来源:Towards Data Science。
model5 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape, kernel_regularizer='l2'),
    Dense(512//2, activation='tanh'),
    Dense(512//4, activation='tanh'),
    Dense(512//8, activation='tanh'),
    Dense(32, activation='relu'),
    Dense(3, activation='softmax')
])
model5.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist5 = model5.fit(X_train, y_train, epochs=350, batch_size=128, validation_data=(X_test,y_test), verbose=2)
训练后,让我们评估模型。
loss5, acc5, mse5 = model5.evaluate(X_test, y_test)
print(f"Loss is {loss5},\nAccuracy is {acc5 * 100},\nMSE is {mse5}")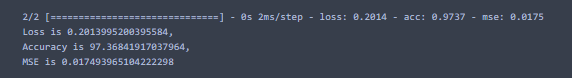
这里我们可以看到验证准确率为97%,相当不错。让我们绘制图表以获得更直观的理解。
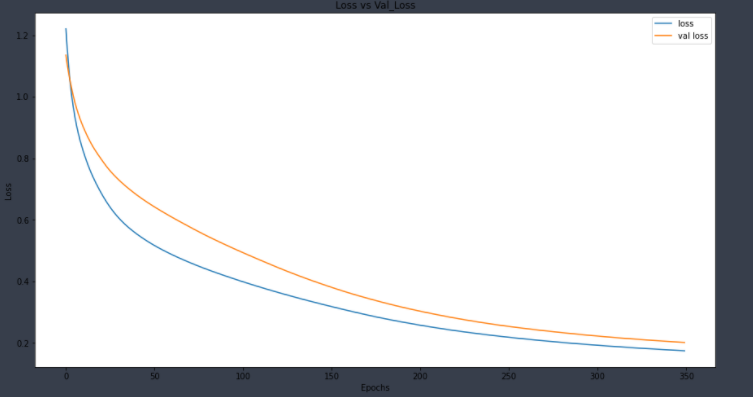
这里我们可以看到,我们的数据并没有过拟合。让我们绘制准确率图表。
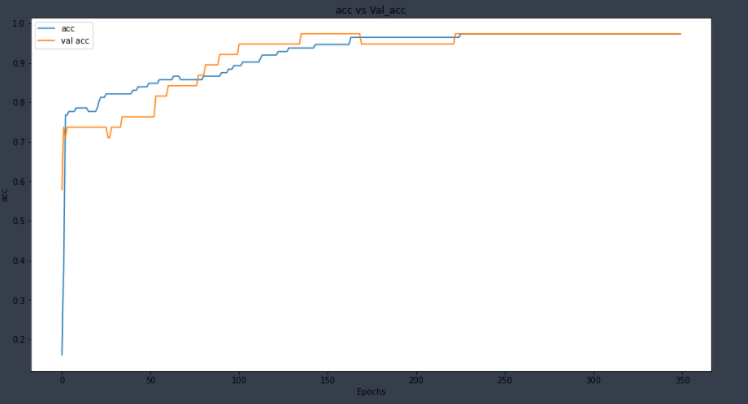
仅在1层中添加“L2”正则化就已经大幅提升了我们的模型。
现在让我们在所有其他层中添加L2。
model6 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape, kernel_regularizer='l2'),
    Dense(512//2, activation='tanh', kernel_regularizer='l2'),
    Dense(512//4, activation='tanh', kernel_regularizer='l2'),
    Dense(512//8, activation='tanh', kernel_regularizer='l2'),
    Dense(32, activation='relu', kernel_regularizer='l2'),
    Dense(3, activation='softmax')
])
model6.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist6 = model6.fit(X_train, y_train, epochs=350, batch_size=128, validation_data=(X_test,y_test), verbose=2)
这里我们在所有层中都使用了L2。训练后,让我们对其进行评估。
loss6, acc6, mse6 = model6.evaluate(X_test, y_test)
print(f"Loss is {loss6},\nAccuracy is {acc6 * 100},\nMSE is {mse6}")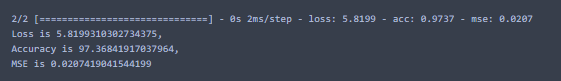
让我们绘制图表以获得更多直观理解。
plt.figure(figsize=(15,8))
plt.plot(hist6.history['loss'], label = 'loss')
plt.plot(hist6.history['val_loss'], label='val loss')
plt.title("Loss vs Val_Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.legend()
plt.show()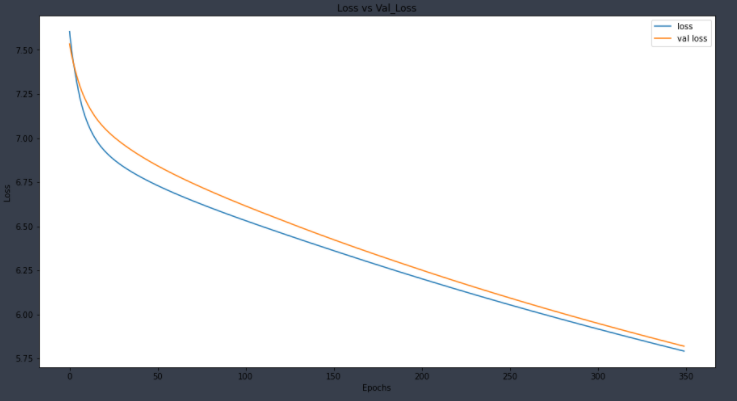
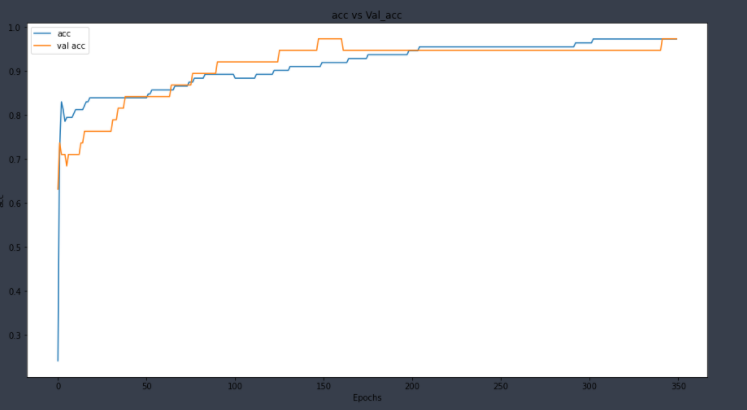
我们可以看到这个模型表现良好,并且没有对数据集过拟合。
Dropout
另一种常见的避免正则化的方法是使用 Dropout 技术。使用 dropout 的主要思想是我们根据一定的概率随机关闭层中的一些神经元。你可以通过吴恩达教授的视频在这里了解更多关于其工作原理的内容。
让我们在 Tensorflow 中编写代码。
之前所有的导入都是相同的,我们只是在这里添加了一个额外的导入。
为了实现 DropOut,我们所要做的就是从 tf.keras.layers 添加一个 Dropout 层,并在其中设置一个 dropout 率。
import tensorflow as tf
model7 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape),
    tf.keras.layers.Dropout(0.5), #dropout with 50% rate
    Dense(512//2, activation='tanh'),

    Dense(512//4, activation='tanh'),
    Dense(512//8, activation='tanh'),
    Dense(32, activation='relu'),
    Dense(3, activation='softmax')
])
model7.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist7 = model7.fit(X_train, y_train, epochs=350, batch_size=128, validation_data=(X_test,y_test), verbose=2)
训练后,让我们在测试集上评估它。
loss7, acc7, mse7 = model7.evaluate(X_test, y_test)
print(f"Loss is {loss7},\nAccuracy is {acc7 * 100},\nMSE is {mse7}")
哇,我们的结果非常有希望,我们在测试集上达到了 97%。让我们绘制损失和准确率以获得更好的直观理解。
plt.figure(figsize=(15,8))
plt.plot(hist7.history['loss'], label = 'loss')
plt.plot(hist7.history['val_loss'], label='val loss')
plt.title("Loss vs Val_Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.legend()
plt.show()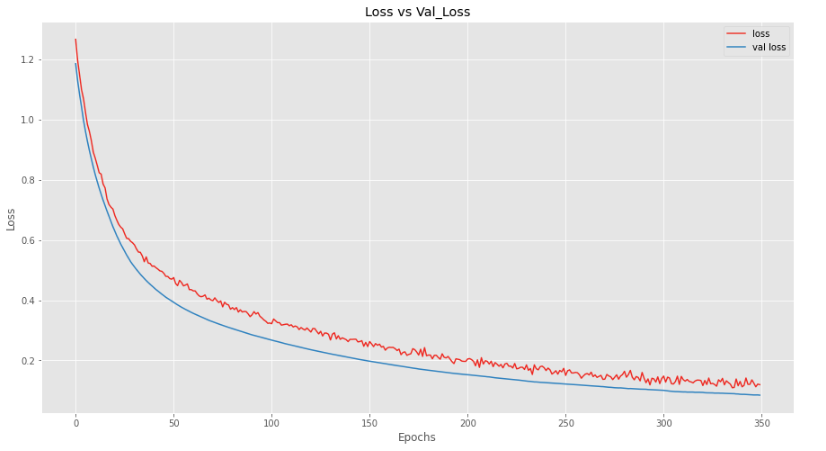
在这里,我们可以看到我们的模型在验证数据上的表现比训练数据更好,这是个好消息。
现在让我们绘制准确率。
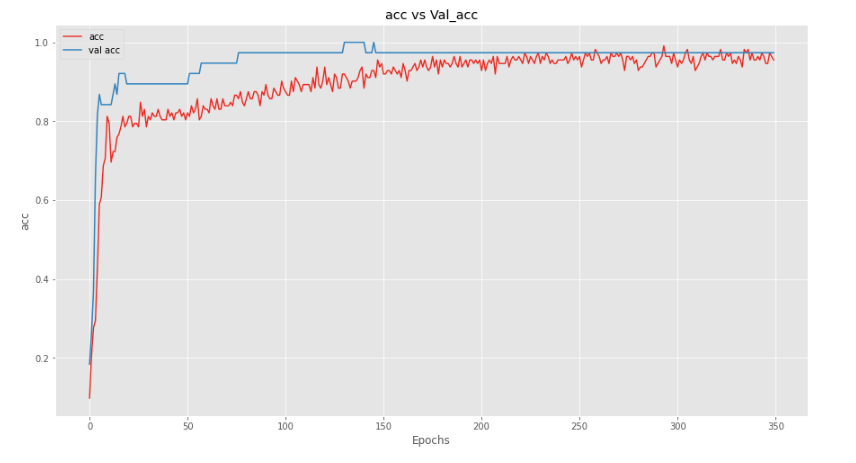
我们可以看到我们的模型在验证数据集上的表现比训练集更好。
让我们添加更多的 dropout 层,看看模型的表现如何。
model8 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape),
    tf.keras.layers.Dropout(0.5),
    Dense(512//2, activation='tanh'),
    tf.keras.layers.Dropout(0.5),
    Dense(512//4, activation='tanh'),
    tf.keras.layers.Dropout(0.5),
    Dense(512//8, activation='tanh'),
    tf.keras.layers.Dropout(0.3),
    Dense(32, activation='relu'),
    Dense(3, activation='softmax')
])
model8.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist8 = model8.fit(X_train, y_train, epochs=350, batch_size=128, validation_data=(X_test,y_test), verbose=2)
loss8, acc8, mse8 = model8.evaluate(X_test, y_test)
print(f"Loss is {loss8},\nAccuracy is {acc8 * 100},\nMSE is {mse8}")
这个模型也非常好,因为它在测试集上达到了 98% 的表现。让我们绘制图表以获得更好的直观理解。
plt.figure(figsize=(15,8))
plt.plot(hist8.history['loss'], label = 'loss')
plt.plot(hist8.history['val_loss'], label='val loss')
plt.title("Loss vs Val_Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.legend()
plt.show()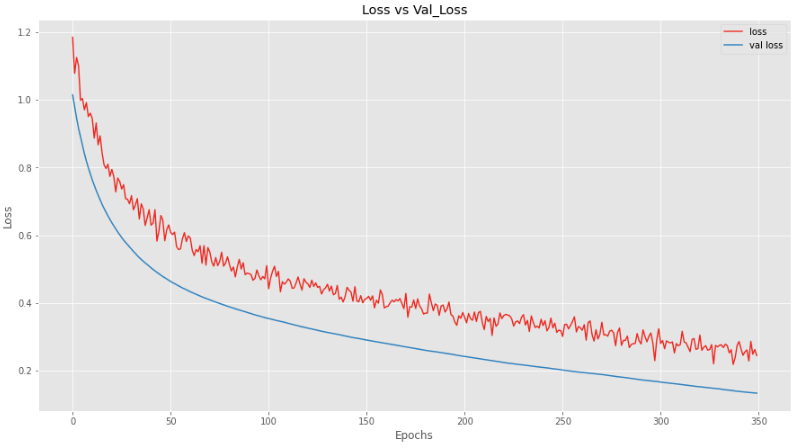
我们可以看到,添加更多的 dropout 层会使模型在训练时的表现略微下降,但在验证集上,它的表现非常好。
现在让我们绘制准确率图表。
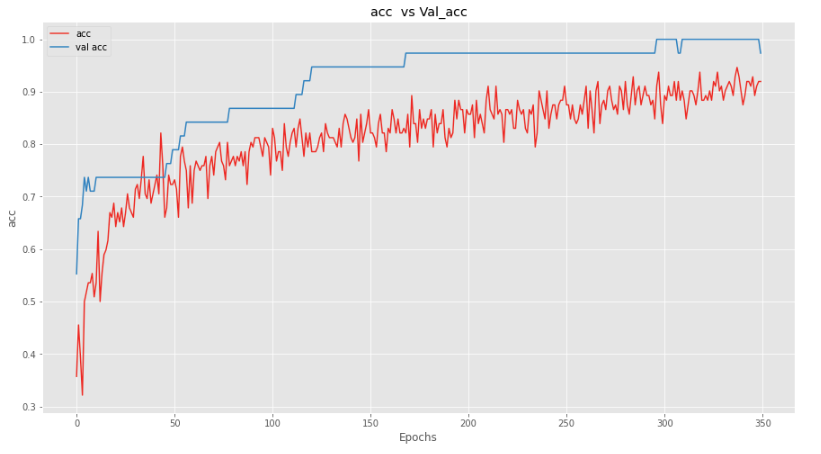
我们可以看到同样的模式,即我们的模型在训练时表现不那么好,但在评估时,它的表现非常好。
批量归一化
批量归一化的主要思想是,我们通过使用几种技术(在我们的例子中是 sklearn.preprocessing.StandardScaler)来归一化输入层,从而提高模型性能,所以如果输入层受益于归一化,为什么不归一化隐藏层呢?这将进一步改进和加速学习。
要学习数学并获得更多直观理解,我将再次引导你到 NG 教授的讲座这里和这里。
要将其添加到你的 TensorFlow 模型中,只需在你的层之后添加 tf.keras.layers.BatchNormalization()。
model9 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape),
    Dense(512//2, activation='tanh'),
    tf.keras.layers.BatchNormalization(),
    Dense(512//4, activation='tanh'),
    Dense(512//8, activation='tanh'),
    Dense(32, activation='relu'),
    Dense(3, activation='softmax')
])
model9.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist9 = model9.fit(X_train, y_train, epochs=350,  validation_data=(X_test,y_test), verbose=2)
在这里,如果你注意到我已经移除了 batch_size 选项。这是因为在仅使用 tf.keras.BatchNormalization() 作为正则化时添加 batch_size 参数,会导致模型性能非常差。我试图在互联网上找到原因,但未能找到。如果你真的想在训练时使用 batch_size,你也可以将优化器从 sgd 更改为 rmsprop 或 adam。
训练后,让我们评估模型。
loss9, acc9, mse9 = model9.evaluate(X_test, y_test)
print(f"Loss is {loss9},\nAccuracy is {acc9 * 100},\nMSE is {mse9}")
1 个批量归一化的验证准确率与其他技术相比并不那么好。让我们绘制损失和准确率图表以获得更好的直观理解。
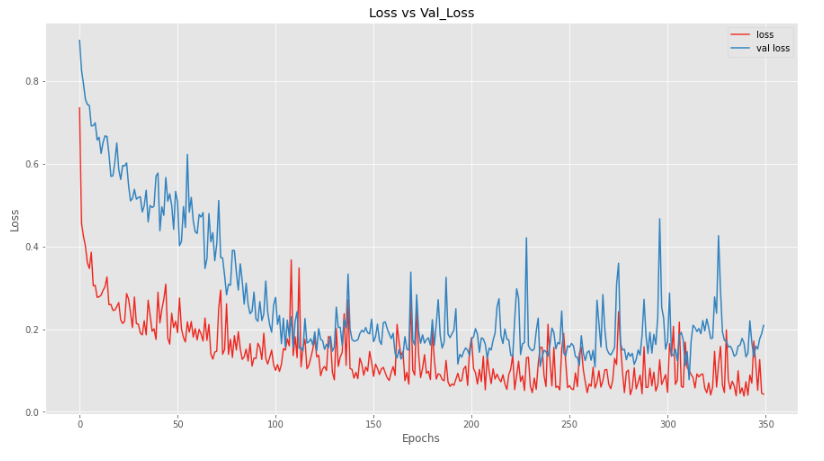
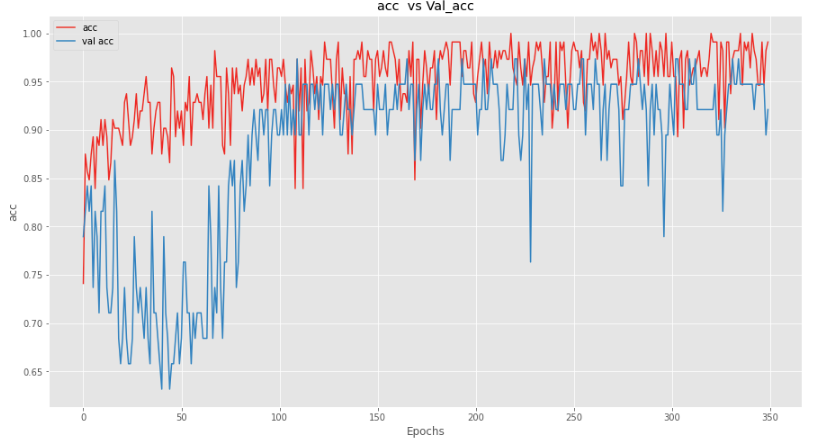
在这里我们可以看到,我们的模型在验证集上的表现不如在测试集上。让我们为所有层添加归一化,看看结果如何。
model11 = Sequential([
    Dense(512, activation='tanh', input_shape = X_train[0].shape),
    tf.keras.layers.BatchNormalization(),
    Dense(512//2, activation='tanh'),
    tf.keras.layers.BatchNormalization(),
    Dense(512//4, activation='tanh'),
    tf.keras.layers.BatchNormalization(),
    Dense(512//8, activation='tanh'),
    tf.keras.layers.BatchNormalization(),
    Dense(32, activation='relu'),
    tf.keras.layers.BatchNormalization(),
    Dense(3, activation='softmax')
])
model11.compile(optimizer='sgd',loss='categorical_crossentropy', metrics=['acc', 'mse'])
hist11 = model11.fit(X_train, y_train, epochs=350,  validation_data=(X_test,y_test), verbose=2)
loss11, acc11, mse11 = model11.evaluate(X_test, y_test)
print(f"Loss is {loss11},\nAccuracy is {acc11 * 100},\nMSEis {mse11}")
通过在每个层中添加批量归一化,我们获得了良好的准确率。让我们绘制损失和准确率曲线。
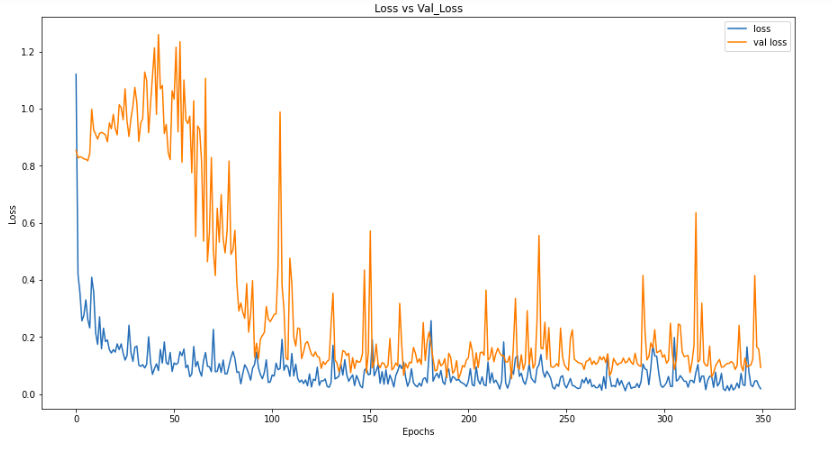
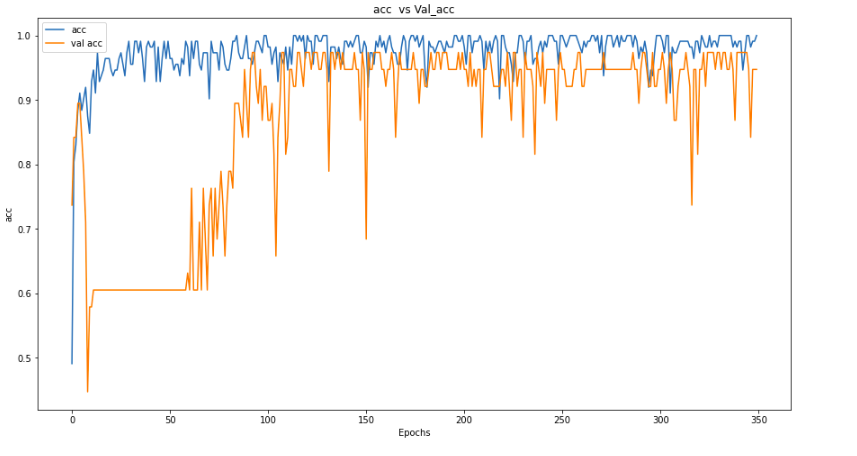
通过绘制准确率和损失曲线,我们可以看到我们的模型在训练集上的表现仍然优于验证集,但性能仍在提升。
结果:
本文简要介绍了如何在 Tensorflow 中使用不同的技术。如果你缺乏理论知识,我建议你学习 Coursera 上深度学习专项课程的第 2 和第 3 门课,以了解更多关于正则化的内容。
你还必须学习何时使用哪种技术,以及何时以及如何组合不同的技术,以产生真正富有成效的结果。
希望现在你已经了解了如何在 Tensorflow 2 中实现不同的正则化技术。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:KDnuggets
原创地址:https://www.kdnuggets.com/2020/08/tensorflow-model-regularization-techniques.html#comment-184740
原文作者:https://www.facebook.com/kdnuggets;如有侵权,请联系管理员删除。

