一个小型对抗性测试集,能捕捉到你的评估集永远无法发现的检索失败
引言
检索增强生成(RAG(检索增强生成))使用从一组文档中检索到的信息来回答问题。该文档集合称为语料库。典型的评估会将一个写得好的问题发送到一个整洁的语料库,并检查检索器是否返回正确的段落。
生产环境的文档集合很少保持整洁。
策略变更后,旧页面仍然可被搜索到。用户输入“warehuse”而不是“warehouse”。光学字符识别(OCR),即从扫描件中提取文本的软件,可能会将“SSO”读作“SS0”。表格也可能在页面边界处被分割,从而将数字与其标签分开。
每个问题都可能将检索器引向错误的段落。语言模型随后接收到不正确或不完整的上下文,因此即使是写得好的答案也可能是错误的。
在本文中,我们将看到一个小型检索器和故障注入,即故意添加问题以测试系统如何响应。我添加了一个过时的策略页面、一个OCR字符替换、一个查询拼写错误,以及一个被分割的表格。
你好,我是Sara Nóbrega,一名拥有物理学背景的AI工程师。如果你正在处理类似问题,或希望就应用这些想法获得反馈,我在这里收集了我的写作、资源和指导链接)。
👉 阅读:5 AI Skills That Will Keep Data Scientists Relevant in 2027 | Towards Data Science
玩具流水线
检索器搜索文档并返回与问题最相关的段落。RAG系统通常先将每个文档划分为更小的段落,称为块,然后再为搜索建立索引。
此示例刻意保持检索方法简单。它有4个短文档和一个评分函数。该函数将查询和每个文档拆分为小写单词,称为标记。然后,对于在该文档中找到的每个查询标记,给该文档1分。得分最高的文档获胜。
DOCS = [
Document("returns-2026", "Returns are accepted within 30 days.", "returns", "2026-02-01"),
Document("plans", "The Enterprise plan includes SSO for employees.", "plans", "2026-01-10"),
Document("crm", "CRM contact sync runs every five minutes.", "integrations", "2026-01-05"),
Document("inventory", "Warehouse inventory sync runs every 15 minutes.", "inventory", "2026-01-12"),
]
def tokens(text: str) -> list[str]:
return re.findall(r"[a-z0-9]+", text.lower())
def score(query: str, text: str) -> float:
query_tokens, doc_tokens = tokens(query), tokens(text)
return sum(token in doc_tokens for token in query_tokens)
每个 Document 存储一个 ID、其文本、一个主题以及更新日期。生产系统通常使用更复杂的匹配方法。精确 token 匹配使每次失败都易于发现,而相同的输入问题也可能影响那些系统。
相互矛盾的过时文档
退货政策在 2026 年初从 60 天改为 30 天。摄取流程将源文档复制到可搜索索引中。在这里,它添加了新页面却没有删除旧页面。
old_policy = Document("returns-2024", "Returns are accepted within 60 days.", "returns", "2024-08-01")
contradictory_docs = [old_policy] + DOCS
retrieve("How many days is the returns window?", contradictory_docs)
# returns-2024
两个页面获得相同的 token 重叠分数,因为每个页面都包含 "returns" 和 "days"。检索器需要一条针对相同分数的规则,称为 tiebreaker。这里它使用列表顺序,因此返回第一个页面:2024 年的政策。客户可能会被告知他们有 60 天的时间退货,而当前限制是 30 天。
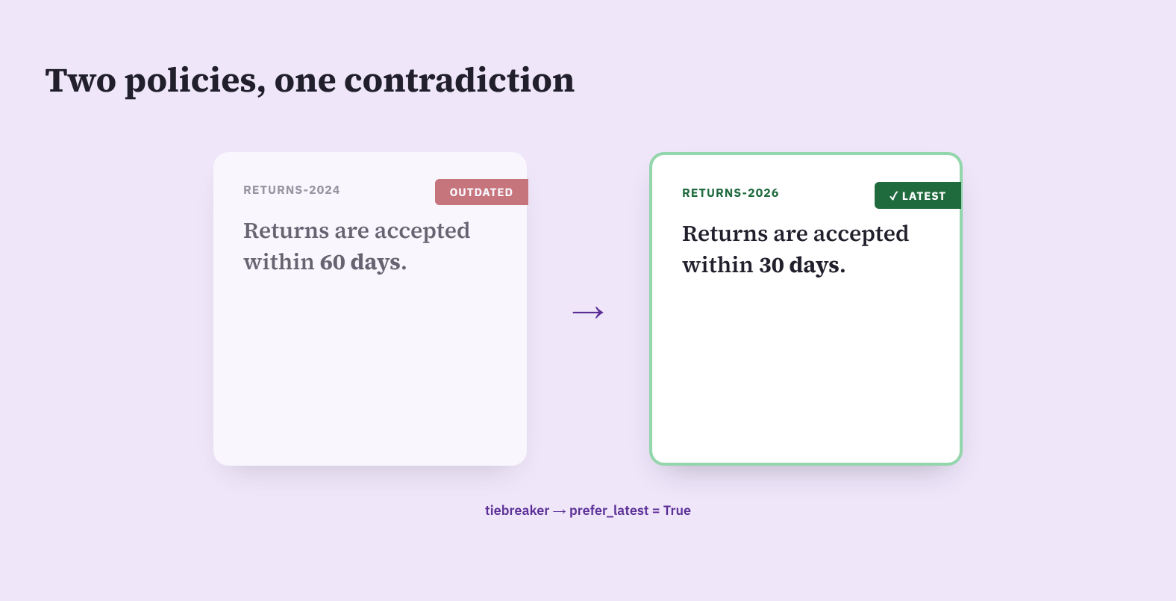
修正方案添加了一个基于新近度的 tiebreaker。当文档获得相同分数时,检索器优先选择更新日期较晚的那个。
retrieve("How many days is the returns window?", contradictory_docs, prefer_latest=True)
# returns-2026
这条规则适用于具有明确替换日期的政策。其他集合可能需要显式状态,例如 current 或 retired,尤其是当较新的文档并不替换较旧的文档时。
隐藏匹配词的 OCR 错误
OCR 将扫描页面转换为可搜索文本。相似外观的字母和数字会导致常见的提取错误。有缺陷的 OCR 输出将 "Enterprise" 改为 "Enterpr1se",将 "SSO" 改为 "SS0"。
noisy_docs = [replace(doc, text=doc.text.replace("Enterprise", "Enterpr1se").replace("SSO", "SS0"))
if doc.id == "plans" else doc for doc in DOCS]
retrieve("Does Enterprise include SSO?", noisy_docs)
# returns-2026
提取的文本包含 enterpr1se 和 ss0,因此查询 token enterprise 和 sso 各得 0 分。所有 4 个文档都以 0 分并列,列表顺序将退货政策作为结果返回。
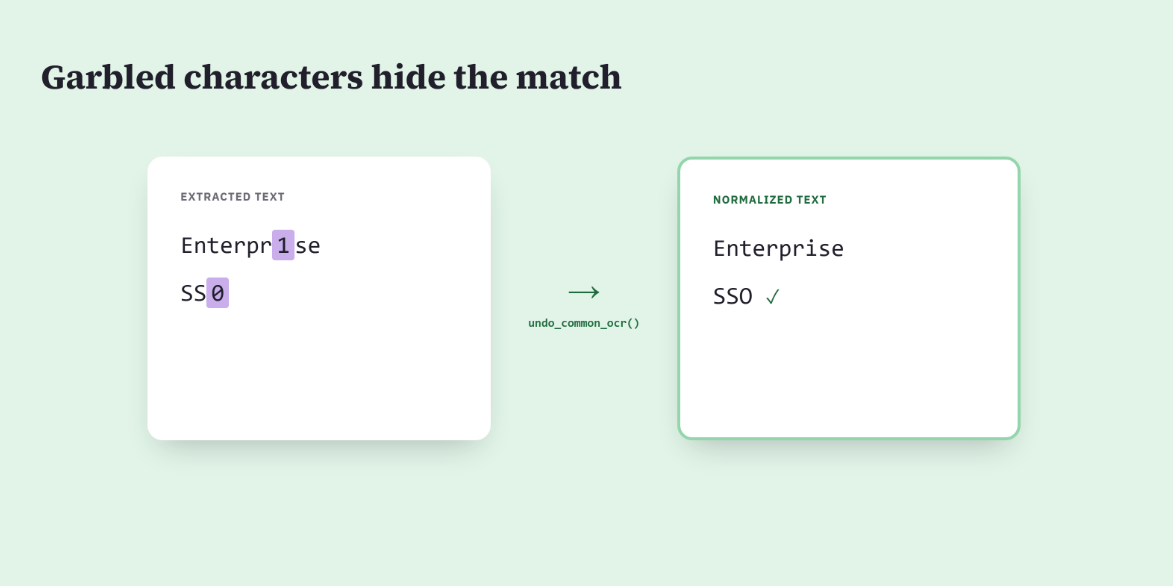
归一化函数在 tokenization 之前修正已知的 OCR 替换。将其应用于查询和文档,可为评分器提供一致的文本。
def undo_common_ocr(text: str) -> str:
return text.lower().translate(str.maketrans({"0": "o", "1": "i"}))
retrieve("Does Enterprise include SSO?", noisy_docs, ocr=True)
# plans
生产环境中的归一化规则需要谨慎。例如,将每个 0 都转换为 o 可能会破坏产品代码或测量值。应根据你自己提取文档中发现的错误来构建替换规则,并将其限制在更改安全的字段中。
查询中的拼写错误
用户会犯拼写错误。"warehuse sync" 比 "warehouse sync" 少了一个字母,而精确 token 匹配器会将这两个词视为不相关。
retrieve("warehuse sync", DOCS)
# crm
拼写错误的 token 贡献 0 分。这使得 sync 决定了结果。CRM 文档和仓库库存文档都包含它,因此平局归于 CRM 文档,因为它出现得更早。
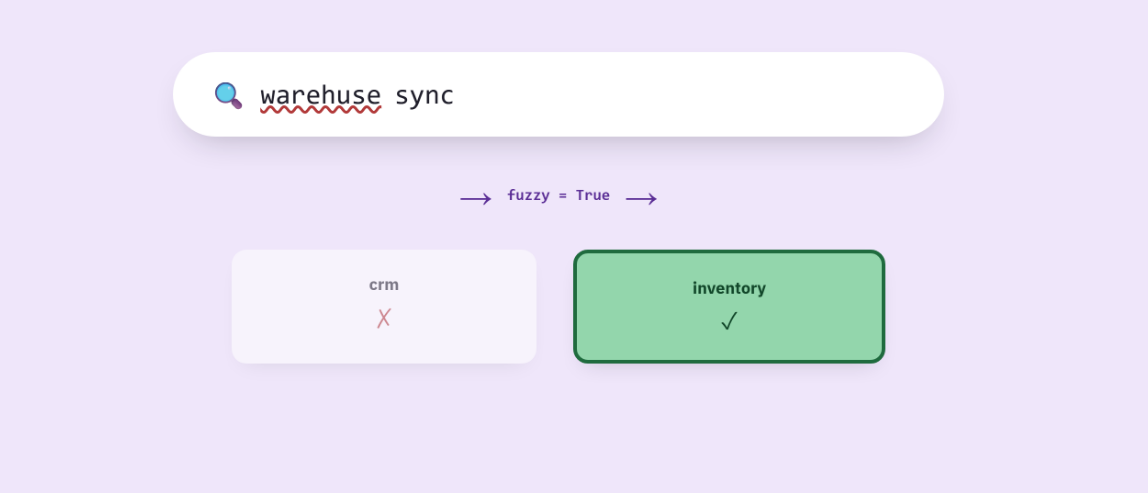
模糊匹配通过拼写相似度比较单词,并为接近的匹配给予部分分数。启用模糊匹配后,warehuse 与 warehouse 足够接近,使库存文档得分更高。
retrieve("warehuse sync", DOCS, fuzzy=True)
# inventory
相似度阈值很重要。设置得太低,不相关的词也可能匹配;设置得太高,常见拼写错误仍然无法匹配。基于真实查询的测试比少量人为编造的拼写错误能提供更好的阈值。
跨页边界分割的表格
一些 PDF 提取工具会为每页创建一个 chunk。如果表格延续到下一页,第一个 chunk 可能包含行标签,而第二个 chunk 包含其值。
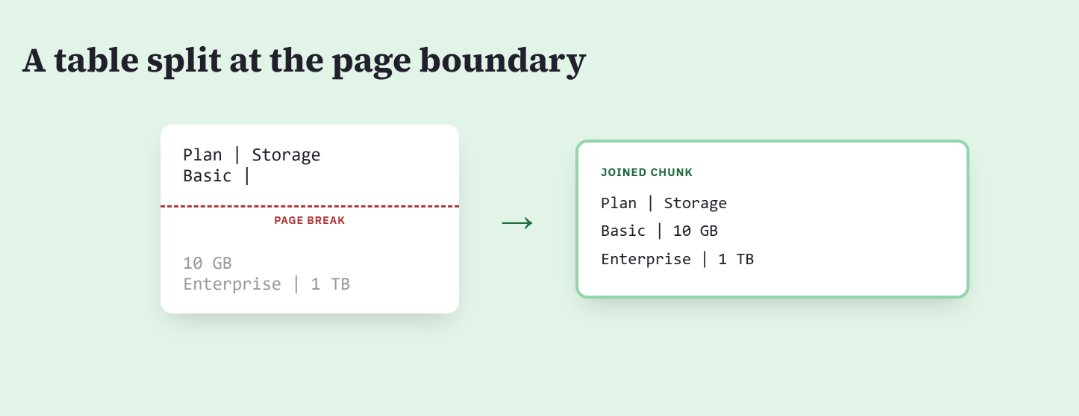
第一个 chunk 包含全部 3 个查询 token:basic、plan 和 storage,因此排名第一。其文本在 Basic | 之后结束。值 10 GB 位于下一个 chunk 中,可能永远不会到达语言模型。
raw_table = "Plan | Storage\nBasic |10 GB\nEnterprise | 1 TB"
table_pages = [Document(f"limits-p{i}", page, "limits", "2026-03-01")
for i, page in enumerate(raw_table.split(""), 1)]
retrieve("Basic plan storage", table_pages)
# limits-p1: "Plan | Storage\nBasic |"
这一修正属于摄取过程。在创建可搜索的 chunk 之前,检测表格片段并合并相关页面。
joined_text = " ".join(page.text for page in table_pages)
joined_table = Document("limits-joined", joined_text, "limits", "2026-03-01")
retrieve("Basic plan storage", [joined_table])
# limits-joined: "Plan | Storage Basic | 10 GB Enterprise | 1 TB"
合并每一对页面会产生过大的 chunk 并混入不相关的文本。将规则限制在检测到的表格上,或者向前携带足够的相邻内容以保留每一行。
测试每个结果中的证据
返回的文档 ID 确认了哪个来源排名第一。证据检查确认其 chunk 是否包含足够的信息来回答问题。分割的表格展示了这一差异:来自正确 limits 文档的 chunk 可能包含 Basic 和 Storage,却将 10 GB 留在下一页。
为每个测试添加证据检查。该检查列出必须出现在检索文本中的单词或值,以便语言模型生成有依据的答案。
def assert_retrieval(result, expected_id: str, required_text: list[str]) -> None:
assert result.id == expected_id
result_text = result.text.lower()
assert all(text.lower() in result_text for text in required_text)
退货政策测试应同时要求当前文档 ID 和当前值:
result = retrieve(
"How many days is the returns window?",
contradictory_docs,
prefer_latest=True,
)
assert_retrieval(result, "returns-2026", ["30 days"])
表格测试应要求行标签及其值出现在同一个检索到的块中:
result = retrieve("Basic plan storage", [joined_table])
assert_retrieval(result, "limits-joined", ["Basic", "10 GB"])
这些断言也让失败更容易诊断。
错误的 ID 指向排序或过滤问题。ID 正确但文本缺失指向提取或分块问题。ID 正确且包含所需证据,则为生成步骤提供了足够的源材料来作答,尽管最终答案仍需单独评估。
如果你的检索器返回多个块,请对传递给语言模型的合并文本应用相同的检查。这样评估的文本将与模型接收到的上下文一致。
4 个测试能捕获什么
对基础检索器运行这 4 个损坏输入会产生 4 个失败。为每种情况启用匹配修正后,全部 4 个都返回预期文档。
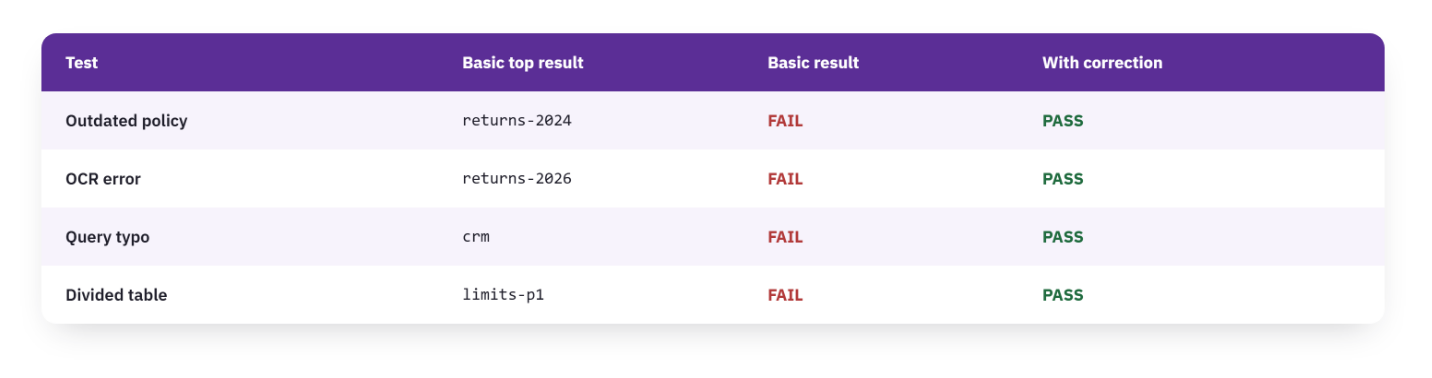
修复很小:
使用文档日期解决平局,规范化已知 OCR 错误,
允许接近的拼写匹配,以及
在摄取期间保留表格行。每一个都针对不同的原因。单独的测试结果能识别出缺少哪种保护。
将这些测试与标准相关性评估一起运行。相关性测试衡量检索在预期输入上是否有效。故障注入测试衡量在查询或文档集合中加入现实缺陷后,检索是否仍然有效。
这 4 个案例只是一个起始测试集。当生产环境返回错误文档时,添加一个回归测试:一种可重复的检查,确认该 bug 在后续代码更改后仍保持修复。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Towards Data Science
原创地址:https://towardsdatascience.com/break-your-own-rag-pipeline-before-users-do/
原文作者:Sara Nobrega;如有侵权,请联系管理员删除。

