本月早些时候,我与 Moniepoint 工程团队一起参加了一场网络研讨会,讨论了一个自 PeerDB 时期以来我一直在思考的问题:当 Postgres 运行在本地 NVMe 上时,什么会改变,什么不会改变?
答案的第一部分与存储有关。一旦 Postgres 的工作集增长到超出内存,存储延迟就可能成为瓶颈,而这些问题表面上看起来像是数据库问题。
第二部分是架构层面的。更快的存储可以让 Postgres 在事务型工作负载上显著提速,但它不会改变行存储的物理布局。到了某个阶段,分析型工作负载需要不同的东西。
这篇文章是那次对话的精简版本。
Postgres 并不慢。慢的是你的存储。#
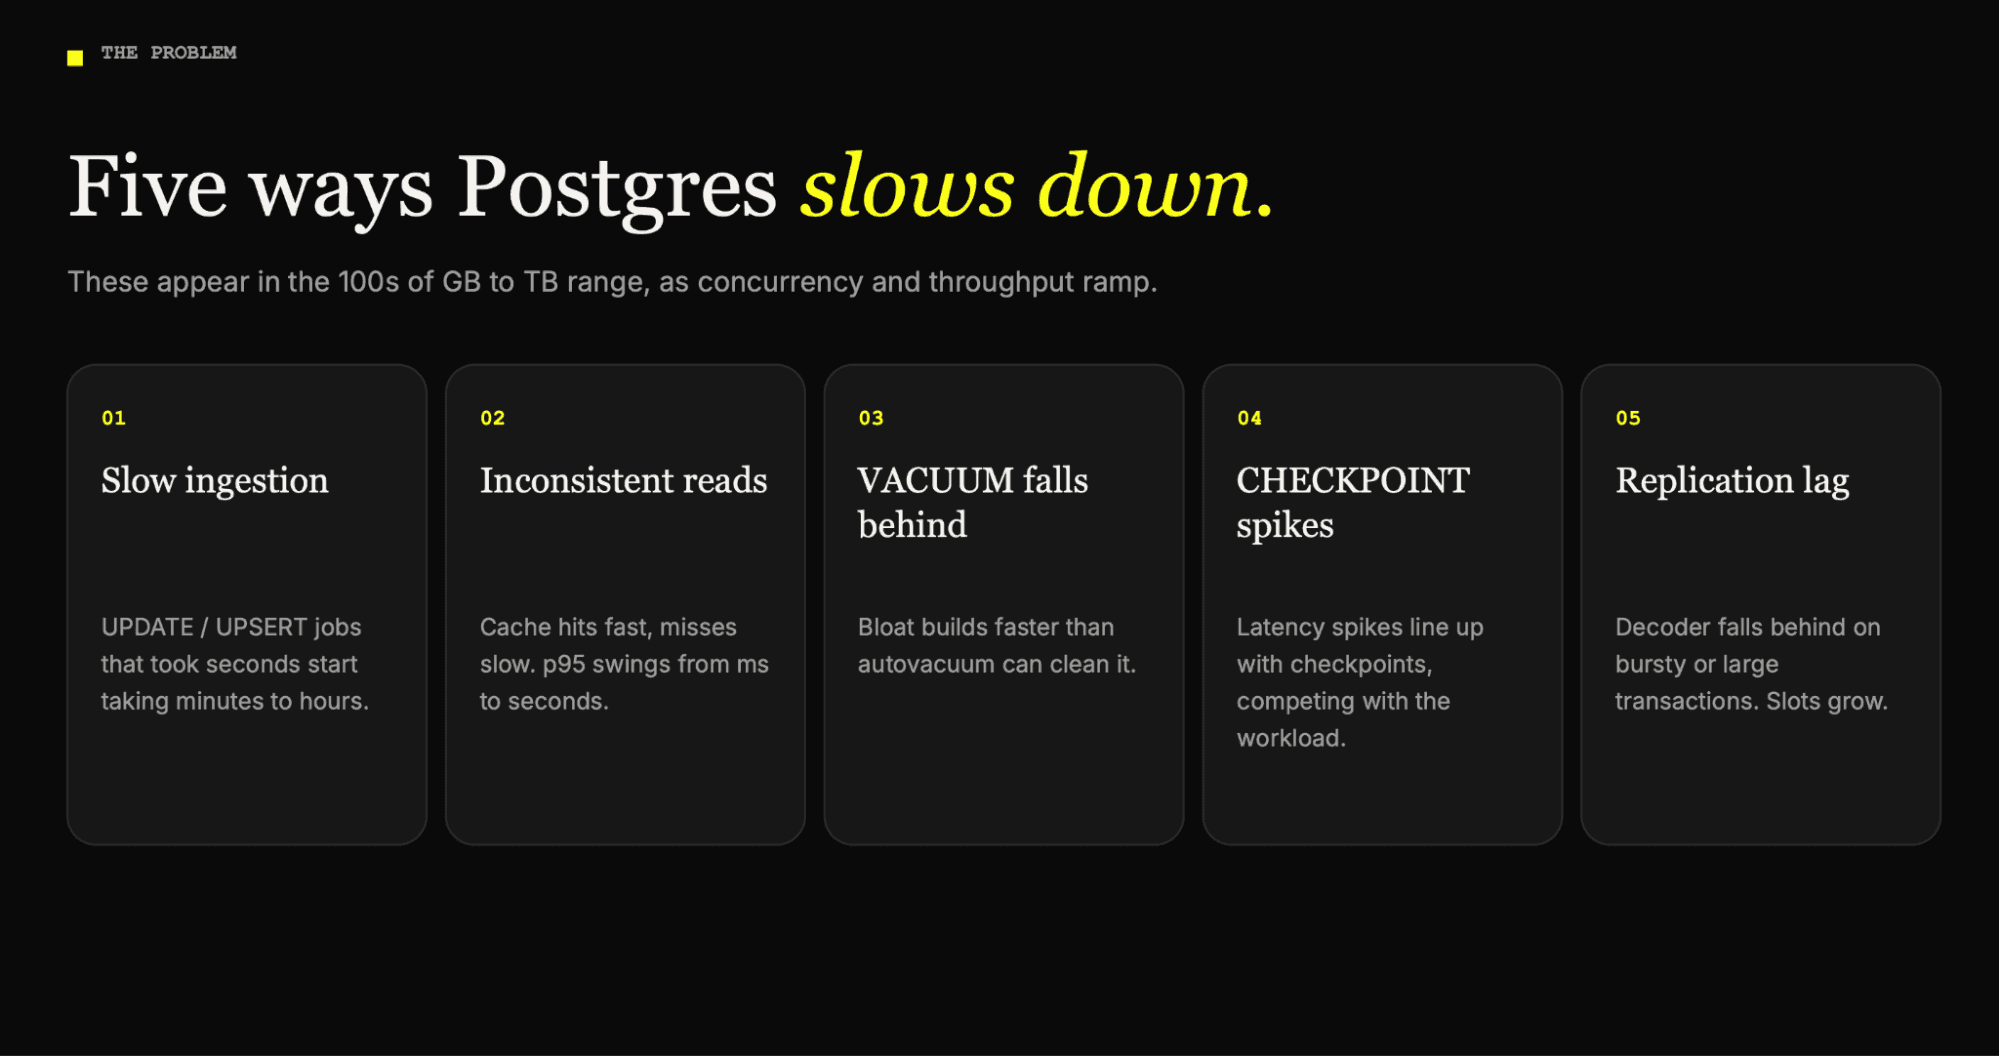
Postgres 可以走得很远。但随着数据集增长到数百 GB 或 TB 级别,并且并发和吞吐量不断攀升,一组熟悉的性能问题就会开始出现。
我反复看到的是同样五个问题:
写入变慢:原本只需几秒的 UPDATE 和 UPSERT 作业开始需要几分钟甚至几小时。
读取变得不稳定:缓存命中仍然很快,但未命中时并非如此,p95/p99 延迟可能从毫秒级攀升到秒级。
VACUUM 跟不上:死元组堆积的速度快于 autovacuum 清理它们的速度。
检查点造成压力:写入和 fsync 与应用争抢 I/O。
逻辑复制滞后:解码器跟不上,slot 不断增长,下游系统落后。
对于像 Moniepoint 这样的支付公司来说,这些问题会直接对应到更慢的交易、更慢的余额查询、延迟的对账以及欺诈流水线。在这种规模下,这些后果是不可接受的。
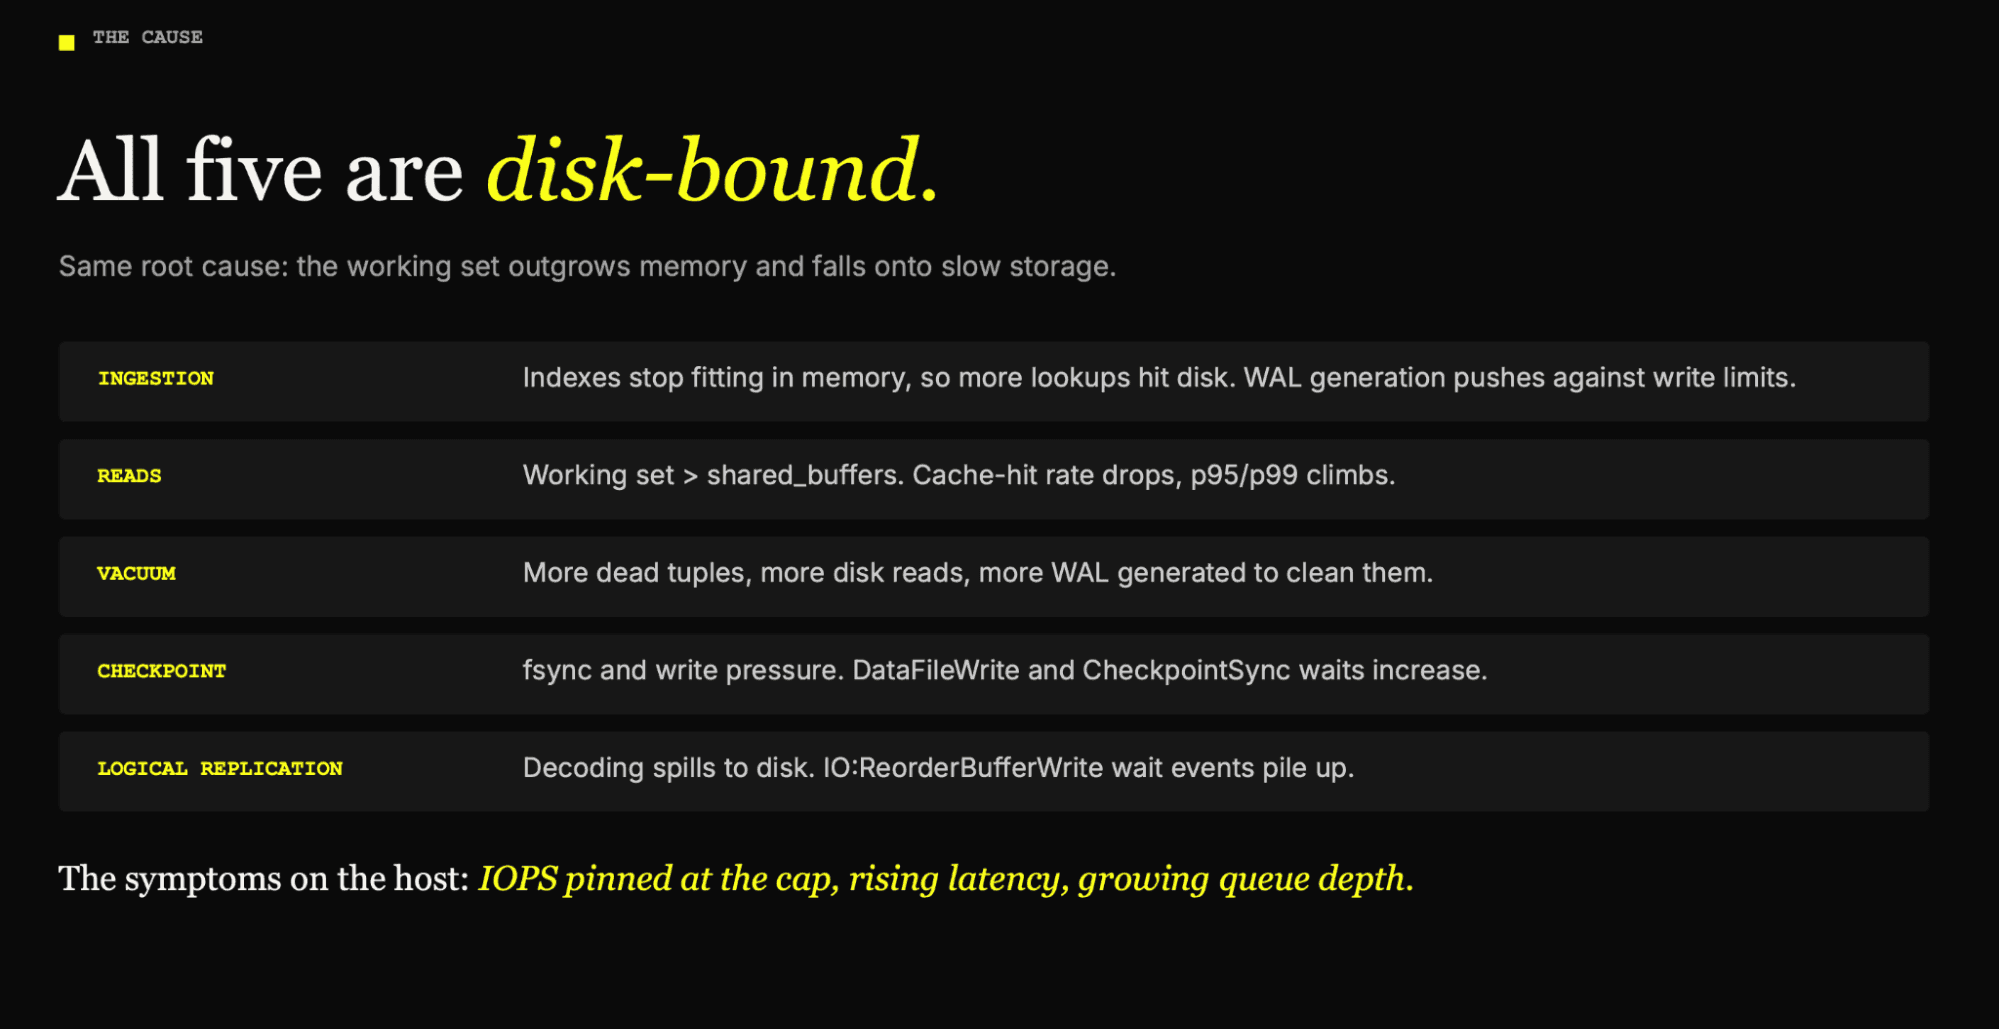
这些问题症状各异,但可能有着共同的底层原因:工作集超出了内存容量,溢出部分落到了磁盘上。
不再常驻内存的索引需要更多的磁盘读取。缓存未命中使读取延迟变得更不可预测。VACUUM 需要读取和清理更多的页面。检查点引入写入和 fsync 压力。逻辑解码可能溢出到磁盘。
在主机层面,这种模式很常见:IOPS 接近上限,延迟上升,队列深度增长。
如果磁盘表现得像第二层内存会怎样? #
CPU 缓存是纳秒级的。DRAM,即 shared_buffers 所在之处,大约在一百纳秒左右。网络附加 SSD(如 EBS)是 1 到 10 毫秒。本地 NVMe 介于两者之间,为几十微秒:比 RAM 慢两个数量级,但比 EBS 快大约一百倍。
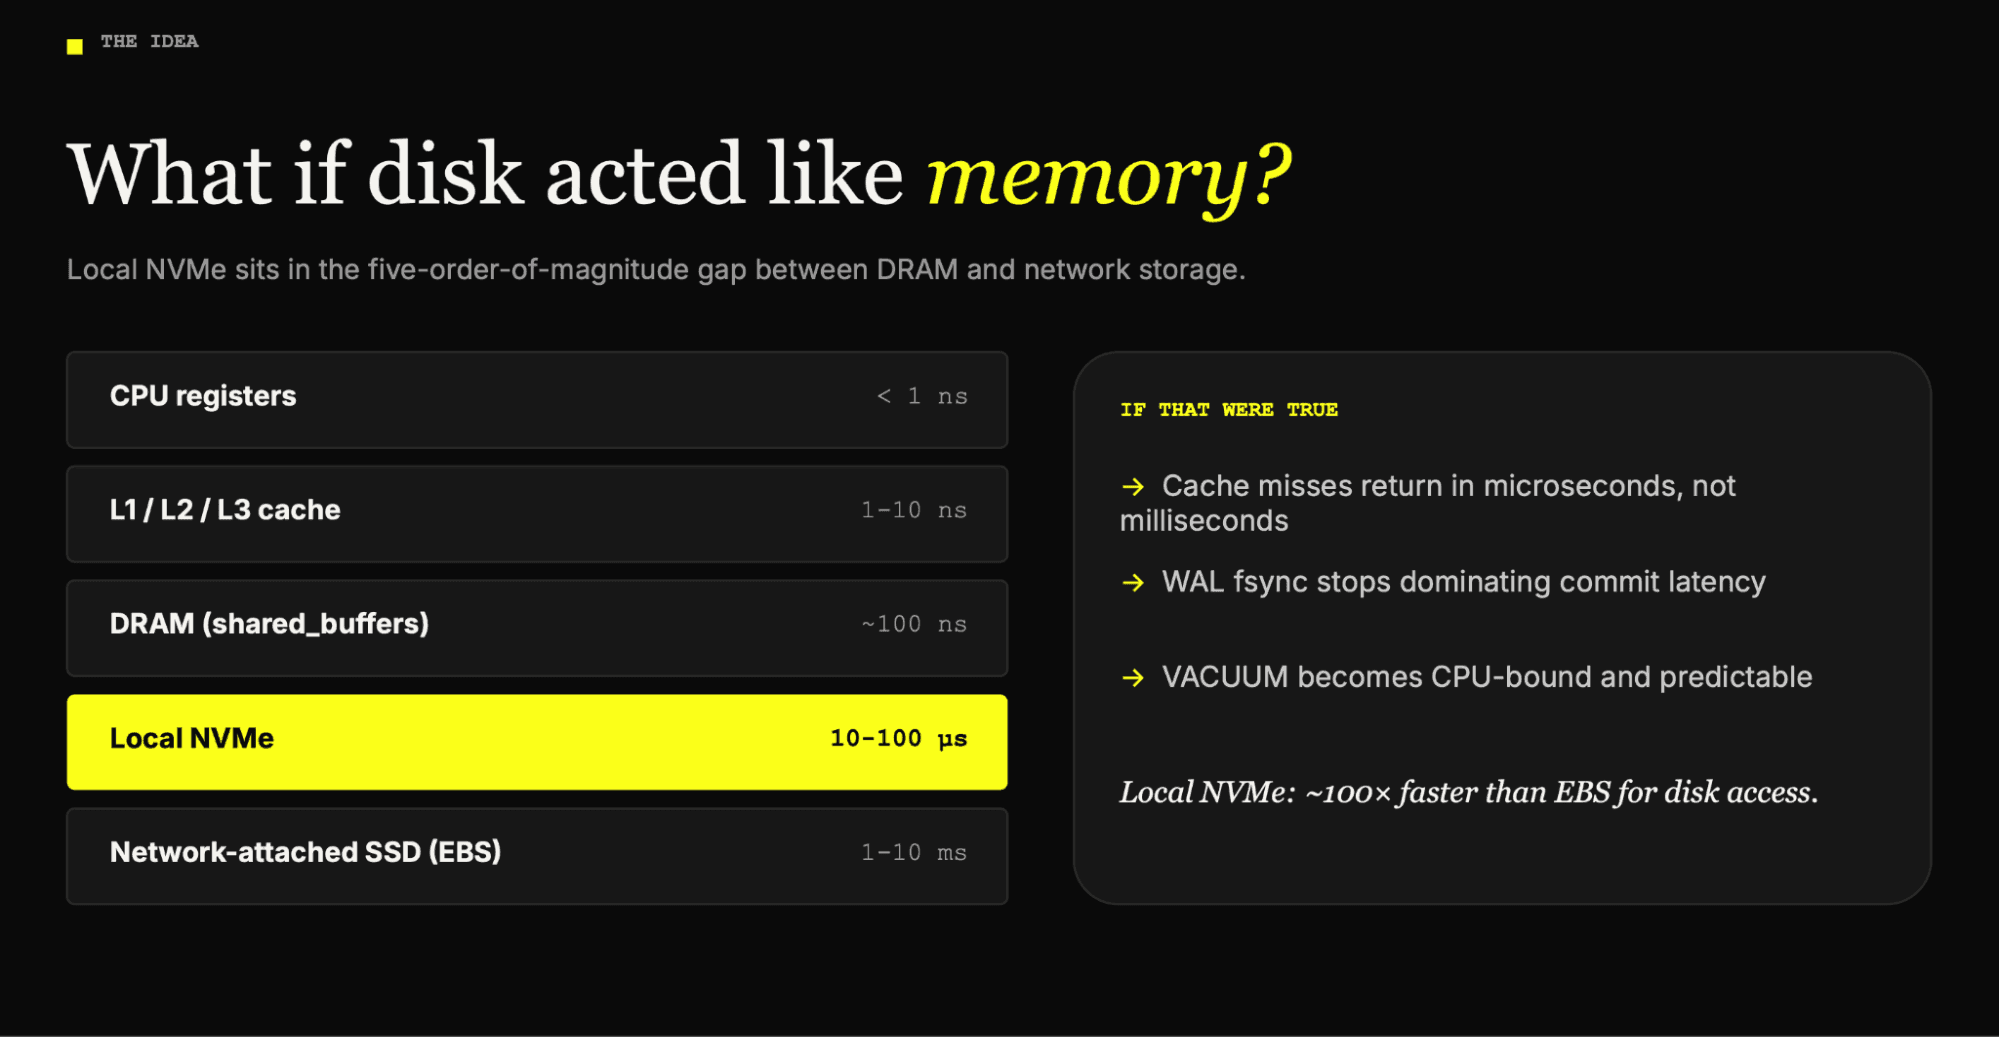
将缓存未命中从毫秒级压缩到微秒级,系统就会表现得好像拥有比实际更多的 RAM。尾部延迟得到改善,因为导致尾部延迟的冷读取变得廉价。WAL fsync 不再主导提交延迟。VACUUM 变得受 CPU 限制且可预测。
基准测试 #
我们搭建了八个完全相同的集群,唯一变量是数据卷的存储类别:m6id.4xlarge(16 vCPU,64 GiB RAM),Postgres 18.3 源码构建,shared_buffers = 16 GB,校验和开启。四个使用实例存储 NVMe,四个使用 gp3 EBS 的 3,000 IOPS 基线。数据集为 pgbench,scale factor 33,000:482 GiB 堆,33 亿行,约为内存可容纳量的 30 倍。这才是成熟 Postgres 的样子,比一个能放进缓存的基准测试更具代表性。
工作负载为 64 个客户端、16 个线程、持续五分钟,每个事务更新全部 33 亿行中的随机一行,所有八台主机并行运行,并在每台主机上进行持续性能分析(Parca 配合 eBPF,pg_stat_activity 以 1 Hz 采样)。
结果:NVMe 上的吞吐量高出 9.2 倍,中位数为 16,030 TPS,而 EBS 上为 1,734。我更关心的数字是延迟:NVMe 上每次 UPDATE 为 4.0 毫秒,而 EBS 上为 36.9 毫秒。这就是可预测的工作负载与一连串难以复现的“部分用户感觉变慢”工单之间的区别。
那 37 毫秒花在哪里 #
我们可以查看运行中途的 pg_stat_activity 快照来了解发生了什么。
在 EBS 上,每台主机 64 个后端中有 29 个(45%)在任何时刻都处于 IO:DataFileRead 状态,且没有任何后端在没有等待的情况下处于 on-CPU 状态。在 NVMe 上,9 个后端(14%)处于 IO:DataFileRead,13 个处于 on-CPU 执行实际工作。两侧其余的后端大多处于 LWLock:WALWrite,无论哪种方式,CPU 侧的工作量相同。
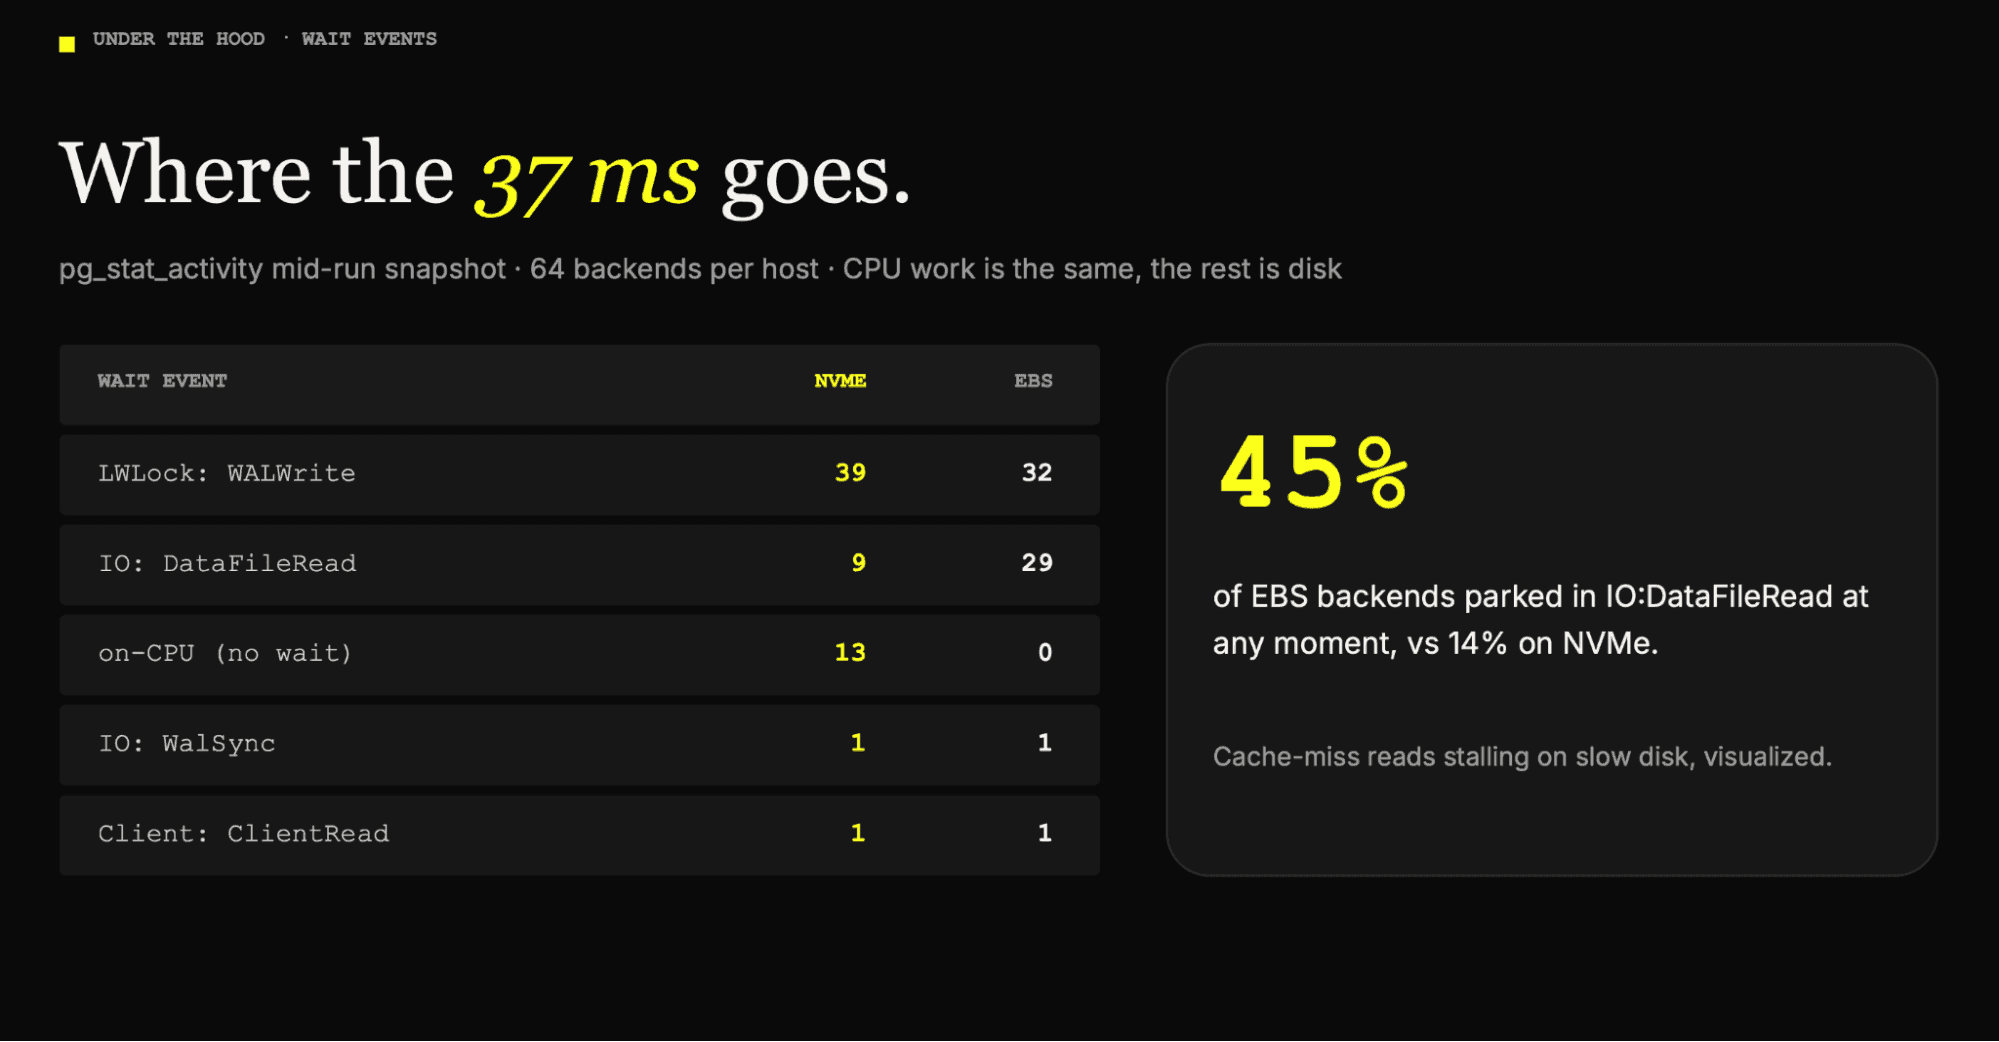
反直觉的部分来自 CPU 剖析。你可能认为 EBS 未被充分利用,更智能的流水线可以弥合差距。但事实并非如此。NVMe 主机在整个运行过程中消耗了约 2,253 CPU 秒(大约 9.4 个核心处于忙碌状态),而 EBS 上仅为 251 CPU 秒(约一个核心)。按函数划分的 CPU 占比在 EBS 上看起来更高,但那是比例,不是吞吐量。Postgres 在两者上做同样的工作;在 EBS 上,它花费 89% 的墙钟时间在 CPU 之外等待 I/O。EBS 不是忙碌,而是被阻塞了。
其他子系统也讲述了同样的故事。使用 VACUUM 清理 10 GB 膨胀在 NVMe 上耗时 366 秒,而在 EBS 上耗时 964 秒(2.6 倍),I/O 等待从 387 秒降至 3 秒。对约 10 GB 槽位进行逻辑解码的运行速度为 89 MB/s,而 EBS 上为 52 MB/s,仅 1.7 倍,因为解码器是单线程的,并且串行读取 WAL。
反对意见:本地 NVMe 是临时的 #
数据库运维人员不会简单地在所有地方用本地 NVMe 替换持久网络存储,这有一个显而易见的原因。
实例存储 NVMe 与实例的生命周期绑定。实例或其底层硬件丢失,本地卷就会消失。你无法将其分离并挂载到其他地方。
你也无法获得许多团队习惯的块存储快照模型,而且容量由实例类型决定。
因此,有趣的问题不仅仅是本地 NVMe 是否更快。而是我们能否在别处设计持久性的同时获得它的低延迟。
基于流式复制的 Quorum HA #
一个构建块是跨可用区的同步流式复制。一种拓扑可以使用一个主库加两个备库,每个都配备本地 NVMe,分布在不同 AZ 中。PostgreSQL 的 quorum 同步复制可以配置为 synchronous_standby_names = 'ANY 1 (standby1, standby2)'。
提交等待最快的备库确认,而不是最慢的,并且你可以在不丢失已确认事务的情况下丢失一个节点或整个 AZ。使用 Patroni 或 repmgr 等工具,故障转移是一个已解决的问题。
你正在将复制从存储层移到 Postgres 中,Postgres 理解 LSN 和事务,并且能更好地完成这项工作。
持续 WAL 归档 #
第二个构建块是持续 WAL 归档。
定期基础备份加上通过 WAL-G 实时传送到 S3 的每个 WAL 段。RPO 为秒级,十一个九的持久性,并且归档位于你的计算集群之外,能够在节点、可用区甚至区域丢失时存活。NVMe 卷成为始终可恢复的状态缓存:丢失节点,重放归档。同一归档为你提供 PITR、从不接触主库的只读副本,以及从任意 LSN 分支。
更快的磁盘提高了上限。它们不会改变形态。 #
如果本地 NVMe 消除了如此多的 I/O 等待,为什么不干脆在非常快的 Postgres 上运行一切?因为存储延迟只是问题的一部分。NVMe 使随机访问的成本大幅降低。它不会把行存储变成列存储。事务型和分析型工作负载对存储引擎的要求根本不同。
Postgres 将完整行存储在 8 KB 页面中。点读只触及一个页面,MVCC 将行版本保留在原位,因此写入者永远不会阻塞读取者,而 B-tree 索引使选择性查找成本低廉。代价是,对十亿行的聚合会读取每一行的每个页面,无论它是否需要那些列。sum(amount) GROUP BY country 仍然会加载整行,即使每个页面在微秒内返回。
ClickHouse 按列存储和处理数据。每一列位于自己的文件中,聚合只读取它引用的列,执行以缓存大小的批次进行向量化,并且相似值在按列编解码器下压缩得非常好(10 倍是常规水平)。MergeTree 通过后台合并来吸收追加密集型写入,而不是立即将每次插入物化到页面上。
改变的是团队撞上这堵墙的时间。从 10 GB 增长到 100 GB 过去需要 12–18 个月;现在只需要一到三个月。AI 原生产品从第一天起就记录推理和 agent 运行,并且从第一天起就需要对它们进行分析。安全平台摄取仅追加的事件流,并迅速达到数 TB 数据。产品分析 SaaS 向客户销售仪表板,而 30 秒的仪表板是没人信任的仪表板。
一种架构,两个引擎 #
我在现场不断看到的模式很简单。应用程序继续写入 Postgres:事务、ACID、点查找,保持不变。变更数据捕获以秒级新鲜度将每次插入、更新和删除流式传输到 ClickHouse。而 pg_clickhouse 是一个开源 Postgres 扩展,让应用程序通过其现有的 Postgres 连接查询 ClickHouse 副本,因此 ClickHouse 的行为几乎就像一个分析型只读副本。
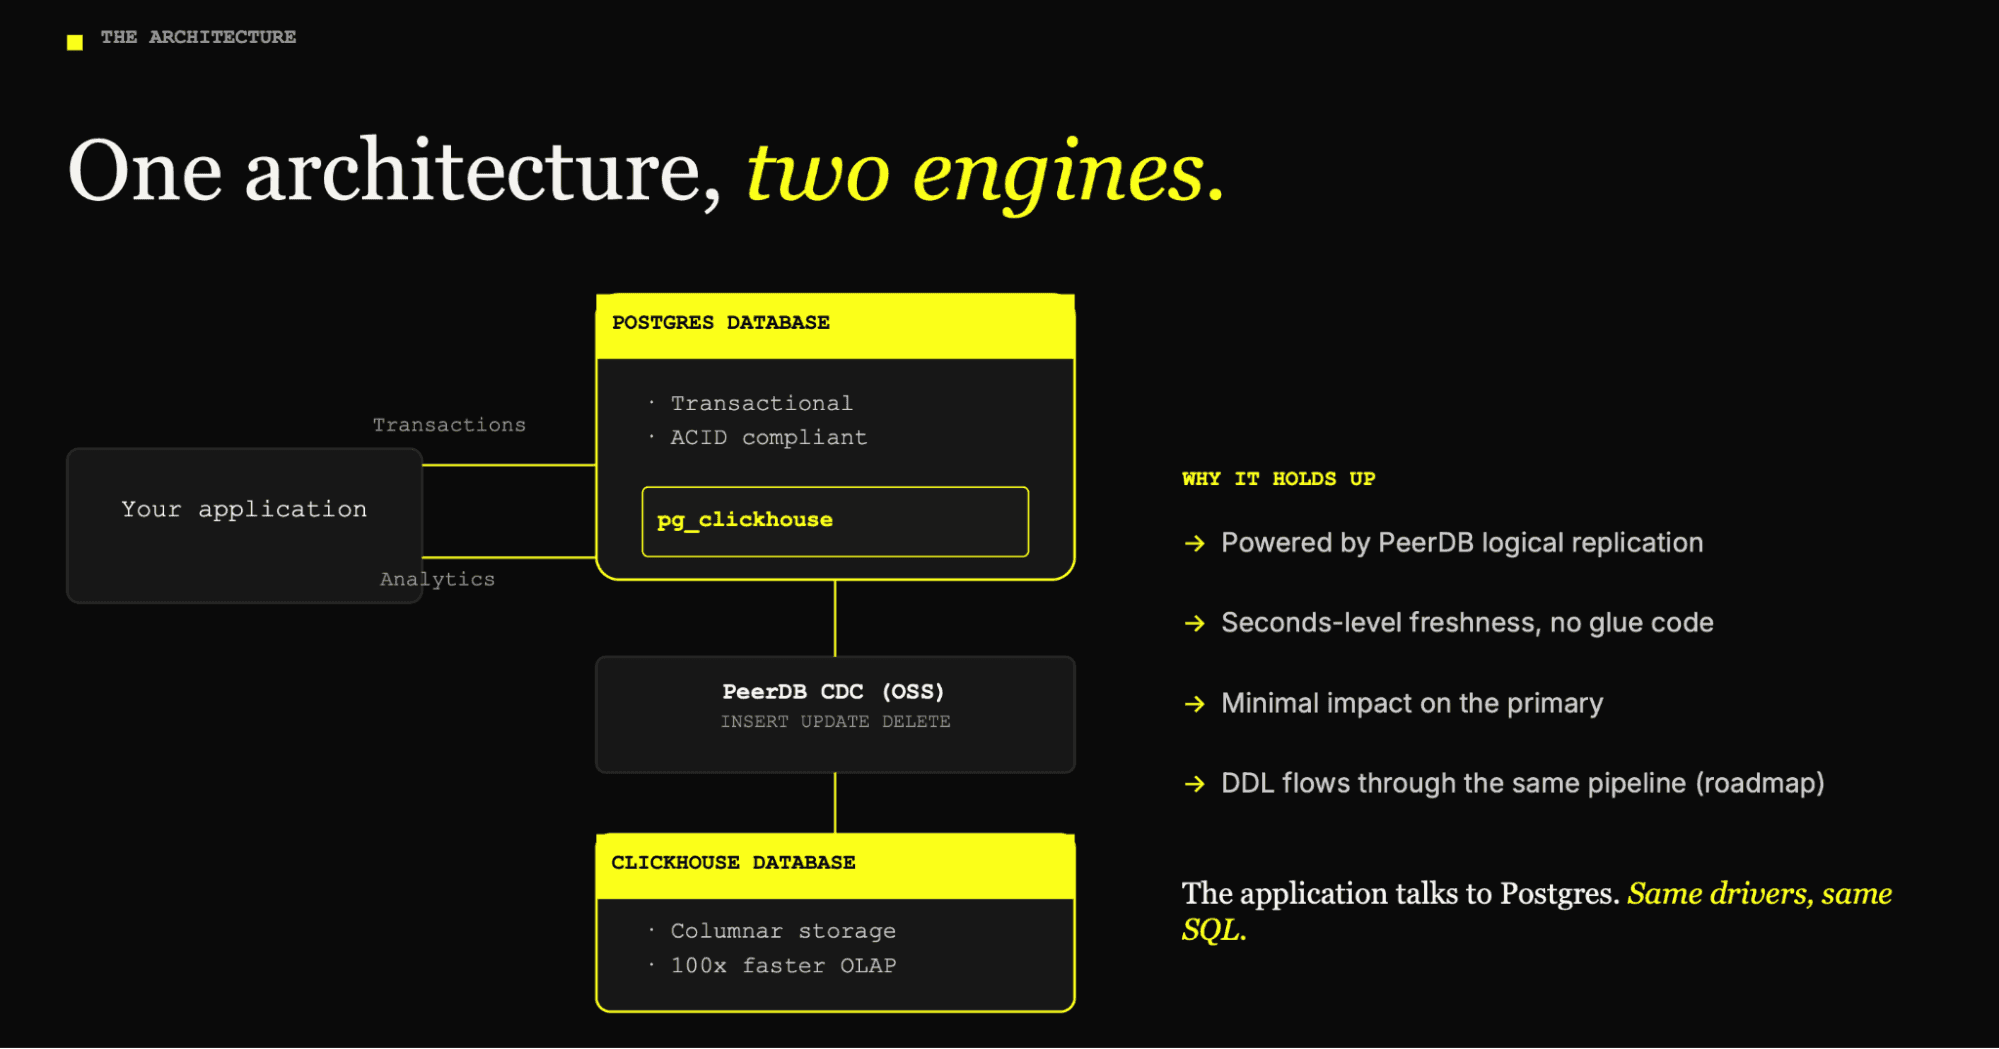
三个支柱支撑着这一点。基于 WAL 的 CDC:我们使用 PeerDB(开源;ClickPipes 是托管产品),它在生产环境中每月复制约 200 TB,将更新和删除落入 ReplacingMergeTree,对主库影响最小。查询下推:该扩展必须深度查询感知,将 Postgres 计划重写为 ClickHouse SQL(例如 JOIN 语法不同),而下推覆盖率是需要仔细评估的事项。模式同步:DDL 与数据流经同一管道,因此在 Postgres 中添加的列会出现在 ClickHouse 中。
新内容:WalShadow 实现亚秒级 Postgres 到 ClickHouse 复制
自本次网络研讨会录制以来,我们推出了 WalShadow,这是一个开源复制引擎,现已在 ClickHouse Managed Postgres 中提供 Private Preview。与通过 PeerDB 或 ClickPipes 实现的逻辑 CDC 不同,WalShadow 直接从物理 Postgres WAL 读取,并将变更转换为 ClickHouse 原生块。这实现了无需逻辑复制槽的亚秒级复制,同时保持插入、更新、删除以及受支持的 schema 变更同步。
实际结果是,你不再需要为 TB 级分析历史数据来规划 Postgres 的容量。保留一个小型、快速的 Postgres 用于事务热路径,让扫描密集型查询交给 ClickHouse。
要点 #
快速 OLTP 是一个存储问题。本地 NVMe 改变了常量:微秒级缓存未命中、廉价的 fsync、可预测的 VACUUM。借助 quorum 复制和 WAL 归档,你可以获得网络存储级别的韧性,而没有网络存储的延迟。
快速 OLAP 是一个架构问题。没有任何存储设备能让行存擅长扫描十亿行;列式布局可以。CDC 加上列存改变了形态。
这里的一切都是开源的:Postgres、WAL-G、repmgr、PeerDB、pg_clickhouse 和 ClickHouse。你可以在笔记本电脑上运行整个技术栈。如果你不想自己运行,这正是我们正在通过 ClickPipes CDC 构建到 ClickHouse 托管 Postgres 中的技术栈。

转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:ClickHouse Blog
原文作者:Kaushik Iska;如有侵权,请联系管理员删除。

