使用 Strands Evals 和 Amazon Bedrock AgentCore 评估配备技能的智能体
通用智能体能够处理广泛的任务,但你仍然需要它们遵循驱动业务运行的流程:合规检查、文档处理工作流、升级策略、工程规范。将所有这些内容编码到一个系统提示词或应用程序逻辑中会变得难以维护和更新。技能是一种模块化的替代方案。技能是一组可复用的指令,通常存储在 SKILL.md 文件中,用于教会智能体执行特定领域的任务,例如编辑合同、核对发票或遵循团队的拉取请求规范。由于技能遵循开放的 Agent(智能体) Skills 标准,它们可以在兼容的执行框架之间移植,并且智能体在运行时只加载所需的技能,而不是将所有流程都携带在核心指令中。
一个技能将一个或多个工具与智能体正确使用它们所需的上下文打包在一起:
指令:注入智能体上下文的领域特定指导和约束。
工具绑定:技能所依赖的 API(应用程序编程接口)、Model Context Protocol (MCP) 服务器或本地命令。
知识:参考资料和示例。
工作流:技能遵循的多步骤流程或决策逻辑。
护栏:格式要求、范围限制和验证规则。
这种模块化方法帮助团队更快地专业化智能体,在智能体和工作流之间复用经过验证的流程,保持行为一致性,并更新领域特定指导而无需微调底层模型或重写智能体的核心逻辑。
智能体中的这种技能可组合性引入了两种通用输出质量指标可能遗漏的失败模式:智能体调用了不适合该任务的技能,以及智能体调用了正确的技能但跳过或仅部分遵循其指令。这两种失败都可能产生流畅、看似合理的响应,却没有使用你预先确定的领域知识。因此,评估不能仅检查最终响应。
为了使这些失败可衡量,Strands Evals SDK(软件开发工具包) 和 Amazon Bedrock AgentCore Evaluations(Amazon Bedrock AgentCore 的一项功能)增加了以技能为中心的评估器:
技能选择准确性判断每个被调用的技能是否是该任务的合适选择。它为每个被调用的技能返回二元结果。
技能指令遵循度判断智能体在多大程度上遵循了被调用技能的指令。它为每个规定的步骤返回基于证据的五级评分。
此外,在 Strands Evals 上,技能调用是一项确定性检查,用于判断指定名称的技能是否已成功加载。
在本文中,你将学习如何从 Strands Evals 中记录的轨迹评估技能选择和指令遵循,向测试套件添加确定性路由检查,使用 AgentCore Evaluations 从 OpenTelemetry 追踪中评估技能行为,并解读每个技能的结果以选择正确的修复方案,所有这些都通过 AgentCore CLI 完成。
了解每个评估器衡量什么
智能体接收任务和技能目录,选择一个技能,加载它,然后执行操作。运行过程在 Strands Evals 中记录为轨迹,或在可观测性层中记录为 OpenTelemetry 追踪。该记录现在可用于所有三种技能评估器。技能选择准确性检查每个被调用的技能是否适合该任务,以及智能体是否调用了正确的技能。下图展示了智能体如何从提供给它的 1:n 个技能中选择一个技能。技能选择准确性随后评分所选技能是否为该任务的正确技能。你可以在提示词模板文档中找到该评估器的提示词模板和评分标准。
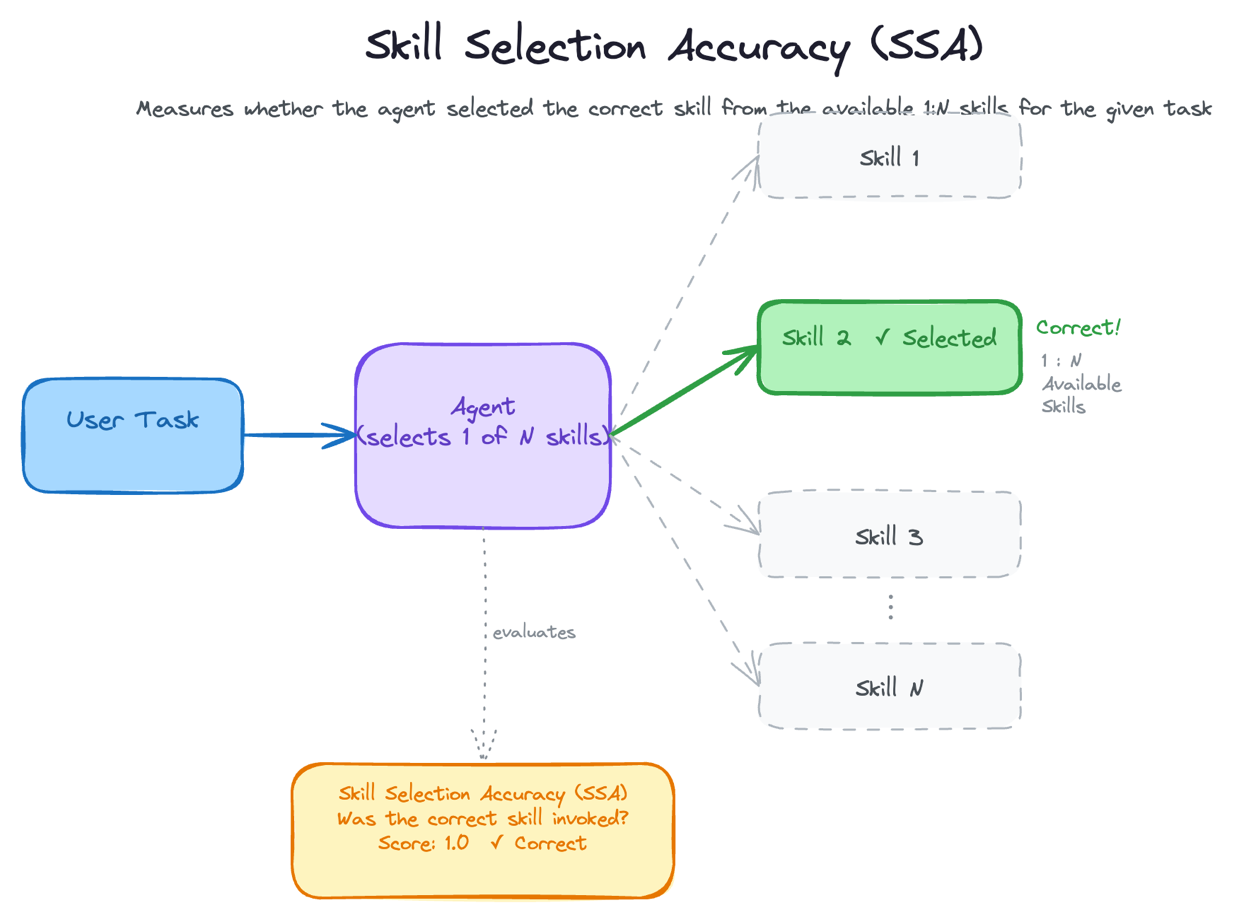
图 1:Skill Selection Accuracy 检查智能体是否为任务选择了合适的技能
Skill Instruction Following 考察智能体在多大程度上遵循了该技能规定的步骤。你可以在提示模板文档中找到该评估器的提示模板和评分标准。
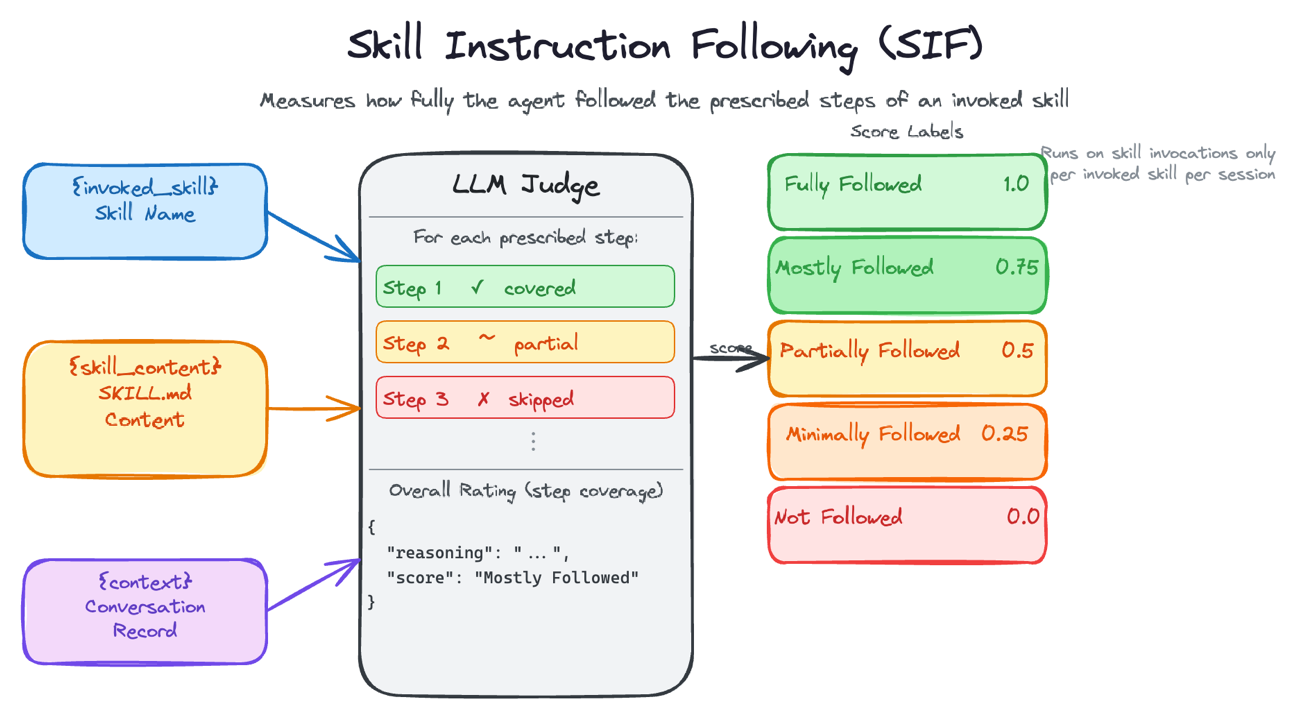
图 2:Skill Instruction Following 衡量智能体遵循技能步骤的完整程度
SkillInvoked 是确定性的。它不调用任何模型,且专属于 Strands Evals。
下图以图示方式概述了这些技能评估器。
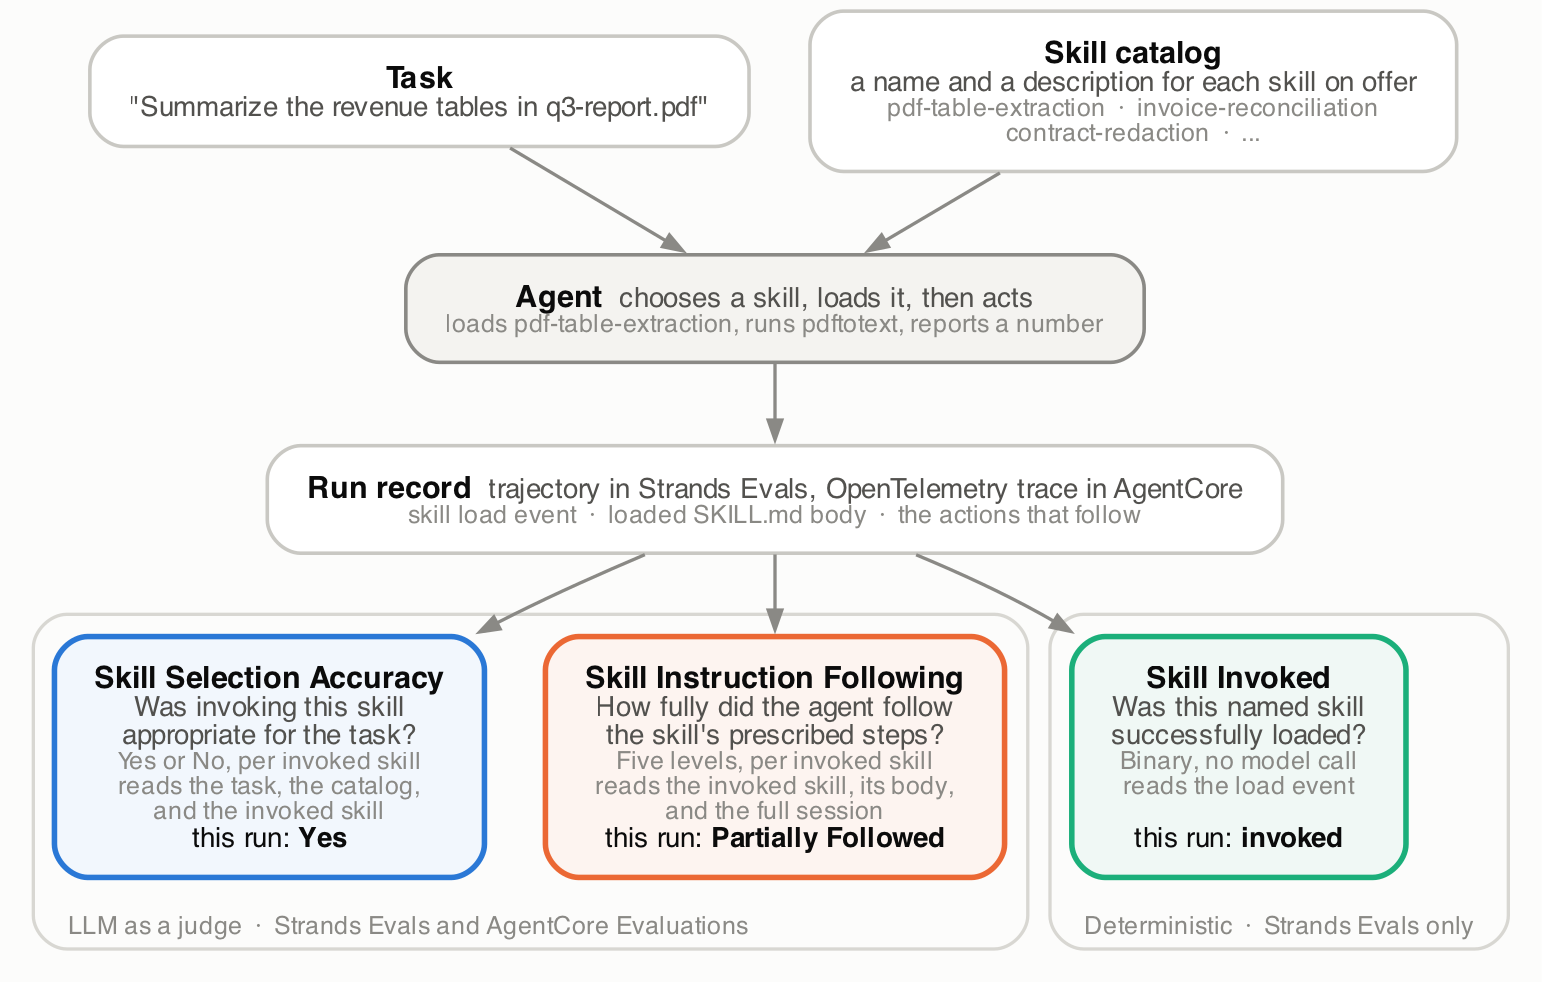
图 3:三种技能评估器概览
设想一个 HR 助手智能体,具备带薪休假(PTO)规划和讨论员工福利的技能。一名员工询问其牙科和视力福利。如果智能体调用福利技能,可能会生成更完善的回复。如果工具调用成功,但智能体选择了错误的操作手册,Skill Selection Accuracy 会定位出该路由决策问题。
现在假设智能体针对相关请求正确调用了 PTO 规划技能。该技能指示智能体识别 employee_id,检查 PTO 余额,根据最新 HR 政策检查结转规则,然后在条件允许时提交 PTO 请求。如果智能体检查了 PTO 余额但跳过了结转规则,智能体可能仍会返回看似合理的回复,却违反了规定的流程。Skill Instruction Following 会定位出该执行失败并识别出被跳过的步骤。
这些失败需要不同的修复方式。不恰当的选择通常指向重叠或模糊的技能描述。不完整的指令遵循可能需要更清晰的步骤、不同的技能结构,或能力更强的智能体模型。
| 评估器 | 可用性 | 评分 | 所回答的问题 |
| --- | --- | --- | --- |
| Skill Selection Accuracy | Strands Evals 和 AgentCore Evaluations | 二元,按调用的技能 | 调用此技能对任务是否合适? |
| Skill Instruction Following | Strands Evals 和 AgentCore Evaluations | 五个等级,按调用的技能 | 智能体在多大程度上遵循了此技能规定的步骤? |
| Skill Invoked | Strands Evals | 二元,确定性 | 此命名技能是否成功加载? |
由于基于评判的评估器返回按调用技能划分的结果,多技能运行仍然可诊断:你可以识别出是哪个选择或指令遵循结果拉低了聚合分数。如果未调用任何技能,基于评判的评估器不会产生分数。当回归测试有已知的路由要求时,将它们与 SkillInvoked 搭配使用。
先决条件
Python 3.10 或更高版本。
一个具有 Amazon Bedrock 访问权限的 AWS 账户,以及具有对评判模型 InvokeModel 权限的凭证。
要跟随 Strands Evals 部分,请安装 SDK:
pip install strands-agents-evals strands-agents
你还需要一次已记录的智能体运行。技能评估器接受 Strands Evals Session 或原始消息列表作为轨迹。在启动时,技能提取可识别来自 Strands AgentSkills 插件、Claude Code、Claude Agent SDK、OpenAI Agents SDK、Codex、Gemini CLI、OpenHands、Google ADK 以及通用 SKILL.md 文件读取的信号。
要跟随 AgentCore Evaluations 部分,你需要:
一个托管在 Amazon Bedrock AgentCore 运行时或其他位置的智能体。我们将使用 HR 助手智能体的示例,你可以将其部署到你的账户中。
为该智能体启用可观测性,以便它将遥测数据发送到 Amazon CloudWatch。
在 CloudWatch 中启用 Transaction Search。
本文中的示例使用 AgentCore CLI:
npm install -g @aws/agentcore
使用 Strands Evals 评估已记录的轨迹
当你控制测试用例并且可以在开发或持续集成期间重新运行智能体时,Strands Evals 非常有用。请查看为 HR 助手智能体创建的完整 Strands evals 代码示例,见完整代码示例。
1. 定义用例和评估器
from strands_evals import Case, Experiment
from strands_evals.evaluators import (
    SkillInstructionFollowingEvaluator,
    SkillInvoked,
    SkillSelectionAccuracyEvaluator,
)

case = Case(
    name="q3-revenue-tables",
    input="Summarize the revenue tables in q3-report.pdf",
)

evaluators = [
    SkillSelectionAccuracyEvaluator(),
    SkillInstructionFollowingEvaluator(),
    SkillInvoked(skill_name="pdf-table-extraction"),
]
2. 运行智能体并捕获其轨迹
技能评估器会读取运行的轨迹。TracedHandler 收集智能体的 span 并将其作为轨迹附加:
from strands import Agent
from strands_evals import TracedHandler, eval_task

@eval_task(TracedHandler())
def task_function():
    return Agent(...) # your skill-equipped agent

experiment = Experiment(cases=[case], evaluators=evaluators)
report = experiment.run_evaluations(task_function)
report.run_display()
3. 解读报告
假设智能体加载了 pdf-table-extraction,运行了 pdftotext -layout,但从未打开提取出的文件,也没有定位表格边界。一份简化报告:
SkillSelectionAccuracyEvaluator: score=1.00, pass=True
pdf-table-extraction: The skill directly matches the request.
SkillInstructionFollowingEvaluator: score=0.50, pass=False
pdf-table-extraction: The extraction phase was completed,
the table-boundary phase was skipped.
Steps:
- Extract text with layout preservation: covered
- Locate table boundaries: skipped
- Summarize each table's headline figure: partial
SkillInvoked: score=1.00, pass=True
skill 'pdf-table-extraction' was invoked
Skill Instruction Following 使用五个评级:完全遵循(1.0)、大部分遵循(0.75)、部分遵循(0.5)、最低限度遵循(0.25)和未遵循(0.0)。达到大部分遵循或更好即通过。
将检查转化为部署门禁
为特定回归用例必须调用的每个关键技能添加 SkillInvoked。由于它不调用模型,因此是一种快速的路由断言。
基于 report.test_passes 对构建进行门禁:if not all(report.test_passes): raise SystemExit(1) 。
使用聚合分数跟踪更广泛的趋势,但在强制执行阈值之前,请根据自己的用例校准该阈值。
使用 AgentCore Evaluations 评估生产跟踪数据
AgentCore Evaluations 可直接处理现有的 OpenTelemetry 跟踪数据,支持按需评估、对已存储会话进行批处理,以及对实时流量进行持续采样。遥测数据按会话、跟踪和跨度进行组织。由于技能评估器在工具调用级别运行,每个结果都包含一个 spanContext,其中带有已识别技能调用的 sessionId、traceId 和 spanId。
技能调用可通过以下任一方式识别:读取 SKILL.md 文件系统(可跨框架工作),或使用 Strands Agents、LangGraph Deep Agents、Google ADK 或 Claude Agent SDK 中的原生技能加载工具。
自定义评估器的跟踪占位符
AgentCore Evaluations 包含两个内置的基于评判器的技能评估器。若要评估内置评估器未覆盖的内容,请在 TOOL_CALL 级别创建自定义评估器。工具级模板可以引用技能占位符:
| 占位符 | 内容 |
| --- | --- |
| {invoked_skill} | 在此工具调用中加载的技能名称 |
| {skill_content} | 已加载的 SKILL.md 正文 |
| {available_skills} | 运行时提供的目录,或“(not recorded by this harness)” |
| {user_message} | 触发该调用的请求 |
| {context} | 对话记录 |
例如,一个检查技能运行某一特定属性的模板:
## Skill instructions

{skill_content}

## Conversation record

{context}

## Evaluation Question

Did the agent complete every numbered step in the skill instructions above, in the order given? Answer Yes or No.
你引用的占位符也决定了评估器何时运行。包含 {invoked_skill} 的模板仅在技能调用跨度上运行,而包含 {skill_content} 的模板还要求已加载的正文。
以下命令针对的是单独的启用技能的运行时。请将 skills-evaluation/agent_config.json 中的运行时名称(agent_id 或 agent_arn)替换到
运行按需评估
使用按需评估来调查某个会话、验证最近的更改,或评估暂存的流量:
agentcore run eval \
  --runtime\
  --evaluator Builtin.SkillSelectionAccuracy Builtin.SkillInstructionFollowing \
  --session-id
运行批量评估
使用批量评估一次性对多个已存储的会话进行评分,例如在技能目录变更前建立基线:
agentcore run batch-evaluation \
  --runtime\
  --evaluator Builtin.SkillSelectionAccuracy Builtin.SkillInstructionFollowing
配置持续在线评估
在线评估会对实时流量进行采样,以便检测精心设计的测试集未能预料到的行为:
agentcore add online-eval \
  --name HRSkillsProductionEval \
  --runtime\
  --evaluator Builtin.SkillSelectionAccuracy Builtin.SkillInstructionFollowing \
  --sampling-rate 100 \
  --enable-on-create
然后部署以配置在线评估:
agentcore deploy
持续评估特别适用于检测目录漂移(当新技能与现有描述重叠时)、未预料到的措辞(当真实请求与精心设计的测试提示不同时),以及长会话失败(当上下文增长导致指令遵循能力下降时)。
最佳实践
在评估智能体技能时,首先要内化的一点是:路由和执行是两种不同的失败模式,你的评估策略需要将它们清晰地区分开来。如果你看到较高的选择分数但较低的指令遵循分数,这表明路由器选择了正确的技能,但该技能没有被完全执行。相反的模式则意味着,如果该技能被调用,它本可以正常工作。将这两项评估一起运行,而不是将它们合并为一个通过/失败的数字,才能让你区分这两种情况。
在构建任何自定义内容之前,先从内置评估器开始建立基线,这样你之后添加的任何自定义逻辑都能覆盖基线实际遗漏的差距。对于你已经知道正确路由行为的需求,不要依赖评判模型来捕捉它。为每个必须触发的技能添加一个确定性的 SkillInvoked 断言。
在开始运行评估之后,要克制住只看聚合分数的冲动。逐步证据才是真正进行诊断的地方。它能告诉你某条指令是被完全覆盖、部分完成,还是被直接跳过,而这种细节程度正是将失败的评估转化为可操作修复的关键。这也是为什么你应该在每个生命周期阶段都进行评估,而不是等到最终输出。最终阶段的失败无法告诉你,是路由器将请求发送到了错误的地方,还是正确的技能执行得很差,而你需要这两个信号才能知道该修复什么。
技能级评估和端到端评估应该配对使用,因为一个技能可能执行得完美无缺,但对于当前请求来说仍然是错误的技能。你可以通过编写真正具有区分度的技能描述,在上游减少大量这种模糊性。同样的逻辑也适用于技能的范围。一个为处理六个不相关功能而构建的技能,没有单一的正确行为定义,这使得一致地评估它几乎不可能。
明确说明只应评估给定运行中实际走过的路径,否则未走的分支会被错误地计为跳过的步骤,并悄无声息地破坏你的通过率。在你信任这些分数之前,要验证你的提取管道确实能对实时追踪数据正常工作。
当你跨工具扩展这套方案时,阈值可能无法干净地迁移。每个评估面都需要按照自身标准进行校准,因为在 Strands Evals 上通过的分数和在 AgentCore Evaluations 上通过的分数并不保证含义相同。最终,这些都不应该存在于你的部署管道之外。技能质量回归需要像失败的单元测试一样阻止发布,否则你到目前为止所做的评估工作实际上并没有保护生产环境。
结论
技能让智能体的专业化变得成本低廉,但一个看似合理的最终答案并不能证明智能体选择了正确的流程或遵循了该流程。技能选择准确率和技能指令遵循将这两种失败模式区分开来,并为每个被调用的技能返回证据。在 Strands Evals 中,SkillInvoked 为已知的路由需求添加了一个确定性守卫。在 AgentCore Evaluations 中,这两个基于评判的指标可以针对特定会话按需运行,也可以对已存储的会话进行批量运行,或对采样流量持续运行。
当你拥有可以重新运行的测试用例和录制的轨迹时,使用 Strands Evals。当你想评估来自预发布或实时智能体的 OpenTelemetry 追踪数据时,使用 AgentCore Evaluations。许多团队会同时使用两者:在部署前使用确定性和基于评判的门禁,然后在生产环境中进行基于追踪的监控。
开始使用
Strands Evals 快速入门。
Strands Evals 代码仓库。
Amazon Bedrock AgentCore Evaluations 开发者指南。
评估 AI 智能体博客文章。
致谢
感谢 Ritvika Pillai、Vincent Chen、Qiaoxuan Xue 和 Shoaib Javed 完成 AgentCore Evaluations 的实现,感谢 Po-Shin Chen 对 Strands Evals 的审阅,感谢 Anwesan Pal 关于技能评估的早期讨论,感谢 Ben Coombs 的产品指导,以及感谢所有帮助使这项工作成为可能的人。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文作者:Sangmin Woo;如有侵权,请联系管理员删除。

