尽管我们尽力避免,但性能不佳的查询很容易在我们的工作负载中悄然出现,对数据库系统的性能产生负面影响。在大规模数据库环境中尤其如此,这些环境拥有数 GB 或数 TB 的数据、数百张表,以及每天执行的数千种查询模式。
幸运的是,MySQL 能够收集可用于识别有问题的查询的数据,并且还可以对这些查询进行分析,以深入了解其性能不佳的原因。在本文中,我将介绍几种在原生 MySQL 中实现此目的的内置技术。如果你使用 PlanetScale,则可以使用 PlanetScale Insights 仪表板更轻松、更直观地收集此类信息。我将在后文简要讨论此功能。
在本文中,我将使用以下 schema 作为示例。
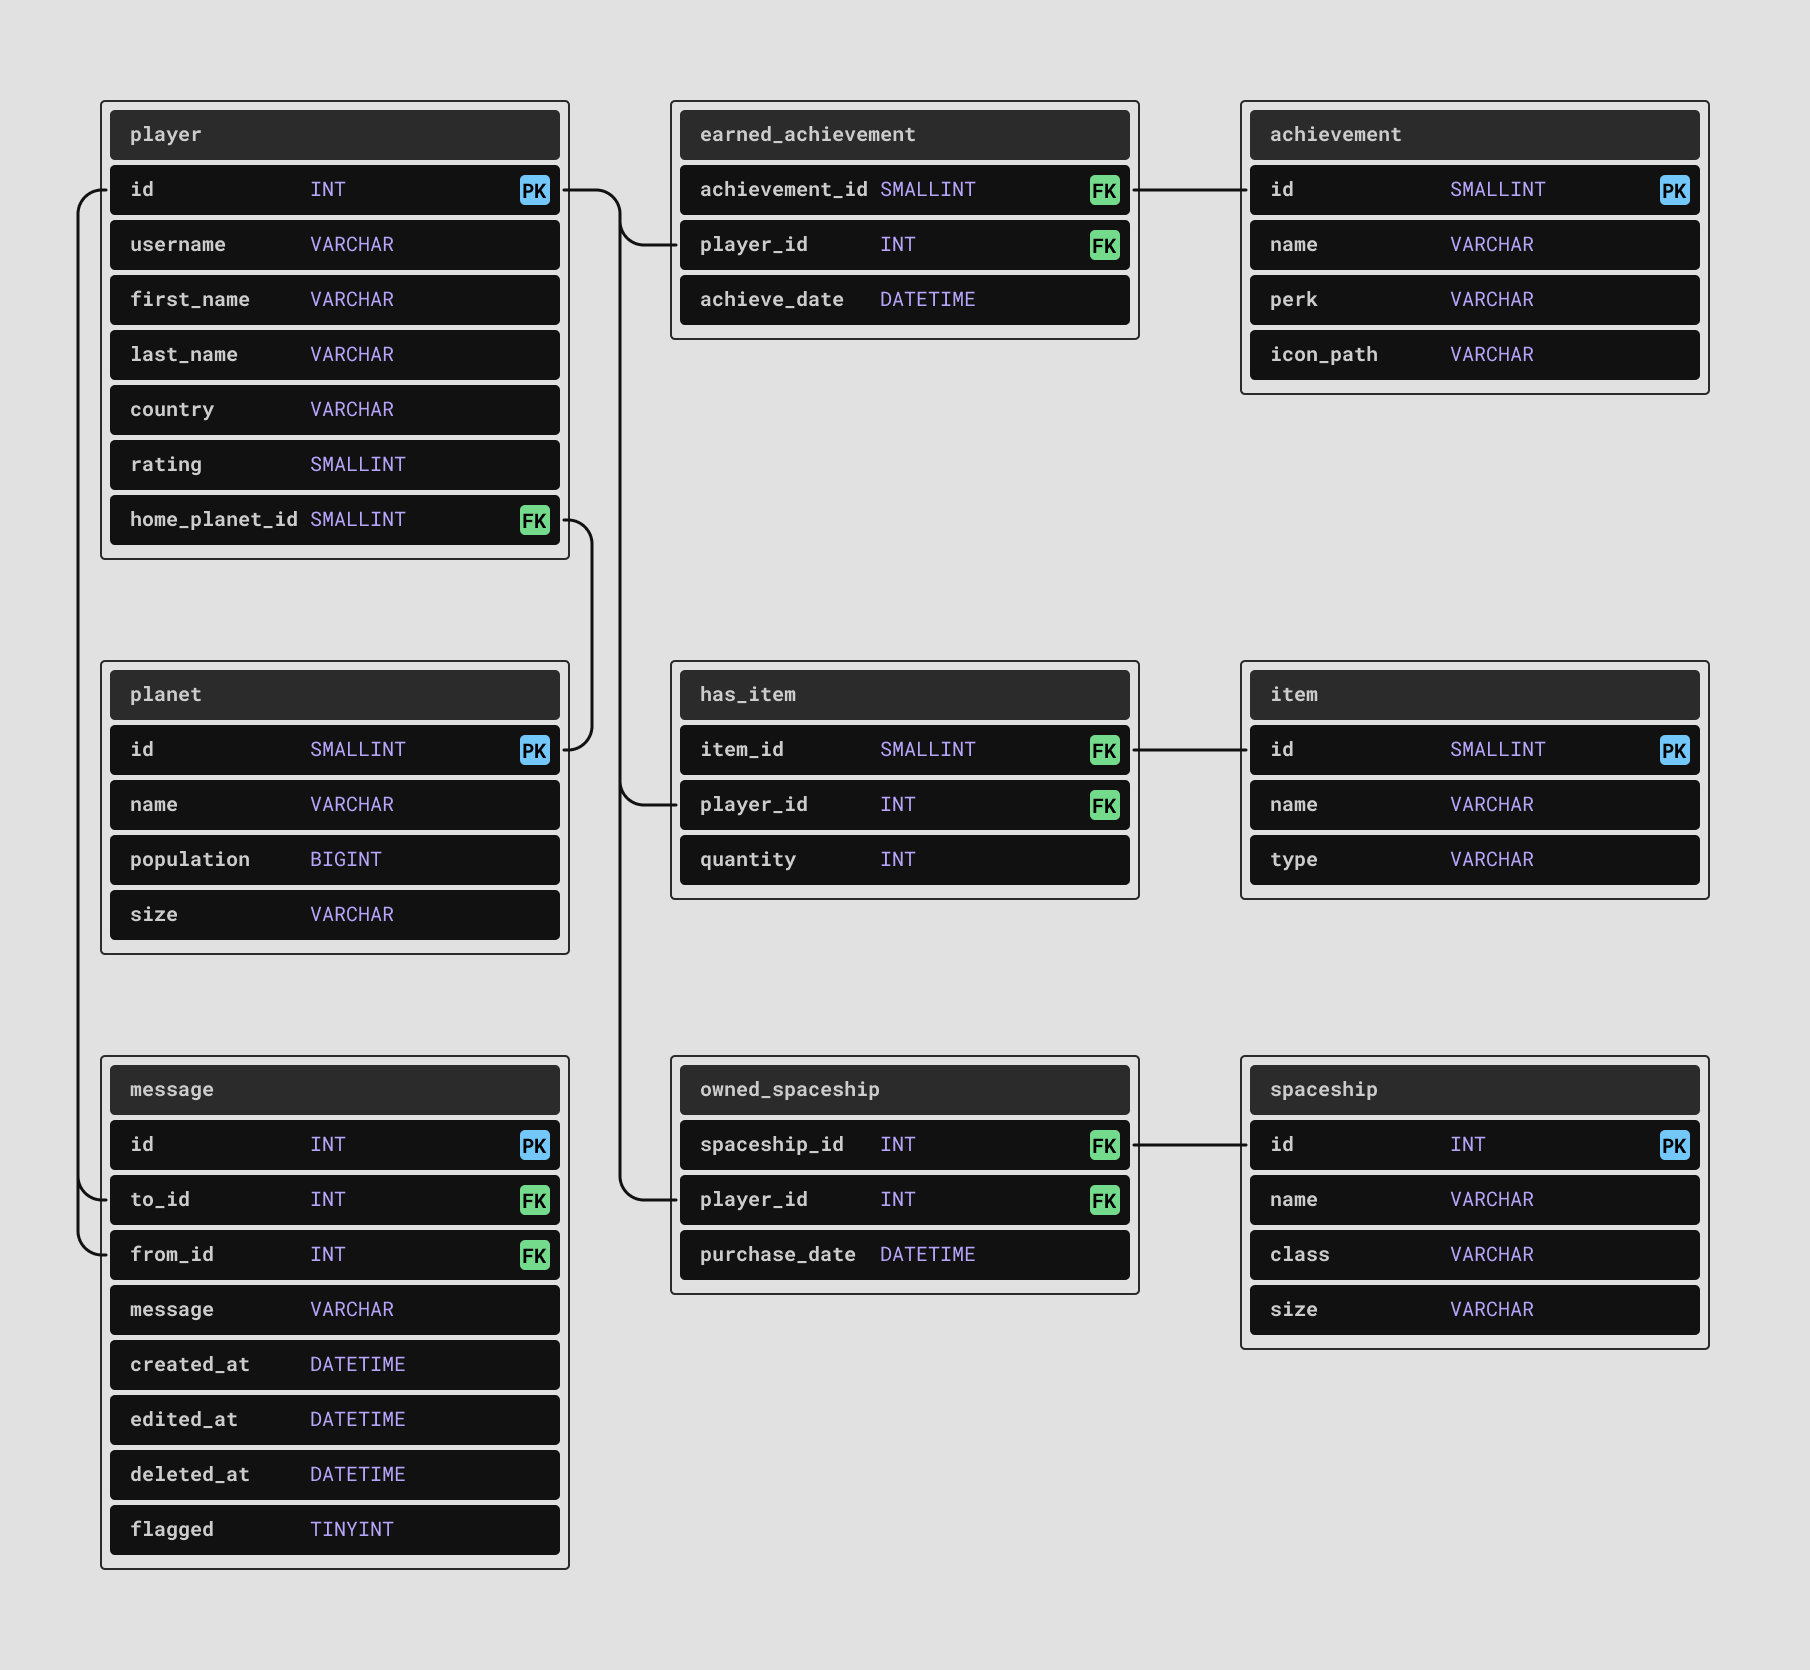
已在此数据库上运行了一个模拟工作负载,稍后你将看到一些操作这些表的查询。
启用 performance_schema
如果你有一个大型应用程序在数据库上执行大量查询,那么要知道从哪里开始查找问题可能会让人不知所措。你如何知道哪些查询性能不佳?确定这一点的一种方法是在 shell 会话中手动执行查询并检查结果耗时。你也可以在浏览器中使用 Web 应用程序,查看哪些页面加载和请求似乎运行缓慢。然而,还有更系统化的方法来识别这些查询。
你可以使用 performance_schema 中表的信息来帮助我们识别这些查询。要使用它,首先切换到该数据库。
USE
performance_schema;
你还应检查以确保 performance_schema 已启用。它默认应处于启用状态,但如果运行 MySQL 的主机内存不足,则可以手动将其关闭或禁用,因为它跟踪的所有信息都存储在内存中的 PERFORMANCE_SCHEMA 存储引擎中。如果已启用,你应该会看到以下内容:
SHOW VARIABLES
LIKE
'performance_schema'
;
+
--------------------+-------+
| Variable_name      |
Value
|
+
--------------------+-------+
| performance_schema |
ON
|
+
--------------------+-------+
识别慢查询
下一步是确定应将精力集中在修复哪些查询上。你可以使用 performance_schema 和 sys 中的表来识别这些查询,有几种技术可供使用。performance_schema 数据库中有非常多的表:
SELECT
COUNT
(
*
)
FROM
information_schema
.
tables
WHERE
table_schema
=
'performance_schema'
;
+
----------+
|
COUNT
(
*
) |
+
----------+
|
113
|
+
----------+
(根据你的 MySQL 版本不同,你的数字可能会有所不同)。
一个很好的起点是查看 events_statements_summary_by_digest 表提供的信息。让我们先看一行,即平均执行次数最高的那一行:
SELECT
*
FROM
performance_schema
.
events_statements_summary_by_digest
WHERE
schema_name
=
'game'
ORDER BY
avg_timer_wait
DESC
LIMIT
1
\G;
***************************
[ 1. row ]
***************************
SCHEMA_NAME                 | game
DIGEST
| 8ee55a42fea07da3d5e786413a6c1bd...
DIGEST_TEXT                 |
SELECT
`p1`
.
`username`
,
`m`
...
COUNT_STAR                  |
2486
SUM_TIMER_WAIT              |
425862156000000
MIN_TIMER_WAIT              |
149411000000
AVG_TIMER_WAIT              |
171304165000
MAX_TIMER_WAIT              |
380467000000
SUM_LOCK_TIME               |
1306000000
...
每一行中有相当多的列。然而,如果你想查看最昂贵的查询,SUM_TIMER_WAIT 和 AVG_TIMER_WAIT 等列是值得关注的。这里显示的时间单位是皮秒,因此需要除以 1 万亿才能转换为秒。在本例中,AVG_TIMER_WAIT(该查询的平均时间)为 0.17 秒,而该查询仅执行了 7580 次(参见上方结果集中的 COUNT_STAR 值)。
sys 数据库中还有许多表保存着用于识别慢查询的有用统计信息。你可以查看 statements_with_sorting、statements_with_runtimes_in_95th_percentile 和 statements_with_full_table_scans 等表中的信息。举个例子,让我们从 statements_with_runtimes_in_95th_percentile 中查看平均检查行数最高的查询:
SELECT
substring
(query,
1
,
50
), avg_latency, rows_examined_avg
FROM
sys
.
statements_with_runtimes_in_95th_percentile
ORDER BY
rows_examined_avg
DESC
LIMIT
10
;
+
----------------------------------------------------+-------------+-------------------+
|
substring
(query,
1
,
50
)                              | avg_latency | rows_examined_avg |
+
----------------------------------------------------+-------------+-------------------+
|
SELECT
`alias`
FROM
`chat`
.
`message`
LIMIT
?     |
2
.
13
s      |
10000000
|
|
SELECT
`alias`
FROM
`message`
LIMIT
?              |
881
.
20
ms   |
2500004
|
| EXPLAIN ANALYZE
SELECT
`p1`
.  ...
` WHERE `
m
` . `
|
223
.
97
ms   |
1081990
|
|
SELECT
`p1`
.
`username`
,
`m`
...
` WHERE `
m
` . `
|
57
.
75
ms    |
421446
|
|
SELECT
*
FROM
`message`
LIMIT
?                    |
70
.
52
ms    |
125125
|
| EXPLAIN ANALYZE
SELECT
`id`
FR ... E
`created_at`
|
56
.
55
ms    |
100000
|
|
SELECT
`id`
FROM
`message`
WHERE
`created_at`
BETW |
58
.
28
ms    |
100000
|
|
SELECT
SUBSTRING
( QUERY , ?,  ... s_examined_avg
` | 76.72 ms    | 1498              |
| SELECT SUBSTRING ( QUERY , ?,  ... `
rows_examined
` | 75.59 ms    | 1495              |
| SELECT SUBSTRING ( QUERY , ?,  ... ned`
AS
DECIMAL
|
78
.
97
ms    |
1494
|
+
----------------------------------------------------+-------------+-------------------+
例如,你可能还有兴趣从表的角度而非查询的角度来查看问题。你可以按表查看有多少行读取是通过索引完成的,有多少是没有通过索引完成的。假设你有一个聊天数据库,其中有一个你知道被频繁使用的 message 表。你可以使用 table_io_waits_summary_by_index_usage 表找到这些统计信息。
SELECT
`OBJECT_SCHEMA`
,
`OBJECT_NAME`
,
`INDEX_NAME`
,
`COUNT_STAR`
FROM
performance_schema
.
table_io_waits_summary_by_index_usage
WHERE
object_schema
=
'game'
AND
object_name
=
'message'
;
+
---------------+-------------+------------+------------+
| OBJECT_SCHEMA | OBJECT_NAME | INDEX_NAME | COUNT_STAR |
+
---------------+-------------+------------+------------+
| game          |
message
|
PRIMARY
|
0
|
| game          |
message
| to_id      |
0
|
| game          |
message
| from_id    |
164500
|
| game          |
message
||
2574002473
|
+
---------------+-------------+------------+------------+
这表明有超过 20 亿次行读取没有通过索引完成(即 INDEX_NAME 为
在 sys 表中还有许多很酷的统计信息可以查看。这里有一个简单的例子。你可以使用 sys.statements_with_full_table_scans 表获取每个查询执行了多少次全表扫描的数据。
USE
sys;
SELECT
query, db, exec_count, total_latency
FROM
sys
.
statements_with_full_table_scans
ORDER BY
exec_count
DESC
LIMIT
5
;
+
-------------------------------------------------------------------+------+------------+---------------+
| query                                                             | db   | exec_count | total_latency |
+
-------------------------------------------------------------------+------+------------+---------------+
|
SELECT
`class`
,
`size`
FROM
`spaceship`
WHERE
`size`
>
?         | game |
8422
|
26
.
65
s       |
|
SELECT
`p1`
.
`username`
,
`m`
...
` WHERE `
m
` . `
created_at
` > ? | game | 6742       | 6.45 min      |
| SELECT * FROM `
earned_achievem ... id
` AND `
ea
` . `
player_id
` > ? | game | 6718       | 969.17 ms     |
| SELECT * FROM `
item
` WHERE NAME LIKE ? LIMIT ?                    | game | 5676       | 969.43 ms     |
| SELECT NAME , `
size
` FROM `
planet
` WHERE `
population
` > ?         | game | 5625       | 173.02 ms     |
+-------------------------------------------------------------------+------+------------+---------------+
这显示了哪些查询触发了全表扫描。在本例中,有大量全表扫描,但这是意料之中的,因为这个示例数据库除了主键上的默认索引外没有其他索引。
有关如何使用 performance_schema 和 sys 表的更多信息,请查看这个视频。
使用 EXPLAIN 进行检查
到目前为止,希望你已收集了一批需要进一步检查的查询。下一步是对这些查询为什么耗时过长、读取过多行进行根因分析。当然,深入了解查询行为的一个好方法是使用 EXPLAIN 或 EXPLAIN ANALYZE。在本例中,我将使用 EXPLAIN ANALYZE。
例如,运行以下查询:
EXPLAIN ANALYZE
SELECT
p1
.
username
,
m
.
to_id
,
p2
.
username
,
m
.
from_id
FROM
message
m
LEFT JOIN
player p1
ON
m
.
to_id
=
p1
.
id
LEFT JOIN
player p2
ON
m
.
from_id
=
p2
.
id
WHERE
m
.
created_at
>
'2020-10-10 00:00:00'
;
提供有关查询计划及各步骤成本的详细信息。
+
--------------------------------------------------------------------------------------------------------------------------------------------+
| EXPLAIN                                                                                                                                    |
+
--------------------------------------------------------------------------------------------------------------------------------------------+
|
->
Nested
loop
left join
(cost
=
333272
rows=
332036
) (actual
time=
0
.
515
..
320
rows=
345454
loops
=
1
)                                           |
|
->
Nested
loop
left join
(cost
=
217059
rows=
332036
) (actual
time=
0
.
475
..
240
rows=
345454
loops
=
1
)                                       |
|
->
Filter
: (
m
.
created_at
>
TIMESTAMP
'2020-10-10 00:00:00'
)  (cost
=
100846
rows=
332036
) (actual
time=
0
.
153
..
188
rows=
345454
loops
=
1
) |
|
->
Table
scan
on
m  (cost
=
100846
rows=
996208
) (actual
time=
0
.
148
..
159
rows=
1e
+
6
loops
=
1
)                                       |
|
->
Single
-row
index
lookup
on
p1
using
PRIMARY
(id
=
m
.
to_id
)  (cost
=
0
.
25
rows=
1
) (actual
time=
54
.5e
-
6
..
70
.9e
-
6
rows=
1
loops
=
345454
) |
|
->
Single
-row
index
lookup
on
p2
using
PRIMARY
(id
=
m
.
from_id
)  (cost
=
0
.
25
rows=
1
) (actual
time=
137e
-
6
..153e
-
6
rows=
1
loops
=
345454
)     |
+
--------------------------------------------------------------------------------------------------------------------------------------------+
检查此输出时,有许多方面需要关注。通常,如果你看到对大表进行表扫描,这是你应该尝试通过索引来缓解的问题。更广泛地说,每当你看到某个节点的成本或行数值很高时,这很可能值得进一步调优。也许查询可以重写,或者一个或多个索引可以帮助提升性能。
有关 EXPLAIN 的更多信息,请参阅我们的 MySQL for Developers 课程或我们的 How to read MySQL EXPLAINS 博客文章。
准备对查询进行插桩
Explain 是一个很好的工具,但你也可以对查询进行性能分析,以确定它在每个执行阶段花费了多少时间。要做到这一点,首先确保启用了适当的 instruments 和 consumers,以便能够适当地收集信息。为此,请运行以下命令:
UPDATE
performance_schema
.
setup_instruments
SET
ENABLED
=
'YES'
, TIMED
=
'YES'
;
UPDATE
performance_schema
.
setup_consumers
SET
ENABLED
=
'YES'
,
TIMES
=
'YES'
;
如果你愿意,可以在此步骤中更具选择性。不必为所有 instruments 和 consumers 启用此设置,你可以仅启用这两个表中行的子集。要为查询执行阶段启用它,可以运行以下命令。
UPDATE
performance_schema
.
setup_instruments
SET
ENABLED
=
'NO'
, TIMED
=
'NO'
;
UPDATE
performance_schema
.
setup_instruments
SET
ENABLED
=
'YES'
, TIMED
=
'YES'
WHERE
NAME
LIKE
'%stage/%'
;
最终,这取决于你对性能分析可能带来的性能影响有多大的接受程度。如果你不太担心性能分析的开销,就全部打开,然后在完成后禁用即可。
接下来,确保启用了历史记录跟踪。如果你之前没有配置过,查看 setup_actors 配置时,你可能会看到以下内容:
SELECT
*
FROM
performance_schema
.
setup_actors
;
+
------+------+------+---------+---------+
| HOST | USER |
ROLE
|
ENABLED
| HISTORY |
+
------+------+------+---------+---------+
| %    | %    | %    | YES     | YES     |
+
------+------+------+---------+---------+
如果你愿意,可以保持这些设置不变。然而,这意味着 performance schema 和历史记录跟踪将对所有用户启用。这可能会对你系统的整体性能产生(轻微的)不利影响。你可以选择仅为一个特定用户启用它(这将是需要在其上运行测试查询的用户)。如果你选择这种方式,请全局关闭它:
UPDATE
performance_schema
.
setup_actors
SET
ENABLED
=
'NO'
, HISTORY
=
'NO'
WHERE
HOST
=
'%'
AND
USER
=
'%'
;
然后仅为你想要跟踪的用户启用它:
INSERT INTO
performance_schema
.
setup_actors
(HOST, USER,
ROLE
,
ENABLED
, HISTORY)
VALUES
(
'your_host'
,
'your_user'
,
'%'
,
'YES'
,
'YES'
);
对查询进行性能分析
现在,让我们对其中一个有问题的查询进行性能分析。首先,获取你将要在其上运行查询的连接的 ID。
SET @connection_thread = (
SELECT thread_id
FROM performance_schema.threads
WHERE PROCESSLIST_ID = CONNECTION_ID() );
接下来,执行你想要分析的查询。执行完此操作后,立即运行以下查询,以确定该执行的起始事件 ID:
SELECT thread_id, statement_id, SUBSTRING(sql_text,1,50)
FROM performance_schema.events_statements_history_long
WHERE thread_id = @connection_thread
ORDER BY event_id DESC LIMIT 20;
找到你想要分析的语句,并将其 ID 放入一个变量中。
SET @statement_id = ?;
最后,运行以下命令以查看该查询执行的分析信息。
SET @eid = (SELECT event_id FROM performance_schema.events_statements_history_long WHERE statement_id = @statement_id);
SET @eeid = (SELECT end_event_id FROM performance_schema.events_statements_history_long WHERE statement_id = @statement_id);
SELECT event_name, source, (timer_end-timer_start)/1000000000 as 'milliseconds'
FROM performance_schema.events_stages_history_long
WHERE event_id BETWEEN @eid AND @eeid;
这应该会提供一个类似这样的时间分解:
+
------------------------------------------------+----------------------------------+--------------+
| event_name                                     | source                           | milliseconds |
+
------------------------------------------------+----------------------------------+--------------+
| stage
/sql/
starting                             |
init_net_server_extension
.
cc
:
110
|
0
.
2400
|
| stage
/sql/
Executing hook
on
transaction
begin
. |
rpl_handler
.
cc
:
1481
|
0
.
0010
|
| stage
/sql/
starting                             |
rpl_handler
.
cc
:
1483
|
0
.
0110
|
| stage
/sql/
checking permissions                 |
sql_authorization
.
cc
:
2169
|
0
.
0020
|
| stage
/sql/
checking permissions                 |
sql_authorization
.
cc
:
2169
|
0
.
0000
|
| stage
/sql/
checking permissions                 |
sql_authorization
.
cc
:
2169
|
0
.
0030
|
| stage
/sql/
Opening tables                       |
sql_base
.
cc
:
5859
|
0
.
0950
|
| stage
/sql/init
|
sql_select
.
cc
:
759
|
0
.
0050
|
| stage
/sql/System
lock                          |
lock
.
cc
:
331
|
0
.
0110
|
| stage
/sql/
optimizing                           |
sql_optimizer
.
cc
:
355
|
0
.
0270
|
| stage
/sql/statistics
|
sql_optimizer
.
cc
:
699
|
0
.
1040
|
| stage
/sql/
preparing                            |
sql_optimizer
.
cc
:
783
|
0
.
0590
|
| stage
/sql/
executing                            |
sql_union
.
cc
:
1676
|
735
.
3020
|
| stage
/sql/end
|
sql_select
.
cc
:
795
|
0
.
0010
|
| stage
/sql/
query
end
|
sql_parse
.
cc
:
4805
|
0
.
0020
|
| stage
/sql/
waiting
for
handler
commit
|
handler
.
cc
:
1636
|
0
.
0060
|
| stage
/sql/
closing tables                       |
sql_parse
.
cc
:
4869
|
0
.
0080
|
| stage
/sql/
freeing items                        |
sql_parse
.
cc
:
5343
|
0
.
2810
|
| stage
/sql/
cleaning up                          |
sql_parse
.
cc
:
2387
|
0
.
0010
|
+
------------------------------------------------+----------------------------------+--------------+
在这种情况下,你可以看到查询大部分时间都花在执行阶段。然而,这也会揭示查询是否花费了大量时间等待锁或进行优化,如果是这样,你可以进一步深入调查问题。
PlanetScale Insights
正如我们所见,MySQL 提供了大量能力来深入分析工作负载中的问题查询,而我们这里讨论的实际上只是冰山一角。然而,也应该清楚的是,收集这些信息可能很繁琐。要准确获取你想要的信息,需要在 performance_schema 和 sys 中大量翻找和挖掘表。
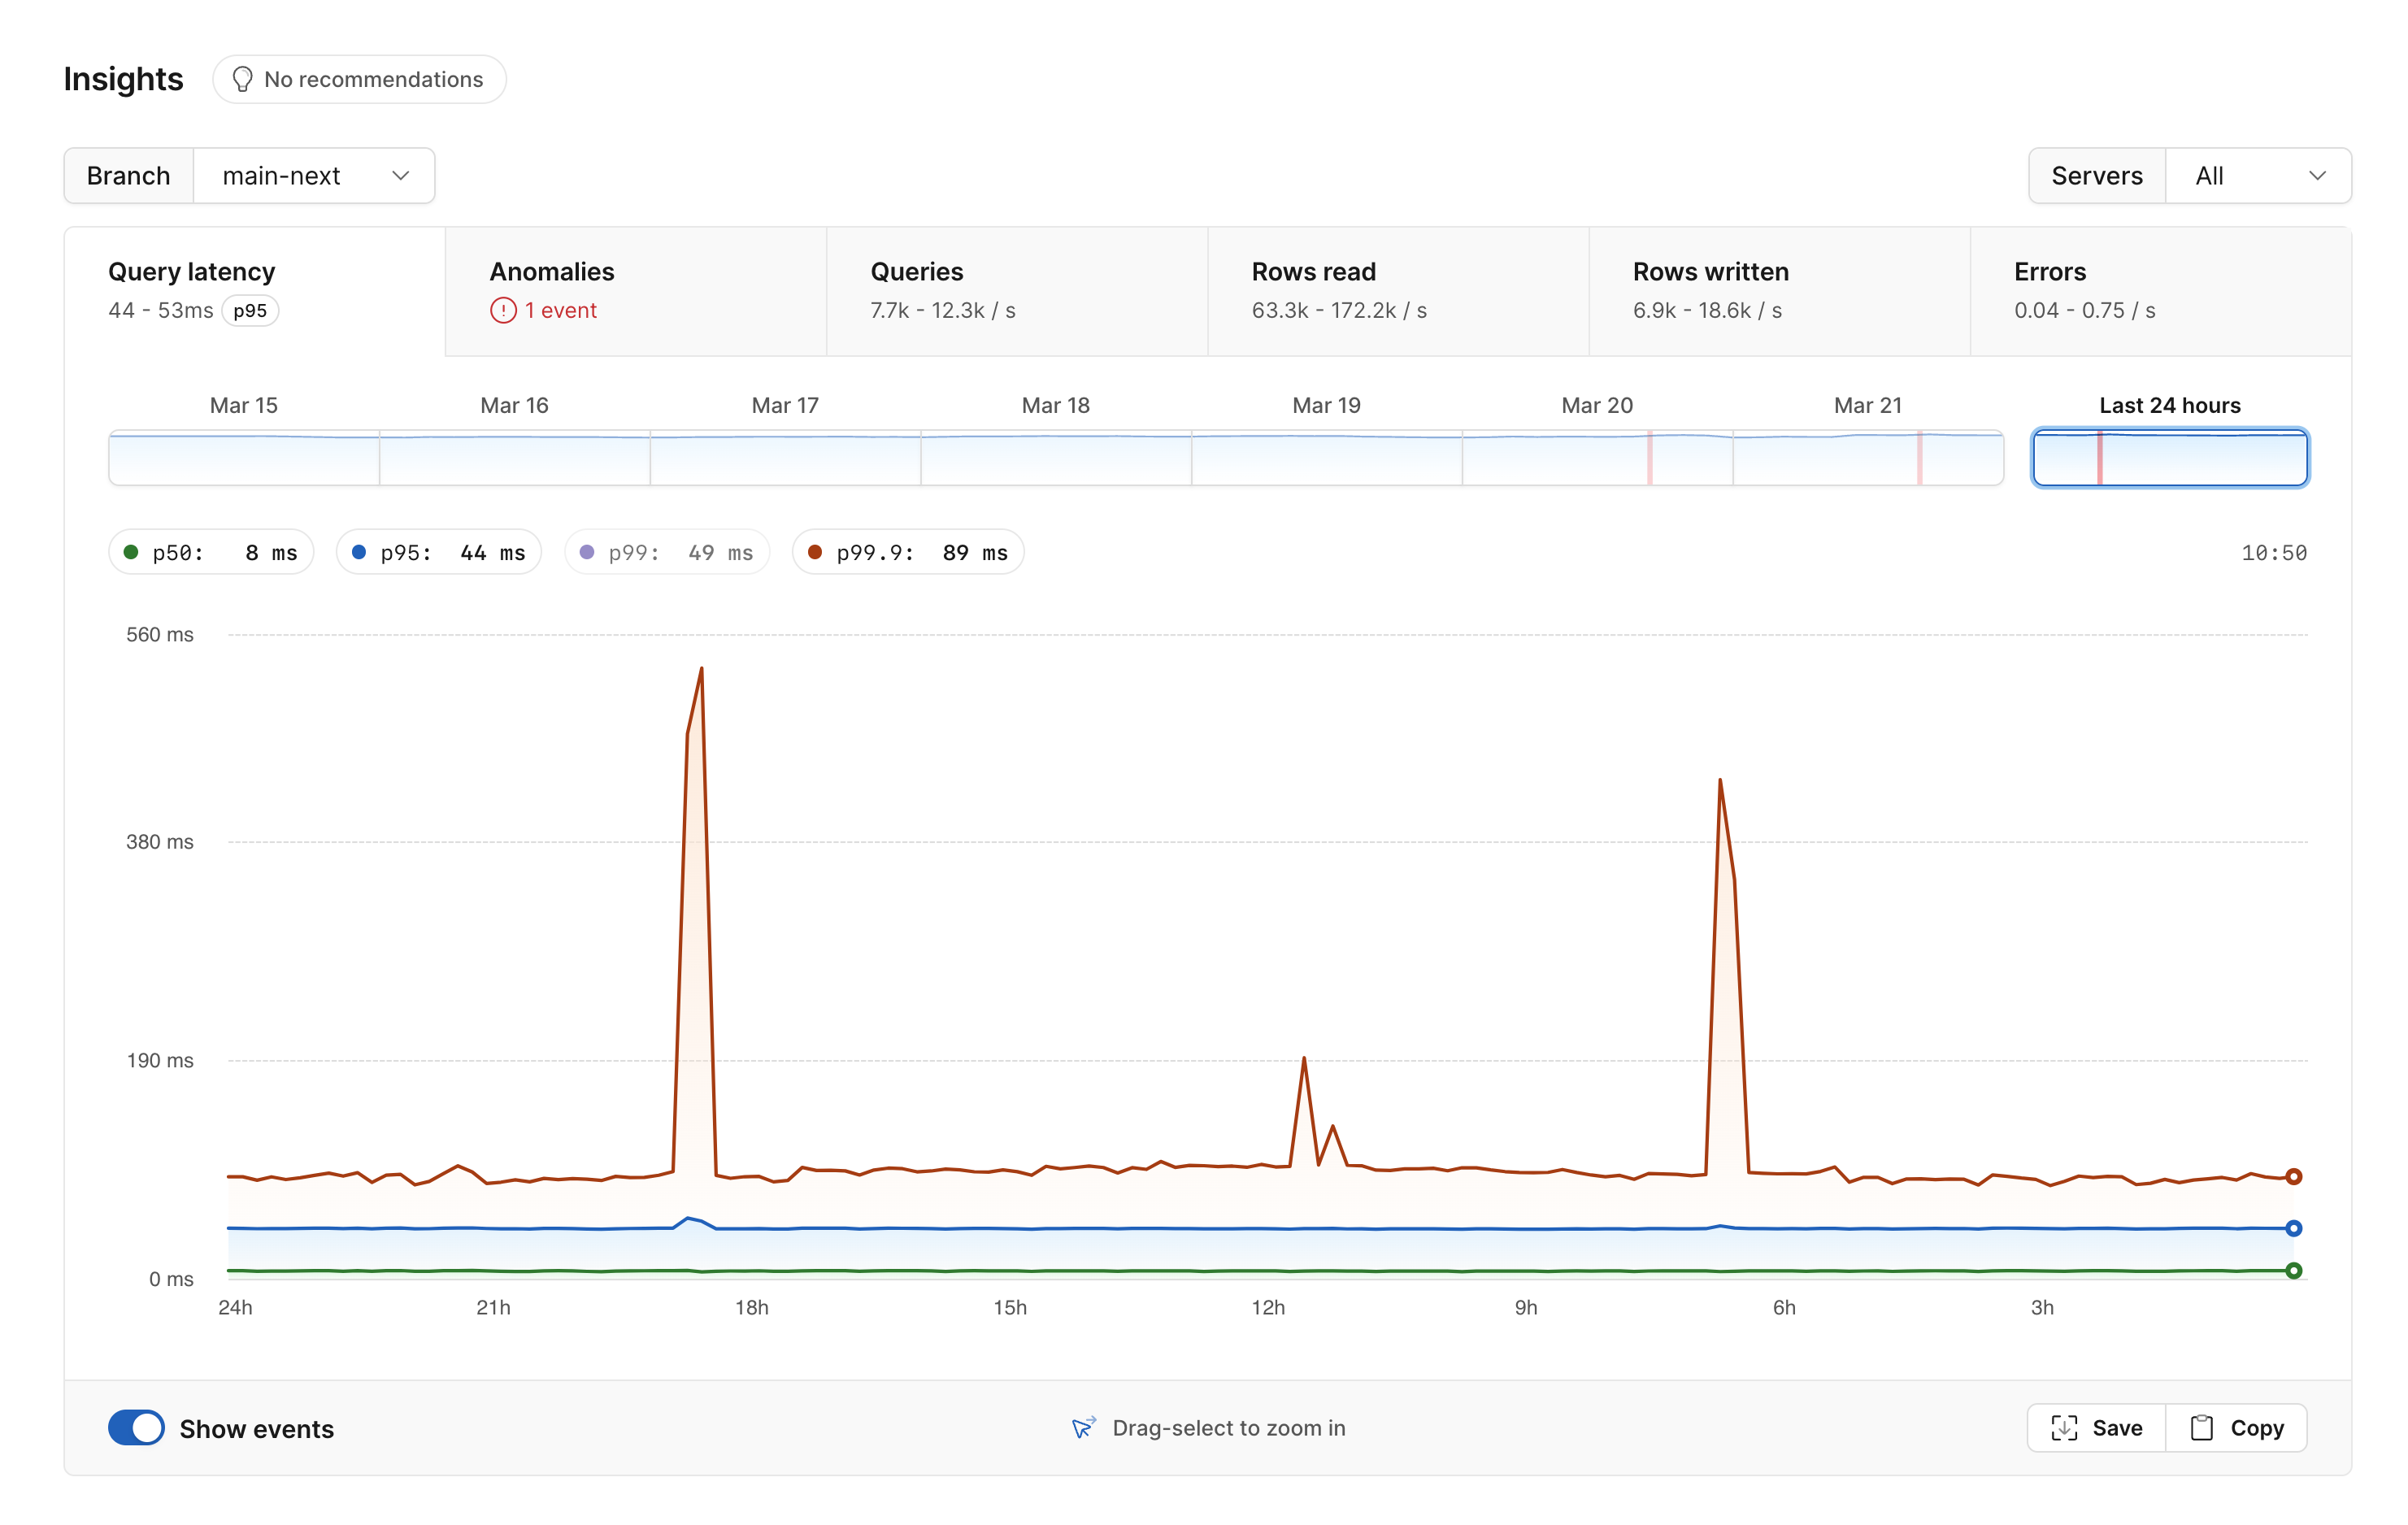
许多相同的观察结果可以通过 PlanetScale Insights 更轻松地收集。Insights 提供了大量有用的可视化,帮助你概览数据库性能,并自动检测异常行为。
你也可以使用它来深入分析特定查询。例如,你可以查看某个时间窗口内执行的所有查询,并按不同统计信息(如读取行数)排序。这可以帮助你快速识别慢查询以及可能值得添加索引的查询。
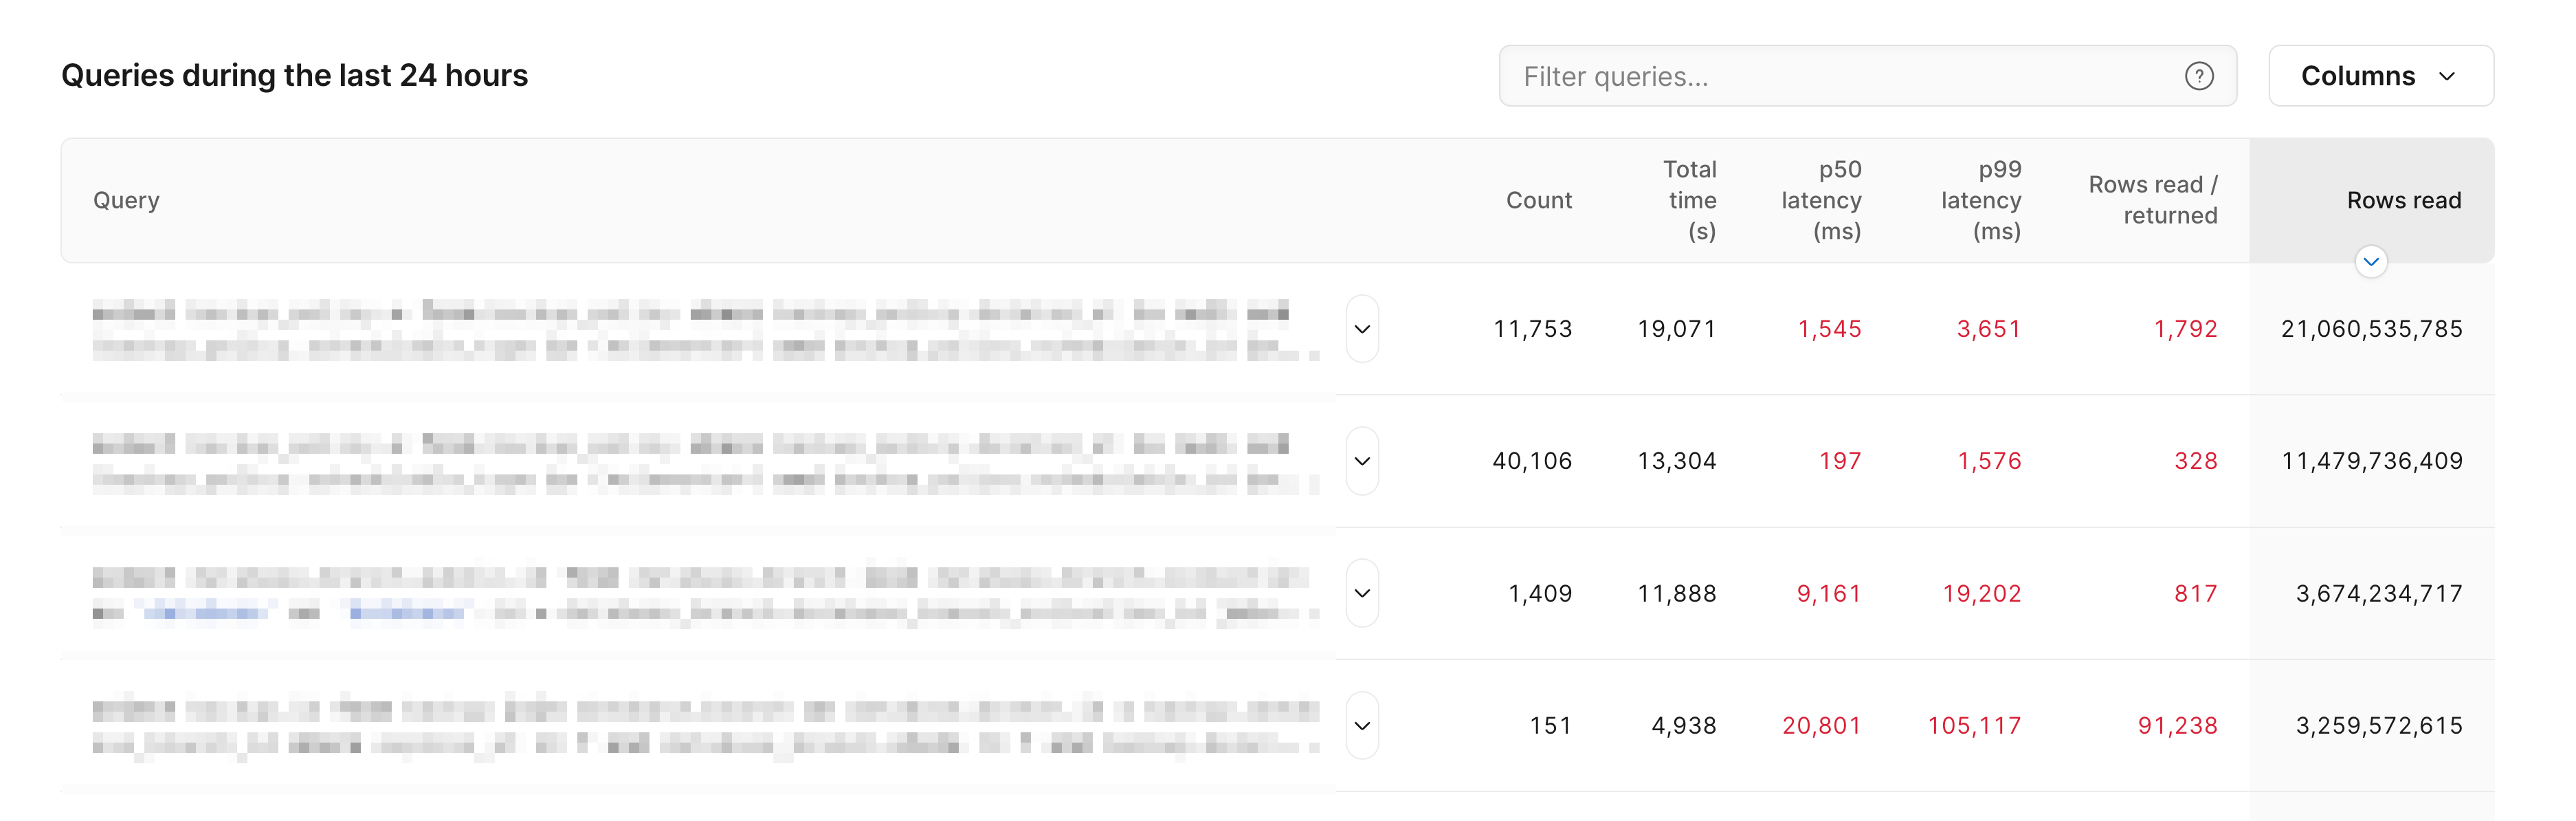
Insights 允许你深入了解你的工作负载。这让你有更多时间专注于改进查询、开发软件和高效工作。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/identifying-and-profiling-problematic-mysql-queries
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

