Thinking Machines Lab 发布了 Inkling,这是一个拥有 9750 亿参数的开源权重混合专家(MoE)模型。每个 token 激活 410 亿参数,并支持高达 1,048,576 个 token 的上下文窗口。
这些数字使 Inkling 与 Kimi K2.5 和 GLM-5.2 处于大致相同的规模级别。然而,该架构有几个我较少见到的细节,包括每个解码器块内部的短卷积,以及用可学习的相对位置偏置替代 RoPE。
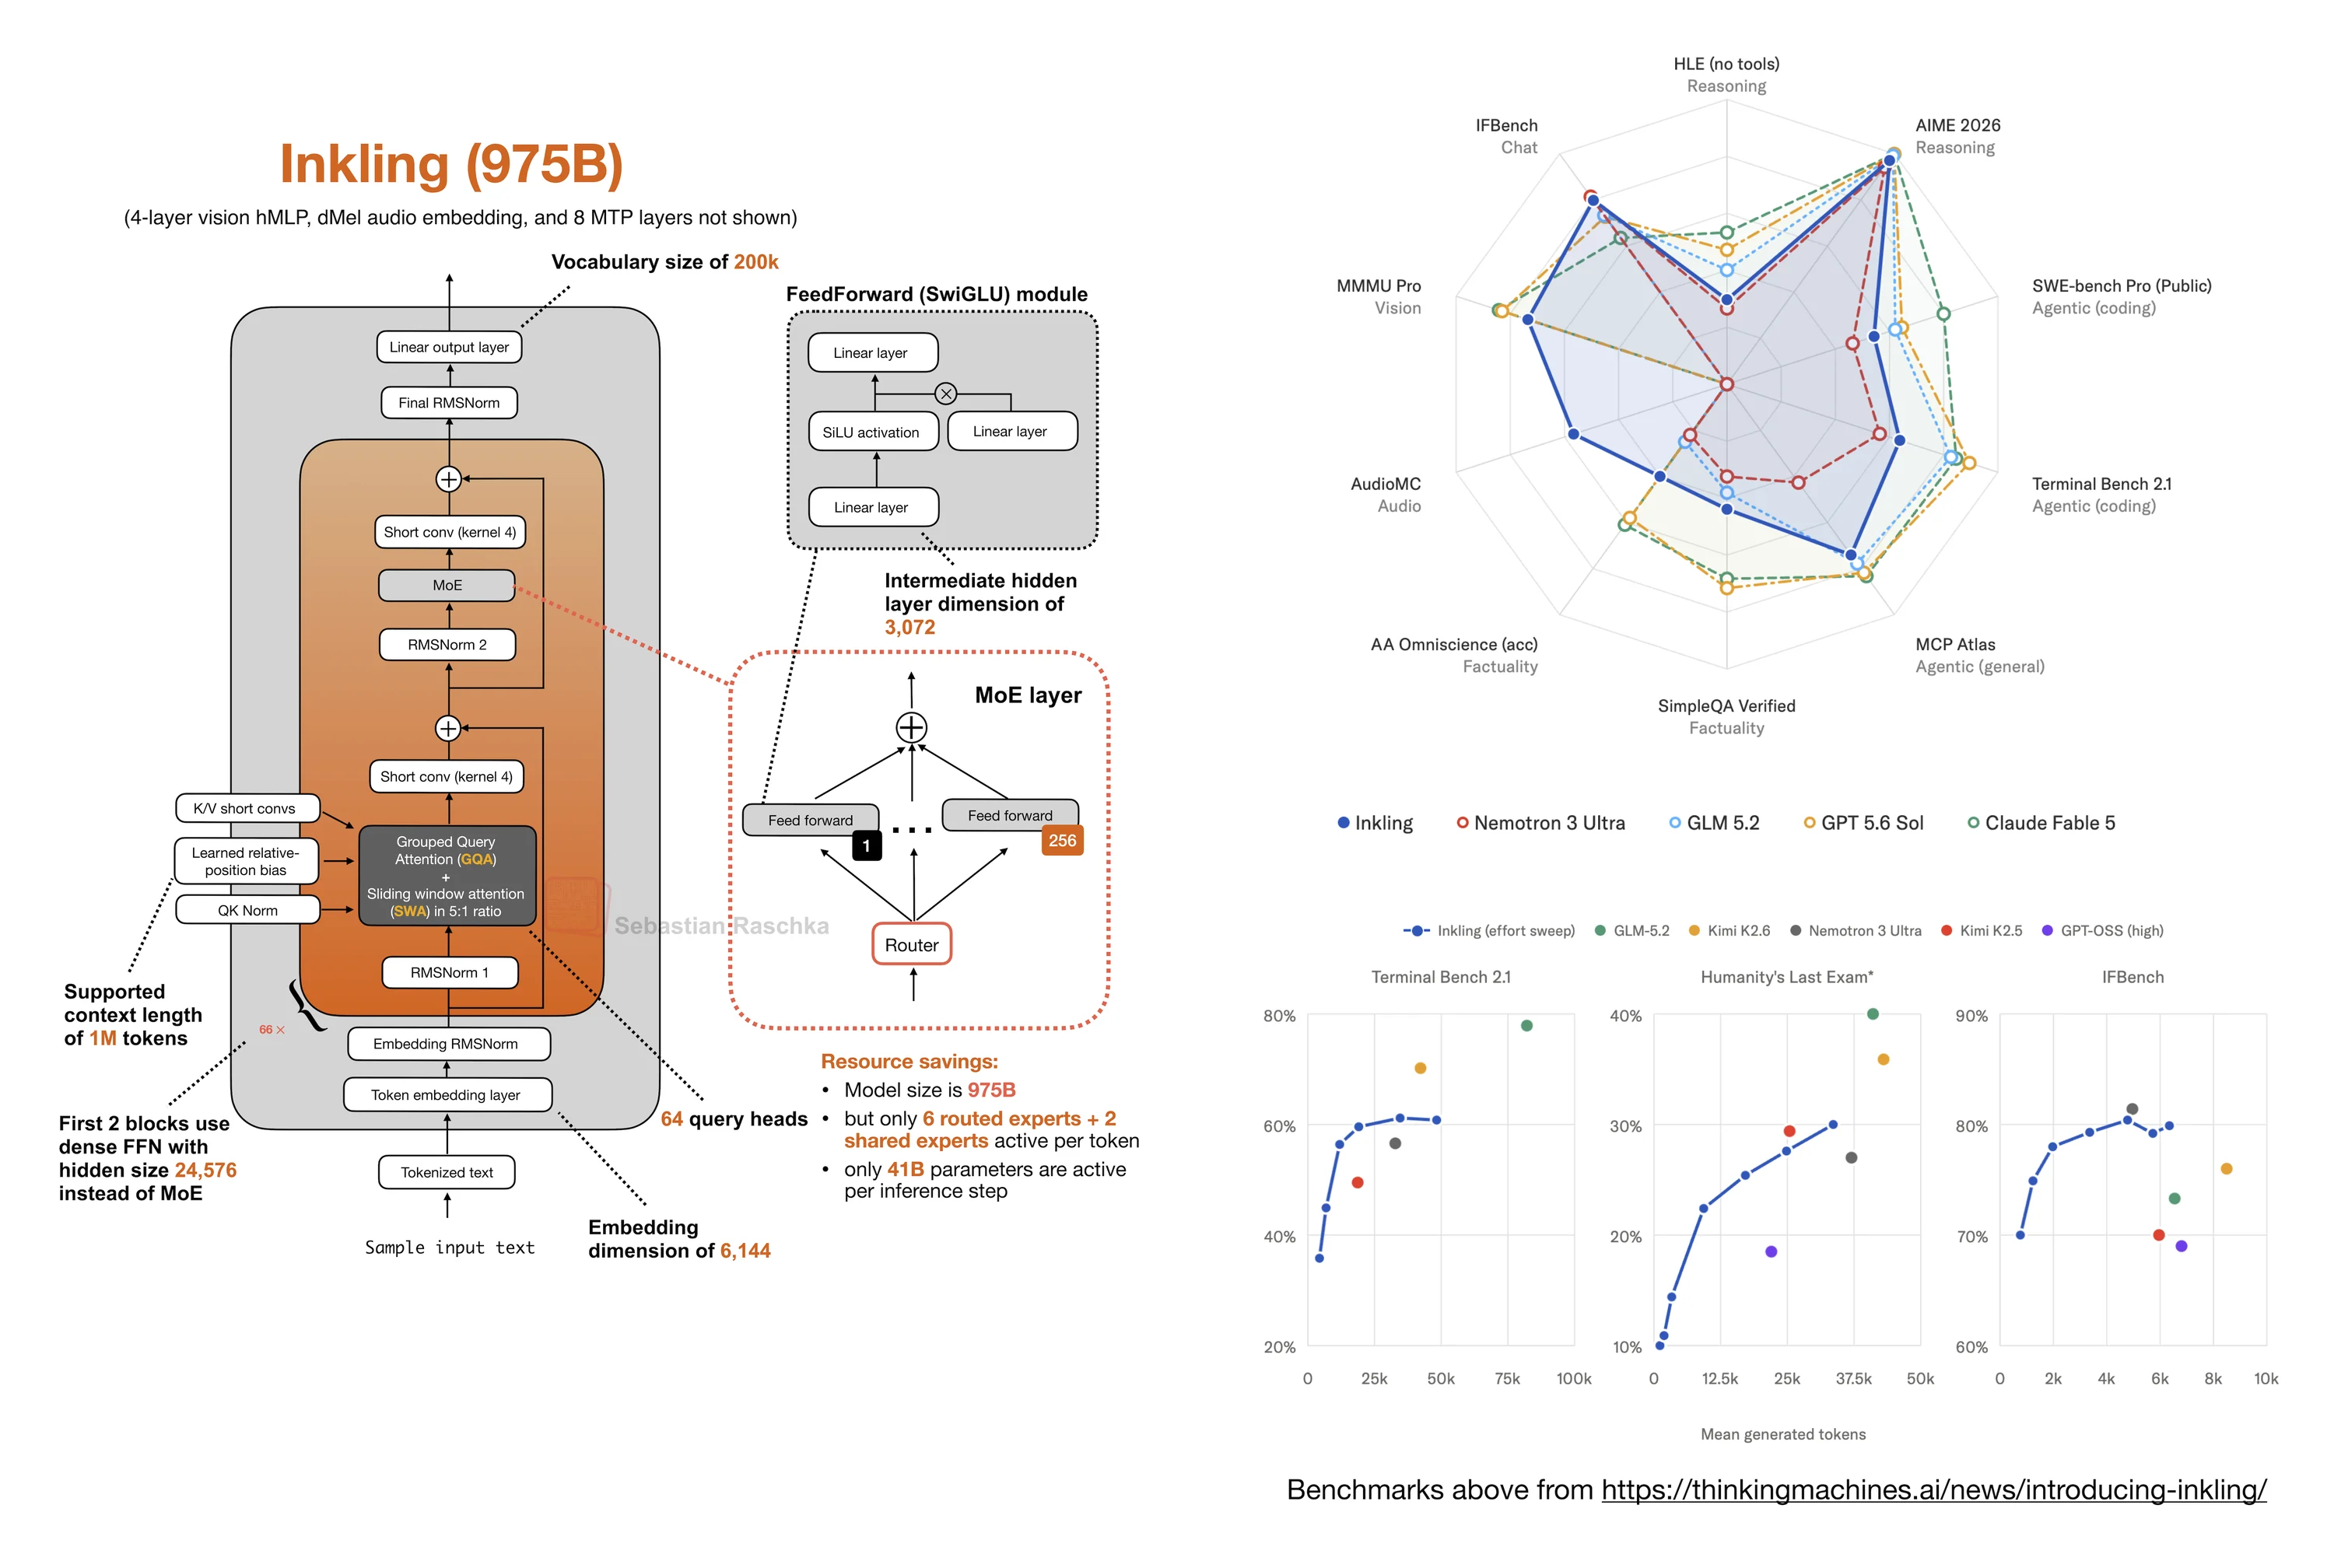
410 亿激活参数规模
Inkling 有 66 个解码器层,隐藏维度为 6,144。前两层使用稠密前馈块。其余层包含 256 个路由专家和 2 个共享专家。每个 token 选择 6 个路由专家,且两个共享专家始终处于激活状态。
这算下来激活比例约为 4.2%。作为对比,GLM-5.2 总参数为 7440 亿、激活参数为 400 亿,而 Kimi K2.5 总参数为 1 万亿、激活参数为 320 亿。因此,尽管 Inkling 的总参数比 GLM-5.2 多出 2310 亿,其激活规模却与 GLM-5.2 接近。
Inkling 还是一个原生多模态模型。图像和视频帧通过一个四层 hMLP 处理,而音频则使用 Thinking Machines Lab 提出的 dMel 表示。由此得到的表示与文本一起进入同一个解码器,模型输出文本。
局部与全局分组查询注意力
在 66 个解码器层中,55 层使用滑动窗口注意力,11 层使用全局注意力。这使 Inkling 形成重复的 5 比 1 局部-全局模式。局部层具有 512 个 token 的窗口,并使用 64 个查询头和 16 个键值头,即 4 比 1 的分组查询注意力(GQA)比例。全局层保留 64 个查询头,但仅使用 8 个键值头,将 GQA 比例提高到 8 比 1。
不寻常之处在于位置信息。Inkling 跳过了 RoPE,转而根据查询和键状态计算一个可学习的、依赖输入的相对位置偏置。它还在注意力之前对查询头和键头应用 RMS 归一化。
该偏置在局部层中覆盖完整的 512 个 token 跨度。在全局层中,其配置范围为 1,024 个 token。更靠后的 token 仍然可以被关注,但它们不会获得显式的可学习相对位置项。如果只阅读发布文章,这个细节很容易被忽略。它在配置和 Transformers 实现中是可见的。
每层四个短卷积
每个解码器层包含四个卷积核大小为 4 的因果卷积。其中两个直接在键和值投影之后运行。另外两个处理注意力分支和 MoE 分支的输出,之后这些输出汇入残差流。
这些小卷积为模块提供了一条显式路径,用于在邻近 token 之间混合信息。该发布未包含隔离其效果的消融实验,因此尚不清楚 Inkling 的质量或训练稳定性在多大程度上来自这一选择。
还有一个归一化细节。在 token 嵌入查找之后、第一个解码器块之前,直接应用了一个单独的 RMSNorm。该嵌入归一化在发布的配置中已启用,并在实现中表现为一个独立的操作。
训练与努力控制
Thinking Machines Lab 报告了 45T 预训练 token,涵盖文本、图像、音频和视频。训练设置对模型的大型矩阵参数使用 Muon,对其余参数使用 Adam。权重衰减与学习率的平方耦合。
后训练始于对来自开放权重教师模型(包括 Kimi K2.5)的合成数据进行监督微调。随后,大部分后训练算力投入到跨合成环境和人类创建环境的强化学习中。据该发布称,团队收集了超过 3000 万条 RL rollout。
一个实际成果是努力控制。一条系统消息告诉 Inkling 应投入多少努力,而训练期间的每 token 成本则鼓励更短或更长的回答。这对于在输出长度与基准性能之间进行权衡而无需维护单独的检查点非常有用。
混合基准快照
所报告的 GLM-5.2 对比说明了 Inkling 的整体基准概况。Inkling 在 IFBench 上得分为 79.8,而 GLM-5.2 为 73.3;在 SimpleQA Verified 上为 43.9 对 38.1。GLM-5.2 在无工具 HLE 上以 40.1 对 29.7 领先,在 SWE-Bench Pro Public 上以 62.1 对 54.3 领先,在 Terminal-Bench 2.1 上以 82.7 对 63.8 领先。
我会将这些视为发布时的快照。所有 Inkling 结果均使用 0.99 的努力设置和 1.0 的温度。编码评估允许轨迹最多 256K token。若干对比数值来自外部报告,而 Inkling 的 Terminal-Bench 结果使用内部测试框架。在此类设置下,微小差距很难解读。
该发布还展示了努力扫描,而非单一操作点。在 Terminal-Bench 上,Thinking Machines Lab 报告称 Inkling 在生成约三分之一 token 的情况下达到了 Nemotron 3 Ultra 的分数。这是一个有用的结果,尽管提供商级别的吞吐量比较仍需要相同的量化、批大小、专家并行设置、注意力内核和硬件。
对我来说,未解决的问题现在相当具体。我希望看到针对短卷积、嵌入归一化和相对位置偏置的受控消融实验。我还希望看到与 Kimi K2.5 和 GLM-5.2 直接可比的吞吐量测量。这些结果将阐明 Inkling 的架构选择主要改善的是质量、长上下文行为、训练稳定性,还是服务效率。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原创地址:https://sebastianraschka.com/blog/2026/inkling-architecture-benchmark-notes.html
原文作者:Sebastian Raschka;如有侵权,请联系管理员删除。

