今天,我们在 PlanetScale Insights 中发布了一项新功能:针对 PostgreSQL 数据库的 AI 驱动索引建议。该功能会监控您的数据库工作负载,并定期建议新索引,以提升查询执行速度和整体数据库性能。本博客文章介绍了我们如何将 LLM(大语言模型)与稳健的验证机制相结合,从而生成高质量的索引建议。
概述
为数据库找到合适的索引是维护数据库健康最常见、最关键的操作之一。这不仅需要在创建表时完成,还需要随着应用程序的演进和查询模式的变化持续重新审视。
我们使用 LLM(大语言模型) 聊天工具的经验清楚地表明,LLM 能够找到提升查询性能的索引。在给定一组需要优化的查询时,LLM 往往能找到最优索引。不过,我们需要解决两个问题。
首先,LLM 并不总是擅长判断某些内容是否需要修改。面对一个问题,LLM 很擅长找到答案,但并不总能被信任去判断也许根本不需要做任何更改。我们在这方面具有优势,可以利用 Insights 收集的查询性能数据,在首先确认存在可能需要索引的查询之后,再请求索引建议。
其次,LLM 有时会产生不准确的结果。任何使用过 LLM 工具进行软件开发的人都可以告诉您,在将 LLM 生成的解决方案发布到生产环境之前进行验证至关重要。在我们建议客户对其生产数据库进行更改之前,需要确保我们的建议确实能产生预期效果。为此,我们会测量相关查询在采用和不采用每个建议索引时的预估性能,并且只展示能够带来显著改善的建议。
我们推出 Postgres 索引建议的目标,不仅是让您免去自行向 LLM 寻求建议的麻烦,更是利用 Insights 中独有的数据和能力来产生最佳的整体结果。
提出正确的问题
对于给定的数据库,决定正确索引集合的因素有两个:
数据库模式
工作负载(即正在运行的查询)
大语言模型(LLM)和人类一样,如果被问到更好的问题,就能给出更好的答案。因此,我们的首要任务是将查询模式列表筛选到那些最有可能真正受益于索引的模式。当我们手动检查数据库以寻找可能受益于索引的查询时,通常会寻找读取行数与返回行数之比较高的查询模式。如果一个查询读取的行集远大于它返回的行集,这表明索引(或更具选择性的索引)可以改善响应时间。
我们还会将查询模式集筛选到那些使用大量资源的模式。具体来说,我们要求该查询模式至少占所有查询聚合运行时间的 0.1%,并且已被运行了最低次数。由于索引会带来存储、内存和写入开销,我们希望避免为临时性或很少运行的查询建议索引。
一旦我们有了一组候选查询,我们就会将模式筛选到查询所引用的表。这可以使提示更小、更聚焦。
我们提示的最后一个组成部分是要求 LLM 包含对每个新索引旨在改进的查询的引用。这些数据将用于验证步骤。
验证
现在我们有了候选索引列表,就可以执行最关键的一步:验证。要求用户在生产数据库上创建索引本质上是一项高风险活动,我们希望确保底层建议的质量。
为此,我们执行 2 个验证步骤:
解析生成的 CREATE INDEX 语句,以确保它们在语法上有效且形式正确。
在有和没有相关索引的情况下评估每个候选查询,并忽略任何未能改进至少一个候选查询的索引建议。
为了评估每个索引的效果,我们使用 HypoPG 扩展。HypoPG 允许我们创建实际上不存在的假设索引(因此没有开销),但规划器可以在 EXPLAIN 命令的上下文中使用这些索引。这使我们能够使用实际的 Postgres 规划器找到估计成本,并确定预测的成本改进是否足够显著,以证明推荐新索引是合理的。
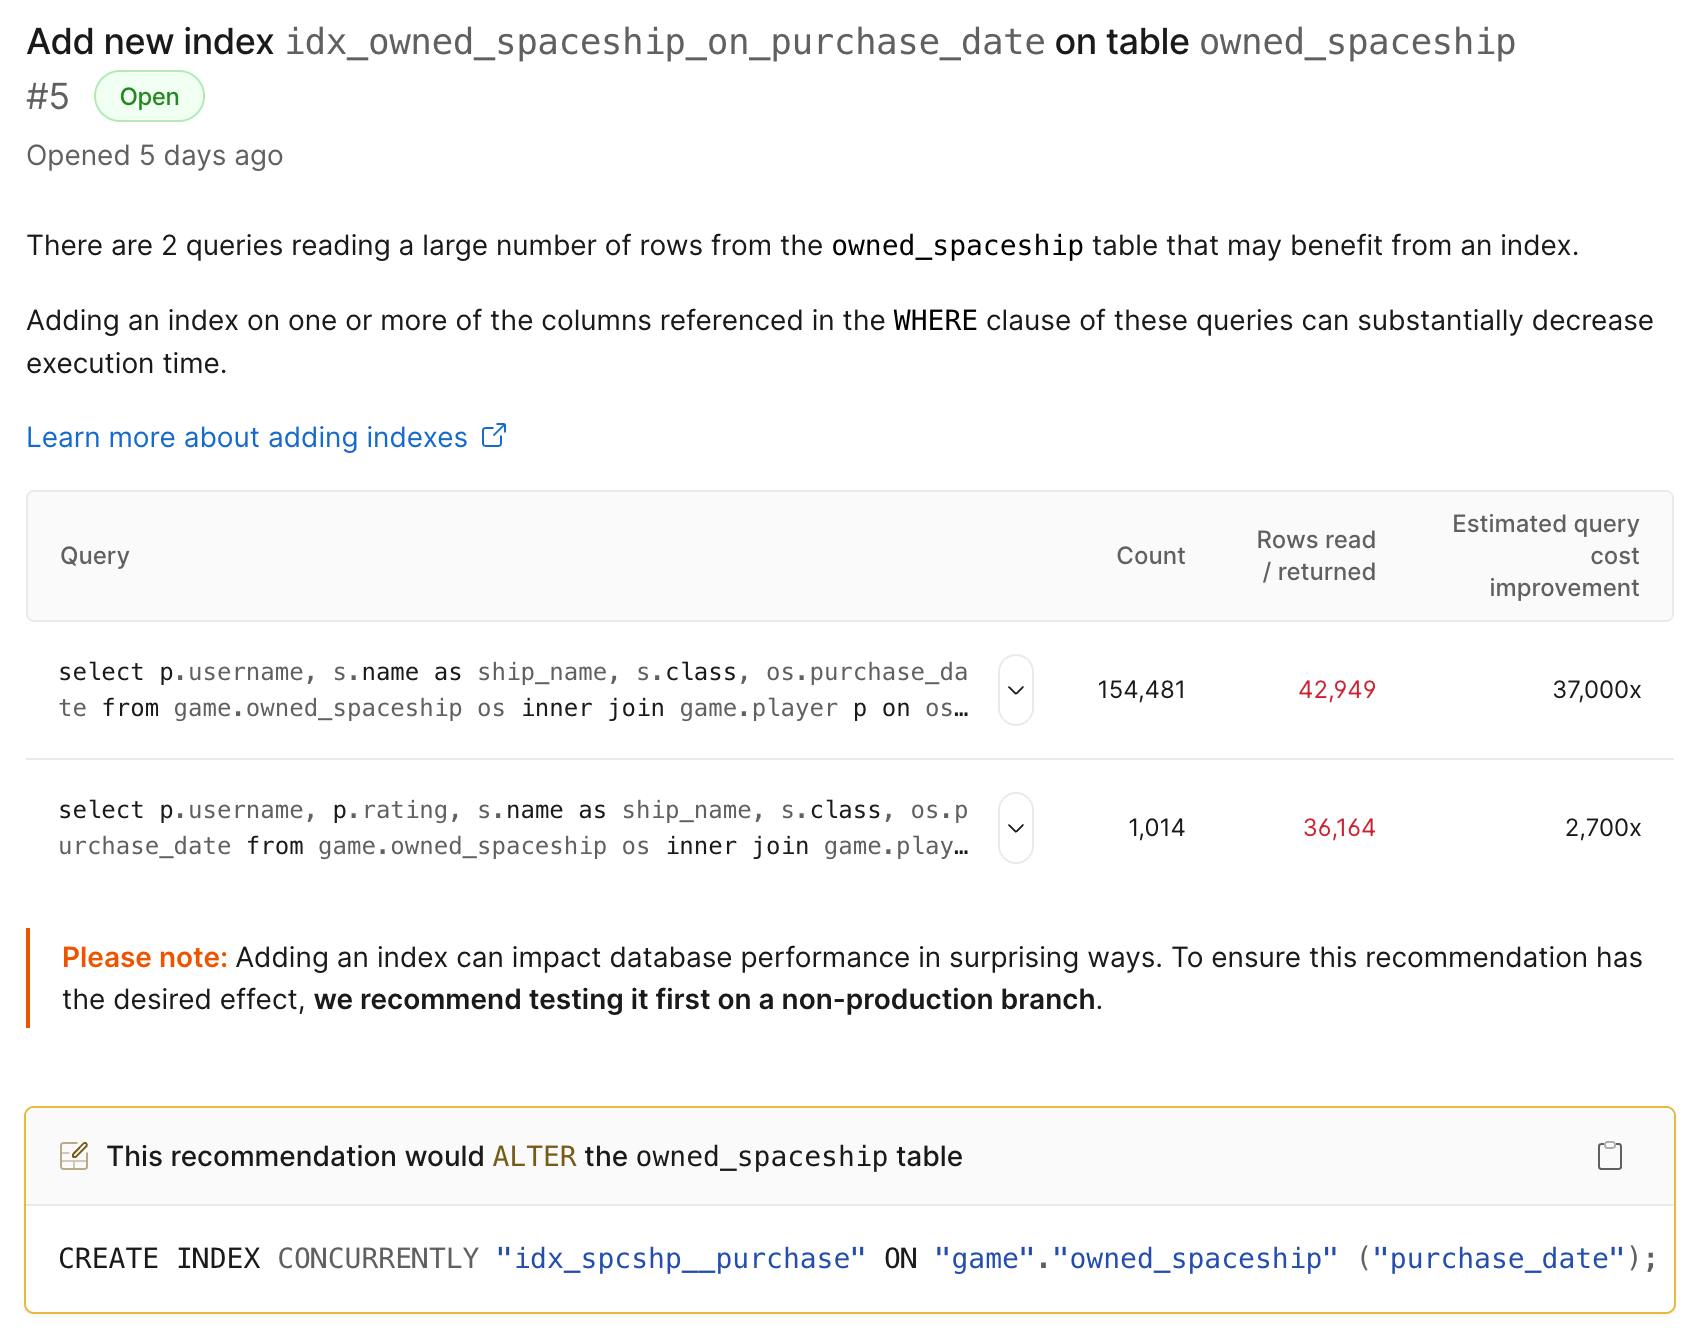
如果某个索引建议通过了两个验证阶段,Insights 就会生成一个新的索引推荐。Insights 会显示索引建议,并附上它们旨在改进的查询表,包括查询成本的估计降低量。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:PlanetScale Blog
原创地址:https://planetscale.com/blog/postgres-new-index-suggestions
原文作者:PlanetScale Blog;如有侵权,请联系管理员删除。

