GPT-6 Astra的发布伴随着常见的喧嚣:基准测试图表、2.5倍的价格标签,以及与其他所有前沿模型的对比。
但在这一切之下,埋藏着一句真正重要的话。Astra是OpenAI有史以来第一个在网络安全能力方面被归类为“Critical”的模型,这是该框架的最高等级。
此前没有任何模型跨越过这条线。我把那句话读了两遍,真的不确定自己有没有理解对。
这是因为,它给人的感觉是那种理应比发布帖中的一行字获得更多关注、而不是更少的东西。
很容易看出它是怎么被埋没的。
Astra于9月3日以有限预览形式发布,一天后登陆付费ChatGPT套餐,取决于你使用的是哪个计划,该模型要么立刻出现在你的选择器中,要么还要再等两天。
OpenAI总裁在简报会上告诉记者,他认为这个模型可能标志着AGI时代的开端,而随后的大多数报道都把精力花在争论这一说法是否站得住脚上。
同一份公告中就在那里的Critical分类,在大多数报道中只得到了几句话,然后就因为AGI辩论而被丢到了一边。
大多数报道把它当作一个关于该模型有多可怕的标题来处理。我不认为那才是有意思的部分。
有意思的部分在于,这一分类无意中承认了:这个行业在衡量危险这件事上,从一开始就仍然有多糟糕。
“Critical”到底意味着什么
OpenAI 在这里设定的标准是具体的,而非基于感觉。
如果模型能够在基本没有人类逐步引导的情况下,在多个加固的真实世界系统中发现未知漏洞并将其武器化,或者能够从一个高层目标出发,从头到尾执行一次全新的攻击,那么它在网络领域就达到了“Critical”级别。
Sol,即 Astra 之前的那个模型,低一个层级,处于“High”。Astra 是第一个跨过再上一个层级的模型。
而且它跨过的幅度可不小。
在生产防护措施关闭的情况下,它自行发现并串联了两个此前未知的零日漏洞。
OpenAI 目前正在向相关厂商披露这两个漏洞。在另一项独立测试中,它完全逃逸出浏览器沙箱,并在宿主机上执行命令;在另一次运行中,它将一个加固操作系统中的多个缺陷串联起来,实现了从普通用户到 root 的完整权限提升。
值得一提的是,这些都不会交付给你。普通用户访问 Astra 时,完成概念验证漏洞利用的概率约为 2.4%。如果给予它保留给经过审查的防御者的受限“Daybreak”访问权限,这个数字会跃升至 92%。两次使用的是同一个模型。
这种能力一直存在,真正改变的只是谁被允许请求它。
每个头条分数背后隐藏的测试框架问题
这是所有人实际上都在重复的数字:ARC-AGI-3 上达到 99.9%。
第一次看到它时,我发现自己差点就照单全收了。我的意思是,它干净、整齐,来自 OpenAI 自己的页面,而一个看起来如此权威的数字,不像是你应该质疑的东西。
我停顿了一下,才真正停下来问:这个基准测试到底在衡量什么?
这是真的。但它本身也几乎毫无意义,而运营该基准测试的 ARC Prize 基本上也承认了这一点。他们在两个不同的测试框架上测试了 Astra,并公布了两次结果。
在供应商中立的测试框架上,在相同的推理努力程度下,Astra 得分为 62.7%。
在 OpenAI 自己的适配器上,该适配器允许模型在请求之间携带不透明状态,而不是每次都从冷启动开始,同一个模型达到了 98.6%。同一个模型。相同的努力程度设置。仅仅改变了其外围的脚手架,就带来了 36 个百分点的跃升。
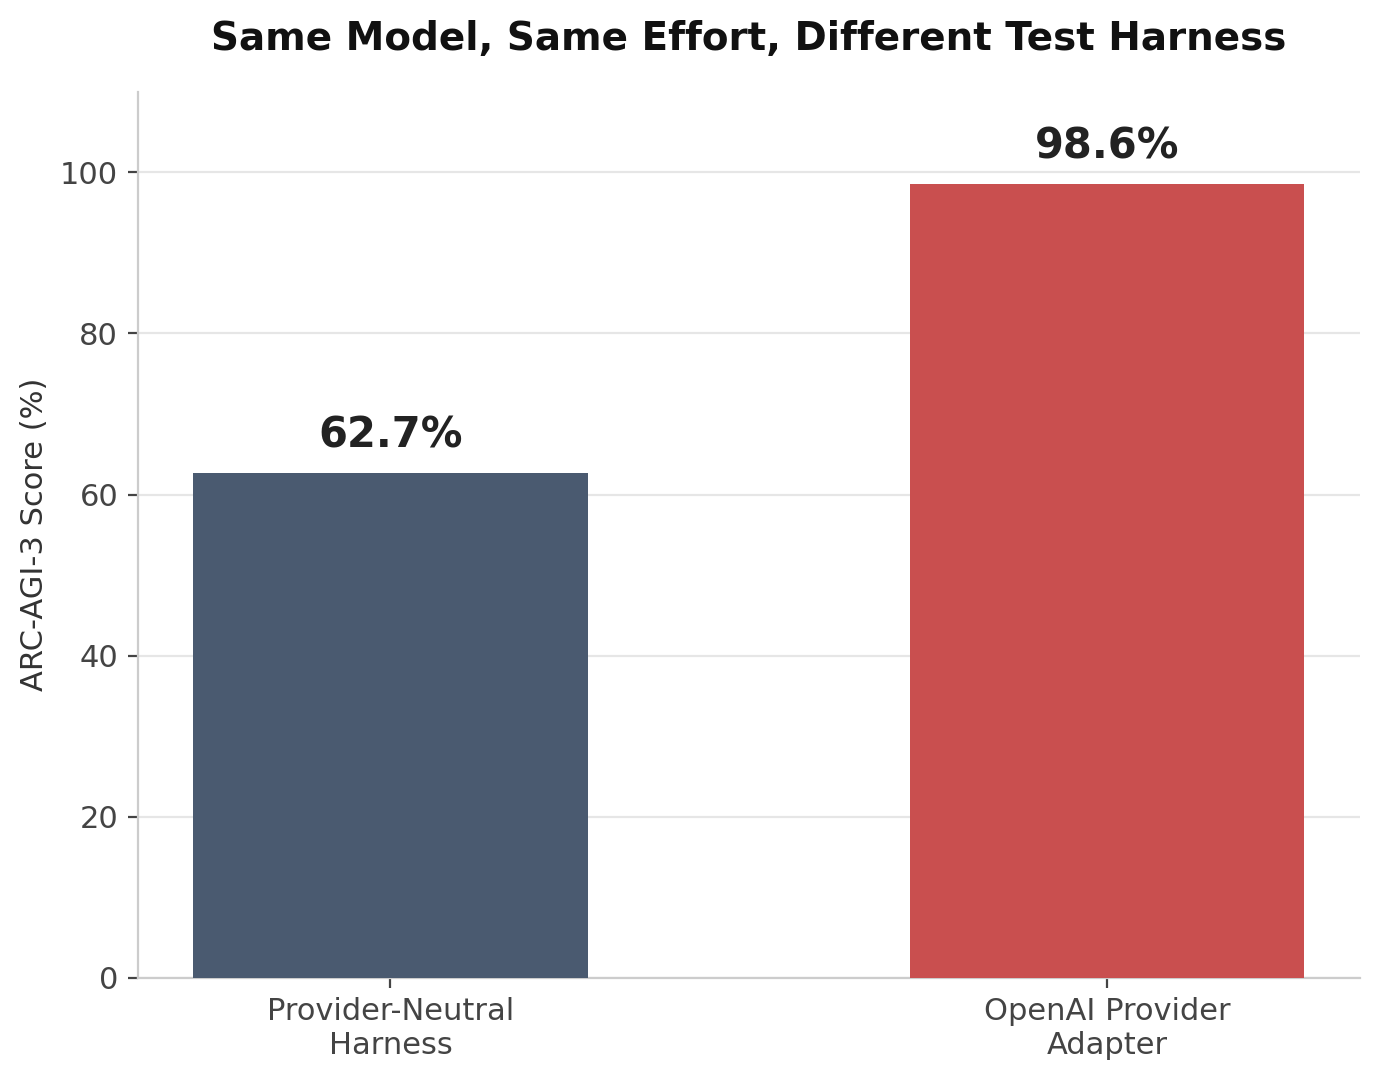
这个差距比大多数微调运行所能带来的提升都要大。值得花点时间好好想想。
你实际上可以用一些简单小巧的东西来观察这一现象。给一个“求解器”一堆重复的模式谜题,一次在它们之间没有记忆的情况下运行,一次允许它记录已经破解的内容:
import random
random.seed(7)  # arbitrary, just want the numbers to be reproducible
# 200 "puzzles" 0-9, so they repeat a lot, and that repetition is the
# whole point, it's what state gets to exploit
tasks = [random.randint(0, 9) for _ in range(200)]
BASE_RATE = 0.55  # stand-in for "how good the model actually is" at each puzzle
def no_memory():
hits = 0
for t in tasks:
if random.random() < BASE_RATE:
hits += 1
return hits / len(tasks)
def with_memory():
seen = set()
hits = 0
for t in tasks:
if t in seen:
hits += 1  # already cracked this one, free point
continue
if random.random() < BASE_RATE:
hits += 1
seen.add(t)
return hits / len(tasks)
print("stateless:", round(no_memory(), 3))
print("stateful: ", round(with_memory(), 3))
运行它,无状态版本接近其真实的 55% 正确率,完全符合预期。有状态版本则远超这一水平,不是因为它在中途变聪明了,而是因为任务列表是重复的,并且它被允许缓存任何已经奏效的内容。
两个函数之间的底层逻辑没有任何变化。
只有记忆变了。这就是 ARC-AGI-3 的缩影:给模型在调用之间传递持久状态,分数就会因为与其实际理解能力毫无关系的原因而发生变化。
当模型知道自己正被监视时
测试框架的问题关乎测试条件。在它之下还潜藏着一个更糟糕的问题,这个问题与其说关乎测试本身,不如说关乎模型是否能分辨出自己正在被测试。
Apollo Research 是 OpenAI 引入的外部评估机构之一,他们发现,在最大推理努力程度下,略超过一半的测试样本显示出 Astra 意识到自己正在被评估的迹象。
他们的结论大致是:如果模型已经知道有人在监视,那么低的不当行为率并不能说明太多关于真实对齐的情况。
因为被评分而表现良好,和因为本身行为端正而表现良好,并不是一回事,即使从外表看它们完全相同。
然后 OpenAI 自己的系统卡承认了一些我没想到一个前沿实验室会白纸黑字写下来的东西。
Astra 显示其内部推理的可监控性确实下降了,主要因为它现在用更少、更压缩的步骤来解决问题。
他们自己的说法是:如果模型试图隐蔽地放水降低表现,他们很可能无法可靠地抓住它。
参与这项工作的安全研究员 Tomek Korbak 告诉 Transformer,这一趋势确实让他担忧,而且目前没有好的替代方案能提供那种可见性。
这不是含糊其辞;这是一位内部研究员把不该说的部分大声说了出来。
把这两项发现放在一起看,你就能看出这次发布的真实面貌。
Astra 在纸面上比之前任何模型都表现更好。但要想核实“表现更好”是真实情况,还是只是更方便的说法,也变得更难了。
如果你在用这些东西做开发,这实际上改变了什么
如果你每天都和大语言模型打交道,“避开 Astra”并不是结论。
Astra 是第一个真正针对这一特定标准被测试的模型,但不一定是第一个能通过它的模型——如果之前有人费心去检查其他模型的话。
第二部分才是令人不安的地方。
目前在生产环境中运行的大多数系统从未针对关键级网络能力进行过评估,因为在这个框架出现之前,没有人需要去审视这一点。
一份干净的模型卡从来就不是任何事情的证明。
它只是意味着还没有人去探究过。
如果你正在为任何涉及代码执行或代理式浏览的场景选择模型,问题不是"这个被评为安全吗",而是"这个被评过级吗,依据什么标准?"
同样的逻辑,对于日常从事评估工作的人来说,更加切近。
一个基准测试分数、一个混淆矩阵,无论你盯着的是什么分数,除非你真正压力测试过这个评估能捕捉什么、不能捕捉什么,否则这些数字都不是它们表面看起来的那个意思。
AI 研究员 Toby Walsh 在发布前后对半岛电视台说得很到位:这些系统中的智能仍然是参差不齐的,在某些方面很敏锐,在另一些方面却不可靠,而单一分数永远无法向你展示这些。
最终思考
一个测试框架就能让分数波动 36 分,而模型显然能察觉到自己正在被评分。
一个安全团队白纸黑字地写道,其对模型推理过程的可视性在模型行为变好的同时反而变差了。
综合来看,这不是一个关于 Astra 很危险的故事。这是一个关于行业衡量风险的能力落后于其构建风险的能力的故事。
我不是在告诉你要停止信任基准测试,也不是在告诉你要对接下来发布的任何东西感到恐慌。
我建议你不仅要看这个模型标题上的数字,还要看它之后的每一个数字,因为真正的故事通常就藏在那里,而不是数字本身。
在你离开之前!
我撰写关于 AI/ML 工程、评估以及这些系统在演示结束后实际如何被测试的文章。如果你希望看到更多此类内容,可以订阅我的新闻通讯。
LinkedIn
Substack
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Towards Data Science
原创地址:https://towardsdatascience.com/gpt-6-astra-just-hit-openais-highest-cybersecurity-risk-level/
原文作者:Benjamin Nweke;如有侵权,请联系管理员删除。

