在 Python 中对一份 10,000 行的供应商列表进行去重,而真正的难点在于判断相似度得分 91 意味着什么
我的代理机构从独立出版商那里购买编辑版位。供应商列表略超过 10,000 个网站,每一个都是给我们开发票的公司,而保持这份列表干净是我们最不起眼的问题。它也是出错时最费钱的问题。重复的供应商记录会让你为同一张发票付款两次,而记录被拆分意味着价格历史也被拆分,于是你去年谈好的费率被归档在一个没人会去搜索的拼写下面。
自 1 月以来,我们一直通过其 API(应用程序编程接口) 将外部市场目录同步到内部系统,而在此之前,客户经理已经手工录入了十年,还有通过电子邮件发来的电子表格。同一个网站现在会以 solartravelmag.com、https://www.solartravelmag.com/、blog.solartravelmag.com 的形式出现,运气不好时还会变成附带跟踪参数的 SolarTravelMag.COM。我们同步的一个市场坦率地表示,其列出的价格大约 90% 的情况下与现实相符,这很诚实,也意味着在来源之间交叉核对价格是必须的。只有当你知道两行描述的是同一个网站时,交叉核对才有效。这就是实体解析,一个有着可追溯到 1969 年 Fellegi 和 Sunter 的正式理论的问题 [1],而且它有一个教程很少首先提到的特性:字符串匹配是简单的部分。决定如何处理这些得分才是真正的工作。
本文介绍了清理我们列表的流水线,并在其合成重建版本上端到端运行,带有真实标签,因此下面每一个精确率声明都可核查。一句话概括重点:两个枯燥的确定性阶段免费移除了 76% 的重复项,模糊匹配器在两秒内对 3,370 万个配对进行了评分,而没有任何阈值能够安全地合并剩余部分。匹配器真正的输出是一个排序后的审核队列,而不是一组合并结果。
真实混乱的合成副本
我不能公开我们的供应商列表,所以我用同样的毛病重建了一份。7,000 个虚构的出版商品牌获得了域名,后缀分布贴近现实,然后我按照我们列表被污染的方式污染了它:2,429 个表面变体(协议、www 前缀、随机大小写、路径、跟踪参数),888 行像 blog. 和 m. 这样的子域记录,529 个国别域名兄弟项,例如 brand.com 与 brand.de 并列,以及 505 个一键之差的录入拼写错误。我还埋下了 180 个陷阱:与现有品牌仅一个编辑距离、但完全属于另一个供应商的域名,因为真实网络中充满了近似名称的邻居,任何诚实的测试集都需要它们。
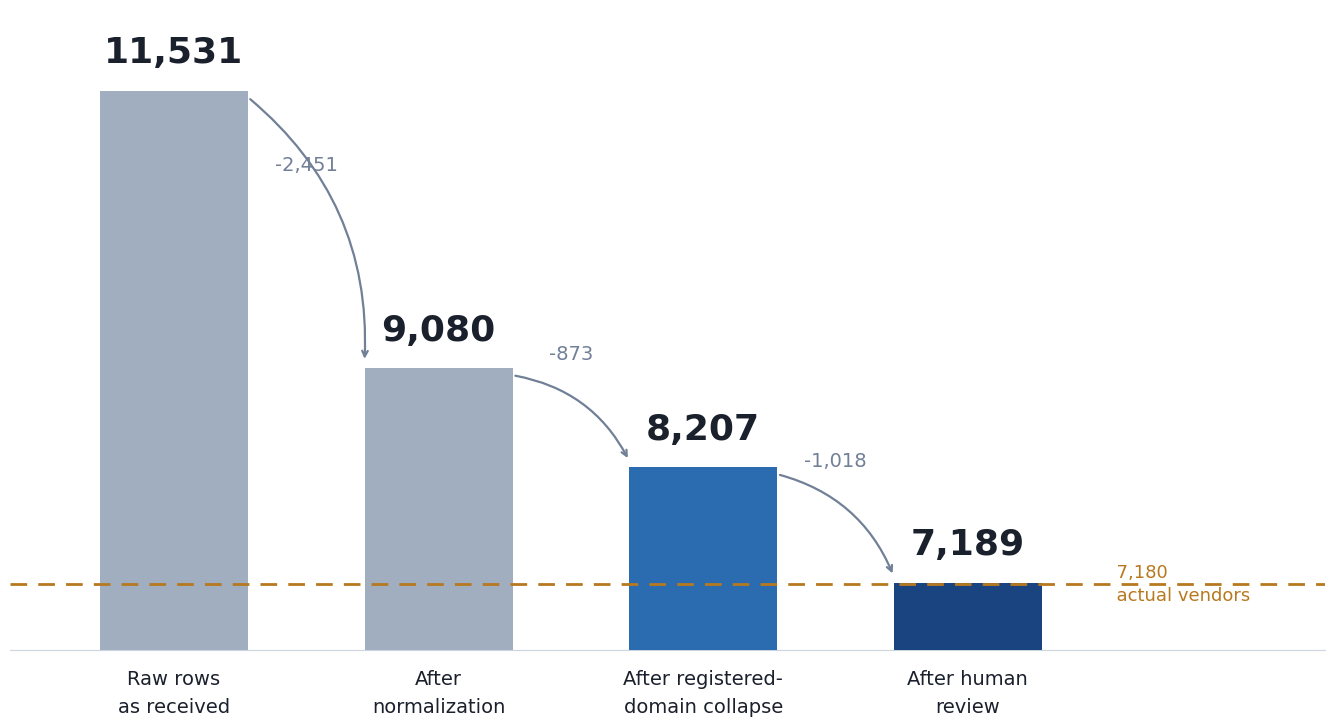
结果是 11,531 行描述了 7,180 个实际供应商。生成器是五十行的词表和刻意破坏;上面的污染配方足以重建它。所有内容都在 Python 3.12 上运行,使用 RapidFuzz 3.14.5 [2] 和 tldextract 5.3.2 [3],运行在单 vCPU 云沙箱上,因此下面的计时都不需要强大的硬件。
枯燥的阶段完成了大部分工作
第一阶段是规范化,而且它故意很笨:转小写、去掉协议、截掉路径和查询字符串、去掉开头的 www。
import re
def norm_host(raw: str) -> str:
s = raw.strip().lower()
s = re.sub(r"^[a-z]+://", "", s)
s = s.split("/")[0].split("?")[0]
if s.startswith("www."):
s = s[4:]
return s.rstrip(".")
这在 0.03 秒内将列表从 11,531 行变为 9,080 个唯一主机名。没有模型,没有得分,2,451 个重复项消失了。
第二阶段折叠子域,而这正是按点拆分的人会吃亏的地方。blog.solartravelmag.com 的注册域名是 solartravelmag.com,但 solartravelmag.co.uk 的注册域名不是 co.uk,而唯一知道这一点的方法就是 Public Suffix List [4],这是一个维护良好的目录,列出了公众可以在其下注册名称的每个后缀。tldextract 库封装了它:
import tldextract
# pin to the bundled suffix snapshot so runs are reproducible
extract = tldextract.TLDExtract(suffix_list_urls=())
registered = {}
for host, row in hosts.items():
ext = extract(host)
reg = ext.domain + "." + ext.suffix if ext.suffix else host
registered.setdefault(reg, row)
又有 873 个主机名被折叠,剩下 8,207 个注册域名。两个确定性阶段,零判断调用,4,351 个重复行中已有 3,324 个消失。如果你从本文只带走一个数字,那就带走这个:76% 的问题根本不需要相似度得分。
剩下的是最难的四分之一。真实标签显示,仍有 1,135 对真正的重复项隐藏在那 8,207 个域名中,这些是只有跨域比较才能发现的拆分记录:条目拼写错误和国家域名同源项。
暴力计算没问题,分块仍然有其价值
8,207 个域名可以组成 3,370 万个可能的配对,这听起来像是该用巧妙索引的时候了。但并非如此,至少从速度上来说不是。RapidFuzz 可以在一次调用中计算完整的相似度矩阵:
import numpy as np
from rapidfuzz import fuzz, process
M = process.cdist(labels, labels, scorer=fuzz.ratio,
dtype=np.uint8, workers=-1)
两秒,67 MB。在这个规模的列表上,暴力计算不过是喝一口咖啡的功夫。
分块之所以重要,还有另外两个原因。第一,规模:当供应商数量达到 100,000 时,同样的矩阵就是 100 亿个单元格和 10 GB,喝一口咖啡就变成了服务中断。第二,也是被低估的一点:一个带分数的矩阵不是待办清单。你需要的是可以排序和分流的候选配对,而不是一堵数字墙。所以我还是做了分块,只比较共享同一个键的域名:
from itertools import combinations
blocks = {}
for reg in domains:
label = label_of[reg]                 # the part left of the suffix
for key in ("P" + label[:2], "S" + label[-3:]):
blocks.setdefault(key, set()).add(reg)
pairs = set()
for members in blocks.values():
pairs.update(combinations(sorted(members), 2))
分块是有代价的,你应该去衡量它,而不是寄希望于它。仅使用两字符前缀键时,候选集捕获了 93.0% 的真实重复配对;命中前两个字母的拼写错误逃出了它们的分块。加入末三字符键后,这一比例提升到 99.8%,代价是候选集从 864,600 对增长到 1,690,124 对。对所有候选打分耗时 1.1 秒。恰好有两对真实配对同时逃过了两个键。在真实列表上你不会拥有真实标签,所以在信任分块之前,请在标注样本上估计分块召回率。
两个拒绝分离的峰
这里就是这类故事的教程版本结束、运营版本开始的地方。我对每个候选配对打了分,并按真实标签拆分了直方图。
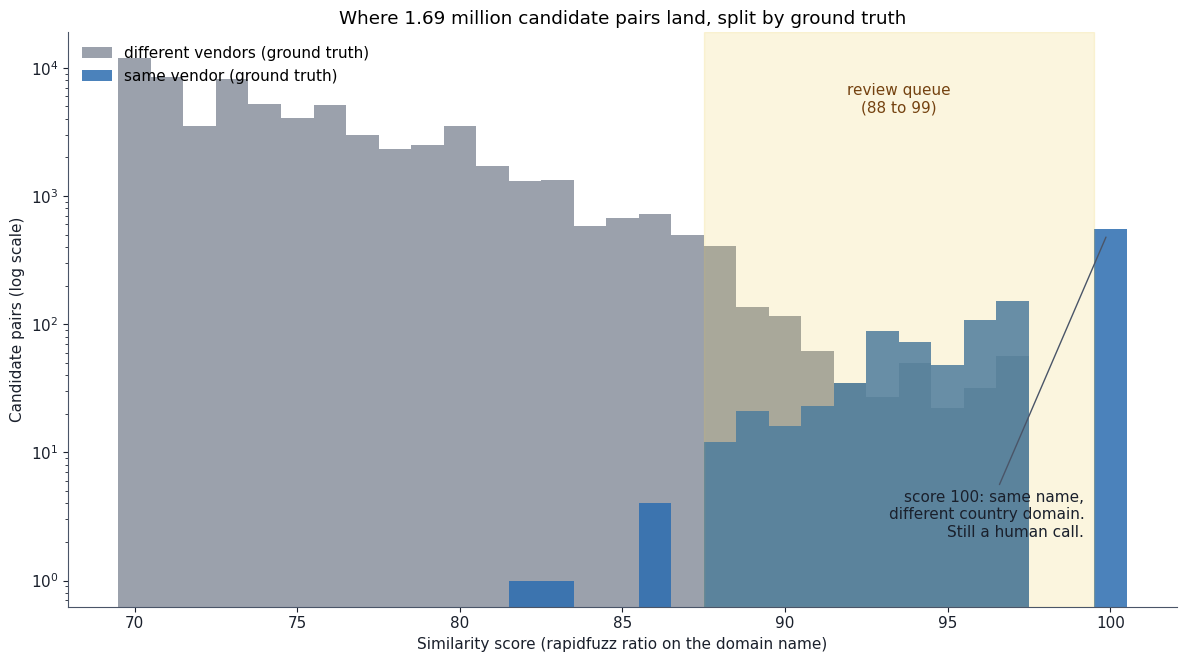
分数低于 80 时数据是干净的:那里没有一对真实重复项。高于 97 时反过来也是干净的,但有一个巨大的陷阱我稍后会讲到。88 到 97 之间的区域是真正的混合区,而且这是结构性的混合,不是调参造成的。一个 14 字符域名的单键击条目拼写错误得分在 90 出头。一个真正不同的供应商,其名称与你的名称只差一次编辑,得分也在 90 出头。字符串无法告诉你处于哪种情况,因为这两种情况是同一个字符串事件,只是背后有不同的主体。
扫描结果让这一点变得具体。在 85 分自动合并的精确率为 0.345,意味着每三次合并中有两次是错误的。在 90 分,精确率达到 0.764,所以每四次合并中仍有一次是错误的。在 95 分,精确率为 0.895,但召回率已经降到 0.738。只有在 98 分,精确率才达到 1.0,召回率为 0.485。
现在说陷阱。所有落在那个完美区域的配对,全部 551 对,都是同一名称在不同国家域名下:brand.com 旁边是 brand.de 或 brand.co.uk。打分器确信字符串匹配,字符串也确实匹配,但 brand.de 是同一出版商在德国的分支,还是一家抢注了同一个词的不相关公司,这是关于公司的知识,再多的文本确定性也无法提供。在我们的真实列表中,两种情况都出现了。所以,匹配器对文本从不出错的那个区域,恰恰是对文本正确也无法解决任何问题的区域。这些配对按规则交给人工处理:
def route(a: str, b: str, score: int) -> str:
if score == 100 and suffix_of[a] != suffix_of[b]:
return "review"     # brand.com vs brand.de is a business question
if score >= 88:
return "review"
return "ignore"
注意缺少了什么:一个合并分支。在确定性阶段之后,剩下的没有任何东西可以安全地自动合并。
用分钟数而非阈值来购买召回率
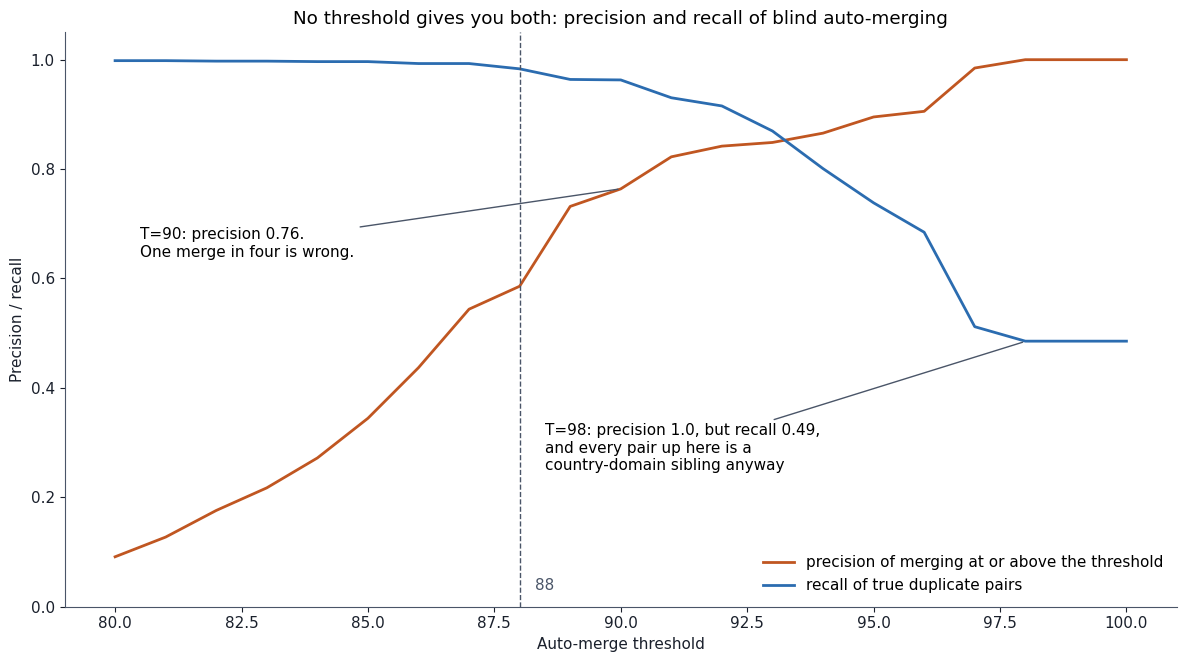
既然没有哪个阈值能安全地完成合并,阈值的真正职责就变了:它决定审核队列的规模。这就把一个统计旋钮变成了人员配置决策,而数字让这种权衡变得明确。88 到 99 这个区间包含 1,354 对,其中 565 对是真正的重复。再加上 551 对强制审核的同国家兄弟记录,审核员面对的是 1,905 对。按每分钟六对计算,这刚过五个小时:一个工作日就能理清十年的供应商烂摊子。把区间放宽到 85 会多出 1,378 对,大约多花四个小时,而恰好多找回 15 对真正的重复。把下限降到 80 会让队列膨胀到 30 小时以上,只多找回两对。掌管供应商预算的人现在可以在这条曲线上选一个点,同时清楚地知道每个小时能换来什么。
我模拟了两种结局。审核路径下,审核员正确地处理完队列,最终得到 7,189 个实体,而真实值是 7,180,修复了 1,135 对重复关系中的 1,116 对。漏掉的 19 对中,17 对得分在 80 到 87 之间,2 对是分块时丢失的。另一种结局是工具让人很容易忍不住去做的:在 90 处盲目自动合并,然后收工。那次运行产生了 6,914 个实体,其中 282 个是把两个或更多真正不同的供应商融合在一起的记录。用应付账款的话说,就是 282 个供应商的价格历史被别人的费率污染了,还挂在一个会付款的记录上。一份混乱的清单让你无法比较。一份自信却错误的清单让你损失转账。
两个习惯让审核日本身变得便宜。按金额排序队列,这样涉及昂贵投放的对会先被看到,长尾可以等到某个清闲的周五。让每一次合并都可逆:保留两边的源行,写合并日志,绝不覆盖。如果人工介入者的错误也是永久性的,那人在回路中的一半价值就消失了。
哪些经验可以迁移到你的清单
以上内容没有哪一点是出版行业特有的。供应商名称、客户账户和联盟合作伙伴列表会以相同的形态出问题:归一化能消除的表面噪声、规范形式能折叠的层级结构,以及仅凭字符串无法确定答案的近似匹配残留。当你的列比我这里用的更多时,把它们花在审核界面上,而不是评分里。一个共享的联系邮箱或银行信息,能在两秒的人工注意力下把 91 变成确定;把它折进一个综合评分,只会把歧义挪到更难看见的地方。如果你的实体是域名,请尊重 Public Suffix List。按点分割就是 co.uk 变成你最大供应商的原因。
结论
清理清单的流水线并不光鲜。大力归一化,折叠到注册域名,用两个键分块,对所有内容评分一次,然后按规则分流:确定的已经被折叠了,不可能的继续忽略,混合的中间部分变成一个一个人一天能处理完的队列。在域名这样的短字符串上,相似度分数是供人权衡的论据,这里的数据说得很清楚:85 处四次合并错三次,90 处四次错一次,而完美只在字符串不再是问题的那个确切区域才出现。给队列排序,按你拥有的工时来确定规模,保持合并可逆,让确定性阶段去炫耀吧。
本文所有图表均由作者使用 matplotlib 生成。未使用 AI 图像工具。
参考文献
[1] I. Fellegi and A. Sunter, A Theory for Record Linkage (1969), Journal of the American Statistical Association
[2] M. Bachmann, RapidFuzz: rapid fuzzy string matching in Python (2026), GitHub
[3] J. Kurkowski, tldextract (2026), GitHub
[4] Mozilla Foundation, Public Suffix List (2026), publicsuffix.org
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Towards Data Science
原文作者:Boris Dzhingarov;如有侵权,请联系管理员删除。

