SOC 团队面临的最大 SIEM 管理问题之一是,他们经常被误报淹没,导致分析师疲劳和可见性缺口。除此之外,安全领域最棘手的挑战之一是检测 SaaS 访问令牌何时被泄露,同时又不增加误报问题。
在 Elastic,InfoSec 团队通过使用 Tines 等工具自动化 SIEM 告警调查来解决这两个问题。这篇博客文章分享了我们如何简化工作流程、减少误报,并让分析师能够专注于真正的威胁。
自动化 SIEM 告警初步调查
在之前的一篇博客文章中,我们介绍了 Elastic InfoSec 团队如何创建检测用户和实体行为分析(UEBA)的规则包。随着我们将这些告警包扩展到包含更多数据源,我们发现,由异常但良性的活动(例如每月仅发生一次的 API(应用程序编程接口) 令牌活动,或来自已知扫描器的活动)引起的大量误报让 SOC 分析师不堪重负。这导致我们不得不决定,是创建一条可能因误报而噪声很大的检测规则,还是接受因没有该检测而存在可见性缺口。噪声很大且包含大量误报的检测,会因分析师疲劳而产生其自身类型的可见性缺口。但这个问题引发了一个新想法:如果我们能够自动化告警的初步调查,关闭已知误报,并升级那些无法关闭的告警,会怎么样?
我们发现,对于许多 SaaS 提供商和 UEBA 检测规则,如果活动来自受信任设备,例如我们管理的某台工作站,我们就可以关闭该规则。在许多情况下,初步调查 playbook 的操作是使用原始告警中的一条信息,例如 source.ip,然后在 Elasticsearch 中查询其他索引模式以查找该 source.ip。如果查询有任何结果,则可以将该告警作为误报关闭。例如,如果你看到一条关于 AWS Secret Key 活动的 UEBA 告警,我们随后会运行以下查询组来分诊该告警,以判断该活动是否来自受信任设备:
是否有代理日志显示 Elastic Agent(智能体) 从具有该 source.ip 的工作站或服务器成功连接到我们的 fleet server?
该 source.ip 是否属于我们管理和控制的某个 AWS、GCP 或 Azure 网络区域的公网 IP 范围?
该 source.ip 是否属于授权的第三方应用程序,例如 Okta、Terraform、Tines、Qualys 或 Snyk?
在过去 2 小时内,是否有来自该 source.ip 的成功 FIDO2 SSO 登录?
如果这些后续 Elasticsearch 查询中的任何一个返回结果,那么我们可以假定此 AWS API key 活动很可能是已授权的,并可以关闭该告警。如果所有这些查询都返回零结果,我们认为该活动可疑,因此会将其升级给 SOC 团队成员以进一步调查。上述所有 Elasticsearch 查询都可以使用 _search API 完成,并且我们可以使用 Signals API 关闭并标记告警,这使我们能够自动化整个过程。
通过使用 Alert Actions 功能将我们的 SIEM 检测从 Elastic 发送到安全编排、自动化和响应(SOAR)系统,我们可以使用 SOAR 为每个适用的告警自动运行这些调查查询。根据查询结果,我们可以自动关闭告警或将其升级给分析师。
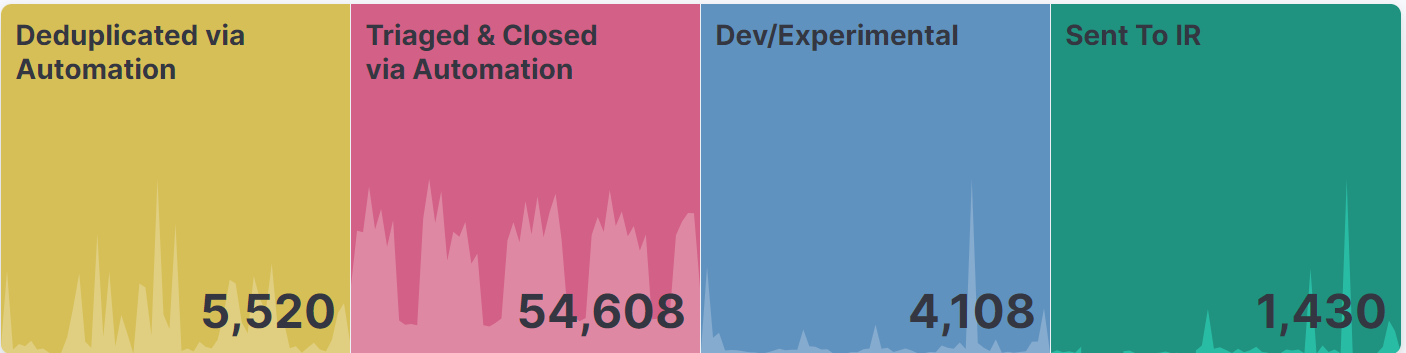
这种自动分诊能力使我们能够创建整类检测,而如果没有 SOC 人员数量的显著增加,这些检测通常会因噪声过大而无法调查。我们的自动化工作流目前每天在没有任何人工交互的情况下分诊并关闭超过 3,000 条告警。一名经验丰富的分析师以同样方式分诊每条告警需要超过 15 分钟。如果我们希望在没有这种自动化的情况下拥有相同的检测,我们将需要额外 94 名全职员工。这张图表显示了我们在 SIEM 中过去 30 天告警的数据:
这种自动分诊工作流可以使用自定义脚本创建,但本博客将向你展示如何使用 Tines 构建这种自动化。我们决定以这种方式进行探索,因为这是 Elastic InfoSec 团队使用的方式,而且简单来说,它比编写脚本更容易。我们发现,Tines 使得在没有专门开发团队的情况下也能轻松构建和修改自动化。
将告警发送到任意 SOAR
如上所述,第一步是将告警内容从 Elastic Security 发送到你选择的 SOAR 解决方案。为此,我们使用 Elastic Security 中的 Alert Actions 功能,它会在每次触发告警时执行自定义操作。
配置检测规则时,有一个添加规则操作的选项。在这里你可以选择所需的连接器类型。
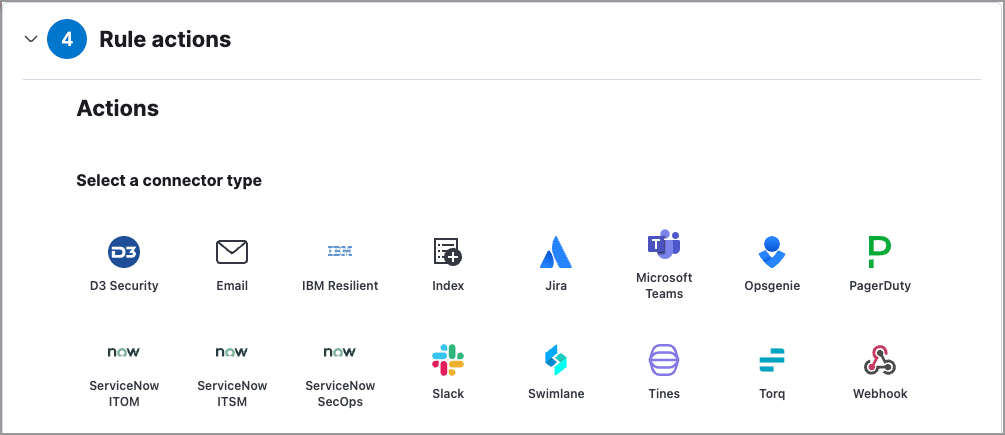
将告警发送到 Tines 最简单的方式是配置并使用 Elastic 内置的 Tines 连接器,它会将你的告警发送到 Tines story 进行处理。
另一种选择是使用 Webhook 连接器,它非常灵活,因为它允许你以 ndjson 格式将告警的一部分或全部内容发送到监听的 Webhook。在 Tines 连接器出现之前,我们 Elastic 内部就一直在使用 Tines,因此我们的大多数自动化仍然使用 Webhook 连接器。你可以一次发送一个告警到 Webhook,也可以将所有告警合并为一个 ndjson 发送。如果你使用自定义脚本,可以使用此连接器来接收和处理告警,它也适用于 Tines Webhook 操作。要将告警的完整内容发送到 Webhook,你需要配置一个 Webhook 连接器,使用 POST 操作,并将内容类型设置为 application/x-ndjson; charset=utf-8 。
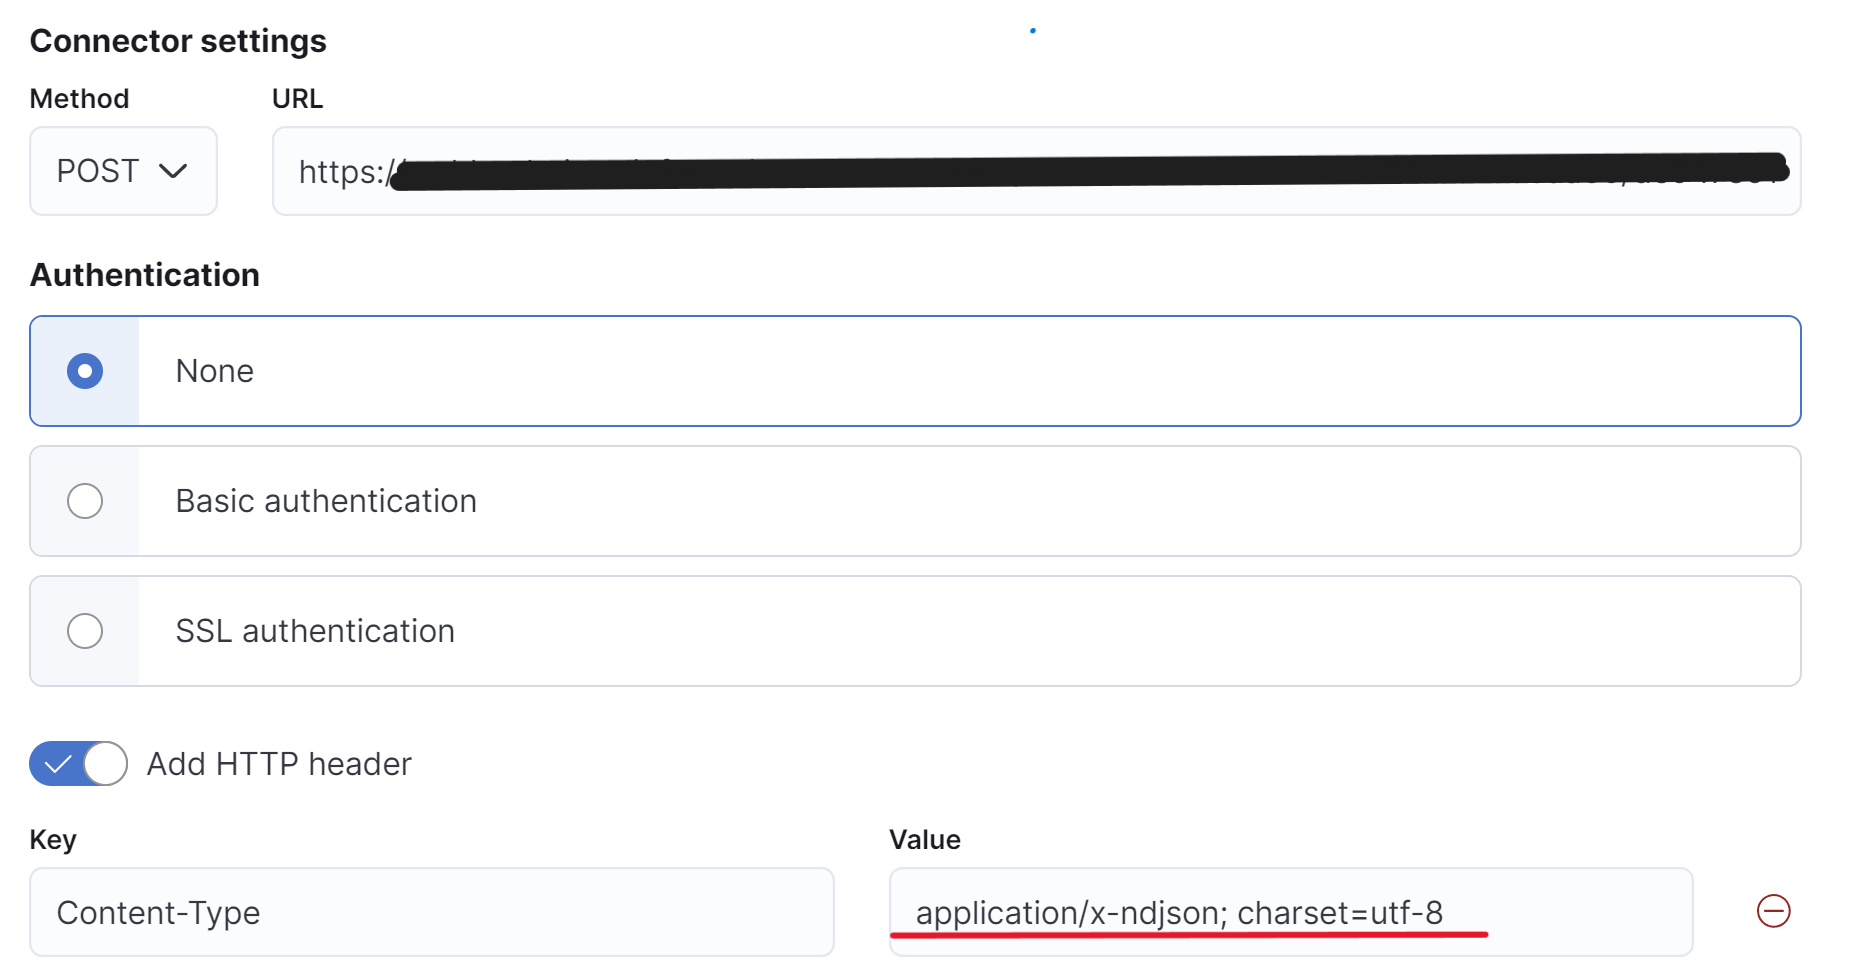
在向规则添加操作时,选择已配置的 Webhook 连接器,并在配置中使用以下 mustache 语法将完整告警作为 ndjson 发送到 Webhook。
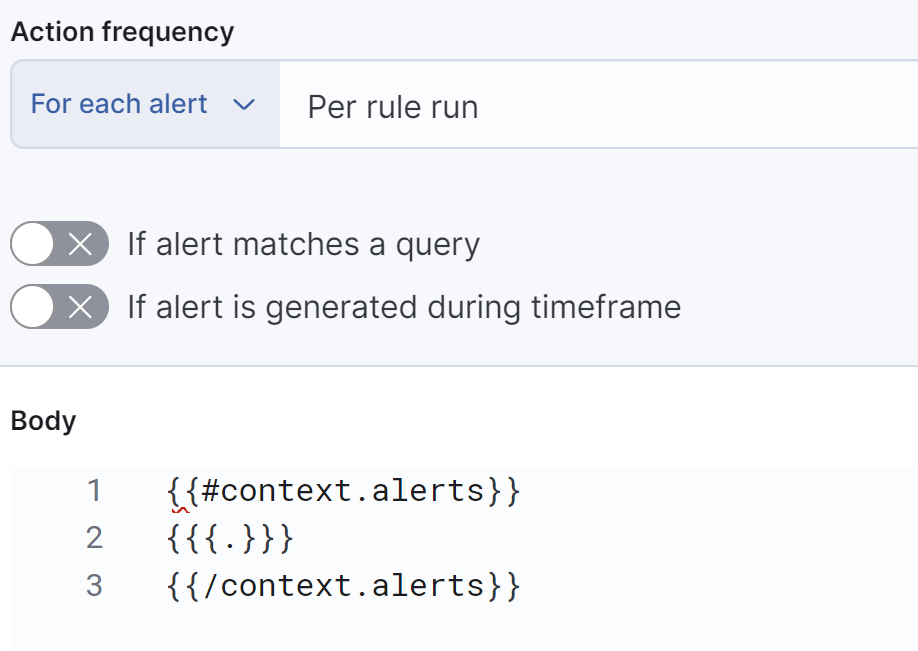
使用标签路由自动化
在构建这些自动化时,我们最初为每个告警单独构建自定义自动化路径,但很快发现这种方式无法扩展。我们的解决方案是在检测规则中使用自定义标签,将规则路由到适当的分诊路径。我们将完整告警发送到 Tines,其中包含 signal.rule.tags 字段中的标签数组。我们决定使用 Triage:{option} 的命名约定来描述将对规则执行哪些自动化检查。检测规则可以有多个不同的标签。
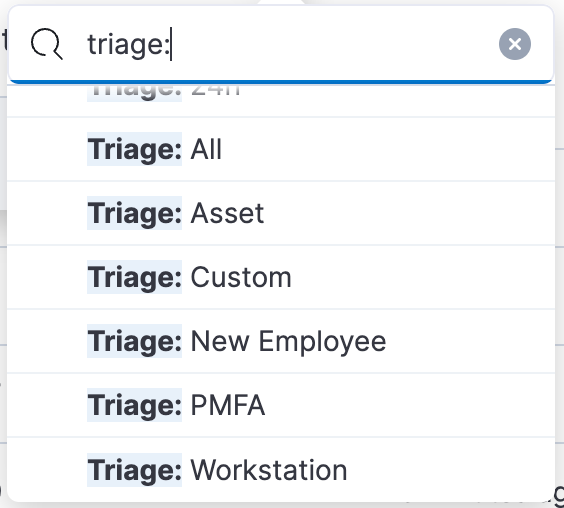
我们使用的自动化分诊标签的描述:
Triage: All 将把告警路由通过 Asset、PMFA 和工作站自动化分诊路径,如果任何查询返回 true,则关闭告警。如果没有任何查询返回 true,则升级告警。
Triage: Asset 将检查各种索引模式,以确定源 IP 是否来自 Elastic 拥有或以某种方式管理的资产。这包括我们存储在 Elastic 中的内部资产数据库、内部网络区域、我们的 Elastic Cloud 公共 IP、CI/CD 系统,以及授权第三方系统(如 Okta 或 Tines)的公共 IP 空间。
Triage: PMFA 将查看我们的 Okta 审计日志,以确认使用抗钓鱼 MFA(如使用 Okta Verify 或 Windows Hello 的 passkey)的成功身份验证。我们使用 Okta 集成来收集 Okta 审计日志。
Triage: Workstation 将检查我们的 nginx 代理日志,以确认来自该 IP 地址的 Elastic Defend 到我们的 fleet server 的成功连接。Elastic 是一家分布式公司,员工可以在世界任何地方工作,但他们的 Elastic Defend 智能体定期连接,因此我们通常可以看到 Elastic 员工的管理工作站是从生成告警的同一 IP 连接的。
Triage: New Employee 将检查我们的资产数据库,其中包含从 HR 系统导出的所有员工的每日报告,以确定该用户是否为新员工。这对于某些类别的检测规则很重要,例如 Slack UEBA,通常在新员工配置其账户时触发,但很少对现有员工告警。
Triage: 1h 将指示 Tines 在执行其余分诊操作之前暂停告警分诊 1 小时。这对于用户配置全新工作站等事件很有用,如果工作站已正确注册并注册到我们安装 Elastic Defend 的终端管理系统,则可以关闭告警。
Triage: 24h 将指示 Tines 在处理之前暂停告警分诊整整 24 小时。某些分诊路径可能需要这样做,因为数据仅每日更新,例如我们资产数据库中收集所有计算机、用户和云账户每日清单的部分。
Triage: Custom 用于告警可能需要的任何自定义分诊路径。一个很好的例子是,我们向第三方(如 Okta)提供了用于在 Azure 中创建或禁用账户的高权限 API 密钥,如果该 API 令牌从不属于 Okta 的 IP 地址使用,我们希望收到告警。此告警和自动化分诊让我们能够“信任但验证”,以防 Okta 存储的我们的 API 密钥被泄露并在 Okta IP 空间之外使用。
自动化的构建块
现在我们将完整告警作为 JSON 发送到我们的 SOAR,我们可以将其通过分诊路径发送,然后发送到其他来源,如 Slack 或 Pagerduty。在 Tines 中,有七种不同类型的操作可用于构建你的 story:
Webhook 操作将发出它通过 Webhook(HTTP 回调)接收到的事件。这是将事件发送到 Tines 中 story 的主要方法。
Send Email 操作向操作选项中指定的收件人发送电子邮件。
Receive Email 操作,正式名称为 IMAP Action,当它在 IMAP 服务器上检测到新电子邮件或当电子邮件发送到唯一生成的电子邮件地址时发出事件。
Event Transformation 操作有多种模式,可修改接收到的事件内容。这些操作极其灵活和强大。
HTTP Request 操作使用各种方法向指定 URL 发送 HTTP 请求。
Trigger 操作将传入事件中某个字段的内容与预定义规则进行比较,当规则匹配时,触发事件发出。这可以看作是一个“If Then”逻辑操作。
Send to Story 操作将事件发送到另一个 Tines story(子 story)。子 story 完成其操作后,Send to Story 操作将发出一个事件。Send to Story 操作类似于代码中的函数或库,你希望在多个地方重用操作。
使用这些操作,我们可以构建每月节省数千小时工作的自动化。
简化的自动化分类工作流示例:
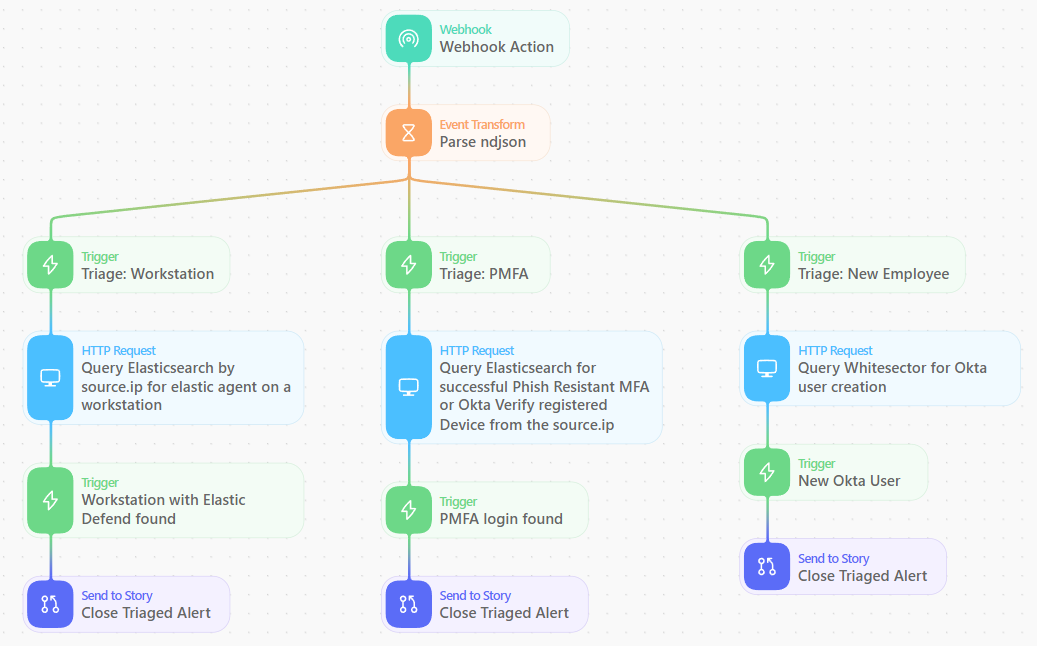
在这个自动化场景中,我们处理进入 Webhook 的新告警,使用事件转换操作将 ndjson 解析为更易于引用的对象,然后使用触发操作来确定告警应走哪些分类路径。
大多数 HTTP 请求操作都是对 Elasticsearch _search API 的查询。在这些后续查询中,我们使用原始告警中的字段(如 source.ip 或 user.email)来对告警进行分类。
Tines 自带数百个预构建的操作模板,其中包括几个用于与 Elasticsearch 交互的模板。你可以使用“Query an Elasticsearch index for all records”模板,然后修改 payload,使用告警中的源 IP 添加你的查询。由于大多数查询是在查找来自特定 source.ip 的任何事件,我建议在查询中添加 "size": 1 选项以提高速度和性能。如果 Elasticsearch 在过去 4 小时内找到与 source.ip 匹配的结果,就会返回。
{
  "size": 1,
  "query": {
    "bool": {
      "must": [],
      "filter": [
        {
          "bool": {
            "should": [
              {
                "match_phrase": {
                  "source.ip": "<>"
                }
              }
            ]
          }
        },
        {
          "range": {
            "@timestamp": {
              "format": "strict_date_optional_time",
              "gte": "now-4h",
              "lte": "now"
            }
          }
        }
      ],
      "should": [],
      "must_not": []
    }
  }
}
在每个查询操作之后,我们有一个触发操作来检查是否找到了任何结果。如果命中数大于零,我们使用 Signals API 关闭告警。如果结果为零,我们继续处理并进入下一个操作。如果所有操作都返回零结果,我们则将告警发送到 Slack,通知分析师进行调查。
用于检查查询是否有任何结果的触发操作的示例设置:
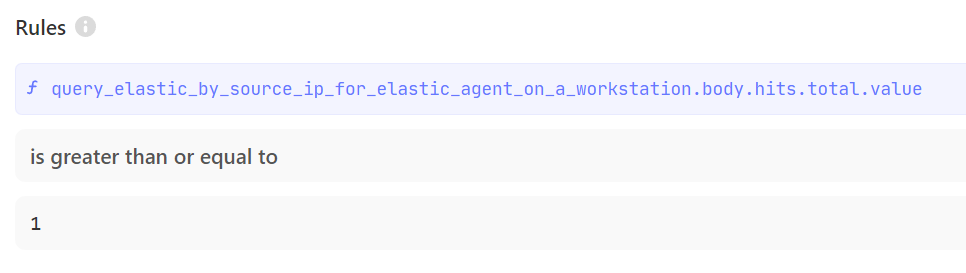
通过使用运行 Elasticsearch 查询并在有任何结果时关闭告警的逻辑,我们可以将多个此类操作串联起来,构建全面的场景,关闭来自已知良好 IP 地址的告警。
托管工作站分类示例
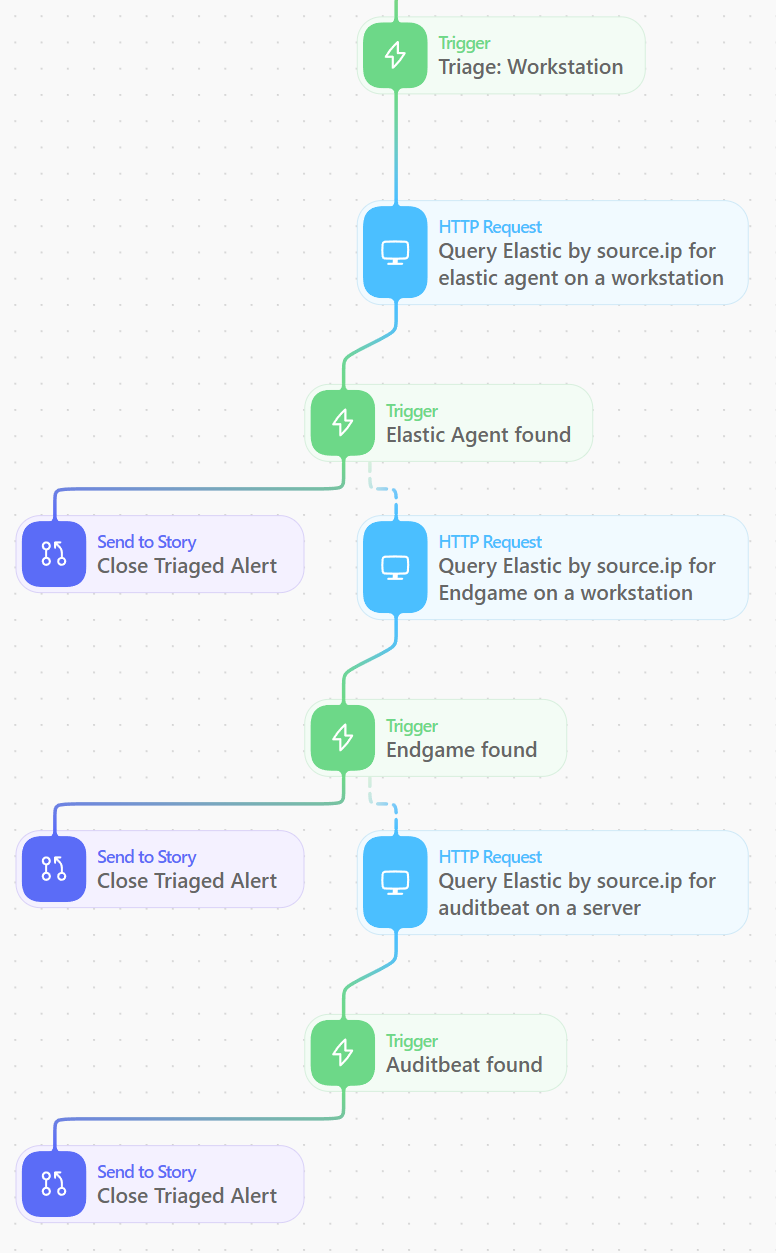
在下面的示例场景分支中,我们关闭来自我们所管理的工作站或服务器的任何告警。Elastic 是一家全球分布式公司,大多数员工在家办公,因此我们无法预测他们将通过哪个 IP 地址连接到互联网,而且在许多情况下,他们的公网 IP 地址每天可能会变化多次。我们可靠地找到这些工作站环游世界时的公网 IP 的解决方案是将 Elastic Agent 部署到位于我们信息安全基础设施前面的 nginx 代理上。
利用这些数据,我们现在可以识别通过代理发送 Elastic Agent、Auditbeat 或 Endgame 流量到我们集群的成功连接。我们所有的云服务器系统都安装了 Auditbeat 或 Elastic Agent,因此这些查询还将检测定期使用密钥运行 CI/CD 和 DevOps 管道的服务器系统的公网 IP 地址。
我们在 Tines 场景中用于从源 IP 检查托管工作站或服务器的路径。触发操作发出的虚线是当触发操作未返回 true 时场景流经的路径。
关闭告警 Send to Story
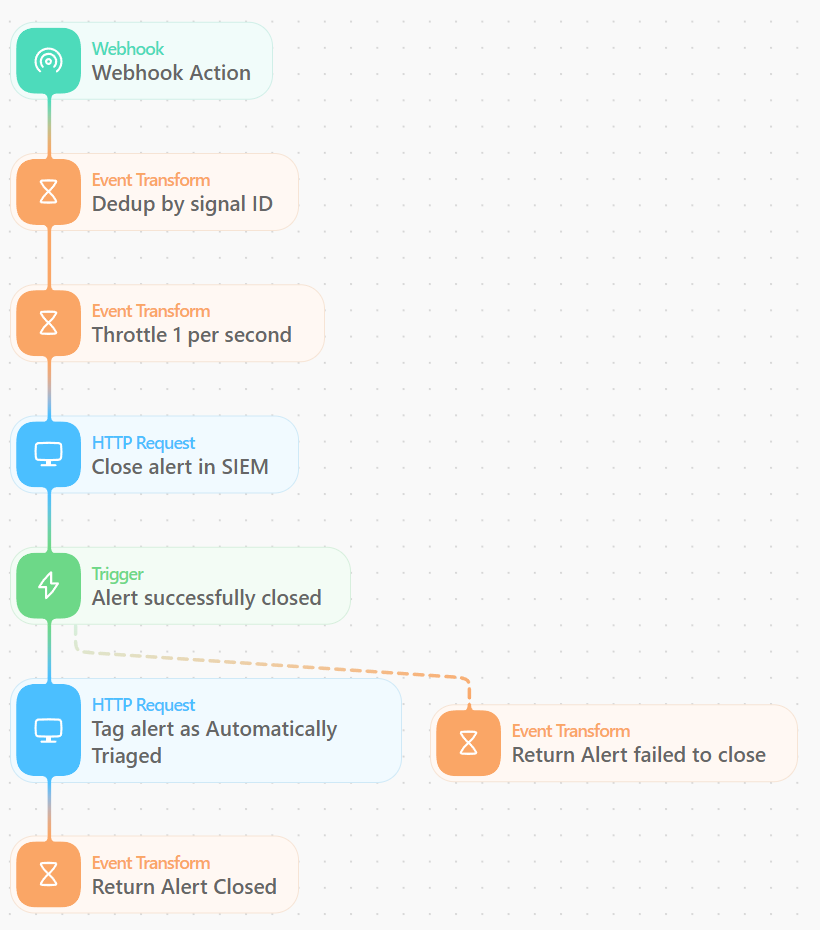
你可能已经注意到,每次我们想要关闭告警时,都会在 Tines 中使用 Send to Story 操作。该操作会通过 Webhook 将我们选择的字段发送到 Tines 中的一个新 story,然后我们在那里关闭并标记该告警。通过使用 Send to Story,我们让主 story 更易于维护,并且可以添加额外功能,例如按 signal ID 去重,这样我们就不会尝试从两个不同的分诊分支关闭同一个告警,以及使用 throttle 操作,这样如果大量告警同时涌入,我们就不会压垮 API。
我们还使用 Signals API 来更新规则标签,这对于指标和跟踪告警状态很有用。我们通过自动化分诊工作流关闭的所有告警也会被标记为 Automated Triage,这样我们就可以跟踪每月分诊的告警数量,并在 SIEM UI 中轻松查看某个告警是由自动化关闭还是由分析师关闭。
将未关闭告警升级到 Slack
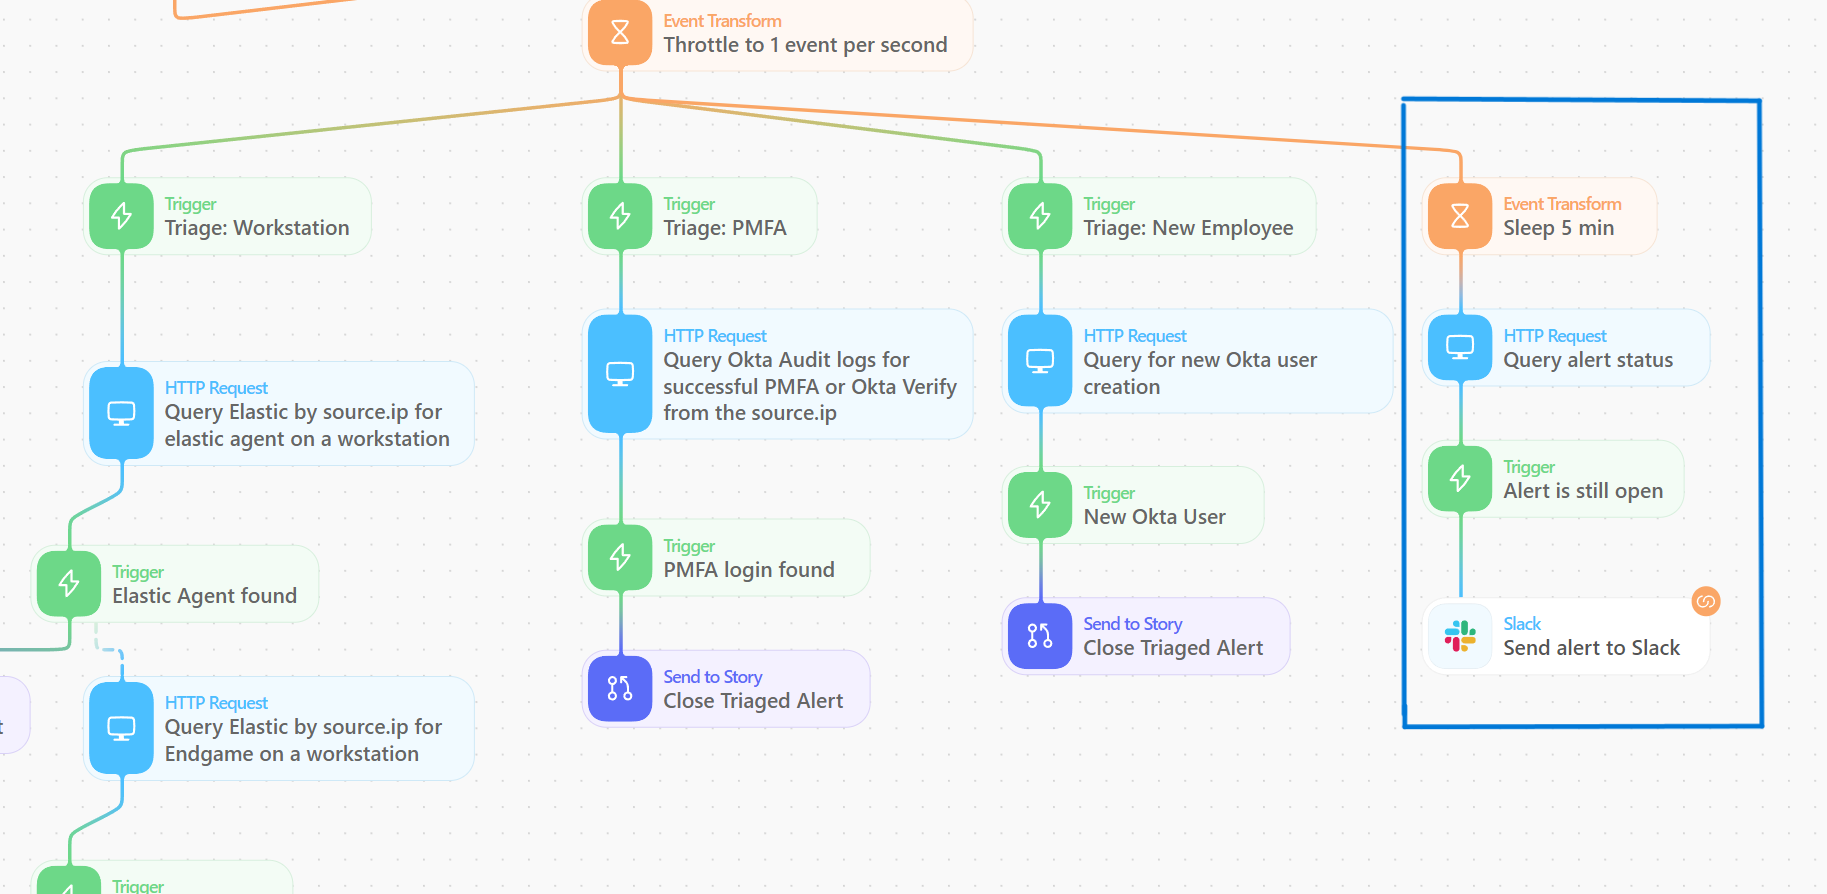
由于我们会并行地让告警经过各种自动化分诊路径,我们还会让 story 走一条暂停处理 5 分钟的路径。这 5 分钟的暂停让其他分支有时间完成并关闭任何被发现来自受信任源 IP 的告警。5 分钟暂停后,我们向 signals search API 发送请求,检查该告警是否仍处于未关闭状态。如果该告警仍处于未关闭状态,我们就向告警 Slack 频道发送消息,通知 SOC 分析师某个告警未被自动分诊。
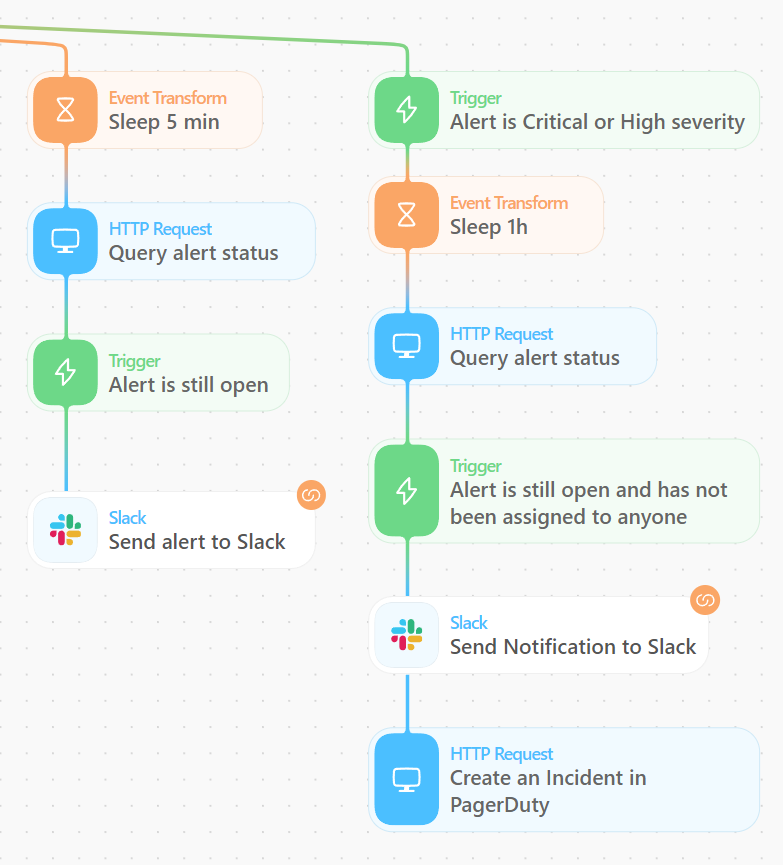
如果你想为这个 story 添加更多功能,Tines 可以轻松地为该 story 创建另一个分支来添加额外能力。例如,如果你有 SLA 要求你在一定时间内确认严重或高严重性告警,你可以添加逻辑,先等待一小时,然后检查该告警是否已在 Elastic SIEM 中被确认。如果该告警仍处于未关闭状态且尚未分配给任何人,你可以通过向 PagerDuty 发送告警或向另一个团队发送第二条 Slack 消息来进行升级。
Tines 还包含用于在 Elastic Security 中处理 Cases 的模板——在这个分支中增加几个额外操作,你就可以打开一个新 case,将其分配给值班分析师,并将告警详情添加到该 case 中。
我们遇到的挑战
安全领域没有什么是完美的,对于每一项安全控制措施,威胁行为者都有办法绕过。但某件事不完美并不意味着它不值得付出努力。一个明显的弱点是,这些告警对内部威胁的有效性有限;如果威胁行为者通过被入侵的工作站、服务器或企业 VPN 连接进行横向移动,那么他们就可以来自一个已知良好的 IP 地址,而对于带有自动化分诊工作流的规则,告警会被自动关闭。
对此我有两个论点:第一,如果没有这套自动化,大多数这些检测在不额外增加数百名员工的情况下根本无法部署。即使存在弱点,这些自动化检测也比没有提供更好的可见性。经过分诊的告警可用于威胁狩猎,并可纳入针对主机或用户的多个不同检测规则触发告警的检测中,因此它们仍然可以提供价值。
第二,如果我们能迫使威胁行为者改变他们的战术——比如迫使他们入侵并通过我们的某个工作站或服务器进行横向移动——那就会大幅提高检测几率。我们的工作站和服务器通过 Elastic Defend 进行了高度 instrumentation,并部署了一千多条检测规则。我们已经看到,大多数时候,当威胁行为者入侵 SaaS 凭据或 API 密钥令牌时,他们通常会从自己的基础设施直接连接到服务,而不是通过被入侵的主机。
构建这些检测时的另一个重大挑战是影子 IT,以及现代 IT 系统中与第三方之间的所有互连和信任关系。影子 IT 是一个术语,用于描述公司中的某个团队在没有经过所有适当渠道的情况下建立自己的 IT 系统,从而未将这些系统加入资产清单并安装 Elastic Agent 或 auditbeat。
当你构建这些分诊工作流并定义什么是“已知良好 IP”时,你也会不可避免地发现,有些 API 令牌正从并不属于你公司的 IP 地址以授权方式被使用。这些令牌通常用于各种第三方自动化,例如 GitHub Actions,或由 Qualys 或 Snyk 等扫描应用程序使用。追踪这些问题并构建例外可能需要时间,但当你识别并移除影子 IT 时,这也可能非常有价值。
在某些情况下,第三方提供商(如 Okta、GitHub 或 Elastic Cloud)会公开其公共 IP 地址空间,因此您可以构建额外的检查来过滤来自这些 IP 的活动。如果您使用的是 Tines 云租户,可以从 https://
示例检测
这些自动化最初是为单个检测规则而设计的解决方案,但我们发现它们在许多不同场景中都极具价值。对于许多检测规则,您可以问自己:“如果此告警是由我们确认属于我们的 IP 地址触发的,我们的 SOC 会关闭该告警吗?”我们发现,对于大多数针对第三方服务的行为检测规则而言,答案是肯定的,这使它们成为自动化分诊的理想候选。
我们自动化初始分诊的部分检测列表,希望能为您提供一些可以使用此工作流构建的检测思路。其中一些检测是为配合此自动化分诊工作流而构建的自定义检测,但许多是现有检测,我们为其添加了 Triage 标签以消除部分误报。
Okta 高风险身份验证
来自非 Okta IP 的 Okta Support 活动
来自新 IP 的 Okta API 活动
Okta UEBA:同一邮箱和 IP 的多个不同告警
Okta:单个 dt hash 关联多个邮箱地址
Okta 用户成功登录但未使用抗钓鱼 MFA
Okta 来自新 IP 的 MFA 豁免账户身份验证
Okta 用户密码重置或解锁尝试次数过多
代理后方同一设备令牌哈希的多个 Okta 用户认证事件
Okta 用户会话模拟
Okta 用户会话从不同地理位置启动
尝试暴力破解 Okta 用户账户
Slack UEBA:Slack 用户的多个不同告警
来自新 IP 的 GCP Portal 登录
来自新 IP 的 GCP IAM 活动
来自新 IP 的 Buildkite Web 活动
来自新 IP 的 Buildkite API 活动
GitHub:GitHub PAT 的多个 UEBA 告警
GitHub UEBA - 来自 GitHub 账户的多个告警
GitHub:用户克隆私有仓库激增
Hashicorp Vault:Vault 用户的多个 UEBA 告警
Azure Active Directory 高风险身份验证
来自新 IP 的 Azure Portal 登录
来自新 IP 的 Azure Active Directory PowerShell 登录
Azure Active Directory 设备代码身份验证
Azure Active Directory 未使用 MFA 的成功登录
来自新 IP 的 AWS IAM 活动
AWS Key UEBA:AWS 密钥的多个不同告警
AWS User UEBA:AWS 账户的多个不同告警
来自新 IP 的 AWS 控制台身份验证
AWS S3 存储桶枚举或暴力破解
尝试暴力破解 Microsoft 365 用户账户
O365 过多的单点登录错误
潜在的 SSH 暴力破解攻击成功
来自源 IP 的成功登录事件激增
来自互联网的 VNC(虚拟网络计算)
到互联网的 VNC(虚拟网络计算)
实现新级别的保护
在这篇博文中,我向您展示了 Elastic InfoSec 团队如何使用 Tines 自动化许多告警的初始分诊。这种自动化使我们能够获得更好的可见性,同时提升效率,并让我们将时间用于调查真正的威胁。使用 Tines,我们在过去 30 天内完全调查并关闭了超过 50K 个告警。每个告警都在触发后的几秒内被彻底调查并关闭。没有这项技术,我们不可能在网络中实现同等水平的保护。
如果您想亲自尝试,可以通过 Elastic Cloud 的 14 天免费试用和 Tines 始终免费的社区版来体验这些工作流对您的强大之处。
本博文中描述的任何功能或特性的发布和时间安排均由 Elastic 自行决定。当前不可用的任何功能或特性可能不会按时交付,也可能根本不会交付。
注册 Elastic Cloud 免费试用
在您选择的云提供商上启动一个功能齐全的部署。作为 Elasticsearch 背后的公司,我们将我们的功能和支持带到您在云中的 Elastic 集群。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Elastic Blog
原创地址:https://www.elastic.co/blog/false-positives-automated-siem-investigations-elastic-tines
原文作者:['Aaron Jewitt'];如有侵权,请联系管理员删除。

