今天我们发布 Claude Opus 4.1,这是对 Claude Opus 4 在智能体任务、真实世界编码和推理方面的升级。我们计划在未来几周内发布对我们模型的更大幅度的改进。
Opus 4.1 现已面向付费 Claude 用户和 Claude Code 提供。它也已上线我们的 API(应用程序编程接口)、Amazon Bedrock 和 Google Cloud 的 Vertex AI。定价与 Opus 4 相同。
Claude Opus 4.1
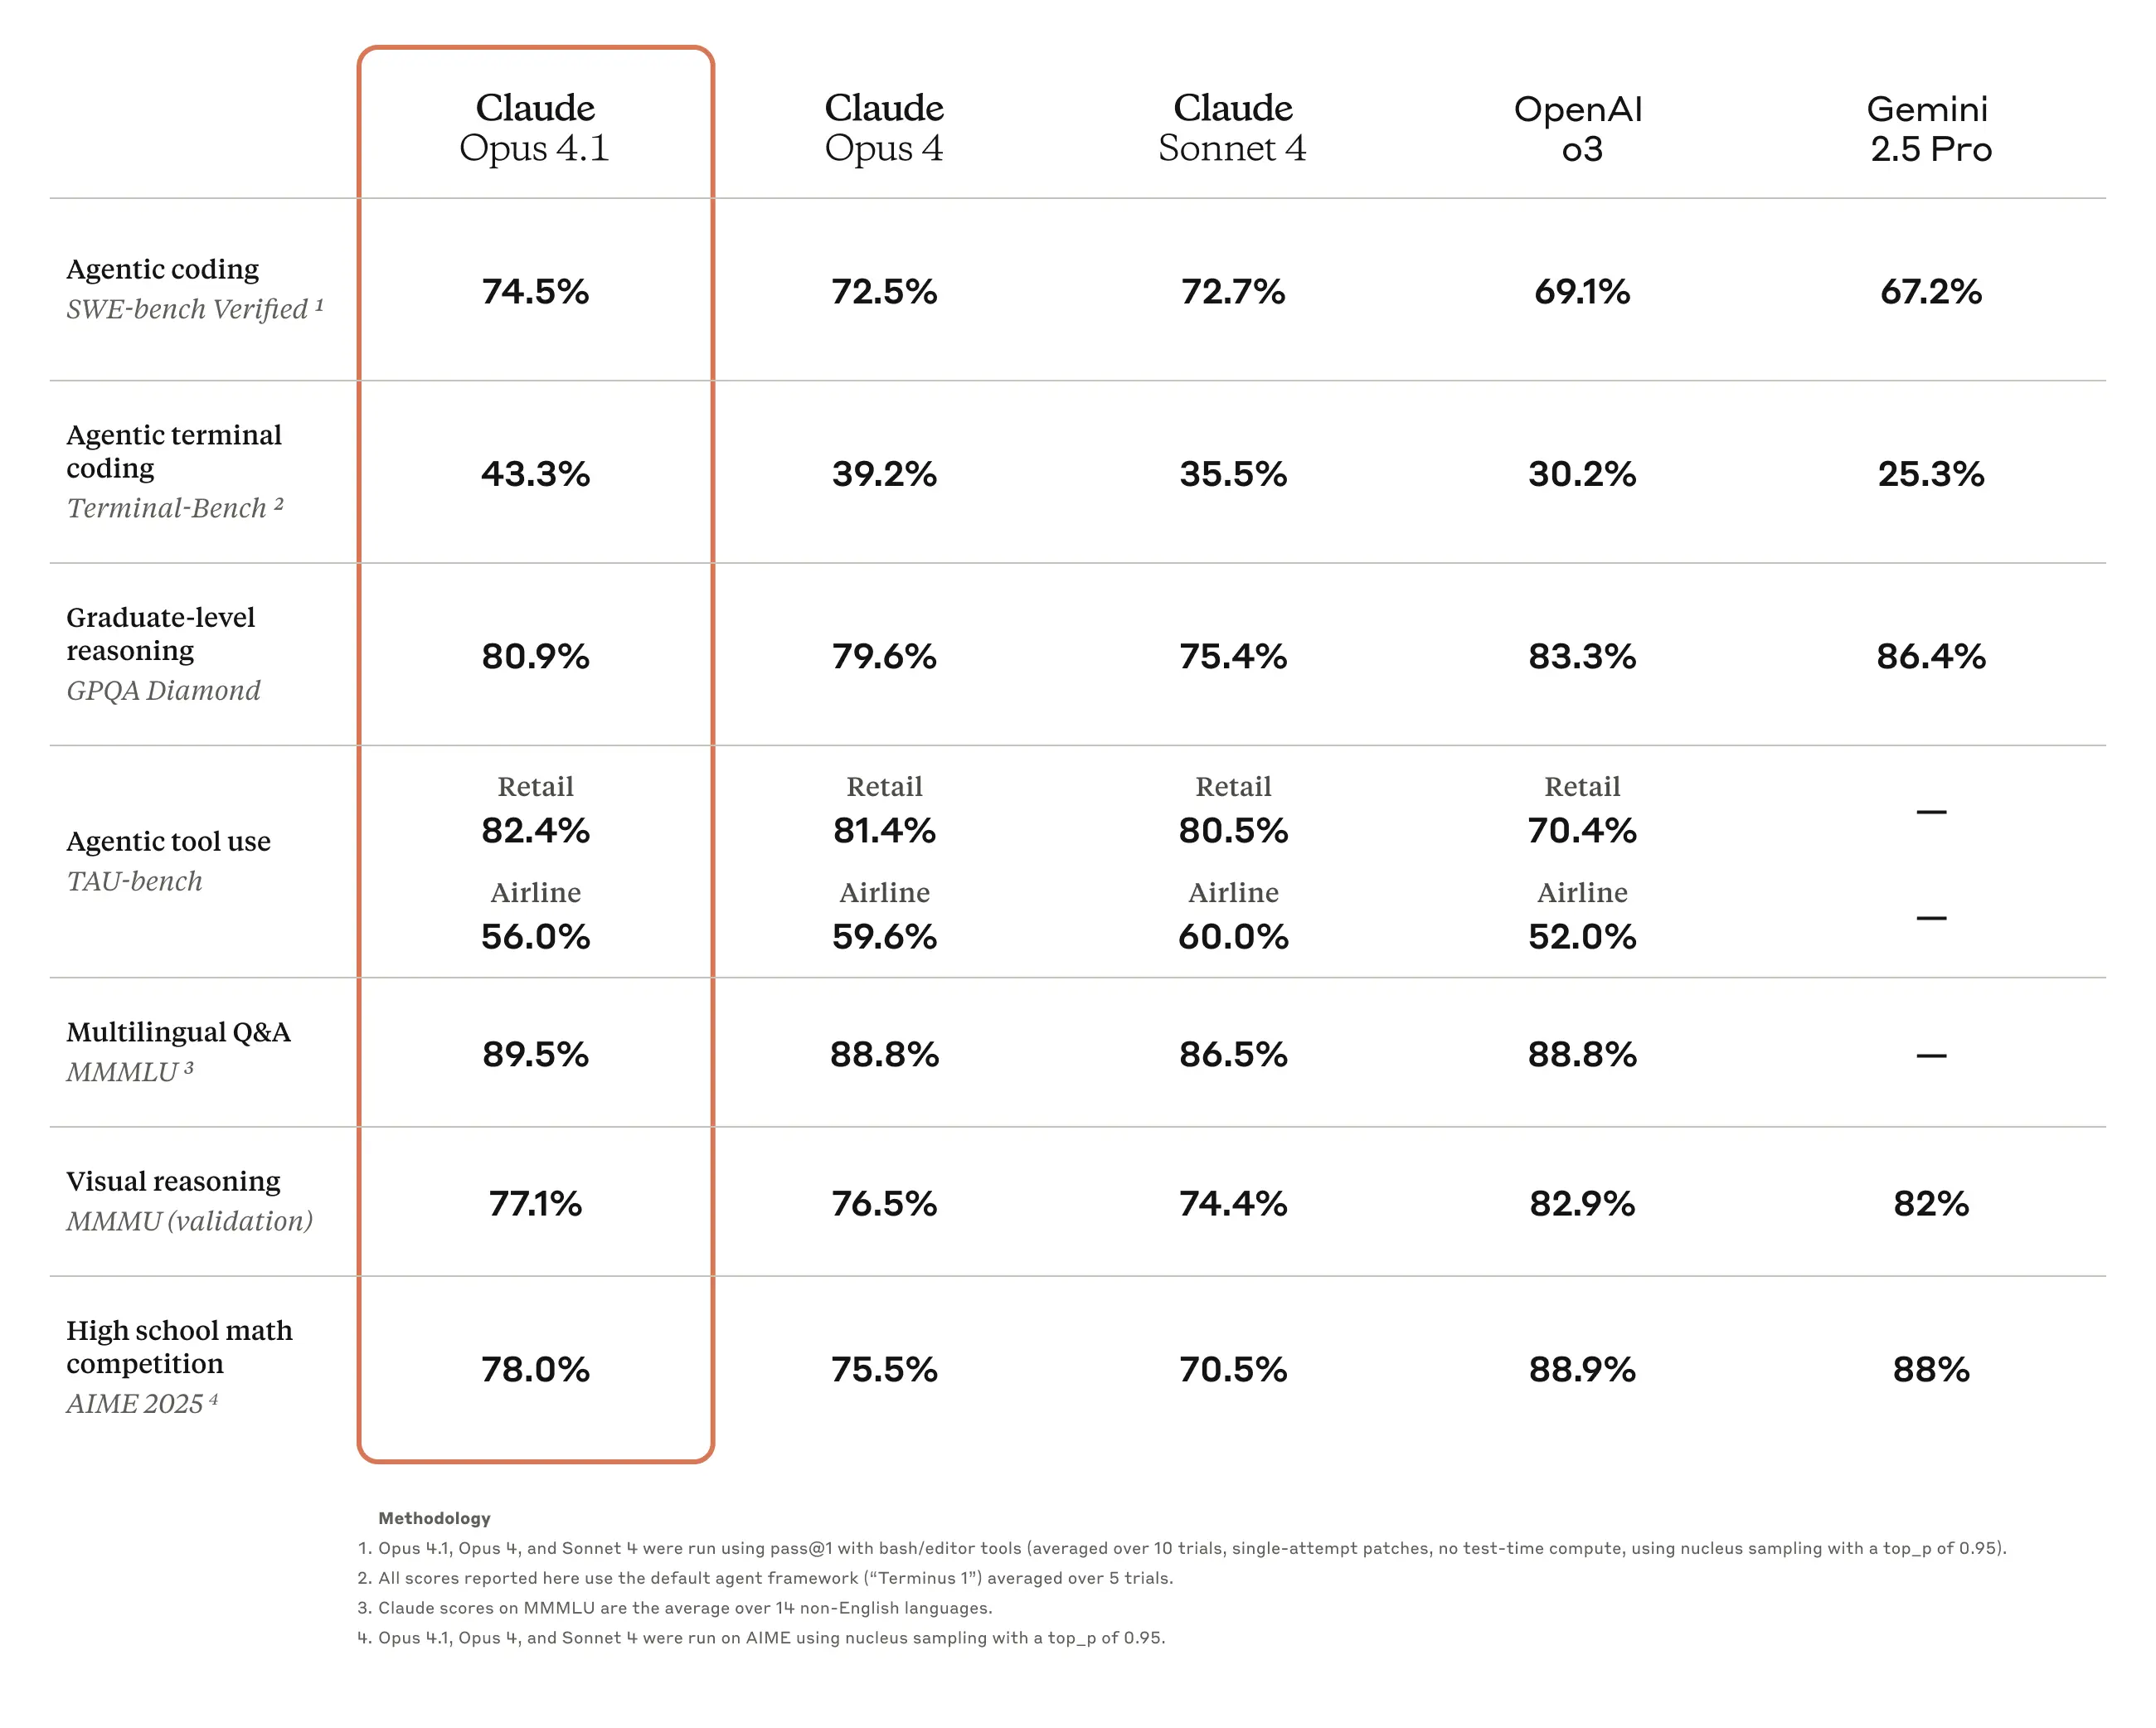
Opus 4.1 将我们最先进的编码性能提升至 SWE-bench Verified 上的 74.5%。它还提升了 Claude 的深度研究和数据分析能力,尤其是在细节追踪和智能体搜索方面。
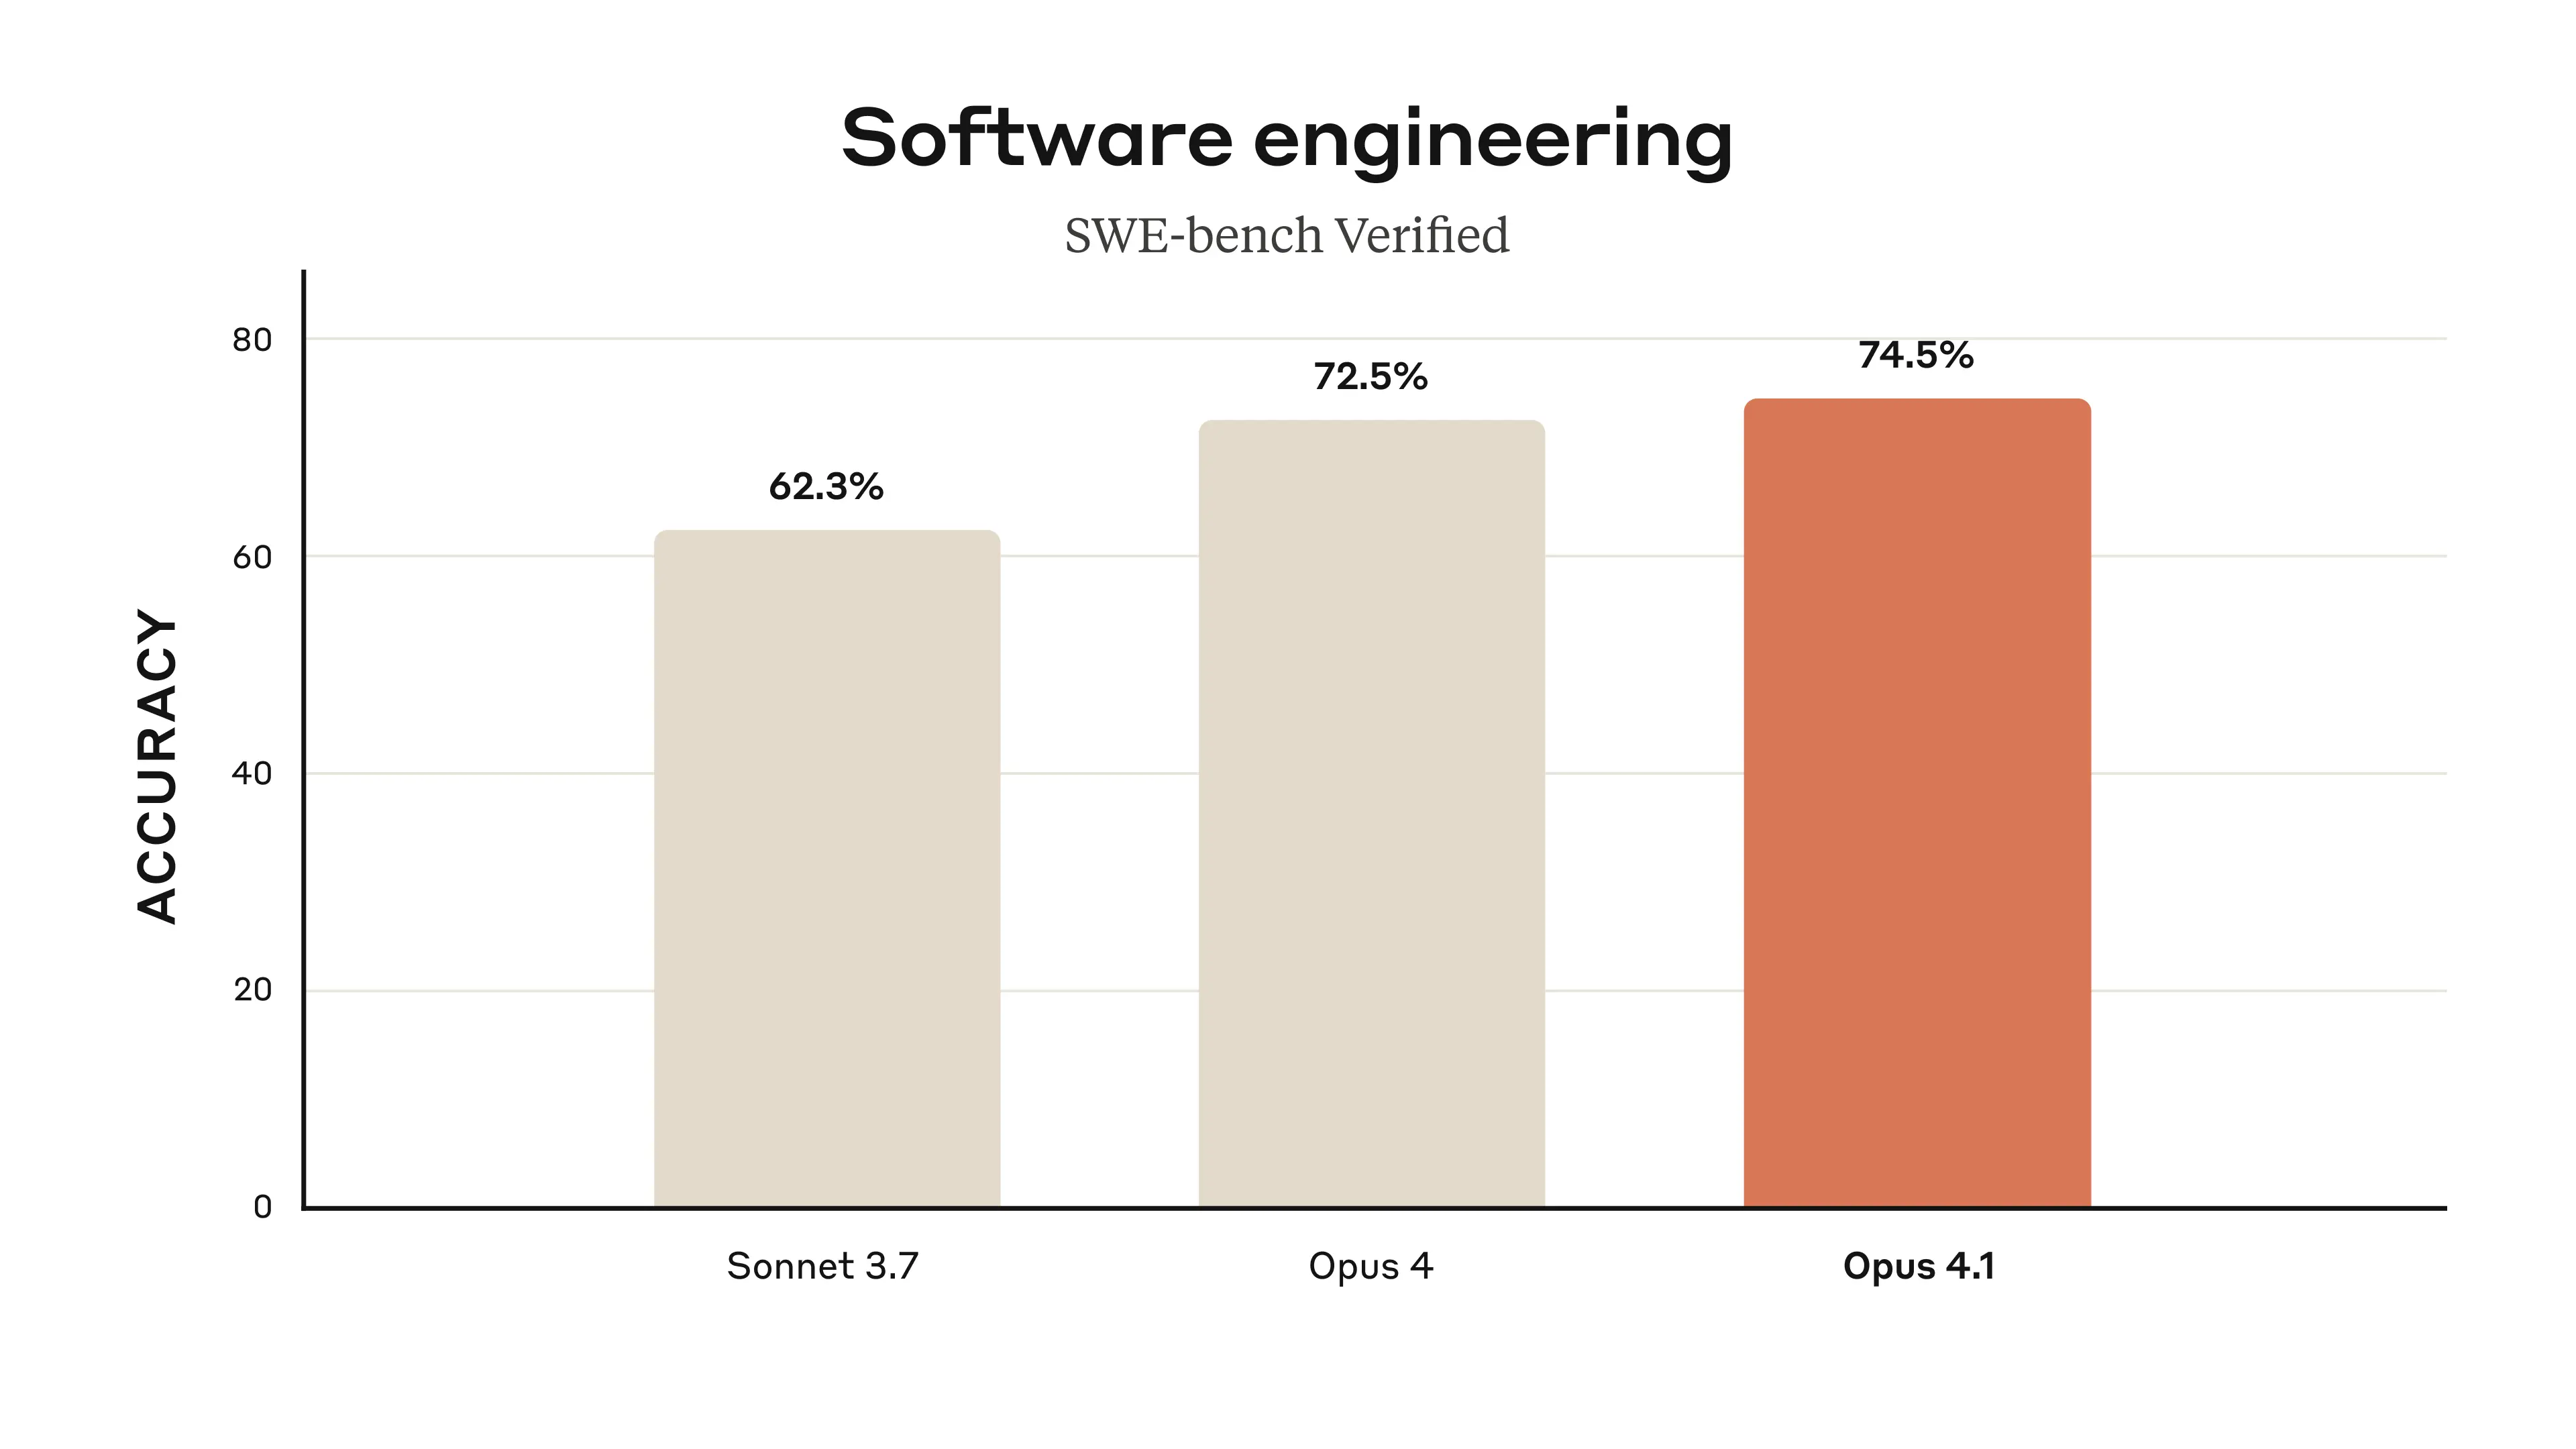
GitHub 指出,相较于 Opus 4,Claude Opus 4.1 在大多数能力上都有所提升,其中在多文件代码重构方面的性能提升尤为显著。Rakuten Group 发现,Opus 4.1 擅长在大型代码库中精确定位确切的修正点,而不会做出不必要的调整或引入错误,其团队在日常调试任务中更青睐这种精确性。Windsurf 报告称,Opus 4.1 在其初级开发者基准测试中相较 Opus 4 带来了一个标准差的提升,显示出与从 Sonnet 3.7 到 Sonnet 4 的跃升大致相同的性能提升。
开始使用
我们建议所有用途都从 Opus 4 升级到 Opus 4.1。如果你是开发者,只需通过 API 使用 claude-opus-4-1-20250805。你也可以查看我们的系统卡、模型页面、定价页面和文档以了解更多信息。
一如既往,你的反馈有助于我们改进,尤其是在我们继续发布新的、更强大的模型之际。
附录
OpenAI:o3 发布文章、o3 系统卡
Gemini:2.5 Pro 模型卡
Claude:Sonnet 3.7 发布文章、Claude 4 发布文章
Claude 模型是混合推理模型。本博文中报告的基准测试显示了使用或不使用扩展思考时达到的最高分数。我们在下面为每个结果注明了是否使用了扩展思考:
未使用扩展思考:SWE-bench Verified、Terminal-Bench
以下基准测试是在使用扩展思考(最多 64K tokens)的情况下报告的:TAU-bench、GPQA Diamond、MMMLU、MMMU、AIME
TAU-bench 方法论
分数是通过在 Airline 和 Retail Agent(智能体) Policy 中添加提示附录实现的,该附录指示 Claude 在使用扩展思考与工具使用时更好地利用其推理能力。我们鼓励模型在解决多轮轨迹问题时,将思考过程写下来,与我们通常的思考模式不同,以最佳方式利用其推理能力。为了适应 Claude 通过使用更多思考而产生的额外步骤,最大步骤数(按模型完成次数计算)从 30 增加到 100(大多数轨迹在 30 步以内完成,只有一条轨迹超过 50 步)。
SWE-bench 方法论
对于 Claude 4 系列模型,我们继续使用相同的简单脚手架,仅为模型配备我们之前发布中描述的两个工具——一个 bash 工具,以及一个通过字符串替换操作的文件编辑工具。我们不再包含 Claude 3.7 Sonnet 使用的第三个“规划工具”。在所有 Claude 4 模型上,我们报告全部 500 个问题的分数。OpenAI 模型的分数报告基于 477 个问题的子集。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Anthropic Blog
原文作者:Anthropic Blog;如有侵权,请联系管理员删除。

