今天,我们推出下一代 Claude 模型:Claude Opus 4 和 Claude Sonnet 4,为编码、高级推理和 AI 智能体(Agent(智能体))设定了新标准。
Claude Opus 4 是全球最佳编码模型,在复杂、长时间运行的任务和智能体工作流中保持持续性能。Claude Sonnet 4 是 Claude Sonnet 3.7 的重大升级,提供卓越的编码和推理能力,同时更精确地响应您的指令。
除了模型之外,我们还宣布:
扩展思考与工具使用(测试版):两个模型都可以在扩展思考期间使用工具——如网络搜索——允许 Claude 在推理和工具使用之间交替以改进响应。
新模型能力:两个模型都可以并行使用工具,更精确地遵循指令,并且——当开发者授予本地文件访问权限时——展现出显著改进的记忆能力,提取并保存关键事实以保持连续性并随时间积累隐性知识。
Claude Code 现已正式可用:在研究预览期间收到大量积极反馈后,我们正在扩展开发者与 Claude 协作的方式。Claude Code 现在支持通过 GitHub Actions 执行后台任务,并与 VS Code 和 JetBrains 原生集成,直接在您的文件中显示编辑内容,实现无缝结对编程。
新 API(应用程序编程接口) 能力:我们在 API 上发布四项新能力,使开发者能够构建更强大的 AI 智能体:代码执行工具、MCP 连接器、Files API,以及最长缓存提示一小时的能力。
Claude Opus 4 和 Sonnet 4 是混合模型,提供两种模式:近乎即时的响应和用于深度推理的扩展思考。Pro、Max、Team 和 Enterprise Claude 计划均包含这两个模型和扩展思考,Sonnet 4 也向免费用户开放。两个模型均可在我们的 API、Amazon Bedrock 和 Google Cloud 的 Vertex AI 上使用。定价与之前的 Opus 和 Sonnet 模型保持一致:Opus 4 为每百万 token(输入/输出)$15/$75,Sonnet 4 为 $3/$15。
Claude 4
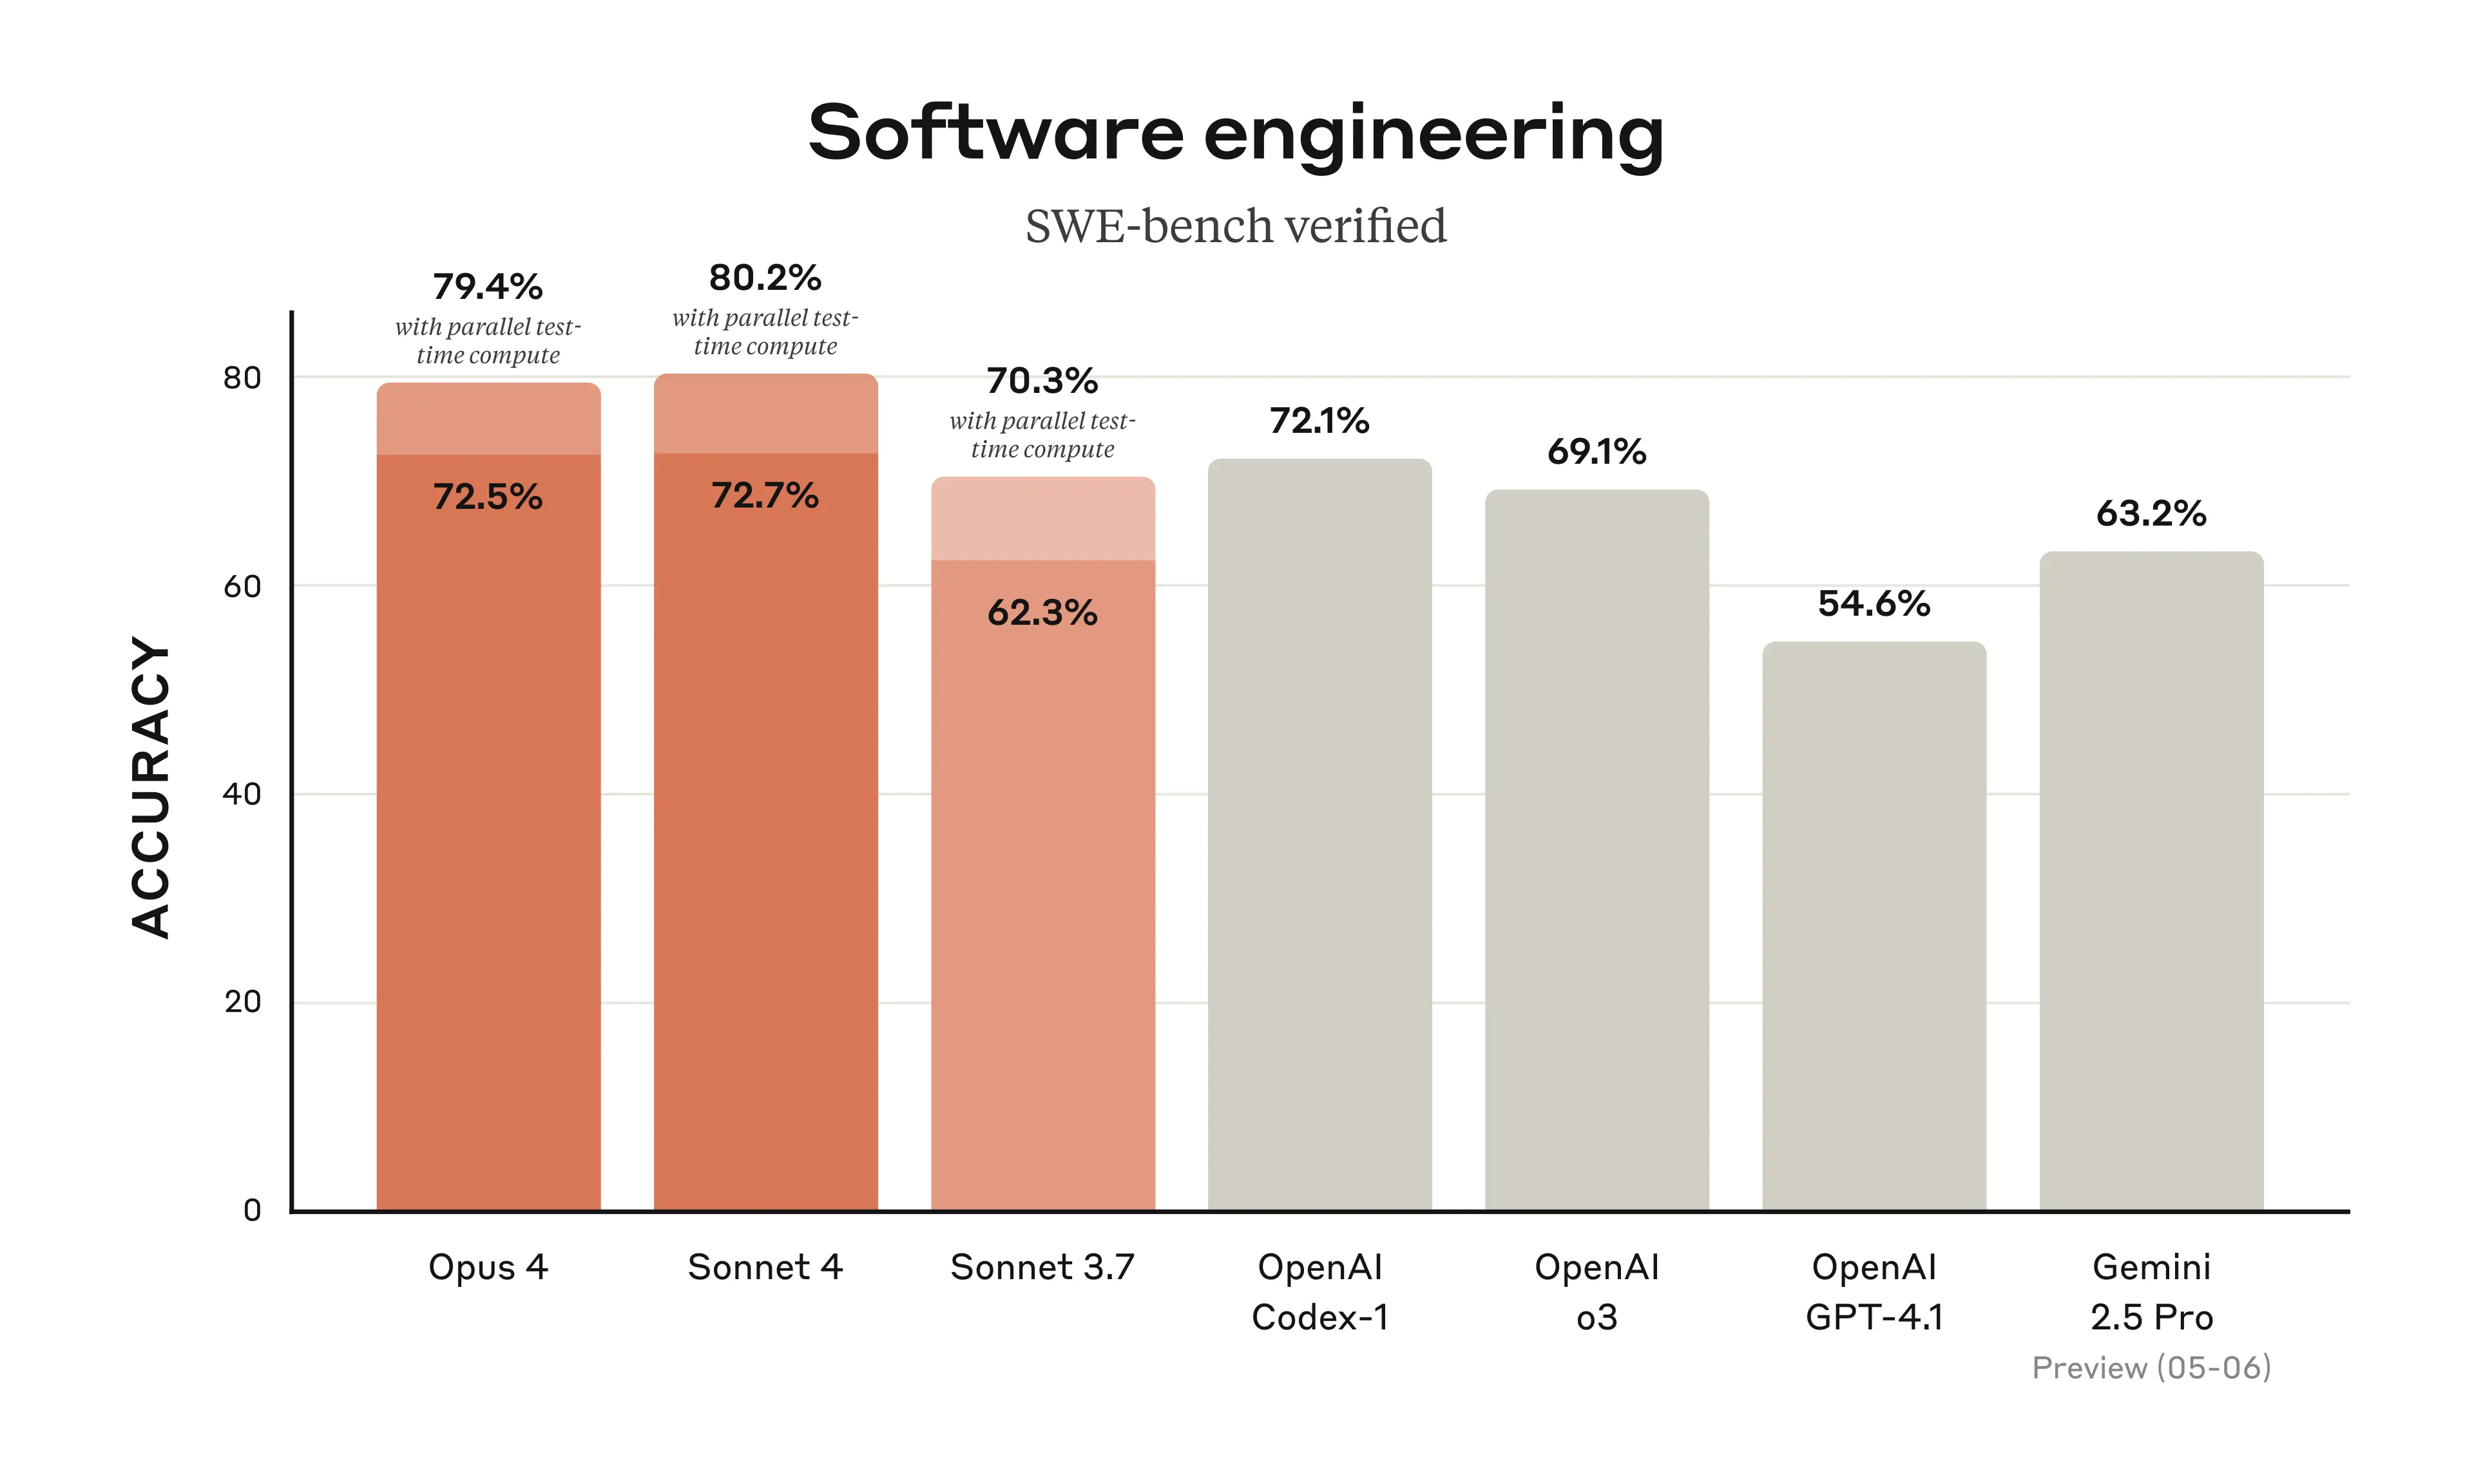
Claude Opus 4 是我们迄今为止最强大的模型,也是全球最佳编码模型,在 SWE-bench(72.5%)和 Terminal-bench(43.2%)上领先。它在需要集中精力和数千步骤的长时间运行任务中保持持续性能,能够连续工作数小时——大幅超越所有 Sonnet 模型,显著扩展了 AI 智能体所能完成的任务范围。
Claude Opus 4 在编码和复杂问题解决方面表现出色,为前沿智能体产品提供动力。Cursor 称其为编码领域的最先进技术,在复杂代码库理解方面实现了飞跃。Replit 报告称其在跨多个文件的复杂变更中精度提升、进展显著。Block 称其为首个在其智能体(代号 goose)中提升编辑和调试期间代码质量的模型,同时保持完整的性能和可靠性。Rakuten 通过一项高要求的开源重构验证了其能力,该重构独立运行 7 小时并保持持续性能。Cognition 指出 Opus 4 擅长解决其他模型无法解决的复杂挑战,成功处理了之前模型遗漏的关键操作。
Claude Sonnet 4 显著提升了 Sonnet 3.7 的行业领先能力,在编码方面表现出色,SWE-bench 达到最先进的 72.7%。该模型在内部和外部用例中平衡了性能与效率,并增强了可控性,使实现过程更易于掌控。虽然在大多数领域不及 Opus 4,但它提供了能力与实用性的最佳组合。
GitHub 表示 Claude Sonnet 4 在智能体场景中表现卓越,并将引入它作为 GitHub Copilot 中新编码智能体的驱动模型。Manus 强调了其在遵循复杂指令、清晰推理和美观输出方面的改进。iGent 报告称 Sonnet 4 在自主多功能应用开发方面表现出色,问题解决和代码库导航能力也大幅提升——将导航错误从 20% 降至接近零。Sourcegraph 表示该模型展现出成为软件开发重大飞跃的潜力——更长时间保持正轨、更深入理解问题,并提供更优雅的代码质量。Augment Code 报告称成功率更高、代码编辑更精准、复杂任务处理更细致,使其成为其主要模型的首选。
这些模型全面推进了客户的 AI 战略:Opus 4 在编码、研究、写作和科学发现方面突破边界,而 Sonnet 4 作为 Sonnet 3.7 的即时升级,将前沿性能带入日常用例。
模型改进
除了带工具使用的扩展思考、并行工具执行和记忆改进之外,我们还显著减少了模型使用捷径或漏洞来完成任务的行为。在特别容易出现捷径和漏洞的智能体任务上,这两个模型出现此类行为的可能性比 Sonnet 3.7 低 65%。
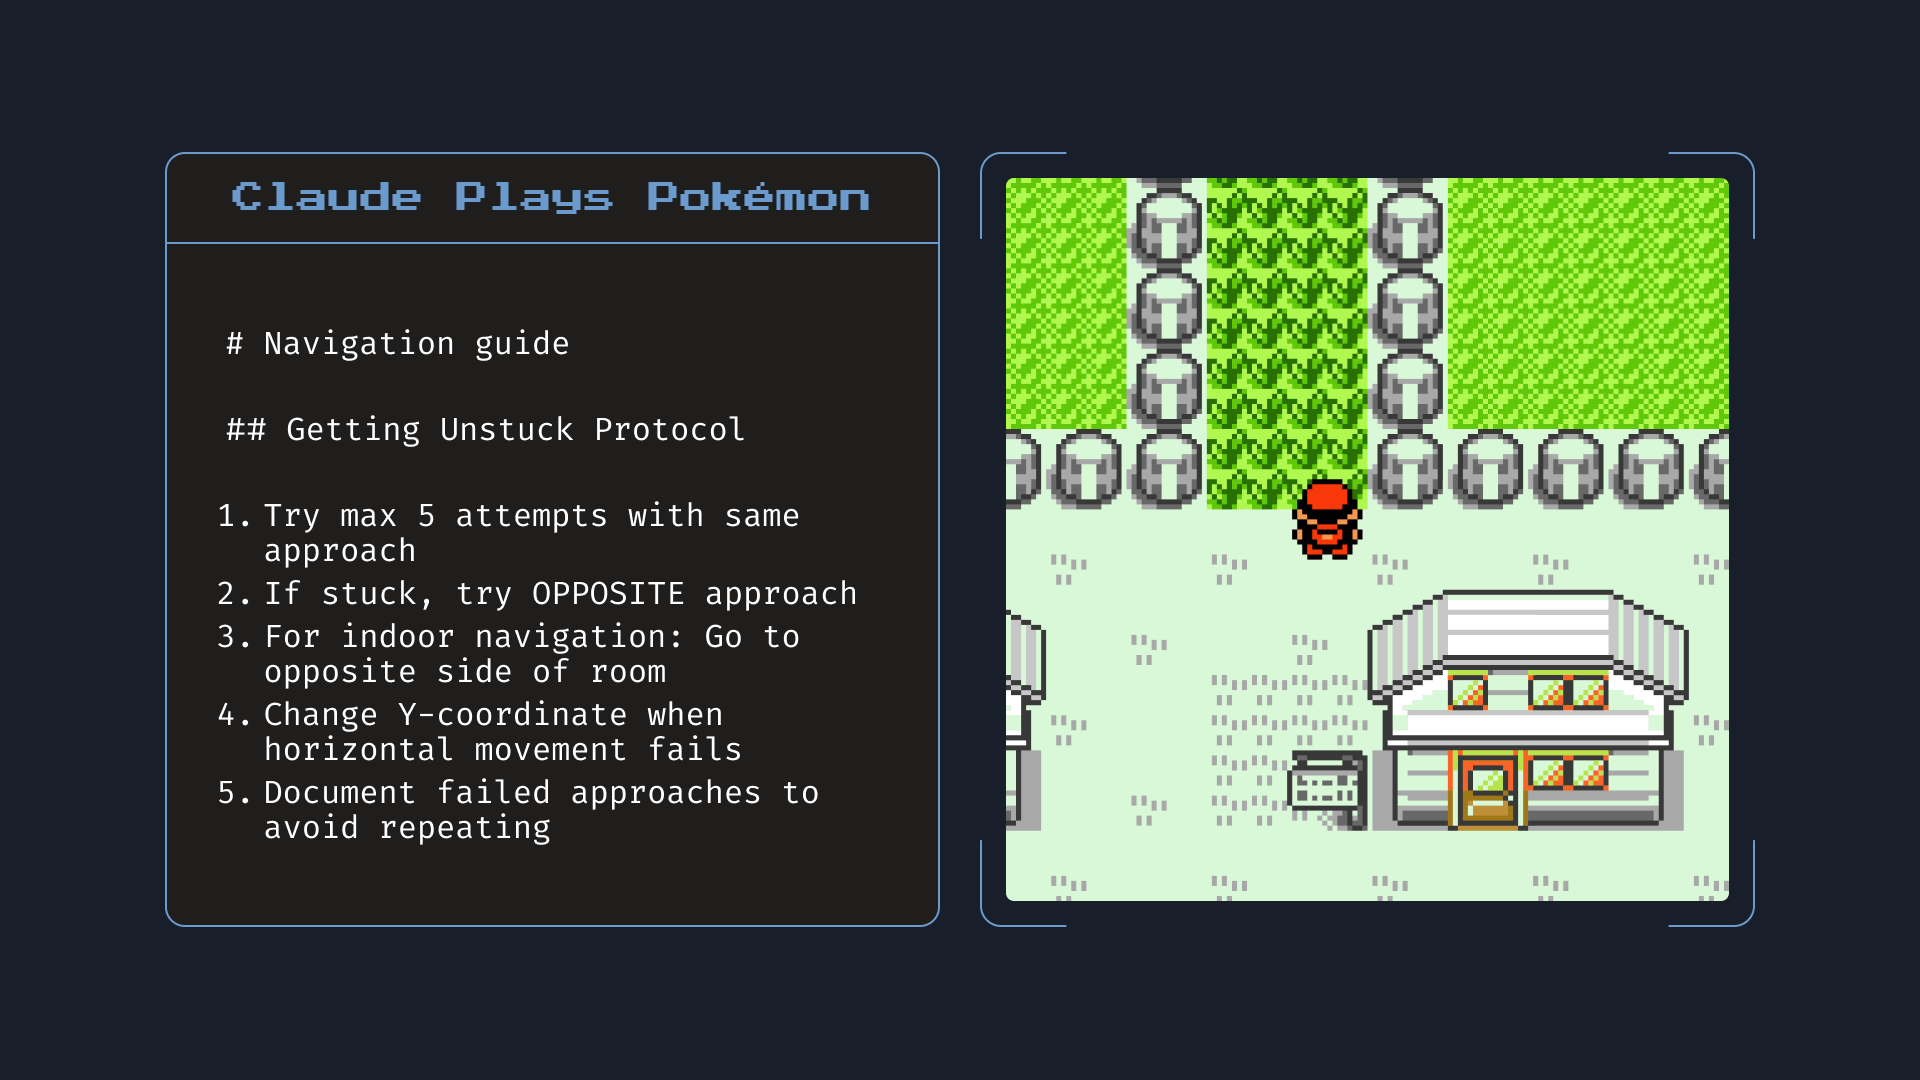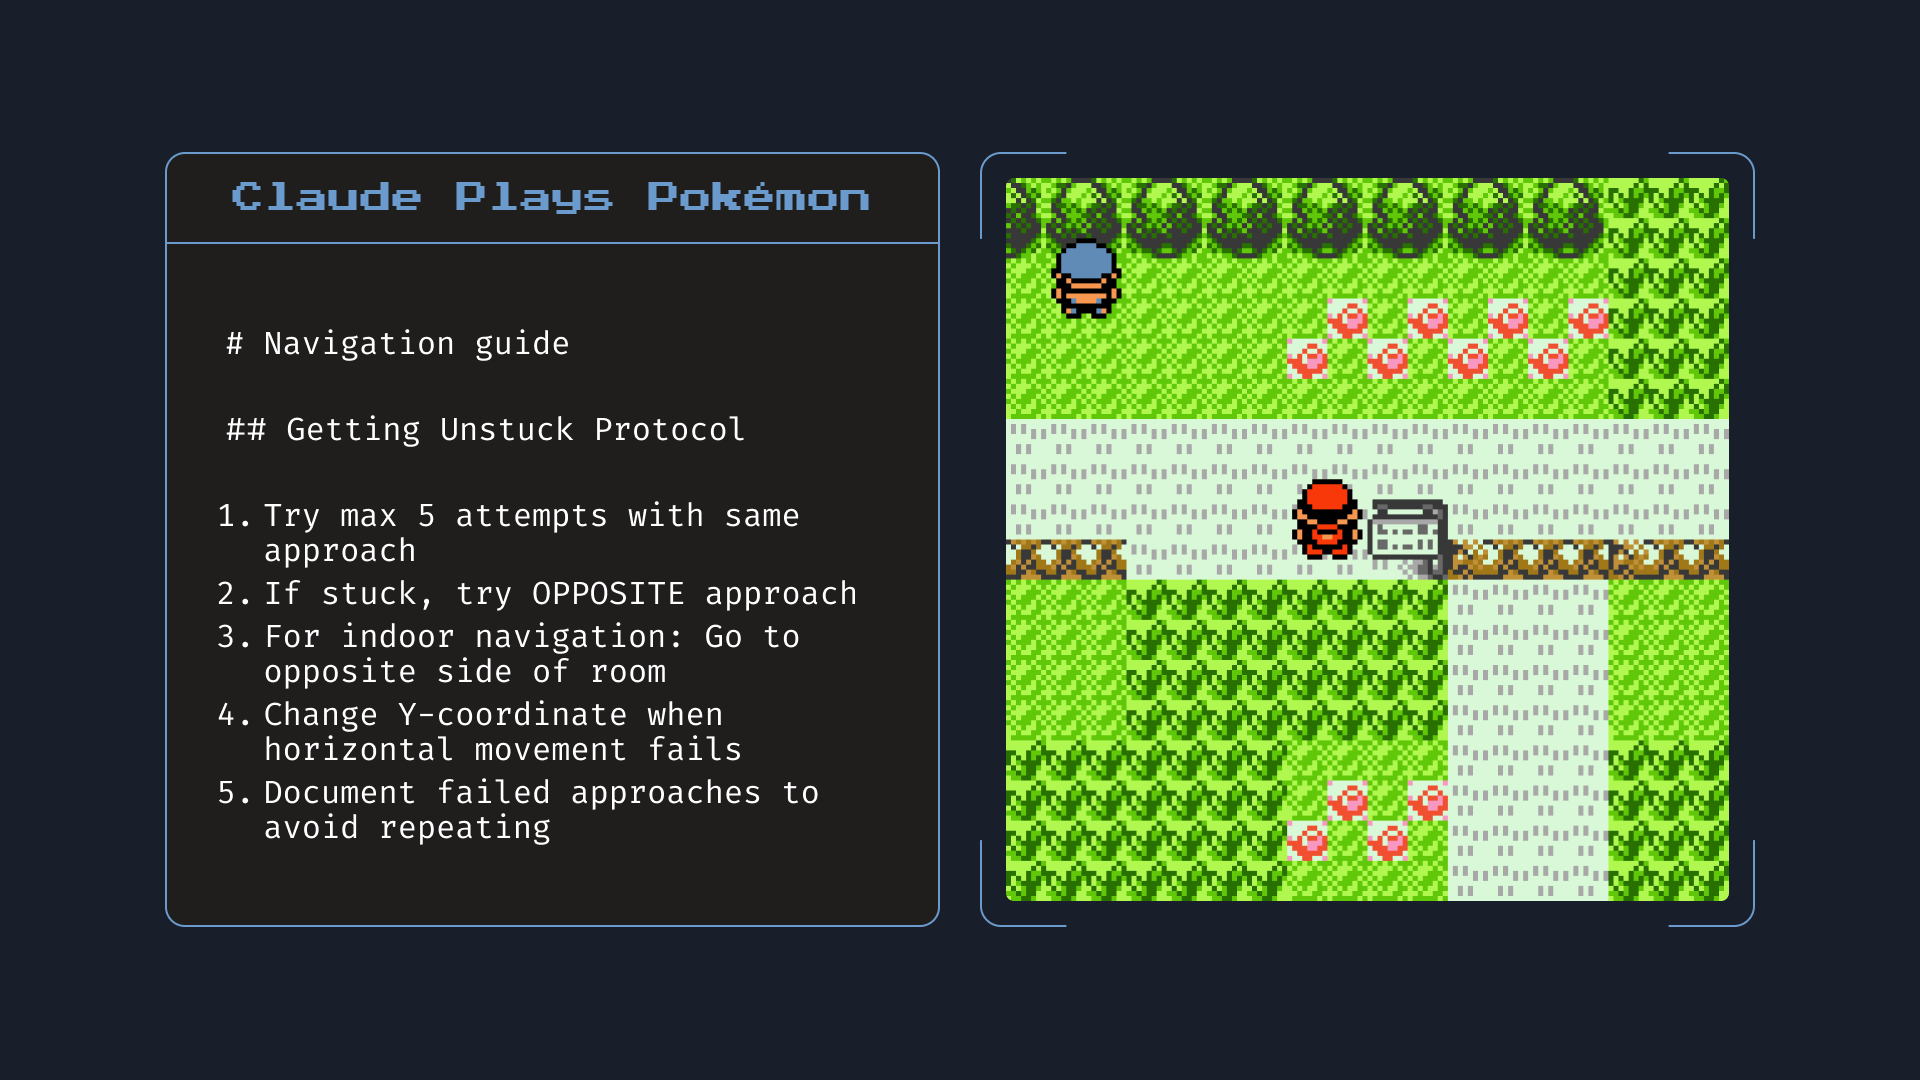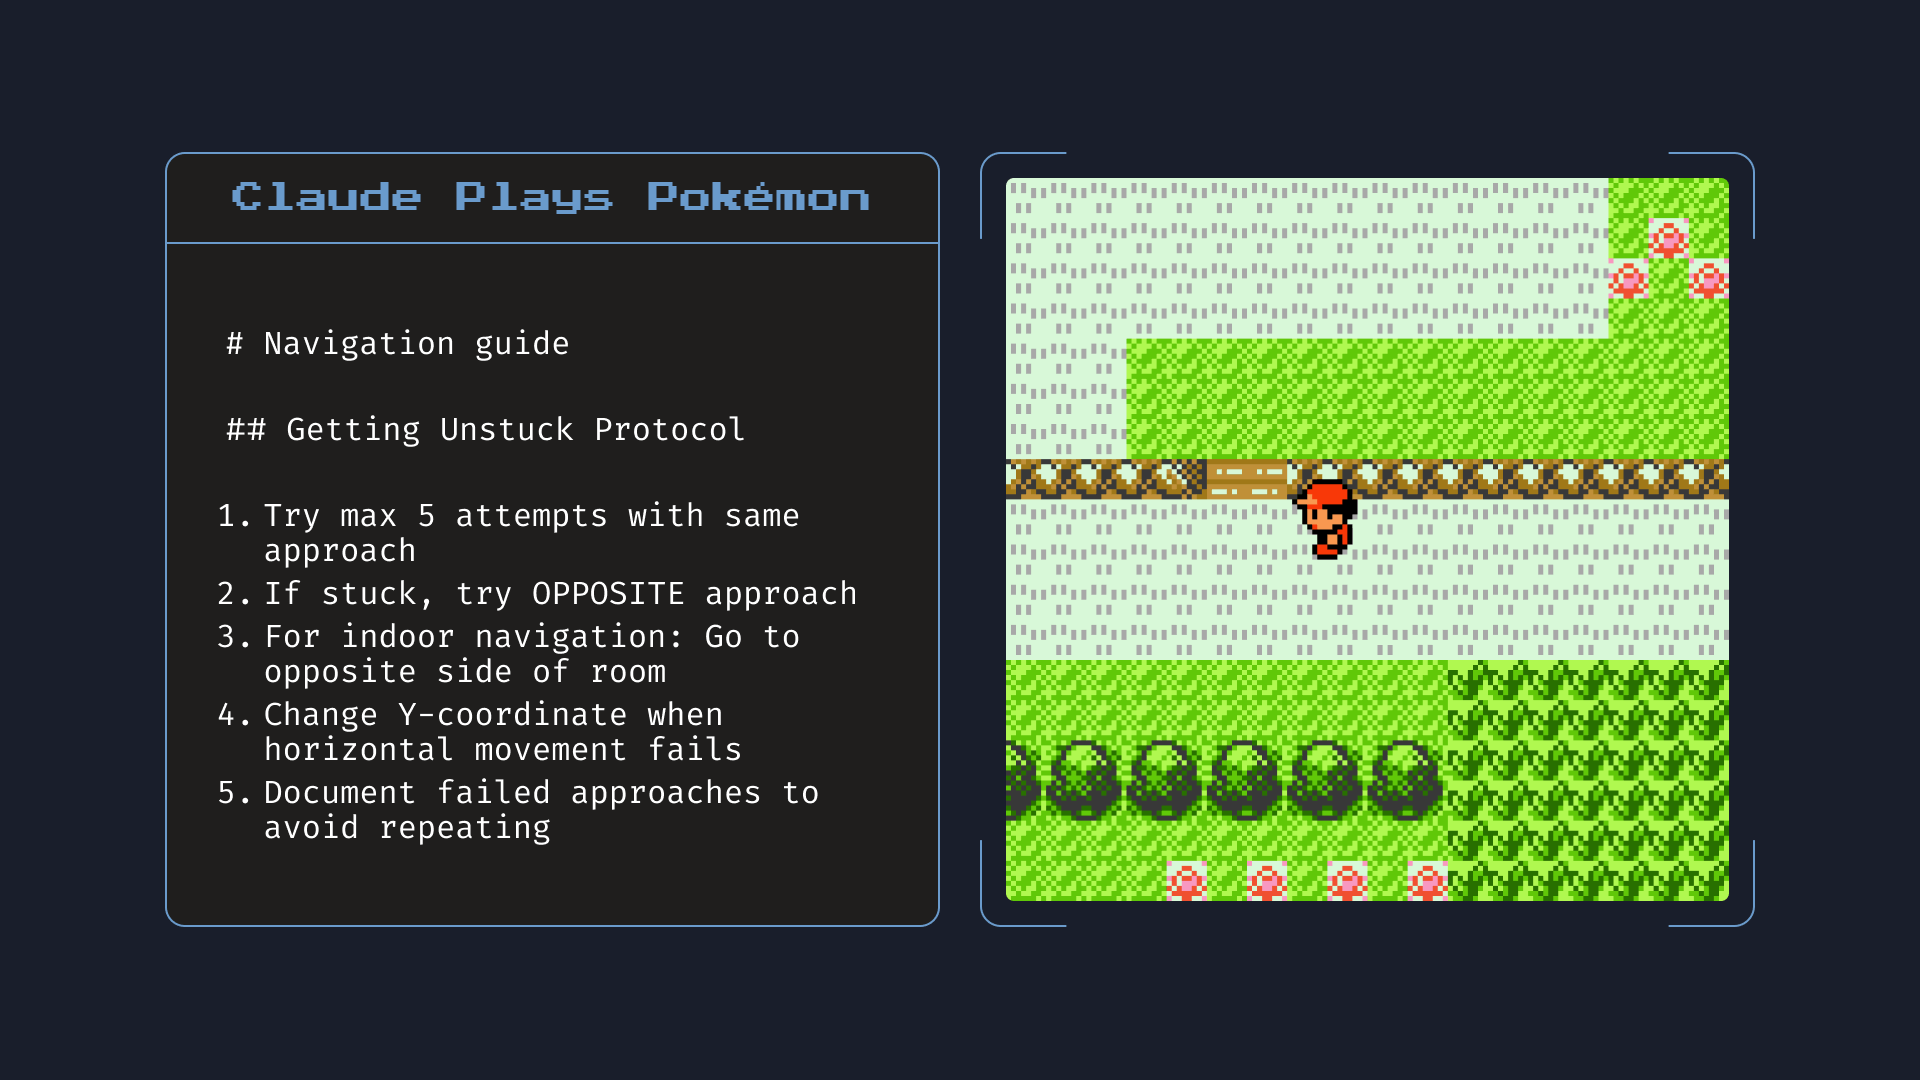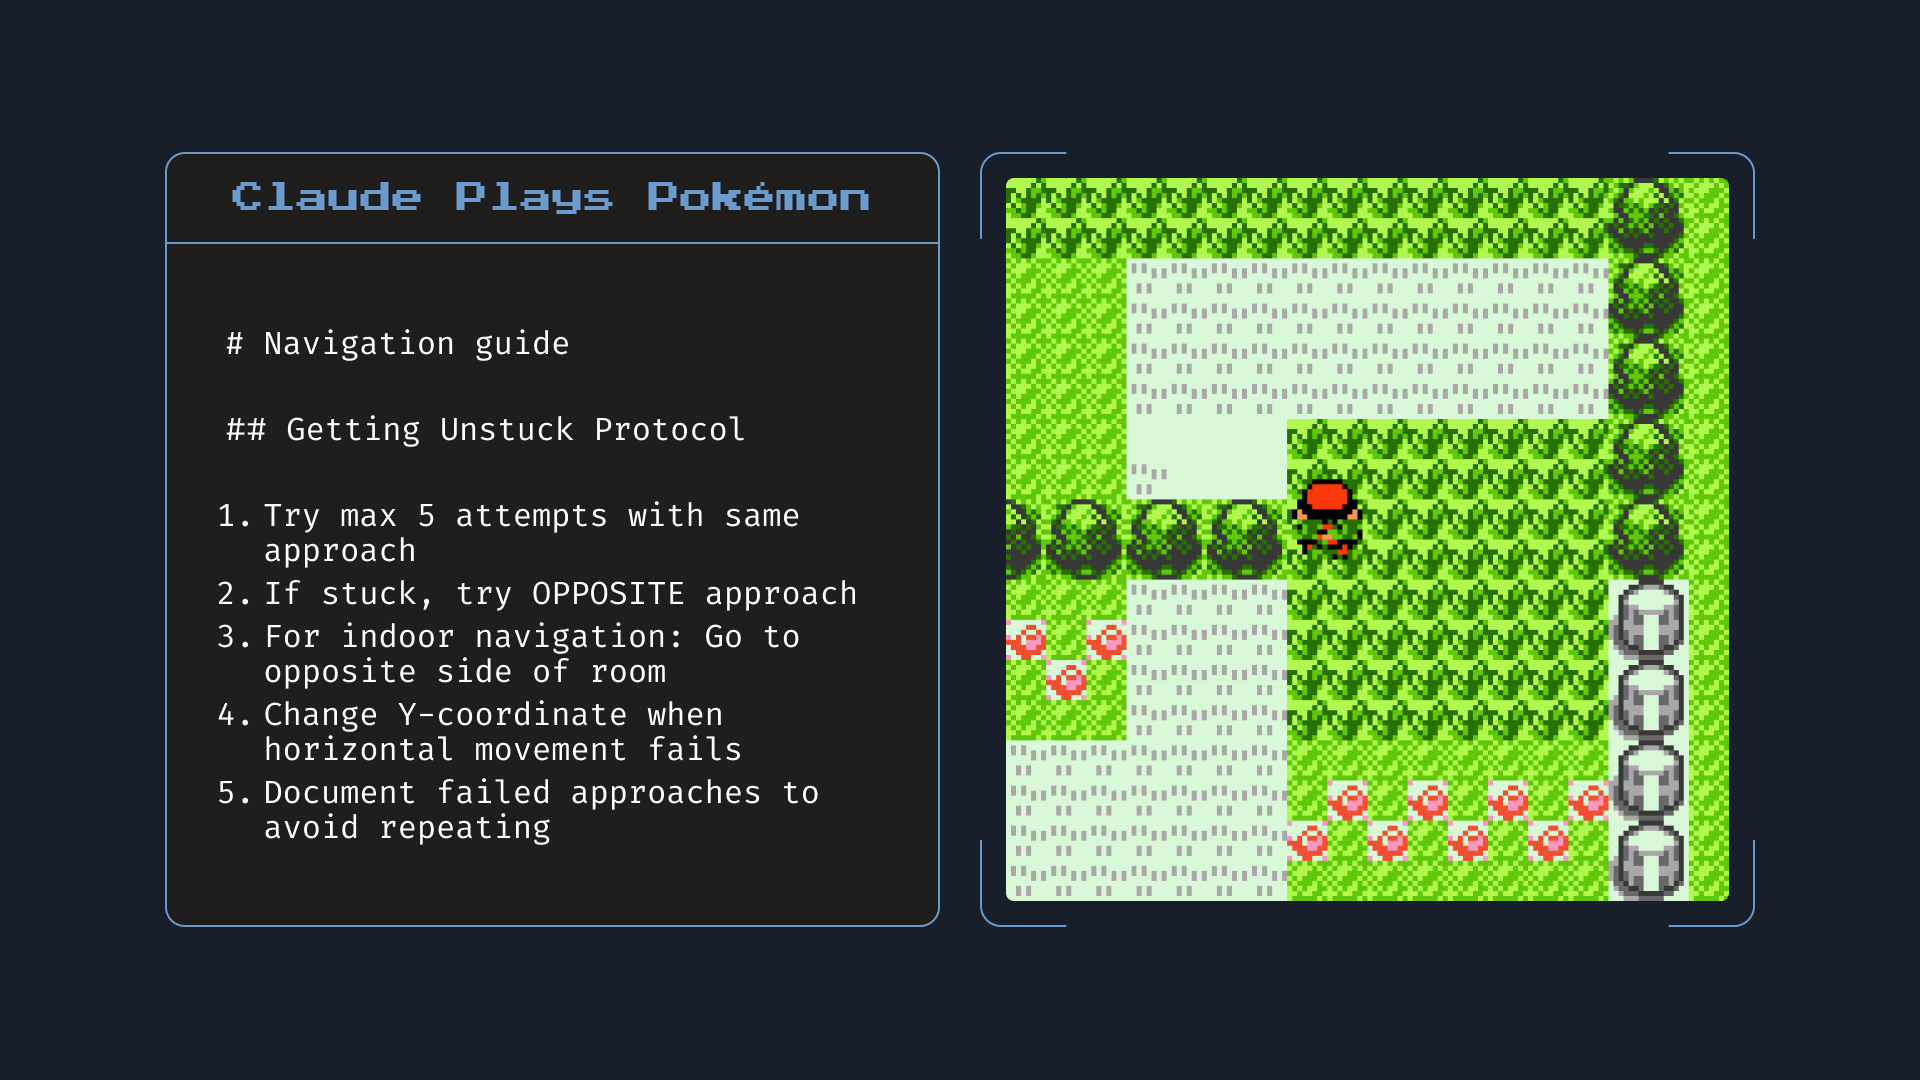
Claude Opus 4 在记忆能力上也大幅超越所有之前的模型。当开发者构建为 Claude 提供本地文件访问权限的应用程序时,Opus 4 能够熟练地创建和维护“记忆文件”来存储关键信息。这解锁了更好的长期任务意识、连贯性和智能体任务表现——例如 Opus 4 在玩 Pokémon 时创建“导航指南”。
最后,我们为 Claude 4 模型引入了思考摘要功能,使用一个较小的模型来压缩冗长的思考过程。这种摘要仅在约 5% 的情况下需要——大多数思考过程都足够短,可以完整显示。需要原始思维链进行高级提示工程(prompt engineering)的用户可以联系销售团队了解我们新的 Developer Mode,以保留完整访问权限。
Claude Code
Claude Code 现已正式可用,将 Claude 的强大能力带入更多开发工作流——在终端中、在你喜欢的 IDE 中,以及通过 Claude Code SDK 在后台运行。
面向 VS Code 和 JetBrains 的新 beta 扩展将 Claude Code 直接集成到你的 IDE 中。Claude 提出的编辑会以内联方式显示在你的文件中,在熟悉的编辑器界面内简化审查和跟踪。只需在 IDE 终端中运行 Claude Code 即可安装。
除了 IDE 之外,我们还发布了可扩展的 Claude Code SDK,让你可以使用与 Claude Code 相同的核心智能体来构建自己的智能体和应用程序。我们还发布了一个展示 SDK 能力的示例:Claude Code on GitHub,现已进入 beta 阶段。在 PR 上标记 Claude Code,即可回应审查者反馈、修复 CI 错误或修改代码。要安装,请在 Claude Code 中运行 /install-github-app。
开始使用
这些模型是迈向虚拟协作者的重要一步——保持完整上下文、在更长期项目中维持专注,并推动变革性影响。它们经过了广泛的测试和评估,以最小化风险并最大化安全性,包括为更高的 AI 安全等级(如 ASL-3)实施相关措施。
我们很期待看到你会创造什么。今天就在 Claude、Claude Code 或你选择的平台上开始使用吧。
一如既往,你的反馈能帮助我们改进。
附录
性能基准数据来源
Open AI:o3 发布文章、o3 系统卡、GPT-4.1 发布文章、GPT-4.1 托管评估
Gemini:Gemini 2.5 Pro Preview 模型卡
Claude:Claude 3.7 Sonnet 发布文章
性能基准报告
Claude Opus 4 和 Sonnet 4 是混合推理模型。本博客文章中报告的基准测试显示了使用或不使用扩展思考时达到的最高分数。我们在下面为每个结果注明了是否使用了扩展思考:
不使用扩展思考:SWE-bench Verified、Terminal-bench
扩展思考(最多 64K tokens):TAU-bench(未报告不使用扩展思考的结果)GPQA Diamond(不使用扩展思考:Opus 4 得分 74.9%,Sonnet 4 为 70.0%)MMMLU(不使用扩展思考:Opus 4 得分 87.4%,Sonnet 4 为 85.4%)MMMU(不使用扩展思考:Opus 4 得分 73.7%,Sonnet 4 为 72.6%)AIME(不使用扩展思考:Opus 4 得分 33.9%,Sonnet 4 为 33.1%)
TAU-bench 方法论
分数是通过在 Airline 和 Retail Agent Policy 中添加提示附录来实现的,该附录指示 Claude 在使用扩展思考和工具使用时更好地利用其推理能力。模型被鼓励在解决多轮轨迹中的问题时写下其想法,这不同于我们通常的思考模式,以最好地利用其推理能力。为了适应 Claude 通过使用更多思考而产生的额外步骤,最大步骤数(按模型完成次数计算)从 30 增加到 100(大多数轨迹在 30 步以下完成,只有一条轨迹达到 50 步以上)。
SWE-bench 方法论
对于 Claude 4 系列模型,我们继续使用相同的简单脚手架,仅为模型配备我们之前发布中描述的两个工具——一个 bash 工具,以及一个通过字符串替换操作的文件编辑工具。我们不再包含 Claude 3.7 Sonnet 使用的第三个“规划工具”。在所有 Claude 4 模型上,我们报告全部 500 个问题的分数。OpenAI 模型的分数是在 477 个问题的子集上报告的。
对于我们的“高计算”数字,我们采用额外的复杂性和并行测试时计算,如下所示:
我们采样多个并行尝试。
我们丢弃破坏仓库中可见回归测试的补丁,类似于 Agentless(Xia et al. 2024)采用的拒绝采样方法;注意不使用隐藏测试信息。
然后我们使用内部评分模型从剩余尝试中选择最佳候选。
这使得 Opus 4 和 Sonnet 4 的得分分别为 79.4% 和 80.2%。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Anthropic Blog
原文作者:Anthropic Blog;如有侵权,请联系管理员删除。

