智能体在跨多个上下文窗口工作时仍面临挑战。我们从人类工程师身上汲取灵感,为长时间运行的智能体构建更有效的运行框架。
随着 AI 智能体能力的提升,开发者越来越多地要求它们承担需要跨越数小时甚至数天的复杂任务。然而,让智能体在多个上下文窗口之间保持一致的进展仍然是一个未解决的问题。
长时间运行智能体的核心挑战在于,它们必须在离散的会话中工作,而每个新会话开始时对之前发生的事情没有任何记忆。想象一个软件项目由轮班工作的工程师组成,每位新到的工程师对上一班次发生的事情毫无记忆。由于上下文窗口有限,且大多数复杂项目无法在单个窗口内完成,智能体需要一种方式来弥合编码会话之间的鸿沟。
我们开发了一个双重解决方案,使 Claude Agent(智能体) SDK(软件开发工具包) 能够在多个上下文窗口中有效工作:一个初始化智能体,在首次运行时搭建环境;以及一个编码智能体,负责在每个会话中取得增量进展,同时为下一个会话留下清晰的产物。你可以在配套的快速入门中找到代码示例。
长时间运行智能体的问题
Claude Agent SDK 是一个强大、通用的智能体运行框架,擅长编码以及需要模型使用工具来收集上下文、规划和执行的其他任务。它具有上下文管理能力,例如压缩(compaction),使智能体能够在处理任务时不耗尽上下文窗口。理论上,在这种设置下,智能体应该能够持续进行有用的工作任意长的时间。
然而,压缩并不足够。开箱即用的情况下,即使是像 Opus 4.5 这样的前沿编码模型,在 Claude Agent SDK 上跨多个上下文窗口循环运行,如果只给定一个高层级的提示词,例如“构建一个 claude.ai 的克隆”,也无法构建出生产质量的 Web 应用。
Claude 的失败表现为两种模式。首先,智能体倾向于一次做太多事情——本质上是试图一次性完成整个应用。这通常导致模型在实现过程中耗尽上下文,使下一个会话开始时某个功能只实现了一半且没有文档记录。智能体随后不得不猜测发生了什么,并花费大量时间试图让基本应用重新运行起来。即使有压缩也会发生这种情况,因为压缩并不总能将完全清晰的指令传递给下一个智能体。
第二种失败模式通常在项目后期出现。在已经构建了一些功能之后,后续的智能体实例会环顾四周,看到已经取得了进展,然后宣布任务完成。
这将问题分解为两个部分。首先,我们需要搭建一个初始环境,为给定提示词所需的所有功能奠定基础,使智能体能够逐步、逐个功能地工作。其次,我们应该提示每个智能体朝着目标取得增量进展,同时在会话结束时将环境保持在干净的状态。所谓“干净的状态”,我们指的是适合合并到主分支的代码:没有重大 bug,代码有序且文档完善,总体而言,开发者可以轻松地开始新功能的开发,而无需先清理不相关的混乱。
在内部实验中,我们使用了一个由两部分组成的解决方案来解决这些问题:
初始化智能体:第一个智能体会话使用专门的提示词,要求模型设置初始环境:一个 init.sh 脚本、一个记录智能体已完成工作的 claude-progress.txt 文件,以及一个显示添加了哪些文件的初始 git 提交。
编码智能体:后续每个会话要求模型进行增量进展,然后留下结构化更新。1
这里的关键洞察是找到一种方法,让智能体在从全新的上下文窗口开始时能够快速理解工作状态,这通过 claude-progress.txt 文件配合 git 历史来实现。这些实践的灵感来源于了解高效软件工程师每天的工作方式。
环境管理
在更新后的 Claude 4 提示指南中,我们分享了一些多上下文窗口工作流的最佳实践,包括一种使用“为第一个上下文窗口使用不同提示词”的框架结构。这个“不同的提示词”要求初始化智能体设置环境,包含未来编码智能体有效工作所需的所有必要上下文。在此,我们深入探讨此类环境的一些关键组成部分。
功能列表
为了解决智能体一次性完成整个应用或过早认为项目完成的问题,我们提示初始化智能体编写一份全面的功能需求文件,扩展用户的初始提示词。在 claude.ai 克隆示例中,这意味着超过 200 个功能,例如“用户可以打开新对话、输入查询、按回车键,然后看到 AI 回复。”这些功能最初都标记为“失败”,以便后续编码智能体能够清楚了解完整功能应该是什么样子。
{
    "category": "functional",
    "description": "New chat button creates a fresh conversation",
    "steps": [
      "Navigate to main interface",
      "Click the 'New Chat' button",
      "Verify a new conversation is created",
      "Check that chat area shows welcome state",
      "Verify conversation appears in sidebar"
    ],
    "passes": false
  }
我们提示编码智能体仅通过更改 passes 字段的状态来编辑此文件,并使用措辞强硬的指令,如“删除或编辑测试是不可接受的,因为这可能导致功能缺失或出现 bug。”经过一些实验,我们最终选择使用 JSON 来实现这一点,因为与 Markdown 文件相比,模型不太可能不适当地更改或覆盖 JSON 文件。
增量进展
有了这个初始环境脚手架,编码智能体的下一次迭代被要求一次只处理一个功能。这种增量方法对于解决智能体倾向于一次做太多事情的问题至关重要。
在增量工作之后,模型在做出代码更改后保持环境处于干净状态仍然至关重要。在我们的实验中,我们发现引发这种行为的最佳方式是要求模型用描述性的提交信息将其进展提交到 git,并在进展文件中写入进展摘要。这允许模型使用 git 来还原错误的代码更改并恢复代码库的工作状态。
这些方法还提高了效率,因为它们消除了智能体需要猜测发生了什么并花费时间试图让基本应用重新运行的需要。
测试
我们观察到的最后一个主要失败模式是 Claude 倾向于在没有适当测试的情况下将功能标记为完成。在没有明确提示的情况下,Claude 倾向于进行代码更改,甚至使用单元测试或针对开发服务器的 curl 命令进行测试,但无法识别该功能并未端到端正常工作。
在构建 Web 应用的情况下,一旦明确提示使用浏览器自动化工具并像人类用户一样进行所有测试,Claude 在端到端验证功能方面大多表现良好。
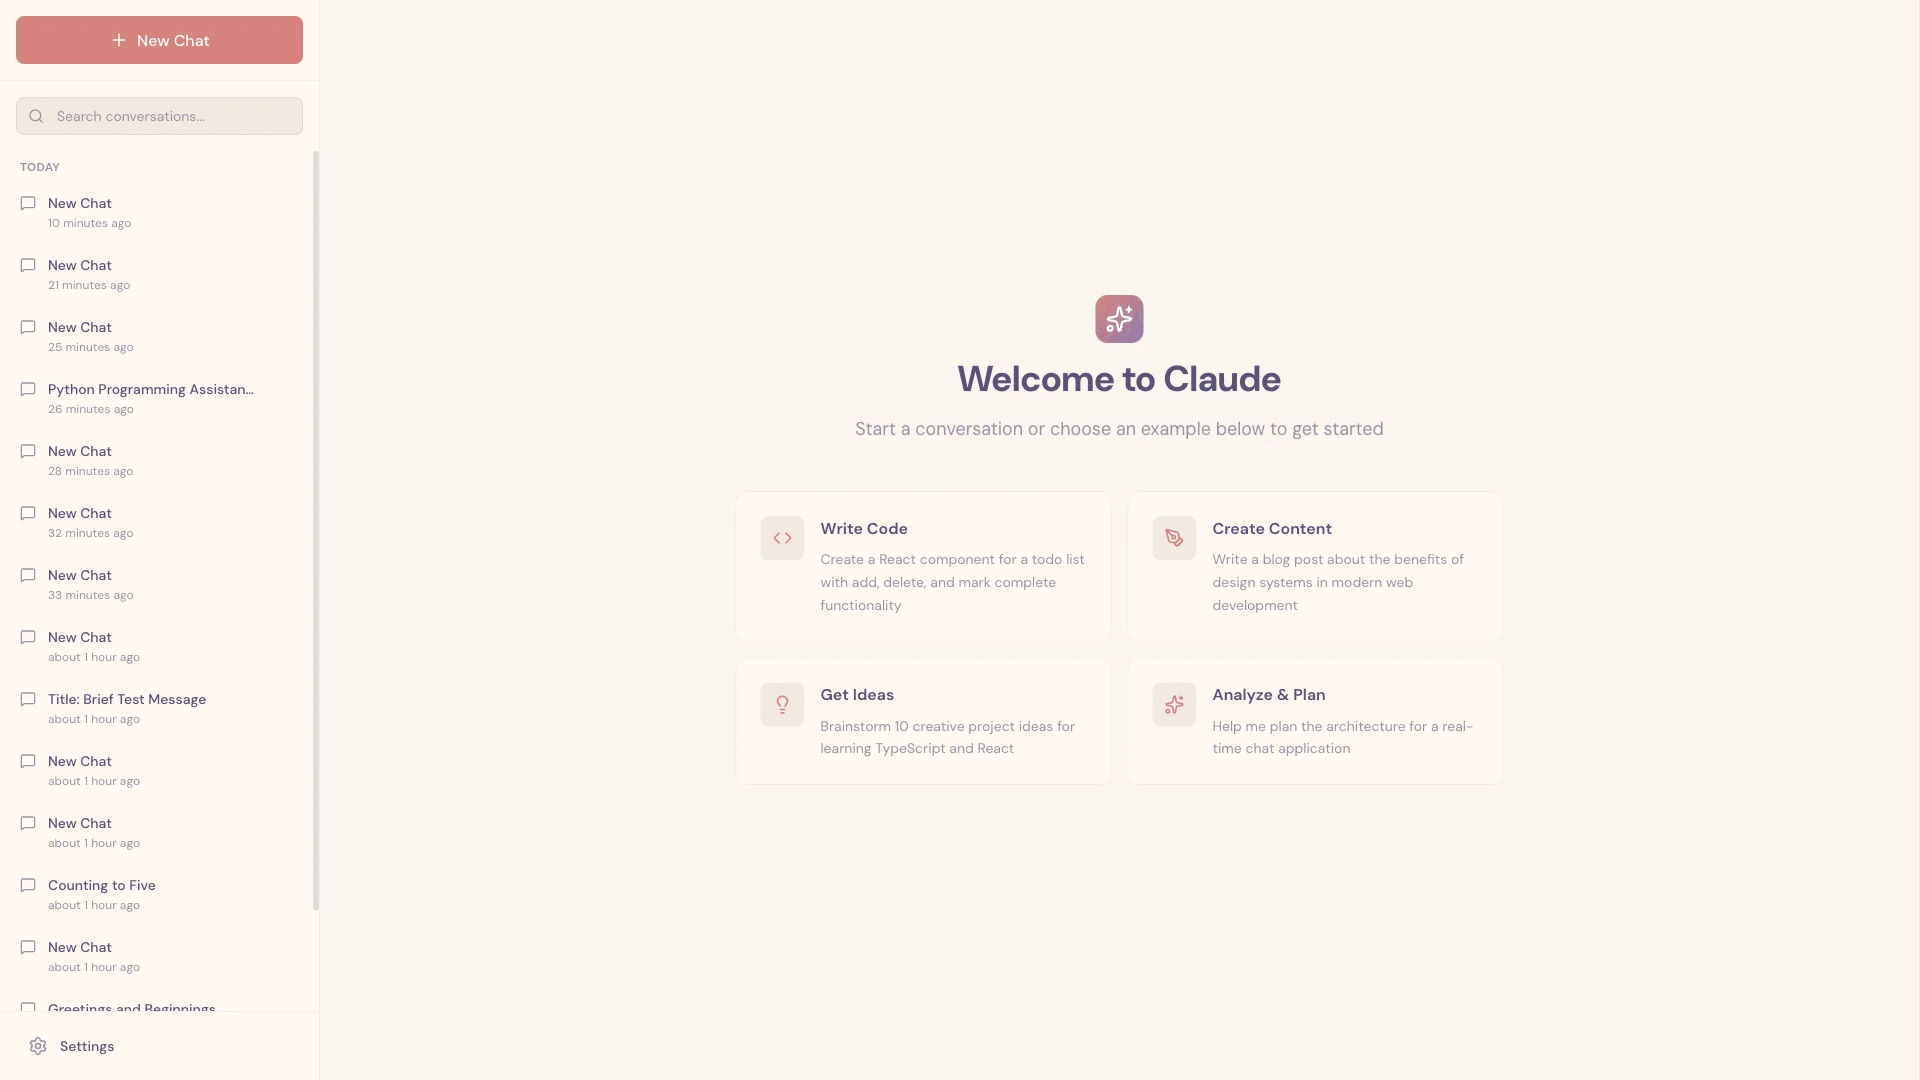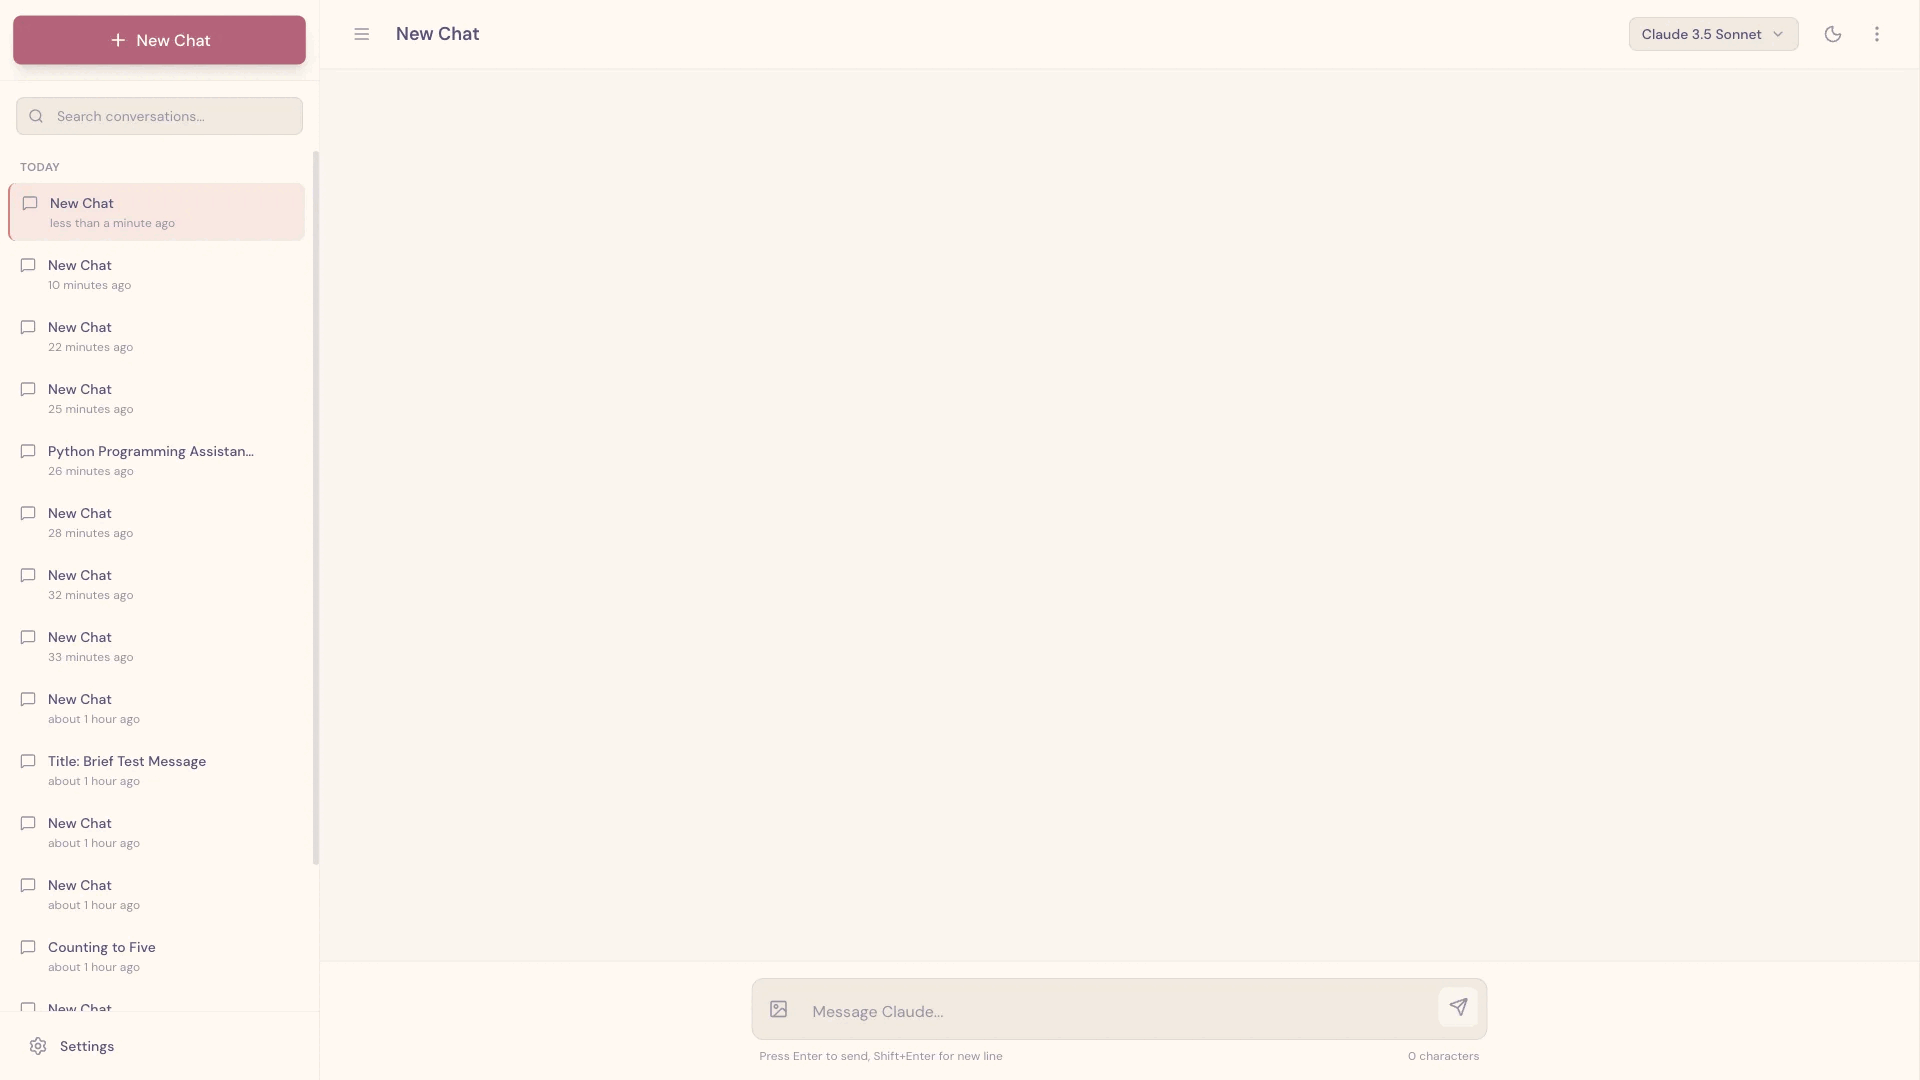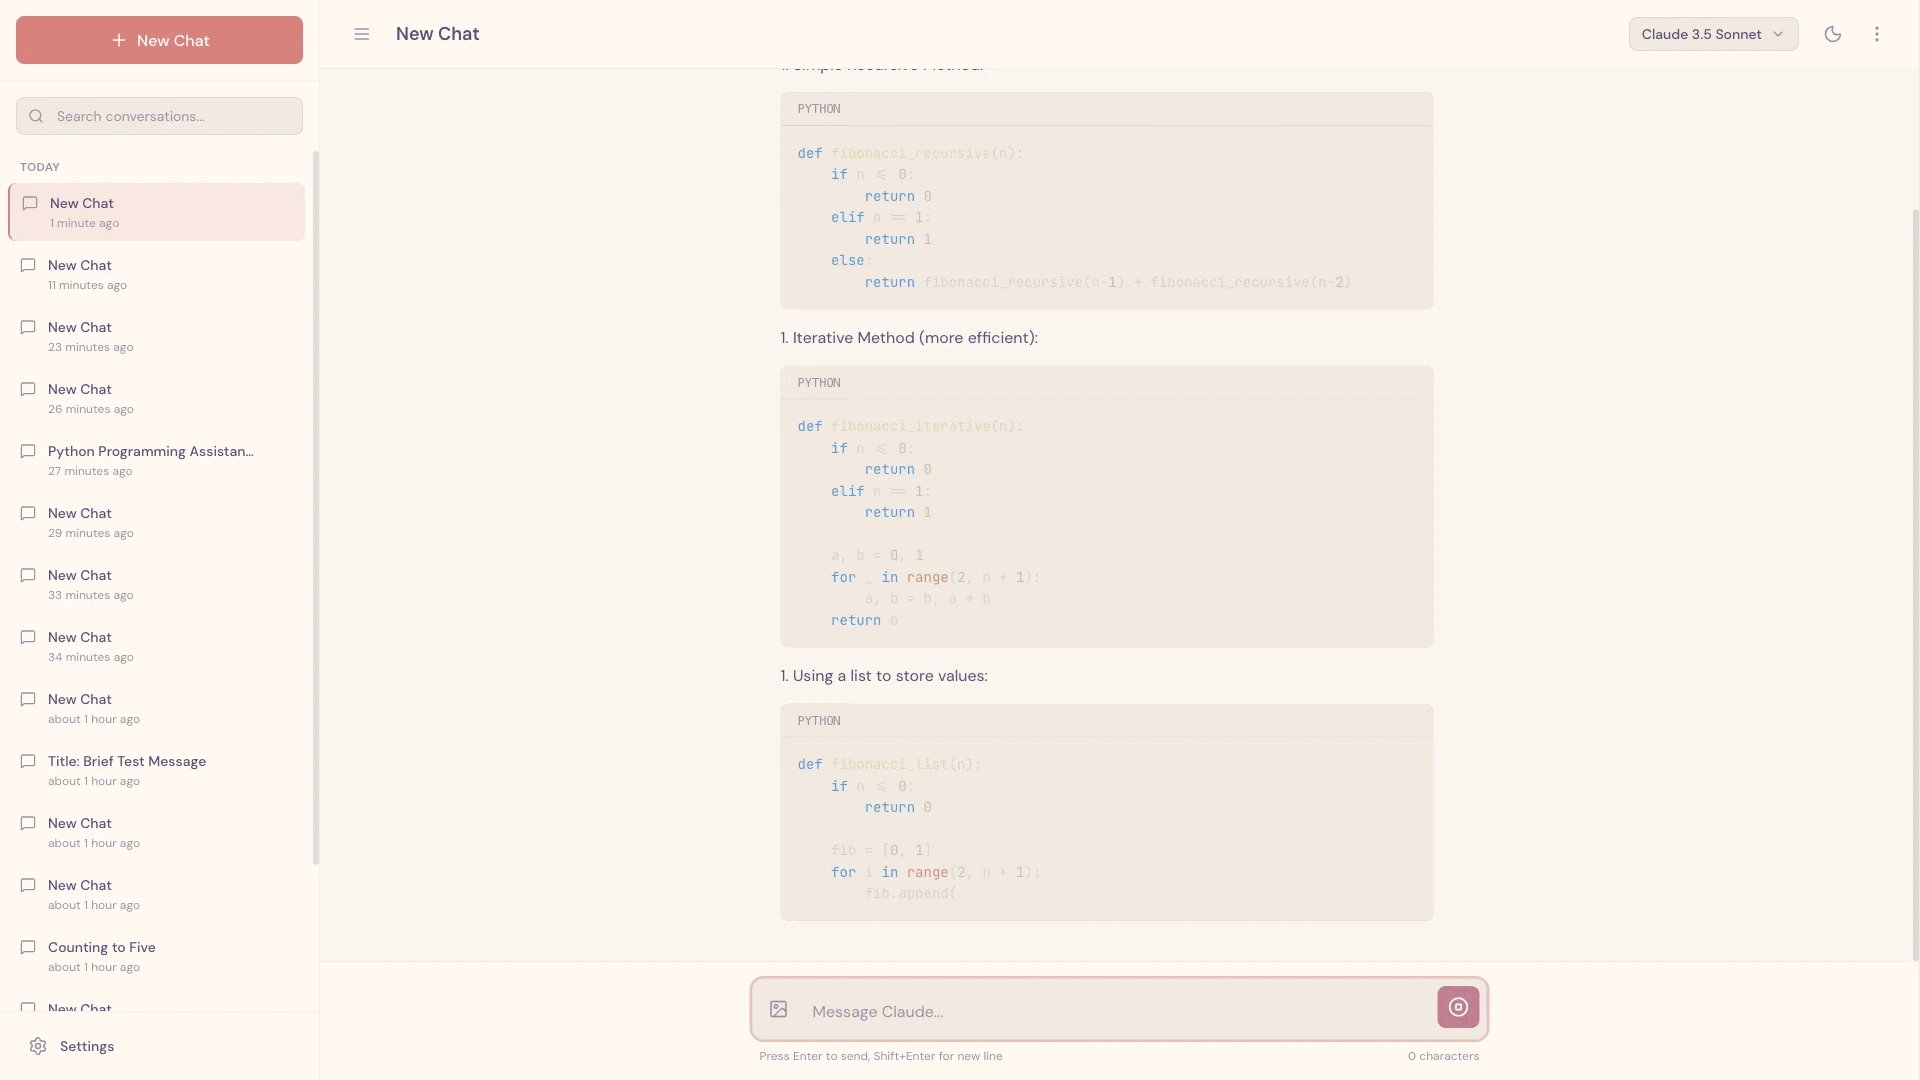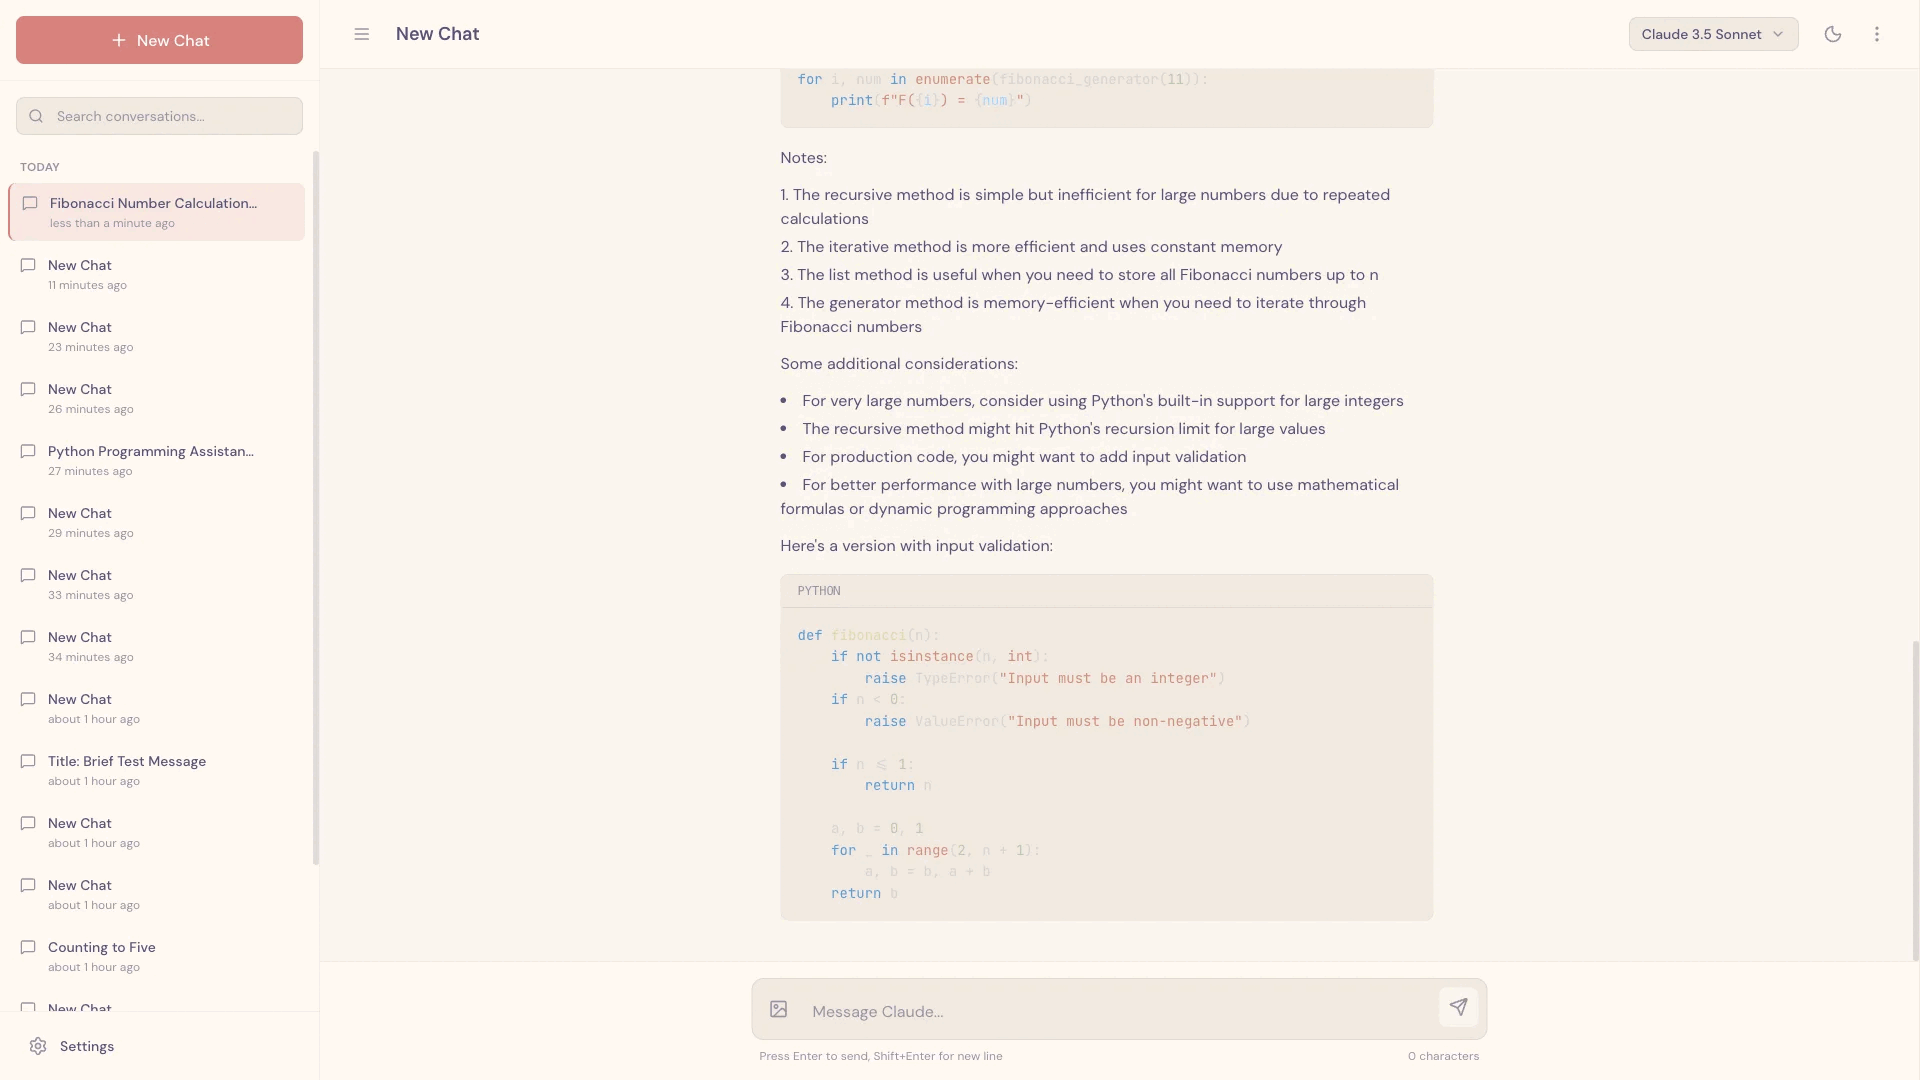
为 Claude 提供这类测试工具显著提升了性能,因为智能体能够识别并修复仅从代码中不明显的错误。
一些问题仍然存在,例如 Claude 的视觉能力和浏览器自动化工具的限制使得难以识别每一种错误。例如,Claude 无法通过 Puppeteer MCP 看到浏览器原生的警告模态框,依赖这些模态框的功能因此往往更容易出现错误。
快速上手
有了上述所有设置,每个编码智能体都会被提示执行一系列步骤来了解情况,其中一些相当基础但仍然有帮助:
运行 pwd 查看你正在工作的目录。你只能编辑此目录中的文件。
阅读 git 日志和进度文件,了解最近的工作内容。
阅读功能列表文件,选择尚未完成的最高优先级功能来处理。
这种方法在每个会话中为 Claude 节省了一些 token,因为它不必弄清楚如何测试代码。它还有助于要求初始化智能体编写一个 init.sh 脚本,该脚本可以运行开发服务器,然后在实现新功能之前运行基本的端到端测试。
在 claude.ai 克隆的情况下,这意味着智能体总是启动本地开发服务器,并使用 Puppeteer MCP 启动新聊天、发送消息并接收响应。这确保了 Claude 能够快速识别应用是否处于损坏状态,并立即修复任何现有错误。如果智能体转而开始实现新功能,很可能会使问题变得更糟。
鉴于以上所有内容,一个典型的会话以以下助手消息开始:
[Assistant] I'll start by getting my bearings and understanding the current state of the project.
[Tool Use][Tool Use][Tool Use][Assistant] Let me check the git log to see recent work.
[Tool Use][Assistant] Now let me check if there's an init.sh script to restart the servers.[Assistant] Excellent! Now let me navigate to the application and verify that some fundamental features are still working.[Assistant] Based on my verification testing, I can see that the fundamental functionality is working well. The core chat features, theme switching, conversation loading, and error handling are all functioning correctly. Now let me review the tests.json file more comprehensively to understand what needs to be implemented next.
智能体失败模式与解决方案
| 问题 | 初始化智能体行为 | 编码智能体行为 |
| --- | --- | --- |
| Claude 过早宣布整个项目胜利。 | 设置功能列表文件:根据输入规范,设置一个结构化的 JSON 文件,包含端到端功能描述列表。 | 在会话开始时阅读功能列表文件。选择单个功能开始处理。 |
| Claude 使环境处于存在错误或未记录进度的状态。 | 写入初始 git 仓库和进度笔记文件。 | 通过阅读进度笔记文件和 git 提交日志开始会话,并在开发服务器上运行基本测试以捕获任何未记录的错误。通过写入 git 提交和进度更新结束会话。 |
| Claude 过早将功能标记为完成。 | 设置功能列表文件。 | 自我验证所有功能。只有在仔细测试后才将功能标记为“通过”。 |
| Claude 必须花时间弄清楚如何运行应用。 | 编写一个可以运行开发服务器的 init.sh 脚本。 | 通过阅读 init.sh 开始会话。 |
未来工作
这项研究展示了一组长时运行智能体框架中可能的解决方案,使模型能够在多个上下文窗口中逐步推进。然而,仍有一些开放性问题。
最值得注意的是,目前尚不清楚是单个通用编码智能体在不同场景下表现最佳,还是通过多智能体架构可以获得更好的性能。像测试智能体、质量保证智能体或代码清理智能体这样的专用智能体,似乎有可能在软件开发生命周期的各个子任务中表现得更好。
此外,这个演示是针对全栈 Web 应用开发优化的。未来的一个方向是将这些发现推广到其他领域。这些经验中的部分或全部很可能可以应用于其他类型的长时运行智能体任务,例如科学研究或金融建模。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Anthropic Blog
原创地址:https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
原文作者:Anthropic Blog;如有侵权,请联系管理员删除。

