本周早些时候,我们通过升级 Gemini 2.5 Pro 和 Flash 文本转语音模型,引入了对音频生成更强的控制能力。
但生成富有表现力的语音只是对话的一方面。今天,我们发布了面向实时语音智能体的更新版 Gemini 2.5 Flash Native Audio。此次更新提升了模型处理复杂工作流、遵循用户指令以及进行自然对话的能力。
Gemini 2.5 Flash Native Audio 现已在 Google 产品中上线,包括 Google AI Studio、Vertex AI,并已开始在 Gemini Live 和 Search Live 中逐步推出,首次将原生音频的自然感带入 Search Live。这意味着您可以更高效地与 Gemini 实时头脑风暴、在 Search Live 中获取实时帮助,或构建下一代企业级客户服务智能体。
除了为实用智能体提供支持外,原生音频还为全球沟通解锁了新的可能性。我们推出了实时语音翻译功能,该功能可为耳机提供流式语音到语音翻译。它保留了说话者的语调、节奏和音高。这一测试版体验从今天起在 Google Translate 应用中逐步推出。
实时语音智能体
为了支持跨界面和产品的广泛用例,我们在三个关键领域改进了 Gemini 2.5 Native Audio:
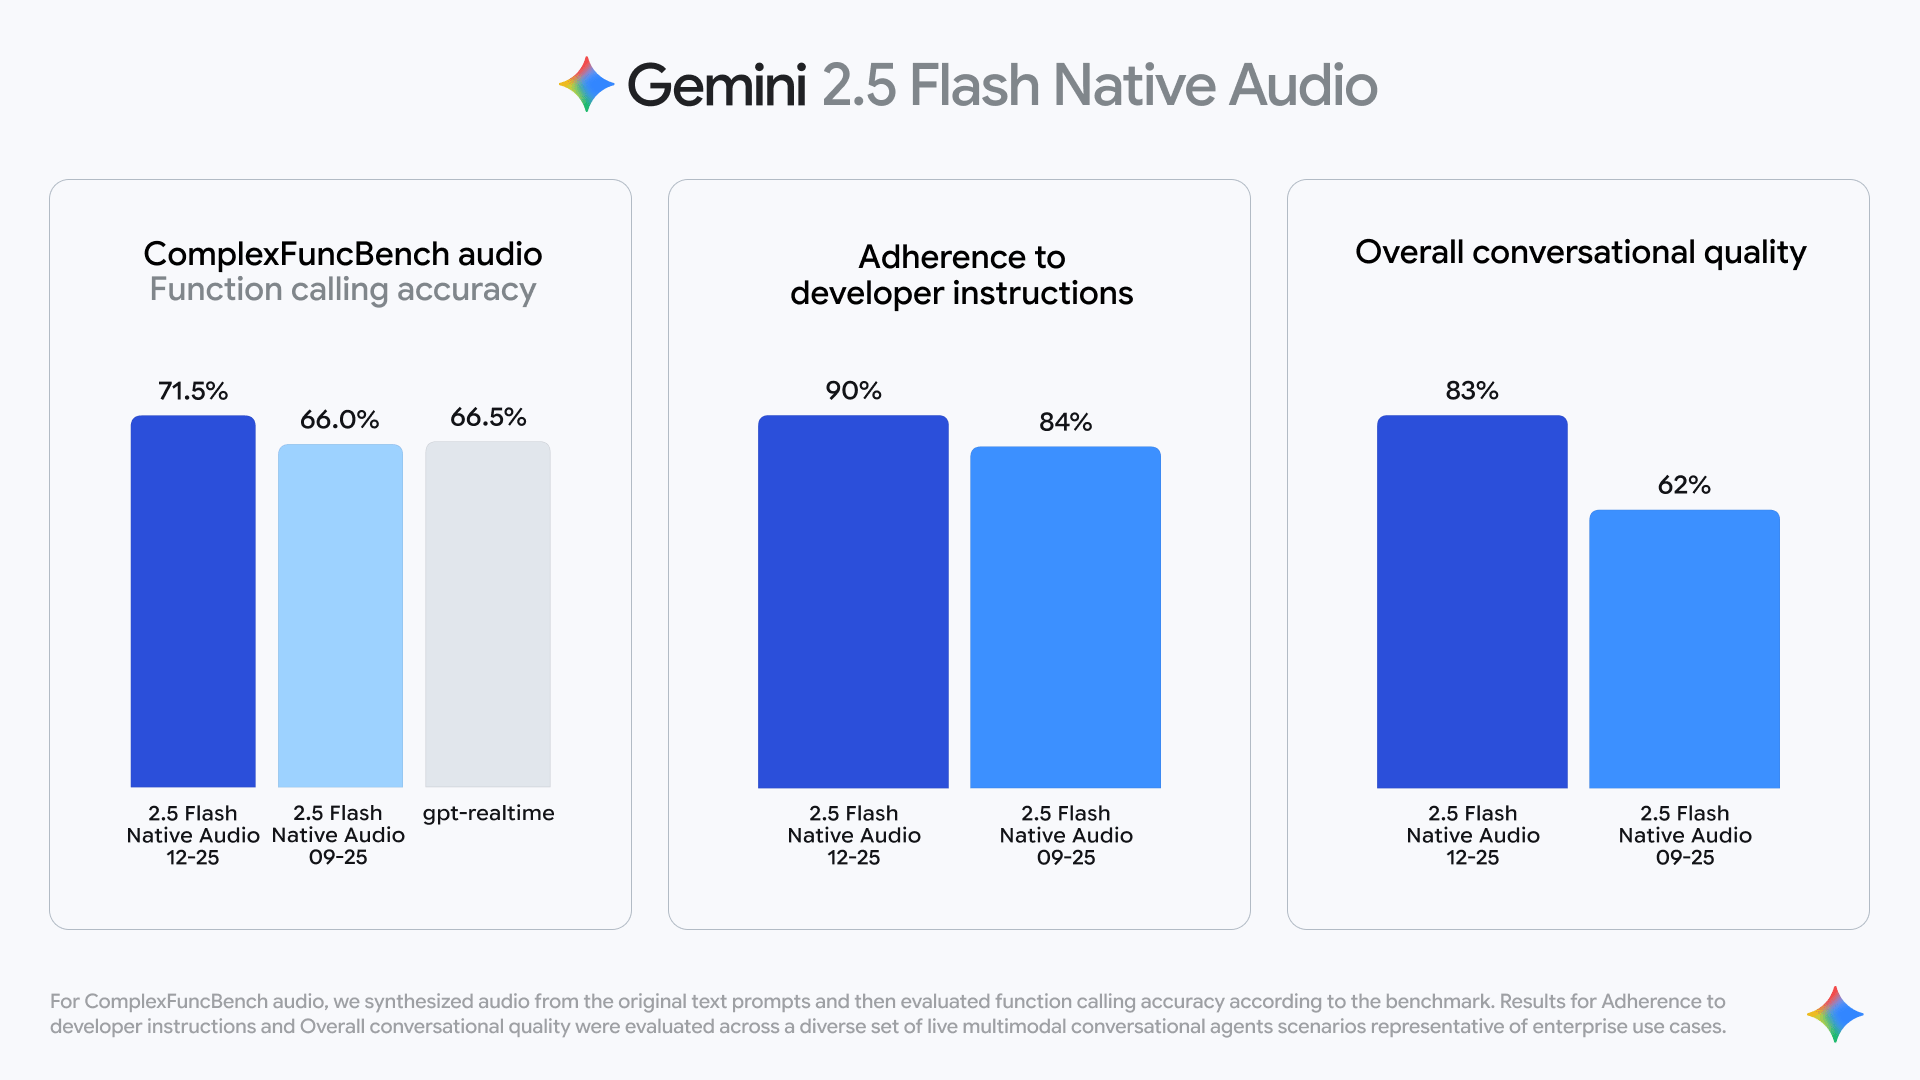
更精准的函数调用:我们提升了模型在触发外部函数时的可靠性。它现在能更准确地识别对话中何时需要获取实时信息,并将这些数据无缝融入音频回复中,而不打断对话流程。在 ComplexFuncBench Audio 这一评估多步骤函数调用及各种约束条件的基准测试中,Gemini 2.5 Native Audio 以 71.5% 的得分领先。
更强的指令遵循能力:模型现在能更好地处理复杂指令,从而在内容完整性方面获得更高的用户满意度。对开发者指令的遵循率达到 90%(此前为 84%),输出更加可靠。
更流畅的对话:我们在多轮对话质量方面取得了显著提升。Gemini 2.5 Flash Native Audio 能够更有效地从之前的轮次中检索上下文,从而创造更连贯的对话体验。
更新版 Gemini 2.5 Flash Native Audio 在 ComplexFuncBench 上与先前版本及行业竞品的性能对比
客户评价
Google Cloud 客户已经在使用 Gemini 的原生音频能力来推动实际业务成果,从抵押贷款处理到客户通话。
“用户在使用 Sidekick 一分钟内往往就会忘记自己在和 AI 对话,有些人在长时间聊天后还会向这个机器人道谢……通过 Gemini [2.5 Flash Native Audio] 提供的新 Live API(应用程序编程接口) AI 能力,让我们的商家能够赢得优势。”——David Wurtz,Shopify 产品副总裁
“通过集成 Gemini 2.5 Flash Native Audio 模型……自 2025 年 5 月上线以来,我们显著增强了 Mia 的能力。这一强大的组合使我们能够为经纪合作伙伴生成超过 14,000 笔贷款。”——Jason Bressler,United Wholesale Mortgage(UWM)首席技术官
“通过 Vertex AI 使用 Gemini 2.5 Flash Native Audio 模型,使 Newo.ai AI Receptionists 能够实现无与伦比的对话智能……即使在嘈杂环境中,它们也能识别主要说话人,在对话中途切换语言,并且听起来非常自然且富有情感表现力。”——David Yang,Newo.ai 联合创始人
实时语音翻译
Gemini 现在原生支持新的实时语音到语音翻译能力,旨在处理持续聆听和双向对话。
在持续聆听模式下,Gemini 会自动将多种语言的语音翻译成单一目标语言。这让你戴上耳机后,就能用自己的语言听到周围世界的内容。
对于双向对话,Gemini 的实时语音翻译会实时处理两种语言之间的翻译,并根据说话者自动切换输出语言。例如,如果你说英语,并想与一位说印地语的人聊天,你会在耳机中实时听到英语翻译,而当你说完后,你的手机会播放印地语。
Gemini 的实时语音翻译具有多项关键能力,可在现实世界中提供帮助:
语言覆盖:通过将 Gemini 模型的世界知识和多语言能力与其原生音频能力相结合,可翻译超过 70 种语言和 2000 种语言对的语音
风格迁移:捕捉人类语音的细微差别,保留说话者的语调、节奏和音高,使翻译听起来自然。
多语言输入:可在单次会话中同时理解多种语言,帮助你跟上多语言对话,而无需反复调整语言设置。
自动检测:识别所说语言并开始翻译,因此你甚至不需要知道对方在说什么语言就能开始翻译。
噪声鲁棒性:过滤环境噪声,因此即使在嘈杂的户外环境中,你也可以舒适地交谈。
从今天开始,你可以在 Google Translate 应用中的全新 beta 体验里试用它:将耳机连接到设备并点击“Live translate”,即可在耳机中体验实时翻译。该体验正在向美国、墨西哥和印度的所有 Android 设备推出,iOS 和更多地区的支持即将到来。
根据反馈,我们将继续迭代这一体验,并在 2026 年将其带到更多 Google 产品中,包括 Gemini API。
立即开始
今天就开始使用 Gemini 2.5 Flash Native Audio 构建语音智能体,它现已在 Vertex AI 上正式可用,并在 Gemini API 中提供预览版。你可以在 Google AI Studio 中试用。
Gemini 2.5 Flash 和 2.5 Pro 文本转语音模型也可通过 Google AI Studio 中的 Gemini API 使用。请参阅语音生成文档开始使用,探索提示指南,或查看 Gemini API Cookbook 以快速上手。
转载声明:本文为转载整理,原文版权归原作者及原站点所有。
原文来源:Google DeepMind Blog
原创地址:https://deepmind.google/blog/improved-gemini-audio-models-for-powerful-voice-experiences/
原文作者:Bibo Xu;如有侵权,请联系管理员删除。

