目录:
前言
一、数据仓库与数据库
1、数据仓库
2、数据库
3、数据仓库与数据库的区别与关系
二、openGauss数据库产品特点
1、openGauss简介
2、openGauss的优点
3、openGauss常见SQL语法介绍
4、小结
三、全量表,增量表,拉链表,流水表,快照表基本概念及部分实现
1、全量表
2、增量表
3、拉链表
4、流水表
5、快照表
6、全量表、增量表、拉链表及快照表的使用建议
7、小结
前言
当人们一提到全量表,增量表,拉链表,流水表,快照表等这些概念时,大家第一反应想到的就是传统数据仓库的使用。 那么本文将从数据仓库介入,简单介绍一下 openGauss设计中的全量表,增量表,拉链表,流水表,快照表等。
主要内容:
一、认识数据仓库和数据库
二、了解openGauss 的有哪些优势和特点,以及其常见SQL 语法
三、认识全量表,增量表,拉链表,流水表,快照表的概念、特点以及其在openGauss中的实验经验总结。
一 、数据仓库与数据库
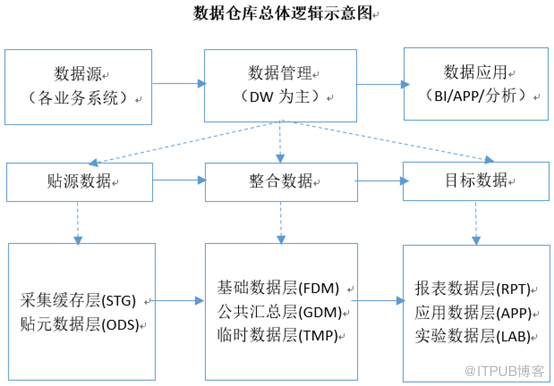
1、数据仓库 ,英文名称为Data Warehouse,可简写为DW或DWH。数据仓库,是为企业所有级别的决策制定过程,提供所有类型数据支持的战略集合。它是单个数据存储,出于分析性报告和决策支持目的而创建。 为需要业务智能的企业,提供指导业务流程改进、监视时间、成本、质量以及控制等。
数据仓库特点:
l 数据仓库是面向主题的:主题是企业较高层次上的信息系统中的数据综合、归类,并进行分析的对象。在逻辑意义上,他是对企业中某一个宏观分析领域所涉及的分析对象。(以银行金融行业为例,可有如:当事人、当事人资产、区域、行销活动、协议、事件、机构、产品、财务、渠道等)
l 数据仓库是集成整合的:数据仓库的数据是从各个分散的数据库(含各种可以存储数据的介质)中进行抽取整合而来(ETL)。
l 数据仓库的数据是随着时间的变化而变化的:数据仓库在整个运行过程中,其数据有新增的、有历史归档的。
l 数据仓库的数据是不可修改的:数据仓库的数据主要提供企业决策分析之用,所涉及的数据操作主要是数据查询分析,一般情况下并不进行修改操作。
2、数据库
数据库(Database) 是一种逻辑概念 ,主要是存放大量数据的“仓库”,是数据的集合, 通过数据库软件来实现。数据库由很多数据表、记录、字段、索引等多种元素组成 。存放在其中的数据具有“永久存储、有组织、可共享”等特点。
3、数据仓库与数据库的区别与关系
数据库主要用于事务处理,数据仓库主要用于数据分析。用途上的不同决定了这两种架构的特点不同。 在IT的架构体系中,数据库是必须存在的,数据必须要有地方存储。
数据库与数据仓库的区别实际讲的是OLTP与OLAP的区别
OLTP是传统的关系型数据库的主要应用,主要是基本的、日常的事务处理。从数据角度主要以“增删改”为主,同时关注的是事务的吞吐量(TPS),数据库在设计原则上要符合3NF/BCNF,例如银行交易系统、零售系统、火车售票系统等。
OLAP是数据仓库的核心部心, 数据仓库是对于大量已经由OLTP形成的数据的一种分析型的数据库,用于处理商业智能、决策支持等重要的决策信息。从数据库角度主要是以“查询”为主,关注的是其查询响应速度(QPS),数据库设计主要以星型/雪花模型为主。例如报表系统、CRM系统、金融风险预测预警系统、反洗钱系统、数据仓库、数据集市等。
二、openGuass数据库产品特点
1、openGauss简介
openGauss 是一款全面友好开放,携手伙伴共同打造的 企业级开源关系型数据库。
openGauss 是一个数据库管理系统。数据库是结构化的数据集合。它可以是任何数据,购物清单、图片库或公司网络中的大量信息。数据库管理系统可以对数据库进行统一的管理和控制,以保证数据库的安全性和完整性。由于计算机非常擅长处理大量数据,因此数据库管理系统可以作为独立程序使用,也可以作为其他应用程序的一部分在计算中发挥着核心作用。
openGauss 数据库是关系型的。关系型数据库是指采用了关系模型来组织数据的数据库,其以行和列的形式存储数据。行和列被称为表,一组表组成了数据库。关系模型可以简单理解为二维表格模型,而一个关系型数据库就是由二维表及其之间的关系组成的一个数据组织。
openGauss的SQL部分代表 “结构化查询语言”。SQL是最常用的用于访问和处理数据库的标准计算机语言。根据您的编程环境,您可以直接输入SQL、将SQL语句嵌入到以另一种语言编写的代码中,或者使用包含SQL语法的特定语言 API。openGauss支持标准的SQL92/SQL99/SQL2003/SQL2011规范。
2、openGauss的优点
openGauss 数据库具有高性能、高可用、高安全、易运维、全开放的优点 :
高性能
1) 提供了面向多核架构的并发控制技术结合鲲鹏硬件优化,在两路鲲鹏下TPCC Benchmark达成性能150万tpmc。
2) 针对当前硬件多核numa的架构趋势, 在内核关键结构上采用了NumaAware的数据结构。
3) 提供Sql-bypass智能快速引擎技术。
高可用
1) 支持主备同步,异步以及级联备机多种部署模式。
2) 数据页CRC校验,损坏数据页通过备机自动修复。
3) 备机并行恢复,10秒内可升主提供服务。
高安全
1) 支持全密态计算,访问控制、加密认证、数据库审计、动态数据脱敏等安全特 性,提供全方位端到端的数据安全保护。
易运维
2) 基于AI的智能参数调优和索引推荐,提供AI自动参数推荐。
3) 慢SQL诊断,多维性能自监控视图,实施掌控系统的性能表现。
4) 提供在线自学习的SQL时间预测。
全开放
1) 采用木兰宽松许可证协议,允许对代码自由修改,使用,引用。
2) 数据库内核能力全开放。
3) 提供丰富的伙伴认证,培训体系和高校课程。
4) openGauss 相比其他开源数据库主要有多存储模式,NUMA化内核结构和高可用等产品特点。
3、 openGauss 常见相关 SQL 语法介绍
创建表
CREATE [ [ GLOBAL | LOCAL ] [ TEMPORARY | TEMP ] | UNLOGGED ] TABLE [ IF NOT EXISTS ] table_name
    ({ column_name data_type [ compress_mode ] [ COLLATE collation ] [ column_constraint [ ... ] ]
        | table_constraint
        | LIKE source_table [ like_option [...] ] }
        [, ... ])
    [ AUTO_INCREMENT [ = ] value ]
    [ WITH ( {storage_parameter = value} [, ... ] ) ]
    [ ON COMMIT { PRESERVE ROWS | DELETE ROWS | DROP } ]
    [ COMPRESS | NOCOMPRESS ]
    [ TABLESPACE tablespace_name ]
[ COMMENT {=| } 'text' ];
注意:
1 )列存表的表级约束只支持PARTIAL CLUSTER KEY ,不支持主外键等表级约束。
2 )列存表的字段约束只支持NULL 、NOT NULL 和DEFAULT 常量值。
创建临时表(示例)
CREATE TEMPORARY TABLE bank_card
(
b_number NCHAR(30) PRIMARY KEY
, b_type NCHAR(20)
,b_c_id INT NOT NULL
);
创建分区表
CREATE TABLE [ IF NOT EXISTS ] partition_table_name
( [
   { column_name data_type [ COLLATE collation ] [ column_constraint [ ... ] ]
   | table_constraint
   | LIKE source_table [ like_option [...] ] } [, ... ]
] )
   [ WITH ( {storage_parameter = value} [, ... ] ) ]
   [ COMPRESS | NOCOMPRESS ]
   [ TABLESPACE tablespace_name ]
   PARTITION BY {
      {RANGE (partition_key) [ INTERVAL ('interval_expr') [ STORE IN (tablespace_name [, ... ] ) ] ]
( partition_less_than_item [, ... ] )} |
      {RANGE (partition_key) [ INTERVAL ('interval_expr') [ STORE IN (tablespace_name [, ... ] ) ] ]
( partition_start_end_item [, ... ] )} |
      {LIST | HASH (partition_key)(PARTITION partition_name [VALUES (list_values_clause)] opt_table_space )}
   } [ { ENABLE | DISABLE } ROW MOVEMENT ];
示例:
create table partition_table
(
u_id varchar(10)
,money varchar(10)
,start_dt  varchar(10)
,end_dt varchar(10)
)
partition by RANGE (end_dt)
(PARTITION P1 VALUES LESS THAN('20221012'),
PARTITION P2 VALUES LESS THAN(MAXVALUE)
);
常用字段类型
INTEGER 、DECIMAL 、FLOAT 、CHAR(n) 、VARCHAR(n) 、DATE 、SMALLDATETIME 、TIME 、TIMESTAMP
逻辑操作符 ,常用的逻辑操作符有AND 、OR 和NOT ,他们的运算结果有三个值,分别为TRUE 、FALSE 和NULL ,其中NULL 代表未 知。他们运算优先级顺序为:NOT>AND>OR 。
表关联
内连接(inner join ) ,内连接的关键字为inner join ,其中inner 可以省略。使用内连接,连接执行顺序必然遵 循语句中所写的表的顺序。
左外连接 (LEFT JOIN ) , 又称左连接,是指以左边的表为基础表进行查询。 根据指定连接条件关联右表,获取基础表以及和条件匹 配的右表数据,未匹配条件的右表对应的字段位置填上 NULL 。
右外连接(RIGHT JOIN ) , 又称右连接,是指以右边的表为基础表,在内连接的基础 上也查询右边表中有记录,而左边的表中没有记录的数据 (左边用NULL 值填充)。
全外连接(FULL JOIN ), 又称全连接,是指除了返回两个表中满足连接条件的 记录,还会返回两个表中不满足连接条件的所有其它 行(不匹配的另外一边用NULL 值填充)。
4、小结
数据仓库表的设计与实现,其都离不开最基本的SQL 操作,以openGauss 数据库为例,涉及如上(临时表的创建使用、分区表的创建使用、常用数据类型、表关联、逻辑操作等等)。
三、全量表,增量表,拉链表,流水表,快照表基本概念及部分实现
1、全量表 ,顾名思义是存储了全部数据的表,全量表存储的是截至到目前最新状态的全部记录,记录更新周期内的全量数据,无论数据是否有变化都需要记录。
每天所有的最新状态的数据:
1)存储的是截至到目前最新状态的全部记录,有无变化,都要上报
2)每次上报的数据都是所有的数据(变化的 + 没有变化的)
3)没有分区,所有数据存储在一个分区中,比如:今天是11号,那么全量表里面包含的数据是截至10号的所有数据, 每次往全量表里面写数据都会覆盖之前的数据,所以全量表不记录历史的数据情况,只有截止到当前最新的、全量的数据。
全量表范例 :
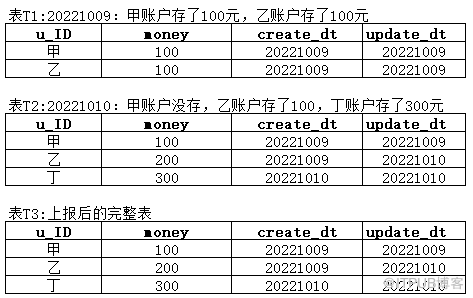
SQL 实现(openGauss)逻辑: 假设T1是初始化的原表,T2是第二天跑批过来的最新状态的全量表,即全删全插。
Truncate table T1;
Insert into T1 select * from T2;

--得到最新状态的全量数据(T3)
SELECT * FROM T1;
2、增量表
增量表, 记录更新周期内的新增数据,即在原表中数据的基础上新增本周期内产生的新数据,没变化的数据不会被记录;
增量表的特征:
1)增量表是相对于全量表而言的,增量表是每次把新增的数据追加到原表中;
2)记录每次增加的量,而不是总量(只报变化量,无变化不用报);
3)存在分区,增量表中每次新增的数据单独存储在一个分区中,历史分区中的数据记录不发生变化。
增量表范例:
增量表,就是记录每天新增数据的表。比如:从9号到10号新增了哪些数据,改变了哪些数据,这些都会存储在增量表在10号的分区里面(下表中的create_dt 可作为分区字段)。
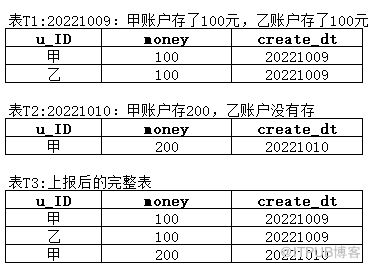
SQL 实现(openGauss)逻辑: 假设T1是初始化的原表,T2是第二天跑批过来的新增数据,即直接累加即可。
Insert into T1 SELECT * FROM  T2;

--得到T3
SELECT * FROM T1;

--可根据分区字段获取对应增量数据
SELECT * FROM T1 WHERE create_dt=‘20221010’;
3、拉链表
拉链表储存了某个主体的一整套连续动作的信息。与快照表类似,但拉链表储存的是在快照表的基础上去除了重复状态的数据。他是一种维护历史状态,以及最新状态数据的一种表,记录数据从开始一直到当前状态所有变化的信息。
拉链表的特征:
1)记录一个事物从开始,一直到当前状态的所有变化的信息;
2)每次上报的都是历史记录的最终状态,是记录在当前时刻的历史总量;
3)当前记录存的是当前时间之前的所有历史记录的最后变化量(总量);
4)存量一般设计成拉链表(月报 - 常用、日报);
5)关链时间可以是3000年,9999年等比较大的年份;
拉链表的适用场景:
当数据量较大,表中某些字段有变化,但变化频率不是很高,而业务需求又需要统计这种变化状态,如果每天存储一份全量数据,不仅浪费存储空间,且不便于业务统计;这时,拉链表的作用就体现出来了,既节省空间,又满足需求。
在数据仓库的数据模型设计过程中,经常会遇到这样的需求:
1)数据量比较大;
2)表中的部分字段会被update,例如:用户的地址、产品的描述信息、订单的状态等等;
3)业务需要:a.查看某一个时间点或者时间段的历史快照信息,比如:查看某一个订单在历史某一个时间点的状态;b.统计订单信息的变化频次,比如:查看某一个用户在过去某一段时间内,更新过几次等等;
4)信息变化的比例和频率不是很大。
此时,如果对张表每天都保留一份全量,那么每次全量中会保存很多不变的信息,这对存储是极大的浪费;拉链表,既能满足反应数据的历史状态,又能最大程度地节省存储空间。
拉链表的优缺点:
优点:保留了数据的历史信息;节省存储空间;
缺点:同步和回滚逻辑复杂;
拉链表范例:
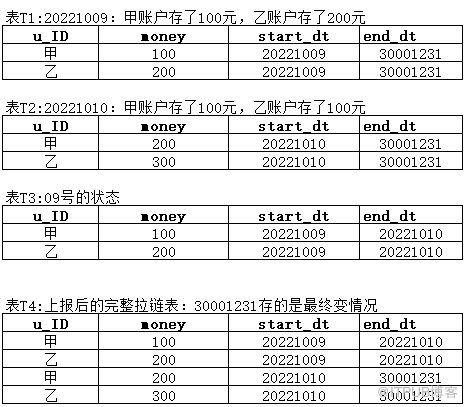
SQL 实现(openGauss)逻辑:
通过主键关联(历史数据和新增数据关联):
1、关联上的,比对非主键字段:
1)如果非主键字段值完全一致,则只更新比对上的历史数据的结束日期为当前日期(关链);
2)如果非主键字段值存在任意一个字段不一致,则更新比对上的历史数据的结束日期为当期日期(关链),然后将新数据insert,其开始日期取当前日期,结束日期set end_dt=‘30001231’(开链);
2、未关联上的:
1)如果供数是全量给,则历史数据全部关联,如果供数是增量给,则历史数据不更新。
2)新增数据直接insert into开链(其开始日期去当前日期,结束日期set end_dt=‘30001231’)。
4、流水表
流水表, 对于表的每一个修改都会记录,可以用于反映实际记录的变更。
流水表的特征:
1)流水表是存储了所有修改记录的表。
2)流水表是每天的交易形成的历史;
区别于拉链表:
流水表与拉链表也有些类似,拉链表通常是对账户信息的历史变动进行处理保留的结果,流水表是每天的交易形成的历史;流水表用于统计业务相关情况,拉链表用于统计账户及客户的情况。
5、快照表
快照表就是截至过去某个时间点的所有数据,关注更多的是过去某个时间点的状态,即:快照表 主要存储的是历史状态的表。每次快照的数据单独储存在一个分区中。
快照表的场景:
快照表用来存储截止过去某个时间点的所有数据,比如:一些用户特征的表、标签表、订单状态表等多存储于快照表中,其实快照表也有所区分,本质是一段时间内数据的记录。
为解决全量表无法查询历史数据的情况,引入了快照表。快照表是有时间分区的,每个分区里的数据都是分区时间对应的前一天的所有全量数据,比如:当前数据表有3个分区,8号、9号、10号。其中,8号分区里面的数据就是从历史到7号的所有数据,9号分区里面的数据就是从历史到8号的所有数据,以此类推。
快照表的特征:
按照时间分区进行数据存储;
快照表的优缺点:
优点:可实现对历史数据的查询;
缺点:数据量大时,由于每个分区都存储了许多重复数据,非常浪费存储空间。
6、全量表、增量表、拉链表及快照表的使用建议
1)总体而言,在数据量不是很大的情况下是可以优先考虑使用全量表进行数据存储,该方法简单,但会很耗资源。
2)一般,建议使用增量表进行存储,毕竟目前大多数公司的数据量都很大,且数据量都在不断增长。
3)当遇到历史状态需要保存的时候就需要使用快照表和拉链表了。
7、小结
全量表、增量表、拉链表、流水表以及快照表都是相对于传统数据仓库(或者数据集市)而言的, 但其一定是基于数据库产品而实现的。 不同数据库产品,其SQL的实现略有不同,但这些表的逻辑概念一定是相同的。另外, 一般企业的业务系统都会有历史数据,所以在考虑设计表时,也要考虑到历史数据的归档或初始化的问题。
以上就是本期基于 openGauss 数据库环境做的相关实验后的经验 分享,欢迎测试、交流,下期再见!
作者:酷哥,来源Gauss松鼠会。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70019768/viewspace-2919223/ ,如需转载,请注明出处,否则将追究法律责任。

