- cpu信息可以从文件中cpuinfo读取。执行命令:# cat /proc/cpuinfo。
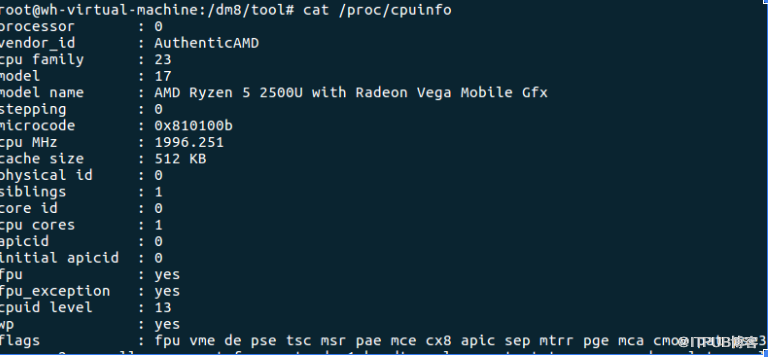
以下是重要指标的说明:
model name    cpu的名称,型号,主频
cpu Mhz       是实际主频
physical id   单个cpu的标号。
cpu cores     逻辑核所处cpu的物理核
- 执行top命令,然后按1。可以查看所有逻辑核的负载
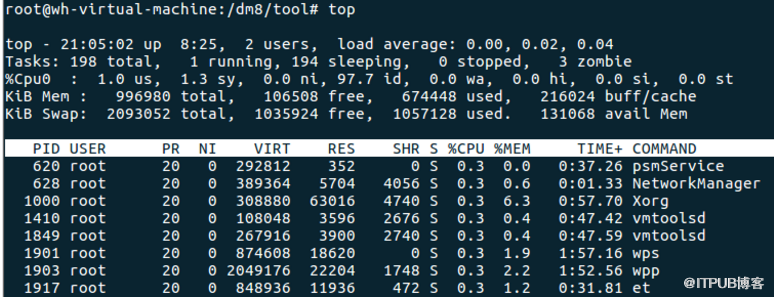
以下是重要指标的说明:
us:  用户空间占用 CPU 百分比。
sy:  内核(系统)空间占用 CPU 百分比。
id:  空闲 CPU 百分比。
wa:   等待输入输出的 CPU 时间百分比。
hi:  硬件 CPU 中断占用百分比。
st:  虚拟机(虚拟化技术)占用百分比。
执行ps aux | grep PID,可以根据PID找到对应其他详细信息以及进程名称,DM数据库的进程最后会指向对应实例的dm.ini文件。
- 执行 vmstat 1 10 命令,可对操作系统的CPU 活动等进行监视.
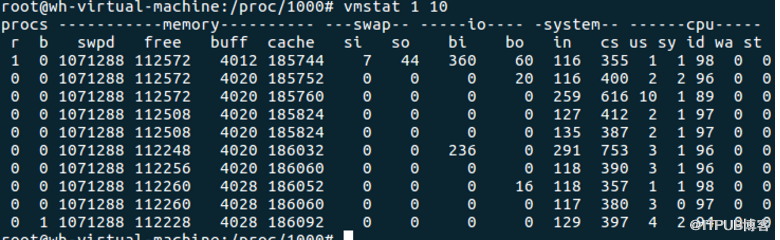
以下是重要指标的说明:
r:如果在 procs 中运行的序列 (process r) 是连续的大于在系统中的 CPU 的个数,表示 CPU
比较忙,系统现在运行比较慢,有多数的进程等待 CPU。如果 r 的输出数大于系统中可用 CPU 个数的 4 倍的话,则系统面临着 CPU
短缺的问题,或者是 CPU 的速率过低,系统中有多数的进程在等待 CPU,造成系统中进程运行过慢。
b:如果在 procs 中运行的序列 (process b),即处于不可中断状态的进程数,连续为 CPU 的 2~3 倍就表明 CPU
排队比较严重了。
SYSTEM
in:每秒产生的中断次数。
cs:每秒产生的上下文切换次数。
in 和 cs 这两个值越大,会看到由内核消耗的 CPU 时间会越大。
us:用户进程消耗的 CPU 时间百分。us 的值比较高时,说明用户进程消耗的 CPU 时间多,在服务高峰期持续大于
50~60,是可以接受,但是如果长期超 50% ,那么我们就该考虑优化程序算法。
sy:内核进程消耗的 CPU 时间百分比。sy 的值高时,说明系统内核消耗的 CPU 资源多,这并不是良性表现,我们应该检查原因。
wa:IO 等待消耗的CPU时间百分比。wa 的值高时,说明 IO
等待比较严重,这可能由于磁盘大量作随机访问造成,也有可能磁盘出现瓶颈(块操作)。
id:CPU 处于空闲状态时间百分比,如果空闲时间 (cpu id) 持续为 0 并且系统时间 (cpu sy) 是用户时间的两倍 (cpu
us) 系统则面临着 CPU 资源的短缺,在服务高峰期持续小于 50,可以接受。
- 执行free,可以查看内存使用情况

以下是指标的说明:
Mem:内存的使用信息
Swap:交换空间的使用信息
total:总计物理内存的大小
used:已使用物理内存
free:可用物理内存
shared:多个进程共享的内存总额
buffers/cached:缓存缓冲使用物理内存大小
available:还可以被应用程序使用的物理内存大小
- 执行top命令,可以监控 Linux 的内存状况
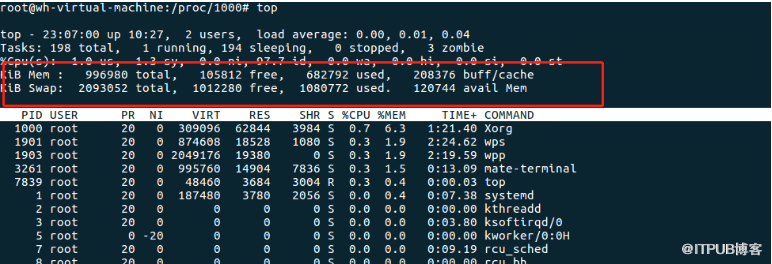
MEM 一行为系统内存信息
total:     物理内存总量
used:      使用中的内存总量
free:      空闲内存总量
buffers:   缓存的内存量
Swap 一行为swap交换分区信息
total:     交换区总量
used:      使用的交换区总量
free:      空闲交换区总量
cached:    缓冲的交换区总量
- 执行 vmstat 1 10 命令,可对操作系统的内存进行监视。
MEMORY
swap:切换到交换内存上的内存(默认以 KB 为单位)。如果 SWAP 的值不为 0,或者还比较大,比如超过 100 MB 了,但是 SI 和 SO 的值长期为 0,这种情况我们可以不用担心,不会影响系统性能。
free:空闲的物理内存。
buff:作为 buffer cache 的内存,对块设备的读写进行缓冲。
cache:作为 page cache 的内存,文件系统的 cache 如果 cache 的值大的时候,说明 cache 处的文件数多,如果频繁访问到的文件都能被 cache,那么磁盘的读 IO bi 会非常小。
SWAP
si:交换内存使用,由磁盘调入内存。
so:交换内存使用,由内存调入磁盘。
- 执行ifconfig -a,可以查看网卡信息
- 执行ping,可以用来测试本机与目标主机是否联通、联通速度如何、稳定性如何。
- 执行iostat 或者iotop ,对IO情况进行监控。若没有安装iostat程序,需要先执行 apt install sysstat
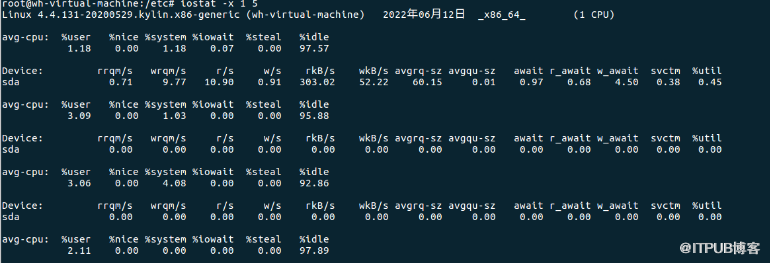

- 执行vmstat 命令了解系统状况
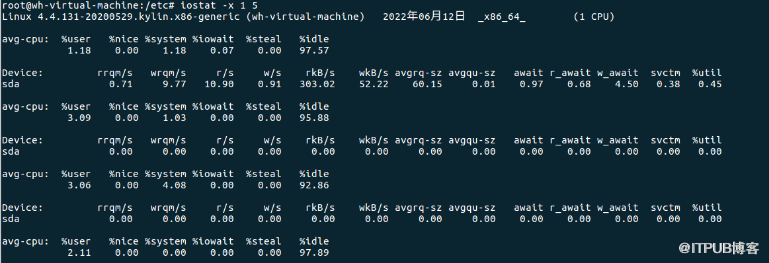
若通过vmstat查看后判断IO 可能出现性能问题。可以进一步通过 iostat 命令分析。
指标中的await(表示每次io设备等待时间)和 svctm(表示每次 IO 设备服务时间,一般性能越好的磁盘,这个值越小),当svctm 接近 await ,说明 IO 几乎没有等待,每个 IO 设备都得到及时的响应。如果 svctm 远小于 await ,说明 IO 等待队列可能很长,IO 的得到服务的时间将延长(排队+服务时间)
- 动态性能视图
with locks as(
  select o.name,l.*,s.sess_id,s.sql_text,s.clnt_ip,s.last_send_time
  from v$lock l,sysobjects o,v$sessions s
  where l.table_id=o.id and l.trx_id=s.trx_id),
 lock_tr as (   select trx_id wt_trxid,row_idx blk_trxid
                from locks
                where blocked=1),
 res as(select sysdate stattime,t1.name,t1.sess_id wt_sessid,s.wt_trxid,
     t2.sess_id blk_sessid,s.blk_trxid,t2.clnt_ip,SF_GET_SESSION_SQL(t1.sess_id) fulsql,
     datediff(ss,t1.last_send_time,sysdate) ss,t1.sql_text wt_sql
     from lock_tr s,locks t1,locks t2
    where t1.ltype='OBJECT'  and t1.table_id<>0
        and t2.ltype='OBJECT'  and t2.table_id<>0
       and s.wt_trxid=t1.trx_id  and s.blk_trxid=t2.trx_id)
select distinct wt_sql,clnt_ip,ss,wt_trxid,blk_trxid  from res;
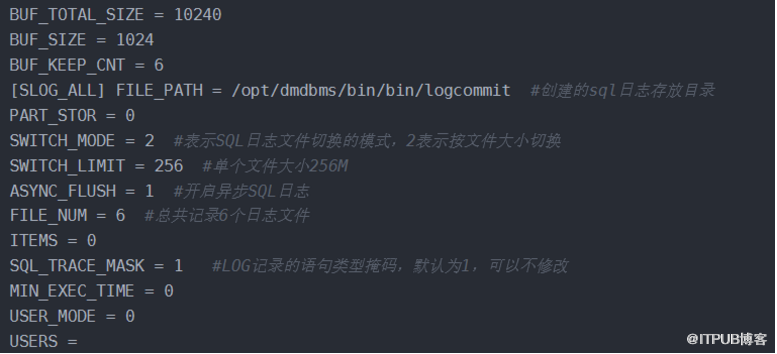
配置 dm.ini 中
SVR_LOG = 1 启用 sqllog.ini 配置:SP_SET_PARA_VALUE(1,'SVR_LOG',1);如需进行更为系统全面的分析,可使用 Dmlog 工具对 SQL 进行分类汇总;
- 开启AWR报告
SP_INIT_AWR_SYS(1)
CALL DBMS_WORKLOAD_REPOSITORY.AWR_SET_INTERVAL(30);
- 生成AWR报告
DBMS_WORKLOAD_REPOSITORY.CREATE_SNAPSHOT();
SELECT * FROM SYS.WRM$_SNAPSHOT;
--查看
SELECT * FROM TABLE(DBMS_WORKLOAD_REPOSITORY.AWR_REPORT_HTML(1,2));
--生成
SYS.AWR_REPORT_HTML(1,2,'D:\','AWR1.HTML');
- 分析AWR报告
- 若sql可在可接受范围内执行出来,可通过et查看耗时的执行计划。
SP_SET_PARA_VALUE(1, 'ENABLE_MONITOR',1);
SP_SET_PARA_VALUE(1, 'MONITOR_TIME',1);
这两个参数一般都是优化后默认开启的。MONITOR_SQL_EXEC 参数可通过会话级开启。
SF_SET_SESSION_PARA_VALUE('MONITOR_SQL_EXEC',1);- 对于收集的慢sql,传参和不传参执行计划不同,但都执行很快的现象,这时需要从内存种获取执行计划。
select cache_item,sqlstr
 from v$cachepln where sqlstr like 'select authorized_customer%' ;
 alter session set events
 'immediate trace name plndump level 4788852848,dump_file ''/data/EXPLAN_ 4788852848.log''';
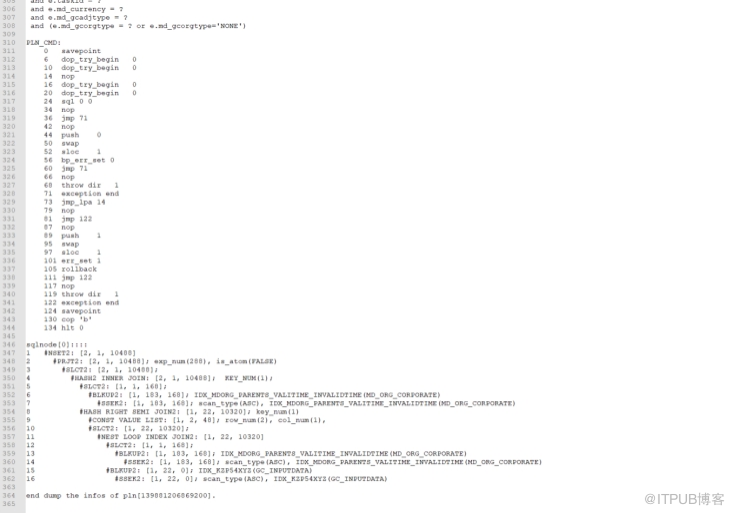
这时可依据内存的执行计划进行分析。必要时可清除该语句的执行计划,让其从新生成。
call SP_CLEAR_PLAN_CACHE(cache_item);
- 常见操作符解读
NSET:结果集收集
PRJT:投影。
用于选择表达式项的计算。广泛用于查询,排序,函数索引创建等。
AAGR:简单聚集
用于没有 GROUP BY 的 COUNT、SUM、AGE、MAX、MIN 等聚集函数的计算。
SAGR:快速聚集
用于没有过滤条件时从表或索引快速获取 MAX、MIN、COUNT 值。
HAGR:HASH 分组聚集
用于分组列没有索引只能走全表扫描的分组聚集
SAGR:流分组聚集
用于分组列是有序的情况下,可以使用流分组聚集,SAGR2 性能优于 HAGR2。
BLKUP:二次扫描 (回表),先使用二级索引索引定位 rowid,再根据表的主键、聚集索引、rowid 等信息获取数据行中其它列。
CSCN:全表扫描
通过聚集索引扫描全表
SSEK:索引扫描
二级索引扫描即先扫描索引,再通过主键、聚集索引、rowid 等信息去扫描表。
CSEK:索引扫描
聚集索引扫描只需要扫描索引,不需要扫描表,即无需 BLKUP 操作,如果 BLKUP 开销较大时,可考虑创建聚集索引。
SSCN:索引扫描
索引全扫描,不需要扫描表
NEST LOOP:嵌套循环连接
HASH JOIN:哈希连接
MERGE JOIN:归并排序连接
- 分析执行计划
DBMS_STATS.GATHER_SCHEMA_STATS('模式名',100,true, 'FOR ALL COULMNS SIZE AUTO');
DBMS_STATS.GATHER_SCHEMA_STATS('模式名',100,true, 'FOR ALL INDEXED SIZE AUTO');dbms_stats.TABLE_STATS_SHOW('模式名','表名');
dbms_stats.column_STATS_SHOW('模式名','表名','列名');
dbms_stats.INDEX_STATS_SHOW('模式名','索引名');
聚集索引:每一个普通表有且只有一个聚集索引;
唯一索引:索引数据根据索引键唯一;
函数索引:包含函数/表达式的预先计算的值;
位图索引:对低基数的列创建位图索引;
位图连接索引:针对两个或者多个表连接的位图索引,主要用于数据仓库中;
全文索引:在表的文本列上而建的索引。
- 当模糊查询时,where条件为A like '%xxx'时是无法使用到A列上的索引。解决办法为建立函数索引,然后改写对应sql条件;若无法改写sql可以通过调整参数LIKE_OPT_FLAG。
CREATE INDEX index_name ON table_name(POSITION('XXX',A));- 存在空值的列上创建索引时需要注意,空值数据信息是不被记录在索引里的,所以当涉及到这些数据的查询时,是无法使用索引的,可以尝试利用一些小技巧,将null的信息也存放在索引中,如创建nvl(列名,0) 或者如下图
CREATE INDEX index_name ON table_name(列名,常量);
- 建索引时不要将过滤性差或分布很不均匀的列建在最前面,当where中以这个单独列为过滤条件时易将其选择到执行计划中,若传参中数据为多数的那个值会导致回表严重。
- 若函数索引中使用的确定性函数发生了变更或删除,用户需手动重建函数索引
- 位图索引:创建方式和普通索引一致, 对低基数的列创建位图索引,能够有效提高,基于该列的查询效率,特别注意位图索引会严重影响到插入和更新操作,不能在业务表上建立。位图索引还具有以下约束:
更多信息请登录达梦社区地址:https://eco.dameng.com/
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70018897/viewspace-2900119/ ,如需转载,请注明出处,否则将追究法律责任。

