PostgreSQL 实时同步到 Apache Doris:一站式 CDC 解决方案
PostgreSQL 已成为众多业务系统的核心数据库,在 各类 TP 场景中被广泛采用。然而,PostgreSQL 的设计目标是高并发在线事务处理,并不适合承载分析型负载。当执行跨表聚合、大范围扫描等查询时,容易占用大量系统资源,从而影响线上业务的稳定性。
因此,在实时分析、实时大屏、数据仓库以及 AI 数据供给等场景中, 通常会将 PostgreSQL 中的数据实时同步至 等分析型数据库 ,由 Doris 承担分析查询任务,实现 TP 与 AP 负载分离。
如何持续、稳定、准确地将 PostgreSQL 的数据同步至 Doris,是整个架构中的关键环节 。
PostgreSQL 至 Apache Doris 的实时同步
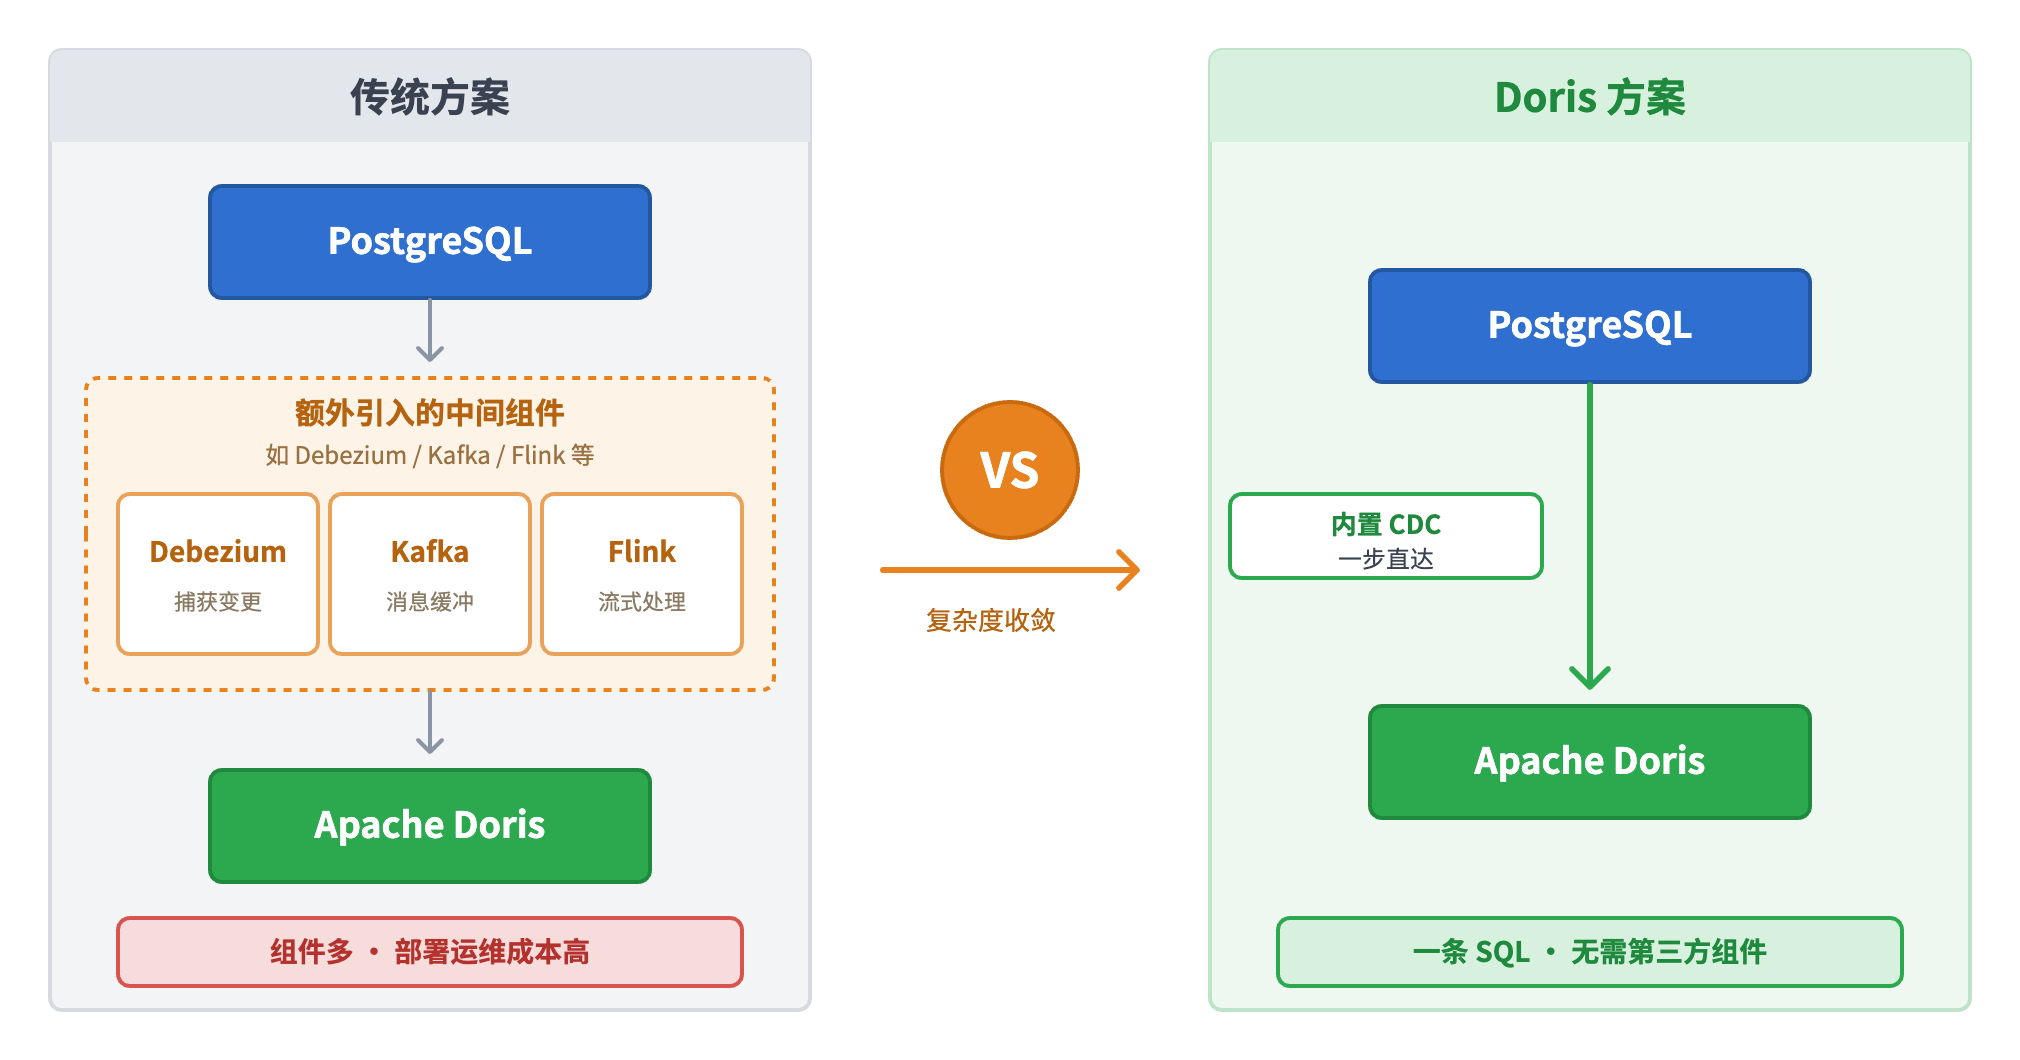
先来看传统方案与 Apache Doris 一站式 CDC 同步方案的整体流程。
传统同步方案的挑战
由上图可知,传统方案的同步链路一般由三个部分组成:
-
CDC 采集:通过 Debezium、Flink CDC 等组件持续捕获 PostgreSQL WAL 日志中的数据变更;
-
消息传递:根据业务需求,将变更数据写入 Kafka,或直接发送至下游系统;
-
数据处理:依赖 Flink、Spark 等计算框架完成数据转换、清洗,并最终写入 Apache Doris。
这种方案具有较强的灵活性,能够支持复杂的数据处理逻辑,但同时也意味着需要维护一条由多个独立组件组成的数据链路。对于仅需完成 PostgreSQL 到 Doris 实时同步的场景,这样的架构往往存在以下问题:
-
组件众多,部署复杂 :除数据库外,还需要维护 CDC、Kafka、Flink/Spark 等多个系统,涉及部署、监控、升级以及扩缩容等工作。对于仅有数据同步需求的用户而言,引入如此多的组件成本较高。
-
同步链路较长,故障排查困难 :当数据延迟、丢失或异常时,需要在 CDC、消息队列、计算引擎等多个系统之间逐层排查,定位问题耗时且复杂。
Apache Doris 一站式 CDC 同步方案
针对上述问题,Apache Doris 提供了 内置 PostgreSQL CDC 同步能力 ,是专门面向 TP 数据库的实时同步场景。该方案将数据采集、任务调度、数据写入、断点续传等能力统一集成到 Doris Job 调度框架中,无需部署额外的 CDC 工具、消息队列或计算引擎。
因此,整体同步链路被进一步简化为:PostgreSQL → Apache Doris。
对于用户而言,需要维护的对象也从多个独立组件收敛为一个 Doris 集群,降低了部署和运维复杂度。
创建同步任务也非常简单,只需执行一条 SQL:
CREATE JOB test_postgres_job


ON STREAMING


FROM POSTGRES
(


"jdbc_url"
=
"jdbc:postgresql://127.0.0.1:5432/postgres"
,


"driver_url"
=
"postgresql-42.5.0.jar"
,


"driver_class"
=
"org.postgresql.Driver"
,


"user"
=
"postgres"
,


"password"
=
"postgres"
,


"database"
=
"postgres"
,


"schema"
=
"cdc_test"
,


"include_tables"
=
"student1,student2"
,


"offset"
=
"initial"


)


TO
DATABASE target_db
任务创建完成后,Doris 将自动完成以下工作:
-
根据 PostgreSQL 表结构自动创建目标表(如不存在);
-
导入历史存量数据;
-
持续消费 PostgreSQL WAL,实时同步增量数据。
一站式 CDC 同步方案的实现原理
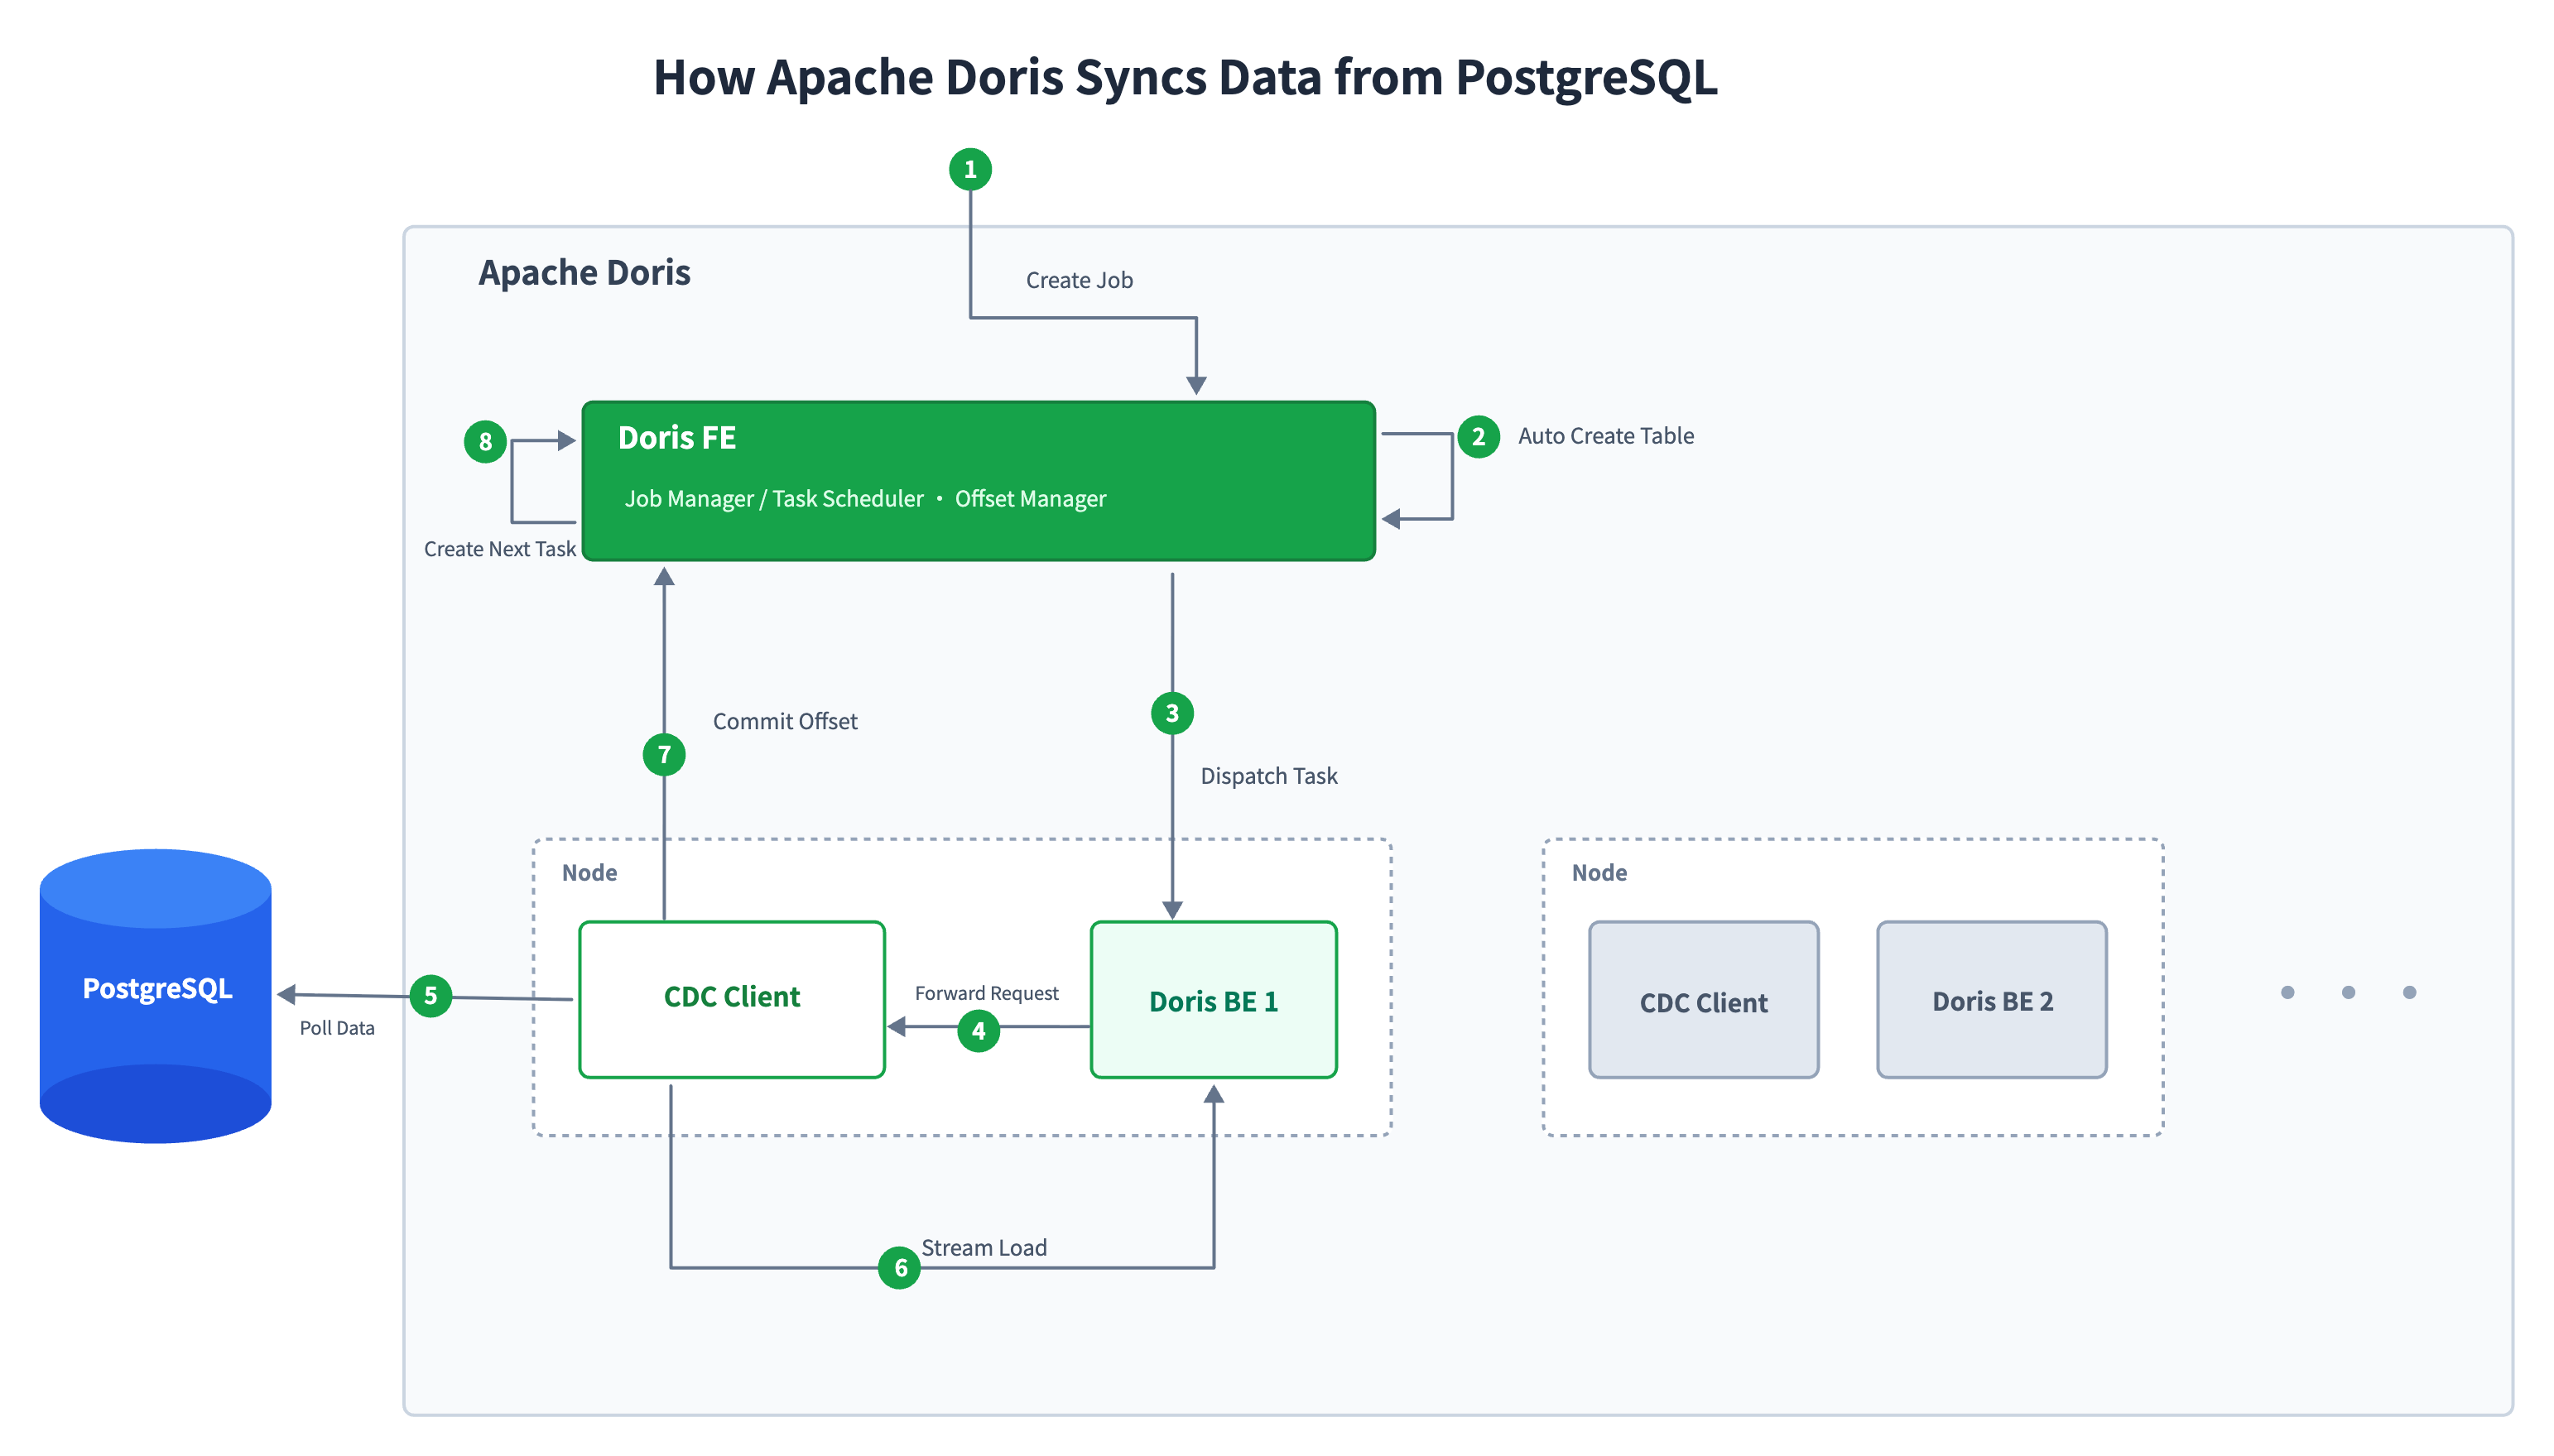
内置 PostgreSQL CDC 并不是一个独立运行的同步组件,而是构建在 Apache Doris 的 Job 调度框架之上。通过 FE 调度、BE 执行以及 CDC Client 拉取变更数据 三部分协同工作,实现持续运行的实时同步任务。
接下来我们了解下具体的执行流程。
-
用户在 FE 中通过 SQL 创建 PostgreSQL Streaming Job,并指定同步库、同步表及相关参数;
-
FE 根据 PostgreSQL 表结构自动创建 Doris 目标表(若不存在);
-
Job Scheduler 生成同步 Task,并调度至某个 BE 节点执行;
-
BE 接收到任务后,将请求转发给本机 CDC Client;若 CDC Client 尚未启动,则自动拉起对应进程;
-
CDC Client 持续读取 PostgreSQL WAL,完成全量及增量数据采集;
-
数据序列化后,通过 Stream Load 写入 Doris;
-
当前批次写入完成后,BE 将同步 Offset 上报给 FE;
-
FE 持久化 Offset,并继续调度下一轮同步任务,实现持续同步。
整个过程中,数据同步、任务调度以及状态管理均由 Doris 自身完成,无需依赖 Kafka、Flink 或 Spark 等外部系统。
这种设计一方面缩短了同步链路,另一方面也充分复用了 Doris 已有的 Job 调度能力,使整个同步过程更加稳定、易于维护。
快速体验
创建 PostgreSQL 同步任务仅需执行一条 SQL:
下面示例将 PostgreSQL 中的数据同步至目标数据库
target_test_db
:
CREATE JOB test_postgres_job


ON STREAMING


FROM POSTGRES
(


"jdbc_url"
=
"jdbc:postgresql://127.0.0.1:5432/postgres"
,


"driver_url"
=
"postgresql-42.5.0.jar"
,


"driver_class"
=
"org.postgresql.Driver"
,


"user"
=
"postgres"
,


"password"
=
"postgres"
,


"database"
=
"postgres"
,


"schema"
=
"cdc_test"
,


"include_tables"
=
"student1,student2"
,


"offset"
=
"initial"


)


TO
DATABASE target_test_db
创建完成后,Job 会自动完成目标表创建、全量数据导入以及后续增量同步。
同步过程中,可以通过如下命令查看任务状态:
mysql
>
select
*
from jobs
(type
=
'insert'
)
where name
=
'test_postgres_job'
\G


***************************
1.
row
***************************


              Id
:
1774599451260


            Name
: test_postgres_job


        Definer
: root


    ExecuteType
: STREAMING


RecurringStrategy
:


Status
: RUNNING


      ExecuteSql
:
FROMPOSTGRES
(
'schema'
=
'cdc_test'
,
'include_tables'
=
'student1,student2'
,
'database'
=
'postgres'
,
'driver_class'
=
'org.postgresql.Driver'
,
'offset'
=
'initial'
,
'driver_url'
=
'postgresql-42.5.0.jar'
,
'jdbc_url'
=
'jdbc:postgresql://127.0.0.1:5432/postgres'
,
'user'
=
'postgres'
)
TO
DATABASE target_test_db
(
'table.create.properties.replication_num'
=
'1'
)


      CreateTime
:
2026
-
03
-
27
17
:
02
:
48


SucceedTaskCount
:
3


FailedTaskCount
:
0


CanceledTaskCount
:
0


Comment
:


      Properties
:


  CurrentOffset
:
{
"lsn"
:
"53547640"
,
"txId"
:
"1523"
,
"splitId"
:
"binlog-split"
}


      EndOffset
:
{
"lsn"
:
"53547640"
}


  LoadStatistic
:
{
"scannedRows"
:
7
,
"loadBytes"
:
341
,
"fileNumber"
:
0
,
"fileSize"
:
0
,
"filteredRows"
:
0
}


        ErrorMsg
:


  JobRuntimeMsg
:
No
data available
for consumption
at the moment
, will retry
after
1774602192496
其中几个关键字段含义如下:
CurrentOffset
记录当前同步进度、
LoadStatistic
反映已写入的行数与字节数。通过这些指标,可以快速判断同步任务是否正常运行,以及当前数据同步的实时进度。
更多参数配置和高级用法,可参考 。
总结
对于 PostgreSQL 到 Apache Doris 的实时同步而言,传统方案通常需要引入 CDC、消息队列和计算引擎等多个组件,虽然具备较高的灵活性,但也增加了部署和运维成本。
Apache Doris 将 PostgreSQL CDC、Job 调度、自动建表、数据导入以及断点续传等能力统一集成到 Job 调度框架中,使实时同步能够简化为一条 SQL 即可完成。后续,该能力也将陆续集成至 ,进一步降低生产环境下 PostgreSQL 实时同步的部署与运维成本。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-3176483/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
- Apache Doris + Lance:让多模态数据真正进入智能驾驶与具身智能的分析闭环
- Apache Doris 5.0 年度版本前瞻(一):构建统一的多模湖仓实时分析平台
- 统一全文检索与 SQL 分析:Apache Doris 日志分析实践
