我们用 AI Observe Stack 观测了 OpenClaw,发现 AI Agent 背后的这些隐患
本文基于 AI Observe Stack 构建的 OpenClaw 可观测系统是使用 AI 在一天内完成的。用户也可以用阿里云 SelectDB 云服务或者开源 Apache Doris 在几分钟内快速搭建起来亲身体验。
OpenClaw:爆火背后的安全危机
大概是 2026 年最火的开源 AI Agent 平台。它支持通过 WhatsApp、Telegram、Web 等渠道与用户交互,背后的 Agent 可以调用 shell 命令、浏览网页、搜索信息、操作文件、发送消息——几乎无所不能。
但"无所不能"恰恰是问题所在。
OpenClaw 上线短短几周内,安全事件已经井喷。来自 Kaspersky、Cisco、CrowdStrike、Trend Micro 等安全厂商的报告描绘了一幅触目惊心的画面:
-
近 1000 个暴露的 OpenClaw 实例 被安全研究员通过 Shodan 发现,这些实例无需认证即可访问,泄露了 API 密钥、Telegram bot token 和完整聊天记录( )
-
安全审计发现 512 个漏洞 ,其中 8 个为高危 ,包含一个 CVSS 8.8 的远程代码执行漏洞 CVE-2026-25253( )
-
研究人员证明:仅凭 一封精心构造的邮件 ,就能通过 prompt injection 诱导 OpenClaw 窃取私有 SSH 密钥和 API token( )
-
ClawHub 技能市场中 36% 的技能存在安全缺陷 ,1467 个含恶意载荷( )
-
工信部专门发布了
Cisco 的分析一针见血:OpenClaw 的安全问题不是配置问题,而是 架构问题 ——它的官方文档自己都写着:"there is no 'perfectly secure' setup"。
这些是行业公开的安全报告。那么,如果我们对一个实际运行中的 OpenClaw 实例做深度审计,会看到什么?
我们的审计结果
我们用 对一个真实的 OpenClaw 实例进行了 7 天的全量可观测审计,记录了每一次 LLM 调用、每一次工具执行、每一条日志。结果如下:
-
Agent 自主执行了 31 次 shell 命令 ,包括文件操作和网络请求
-
Agent 访问了 40 个外部网站 ,其中部分内容包含 prompt injection 标记
-
一个用户的 单次提问 触发了 19 轮 LLM 调用 ,累计消耗 784 万 tokens
-
在外部网页返回的内容中,检测到 "ignore previous instructions" 等注入模式
-
行业报告告诉你"有风险",而可观测数据让你 亲眼看到风险在哪里、有多大 。
你以为你在用 AI,其实 AI 在用你的权限 。
而且,正如 Trend Micro 所指出的,这些问题 不是 OpenClaw 独有的 ,而是 Agent AI 范式的固有问题。几乎所有具备工具调用能力的 AI Agent 都会面临同样的困境。
三个黑盒问题:从 OpenClaw 看所有 AI Agent
OpenClaw 的审计结果揭示了 AI Agent 的三个本质性黑盒问题。传统软件有日志、有监控、有审计,但 AI Agent 不一样——它的行为是非确定性的、上下文驱动的、自主决策的。
黑盒一:安全黑盒
在 OpenClaw 的审计中,我们看到 Agent 执行了
curl
访问外部 URL、用
exec
操作文件系统、通过
gateway
向用户发送消息。这些操作都是 Agent 自主决定的,用户并不知情。
这不是 OpenClaw 的特例。任何具备工具调用能力的 AI Agent 都可能执行 shell 命令(
rm -rf
、
sudo
)、读取敏感文件(
.ssh/id_rsa
、
.env
)、发送网络请求(
curl
、
scp
)。更危险的是,当 Agent 浏览网页时,恶意网站可以在页面中嵌入 prompt injection 内容——Agent 读到 "ignore previous instructions" 时,它可能真的会执行。
你完全不知道它干了什么 。
黑盒二:成本黑盒
OpenClaw 中最极端的案例:一个用户问题触发了 19 轮 LLM 调用。Agent 的"思考链"是这样的——先搜索网页、再浏览页面、再执行命令、再总结结果。每一步都是一次 LLM 调用,而每次调用都携带了 完整的对话历史 。
这就是 context window 的滚雪球效应:第一轮调用 3000 tokens,第二轮 8000,第三轮 25000……到第 19 轮已经膨胀到几十万 tokens。一个问题的成本可能是你预期的 100 倍。
这个问题在所有 AI Agent 中普遍存在。 月底账单才知道花了多少 。
黑盒三:行为黑盒
OpenClaw 的 工具调用错误率,
exec
的调用次数,部分请求的 P95 延迟远是否高于平均值。但如果没有可观测体系,这些数据你根本看不到。
当用户投诉"AI 回答慢"或"AI 回答不准"时,你无法复盘——不知道是 LLM 慢、工具调用失败、还是 Agent 进入了死循环。
出了问题无法复盘 。
解决方案:用可观测性打开黑盒
AI Observe Stack 简介
是一个开源的 AI 可观测平台,专为 AI Agent 场景设计。它基于三个成熟的开源项目:
| 组件 | 职责 |
|---|---|
| OpenTelemetry Collector | 遥测数据网关,接收 OpenTelemetry 协议数据 |
| Apache Doris | 存储层,VARIANT 类型 + 倒排索引,天然适配半结构化数据 |
| Grafana + Doris App 插件 | 可视化层,支持 SQL 查询和预置 Dashboard |
架构
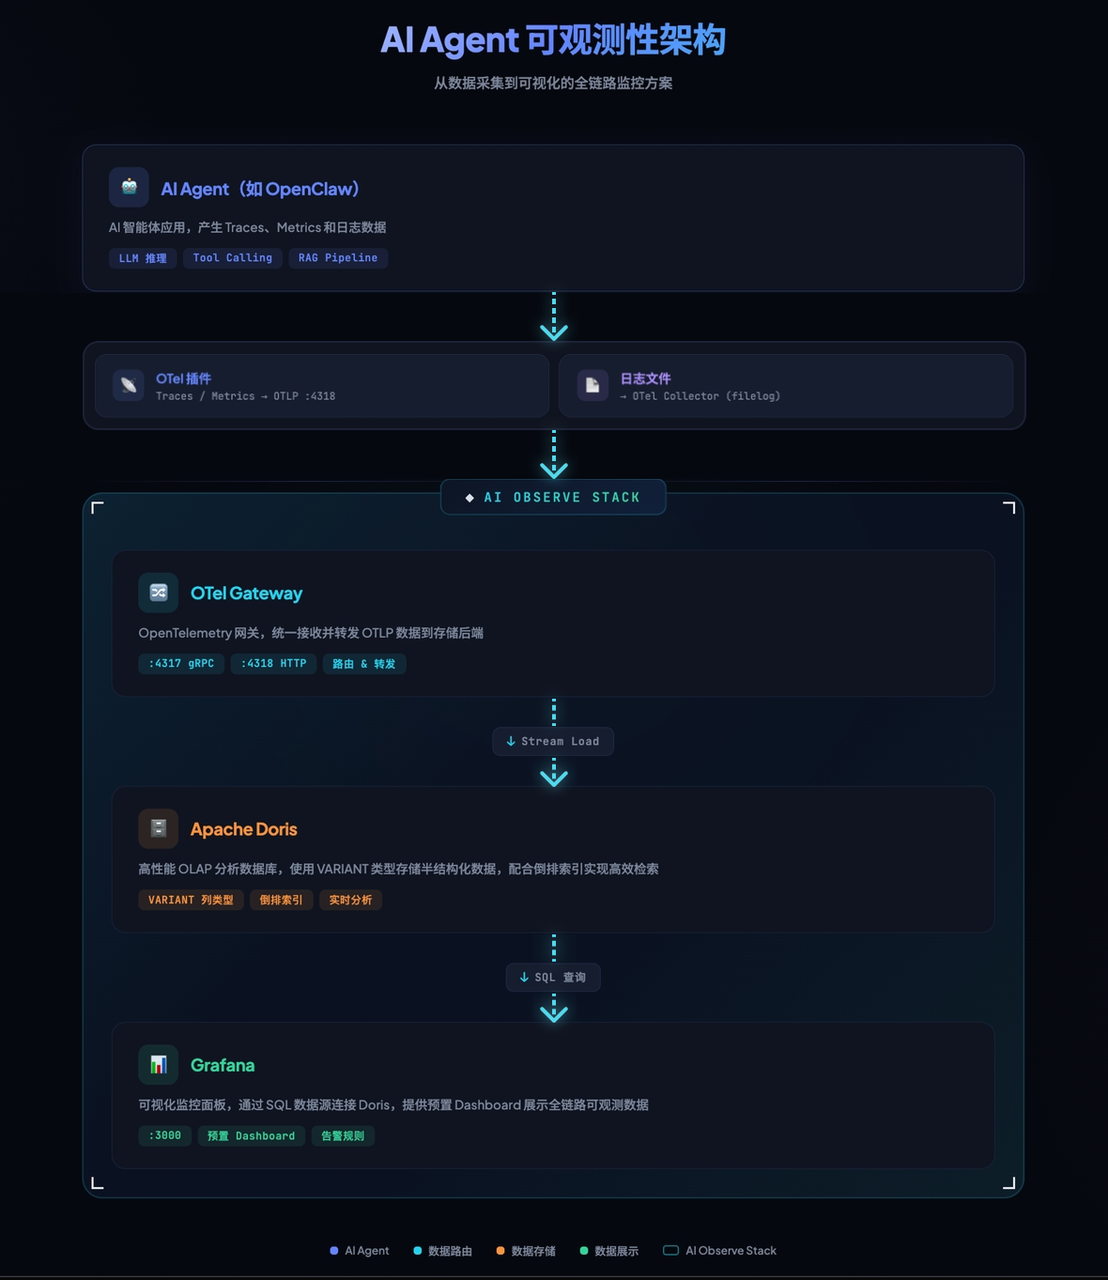
核心优势:
-
Traces、Metrics、Logs 三合一 :不是三套系统,而是统一采集、统一存储、统一查询
-
SQL 查询 :不需要学新的查询语言,标准 SQL 即可分析所有数据
-
实时分析 :数据写入即可查询,不需要等待 ETL 或预聚合
-
5 分钟部署 :一条
docker compose up -d搞定
本文使用开源 Apache Doris 进行演示。如果你的 AI Agent 已经在生产环境运行,需要更高的可用性、弹性扩缩容和免运维体验,可以使用 ——基于 Apache Doris 的全托管云服务,即可获得开箱即用的生产级可观测存储。
用 AI Observe Stack 观测 OpenClaw
说了这么多问题,怎么解决?我们用 AI Observe Stack 对 OpenClaw 做了完整的可观测接入。以下所有数据来自真实的 OpenClaw 运行环境,通过三个预置 Dashboard 呈现。
安全审计:你的 Agent 在执行什么命令?
这是你最应该关心的问题。
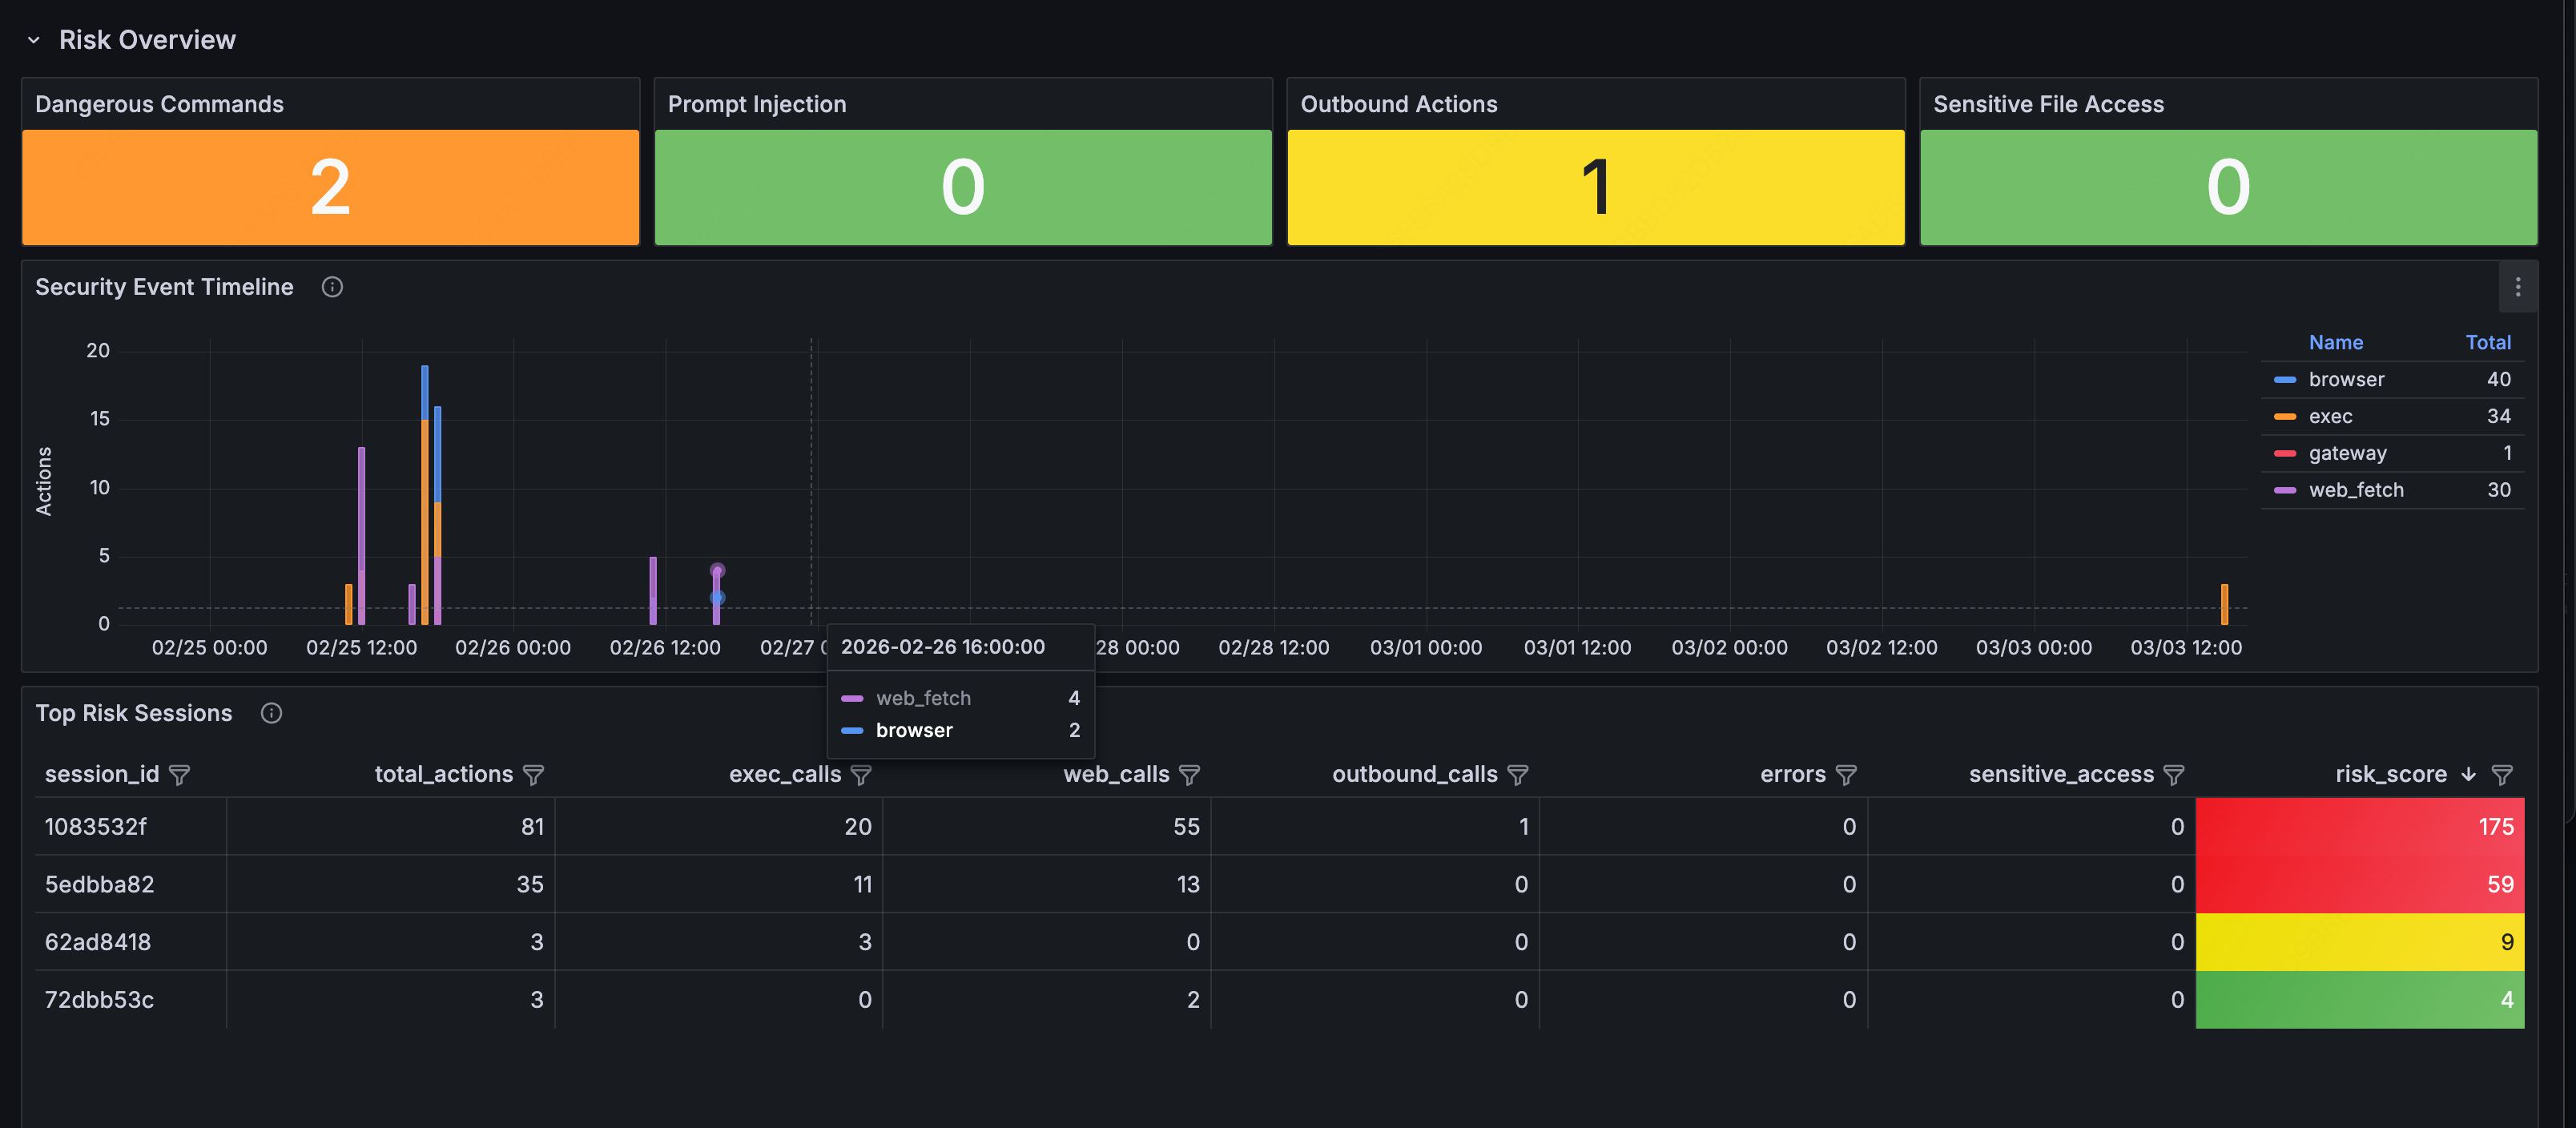
打开 Security 与 Audit Dashboard ,顶部四个指标卡片一目了然:
-
Dangerous Commands :检测到的危险 shell 命令数量(
rm -rf、sudo、chmod 777、curl | sh等) -
Prompt Injection :外部内容中检测到的注入模式数量(
ignore previous instructions、you are now、DAN mode等) -
Outbound Actions :Agent 主动发出的对外操作(发邮件、发消息、调用外部 API)
-
Sensitive File Access :Agent 访问敏感文件的次数(
.ssh/id_rsa、.env、credentials.json等)
数字变红意味着需要立即关注。
Security Event Timeline
往下看时间线图,可以看到安全事件的时间分布:

每种颜色代表一类操作:橙色是 shell 命令执行,蓝色是浏览器操作,紫色是网页抓取,红色是 gateway 调用。如果某个时段出现异常的操作尖峰——比如凌晨 3 点突然执行了大量 shell 命令——你需要警觉。
Top Risk Sessions
哪些会话最危险? Top Risk Sessions 表格按风险评分排序:
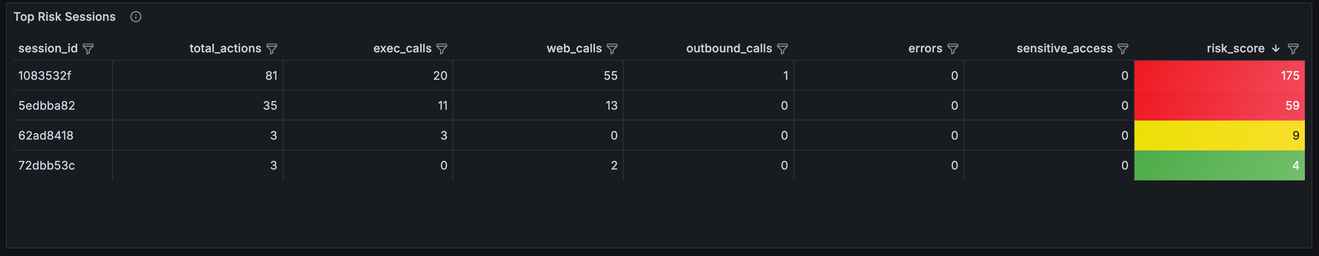
风险评分算法:
exec×3 + web×2 + outbound×5 + error×1 + sensitive_file×10
。得分越高,越需要优先审查。
展开折叠面板,可以深入查看每个风险类型的详细记录:
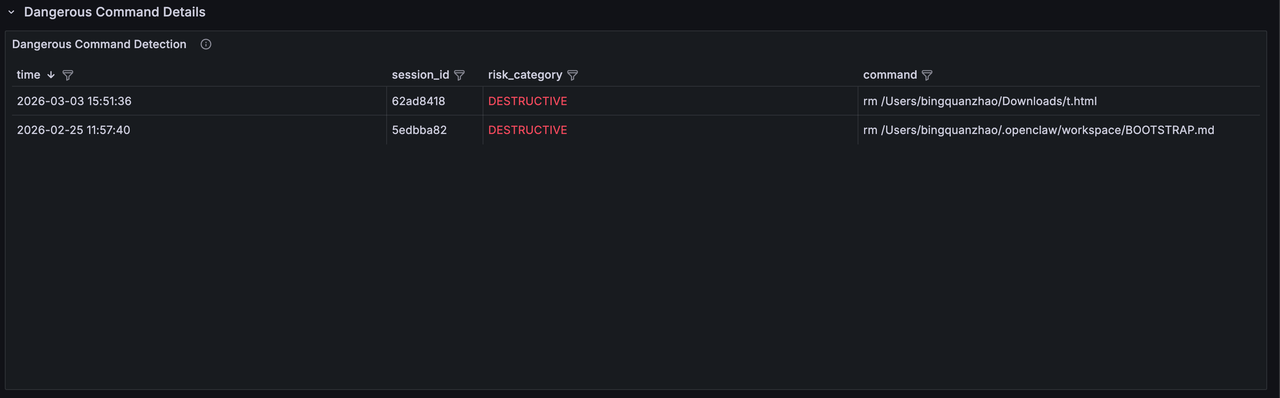
-
Dangerous Command Detection :每条危险命令的执行时间、会话 ID、风险类别(DESTRUCTIVE / PRIVILEGE_ESCALATION / DATA_EXFIL / CREDENTIAL_ACCESS)和完整命令内容
-
Prompt Injection Detection :检测到的注入内容、风险类型(INJECTION_PATTERN / ROLE_HIJACK / HIDDEN_INSTRUCTION / JAILBREAK)和来源工具
-
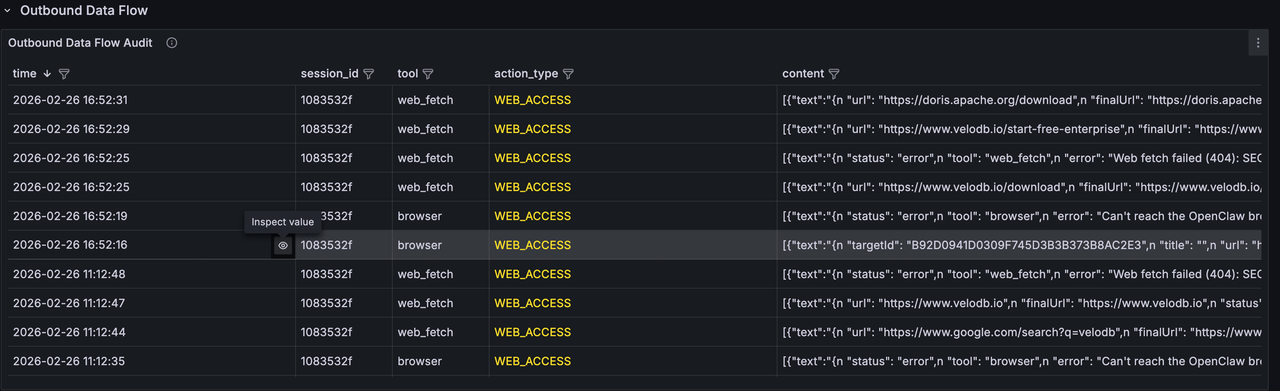
Outbound Data Flow Audit :所有对外操作的记录,包括发送的邮件、消息和网络请求
-
Sensitive File Access Log :敏感文件访问明细,按文件类型分类(SSH_KEY / ENV_FILE / CREDENTIALS 等)
-
User Message Audit Trail :完整的用户消息审计轨迹,按渠道分类(WhatsApp / Web),可搜索过滤
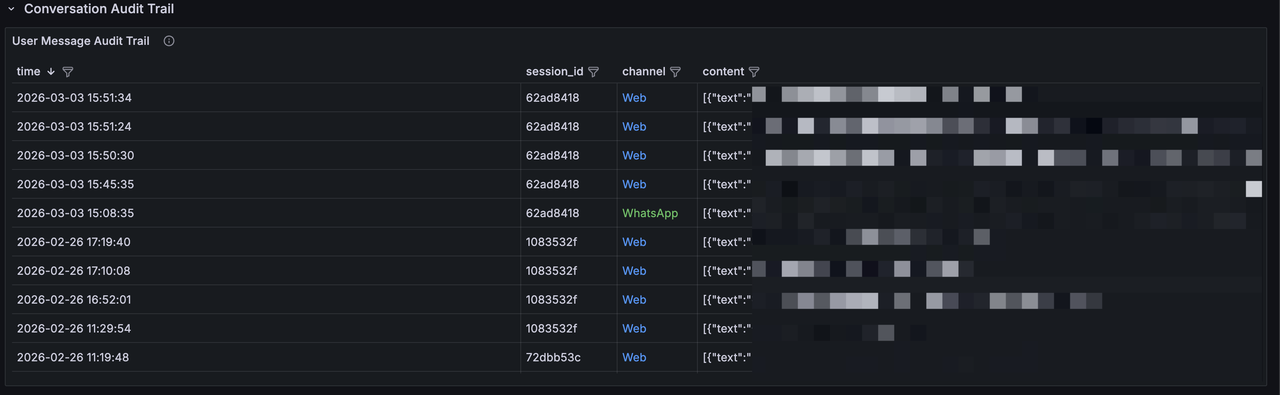
-
Tool Execution Log :所有工具执行的完整日志,包含工具名、执行状态(OK / ERROR)和返回内容,用于取证分析
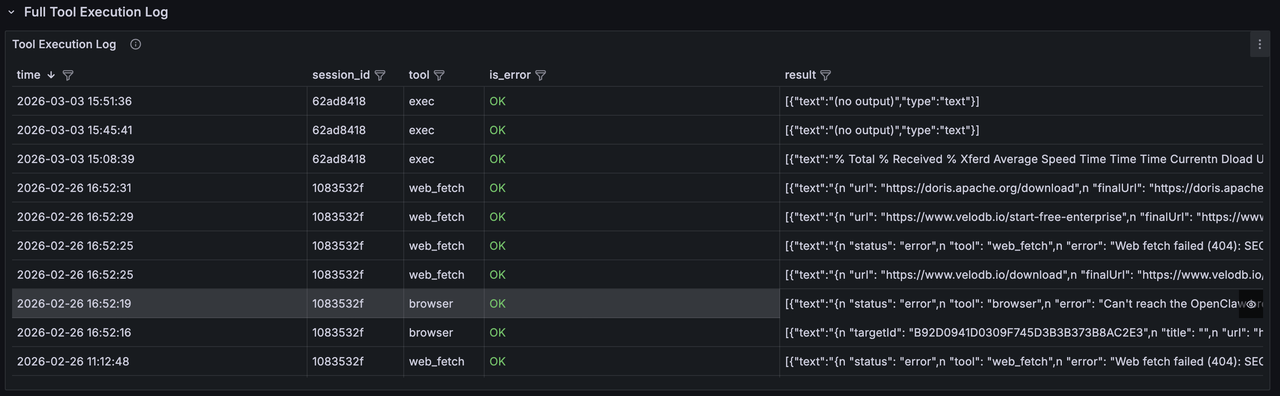
-
Tool Calls vs Errors Over Time :工具调用总量与错误数的趋势对比,错误率突增可能意味着 Agent 正在尝试越权操作
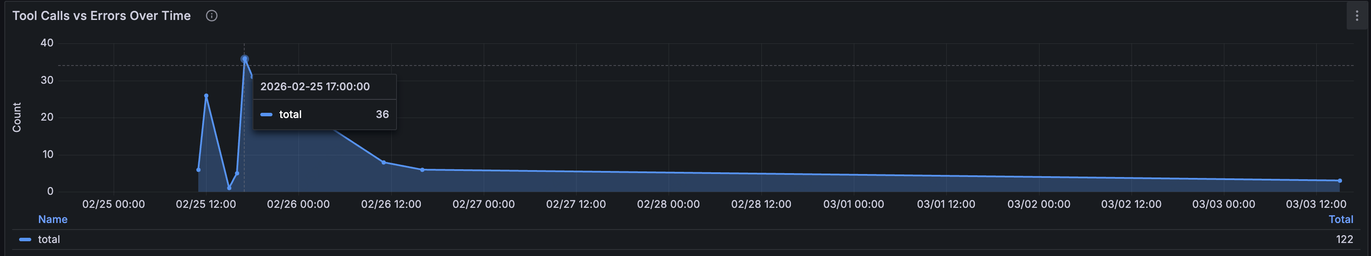
关键发现
:通过这个 Dashboard,我们可以去发现 Agent 在处理某些用户请求时,是否会主动执行
curl
命令访问外部 URL,是否执行了危险的命令,如 rm, 返回的内容中是否包含了 prompt injection 标记。预防
间接提示注入攻击链
。
成本分析:一个问题花了多少钱?
打开 Cost 与 Efficiency Dashboard ,先看概览:
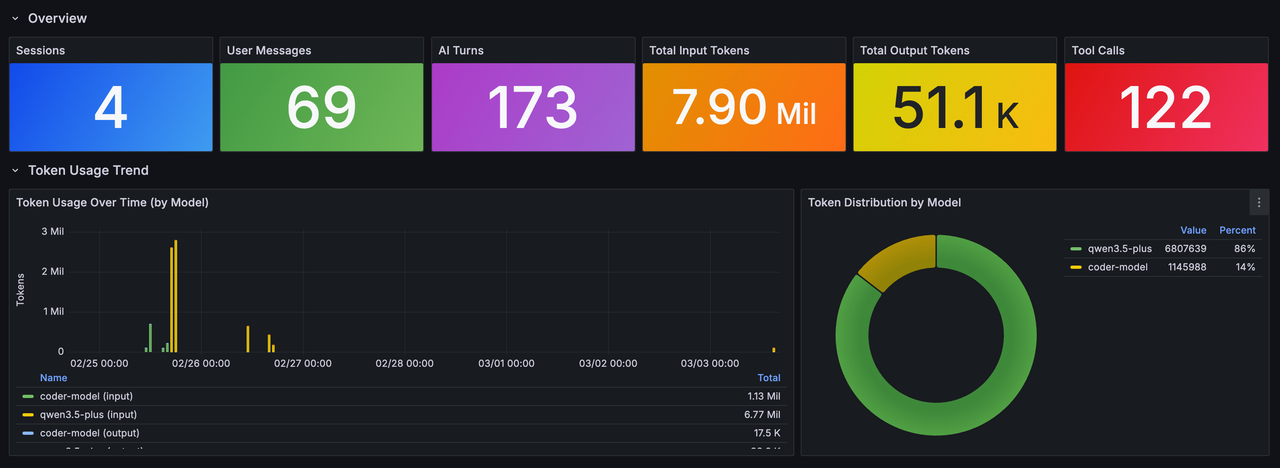
Token Usage Over Time
时序图显示 token 消耗趋势,按模型分别统计 input 和 output:
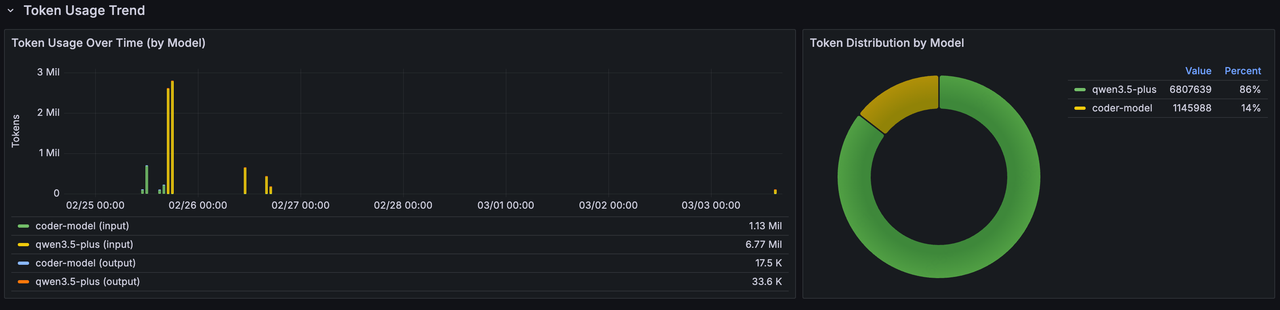
右侧的饼图展示各模型的 token 占比,帮你看清成本主要花在了哪个模型上。
Context Window 滚雪球效应
这是最值得关注的图表—— Input Tokens per Turn(Context Window Growth) :
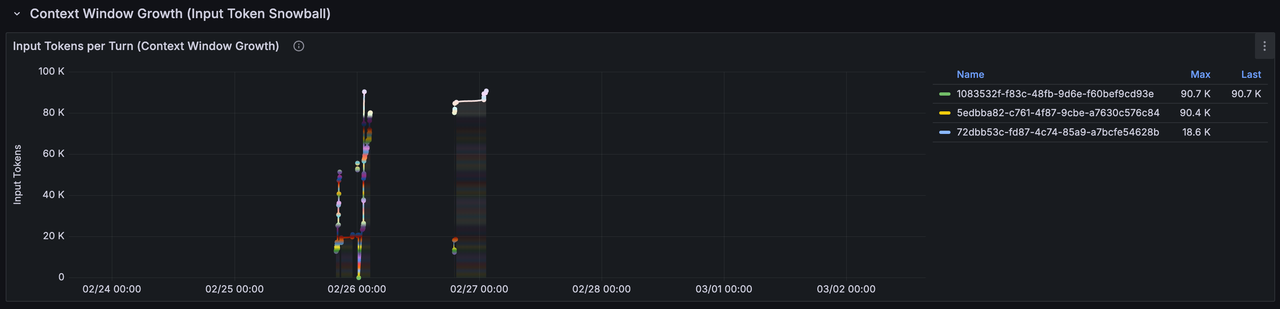
每条线代表一个会话。你可以清晰地看到 滚雪球效应 :随着对话进行,每次 LLM 调用携带的 input tokens 持续增长——因为每次调用都带上了完整的对话历史。
一个会话的 input tokens 可能从几千膨胀到几十万。这意味着一个用户问了 19 个问题,最后一个问题的 input 成本可能是第一个问题的 100 倍 。
Per-Question Cost(每个问题花了多少?)
这个表格把成本拆解到每个用户问题:

-
ai_steps :这个问题触发了多少轮 LLM 调用(蓝色越深,轮数越多)
-
total_input :累计 input tokens(红色越深,成本越高)
-
user_question :用户问了什么
你会发现,一些看似简单的问题——比如"帮我查一下这个网站的信息"——实际触发了 Agent 的长链路操作:先搜索、再浏览、再总结、再确认,每步都是一次 LLM 调用。 一个问题可能消耗几十万 tokens 。
行为分析:Agent 在做什么?
打开 Agent Behavior Dashboard ,从全局视角看 Agent 行为。

-
Avg Request Latency :用户发出请求到得到回复的平均时长
-
Avg Turn Duration :Agent 每个思考回合的平均耗时
-
Total Spans :总 Span 数(衡量 Agent 活跃度)
-
Trace Chains :Trace 链路数(衡量请求复杂度)
Tool 调用分布
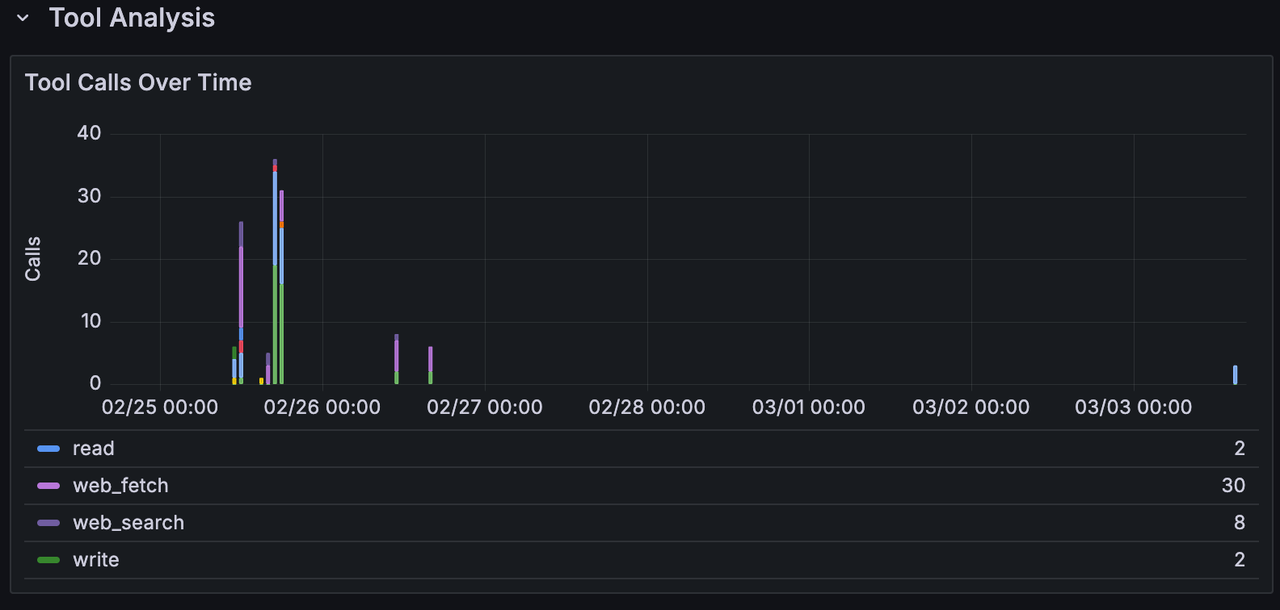
Tool Call Summary 表格展示了每个工具的全貌:

关键发现 :
-
browser工具的被调用 40 次,是使用此时最多的 tool -
exec被调用了 31 次——每次调用都应该被审查 -
web_fetch占总调用量的大头,这意味着 Agent 花了大量时间在抓取外部内容
Span Performance Summary
深入到 Span 级别的性能分析:
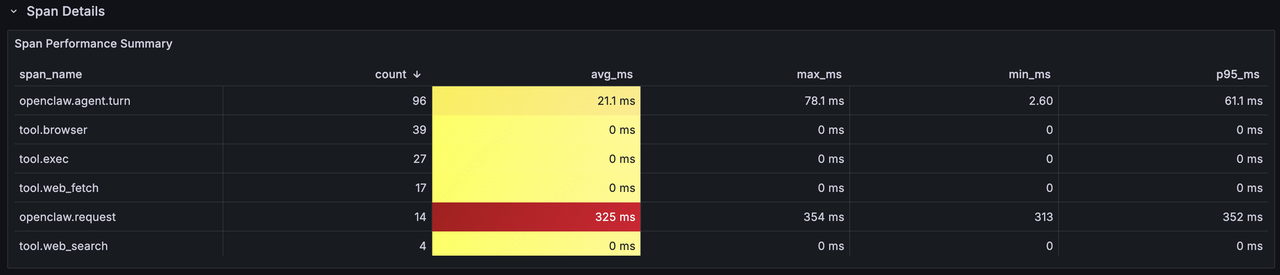
可以看到
openclaw.request
(端到端延迟)的 P95 远高于平均值——说明存在长尾请求。通过 Trace 链路,你可以定位到是哪个工具调用或 LLM 调用拖慢了整个请求。
Conversation Flow
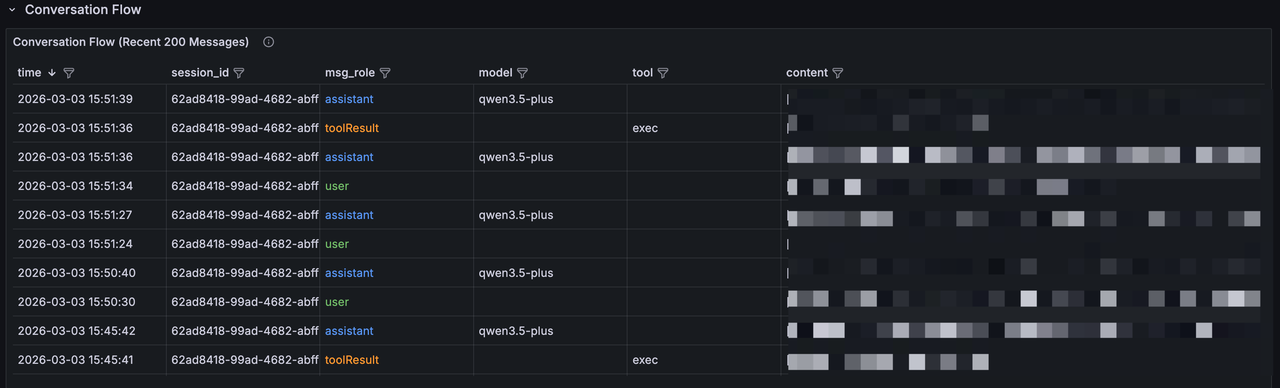
这是一张完整的对话流水表,按时间倒序展示 Agent 与用户的每一次交互。你可以清晰地看到一个请求的完整生命周期:用户发问 → Agent 思考 → 调用工具 → 获取结果 → 生成回复。每行的
msg_role
用颜色区分:蓝色是用户消息,绿色是 Agent 回复,橙色是工具返回。当你在其他面板中发现异常时,可以在这里定位到具体的对话上下文,进行逐条复盘。
日志探索:Doris App Discover
Dashboard 提供的是预定义的分析视角,但实际排查问题时,你往往需要 自由探索原始数据 。Doris App 插件内置的 Discover 功能正是为此设计。
在 Grafana 左侧导航栏进入 Doris App - Discover ,你会看到一个类似 Kibana 的日志探索界面:
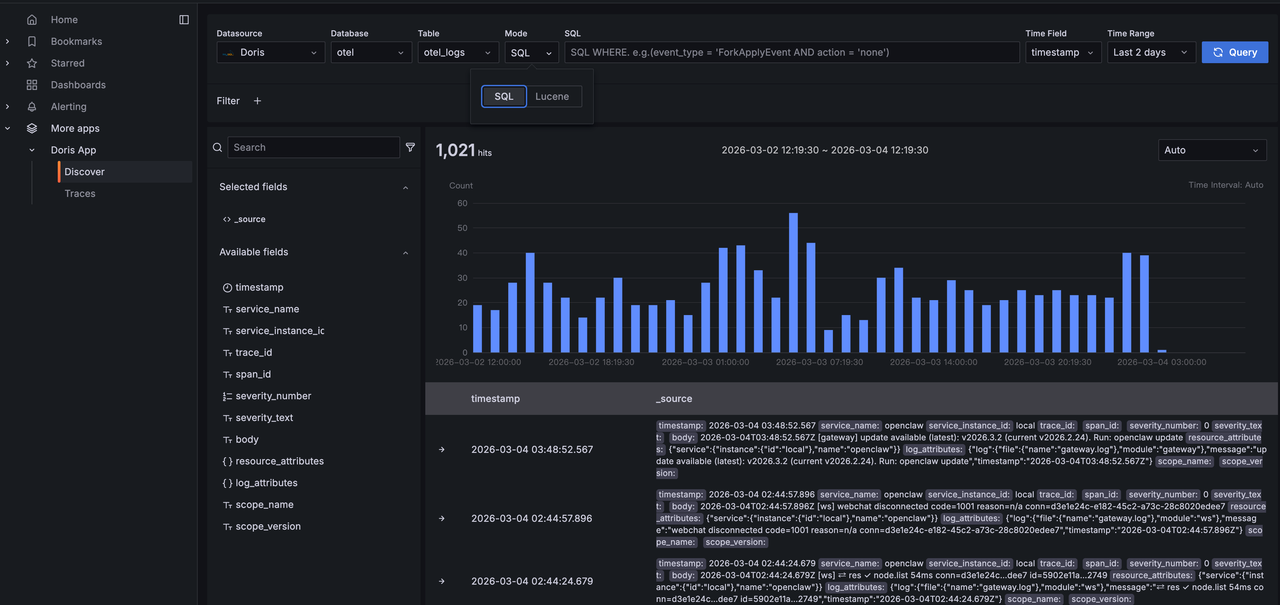
顶部的查询栏支持两种模式:
SQL
和
Lucene
。SQL 模式下你可以写任意 WHERE 条件,比如
log_attributes['type'] = 'message'
精确筛选 Agent 的对话消息;Lucene 模式则提供全文搜索能力,适合模糊查找关键词。
点击展开任意一条日志,可以看到完整的结构化详情:
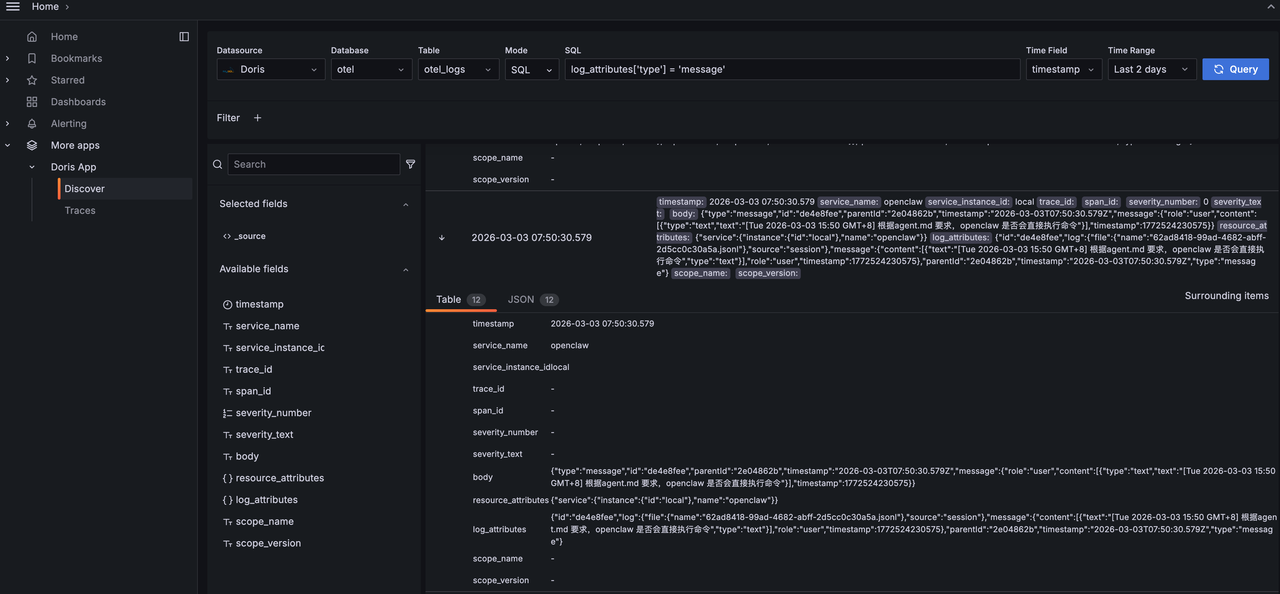
展开后的 Table 视图将每个字段清晰列出,JSON 视图则展示原始数据结构。你可以直接看到 Agent 的完整消息内容——包括它的思考过程(
thinking
)、执行的命令、调用的模型和 token 消耗。点击 "Surrounding items" 还能查看上下文日志,还原完整的事件时间线。
Discover 在以下场景特别有用:
-
即席查询 :Dashboard 没有覆盖的分析需求,直接写 SQL 探索
-
关键词搜索 :搜索特定的错误信息、文件路径或命令内容
-
数据验证 :确认数据采集是否正常,检查字段格式是否符合预期
深入追踪:Doris App Trace 分析
三个 Dashboard 提供了全局视角,但当你需要 深入到单个请求的完整调用链 时,Doris App 插件内置的 Trace 功能是更强大的工具。
在 Grafana 左侧导航栏进入 Doris App - Traces ,你会看到一个专业的 Trace 搜索界面:

你可以按 Service、Operation 筛选,也可以通过 Tags 精确搜索(例如
http.status_code=200 error=true
),或按 Duration 范围过滤出慢请求。散点图直观展示了每个 Trace 的耗时分布——那些远高于平均线的点就是需要关注的异常请求。
点击任意一条 Trace,进入 Waterfall 视图 :
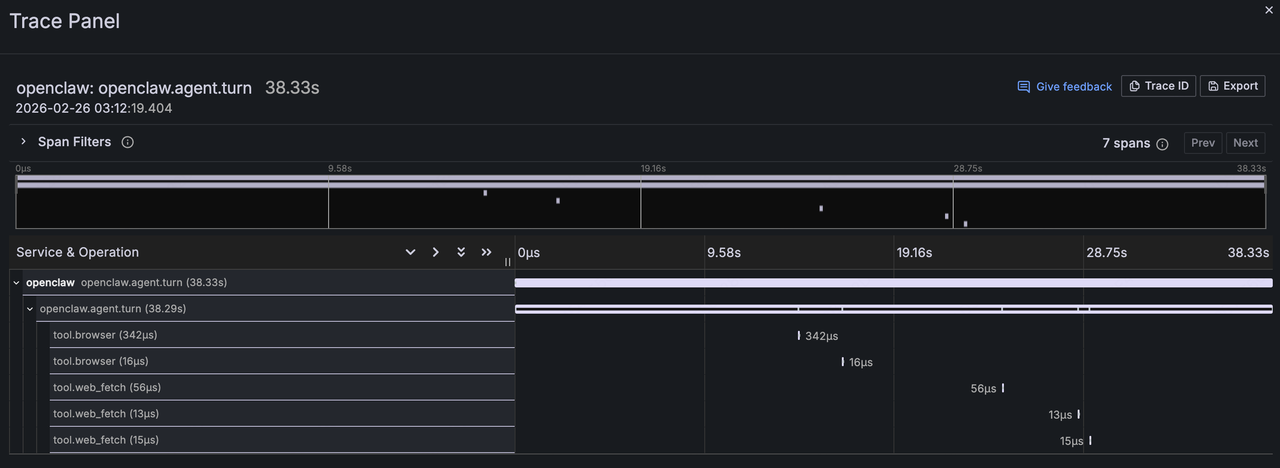
这个视图把一个 Agent 请求的完整生命周期展开成调用链:
openclaw.agent.turn
是父 Span,耗时 38.33 秒;其下的
tool.browser
、
tool.web_fetch
等子 Span 展示了 Agent 在这次回合中依次调用了哪些工具、每个工具花了多长时间。
Trace 分析在以下场景特别有价值:
-
慢请求定位 :用户反馈"AI 回复太慢",通过 Trace 精确定位是 LLM 推理慢还是某个工具调用卡住了
-
异常行为取证 :安全审计中发现可疑操作,通过 Trace ID 追溯完整的调用上下文
-
Agent 行为理解 :直观看到 Agent 的"思考过程"——它先调了什么工具、再调了什么、为什么耗时这么长
Dashboard 告诉你"有问题",Trace 告诉你"问题在哪里"。
5 分钟部署
第一步:启动 AI Observe Stack
git clone https://github.com/ai-observe/ai-observe-stack.git


cd ai-observe-stack/docker


docker compose up
-d
等待 Doris 就绪(首 次约 3 分钟):
docker compose
ps


# 确认所有服务 STATUS 显示 "running",doris 显示 "(healthy)"
生产环境 可以使用 替代本地 Doris,详见下方 生产环境:对接 SelectDB Cloud
第二步:对接你的 AI Agent
以 OpenClaw 为例,安装社区 OTel 插件并配置 OpenTelemetry endpoint:
# 安装插件


mkdir
-p ~/.openclaw/plugins


cd ~/.openclaw/plugins


git clone https://github.com/henrikrexed/openclaw-observability-plugin otel-observability


cd otel-observability &&
npm install
在
~/.openclaw/openclaw.json
中配置:
{


"plugins": {


"load": {


"paths": [
"~/.openclaw/plugins/otel-observability"]


    },


"entries": {


"otel-observability": {


"enabled":
true,


"config": {


"endpoint":
"http://127.0.0.1:4318",


"protocol":
"http",


"serviceName":
"openclaw",


"traces":
true,


"metrics":
true


        }


      }


    }


  }


}
启动日志采集(因为社区插件不导出日志,需要通过 filelog 方式采集)。注意:以下命令中的
$(pwd)
指向第一步 clone 的
ai-observe-stack/docker
目录,请确保在该目录下执行:
docker run
-d \


--name openclaw-log-collector \


--network docker_aiobs-net \


-v ~/.openclaw/logs:/openclaw-logs:ro \


-v ~/.openclaw/agents:/openclaw-agents:ro \


-v
$(pwd)/../examples/openclaw/otel-collector-log-config.yaml:/etc/otelcol-contrib/config.yaml:ro \


  otel/opentelemetry-collector-contrib:0.144.0 \


--config
=/etc/otelcol-contrib/config.yaml
重启 OpenClaw:
openclaw gateway restart
第三步:打开 Dashboard
打开 Grafana(
http://localhost:3000
,默认账号
admin
/
admin
),三个 OpenClaw Dashboard 已经预置好了,无需手动导入:
-
Security 与 Audit Dashboard — 安全审计
-
Cost 与 Efficiency Dashboard — 成本分析
-
Agent Behavior Dashboard — 行为分析
对接 OpenClaw 并产生数据后,Dashboard 会自动展示分析结果。你的 AI Agent 的一切行为,现在都在你的掌控之中。
生产环境:对接阿里云 SelectDB
上面的一键部署包含了内置的 Doris 实例,适合本地体验和开发测试。如果你的 AI Agent 已经在生产环境运行,推荐使用 作为 AI Observe Stack 的后端存储,免去运维负担。
只需将第一步替换为以下操作,其余步骤完全一致:
# 1. 配置连接信息


cp .env.example .env


# 编辑 .env,填入 SelectDB Cloud 连接信息:


DORIS_FE_HTTP_ENDPOINT
=http://<your-cluster>.selectdb.com:http_port


DORIS_FE_MYSQL_ENDPOINT
=<your-cluster>.selectdb.com:mysql_port


DORIS_USERNAME
=admin


DORIS_PASSWORD
=<your-password>


# 2. 使用 without-doris 模式启动(不启动本地 Doris,数据直接写入云端)


docker compose
-f docker-compose-without-doris.yaml up
-d
不只是 OpenClaw
虽然本文以 OpenClaw 为例,但 AI Observe Stack 的设计是通用的。任何支持 OpenTelemetry 的 AI Agent 框架都可以接入:
-
数据采集 :通过 OpenTelemetry 协议(gRPC :4317 / HTTP :4318)发送 Traces 和 Metrics;通过 filelog receiver 采集日志
-
数据存储 :Apache Doris 的高效列式存储,VARIANT 类型天然适配半结构化 JSON 的可观测数据,倒排索引自动加速文本检索等查询
-
数据分析 :标准 SQL 查询,你可以自由编写任何分析逻辑
无论你用的是 LangChain、AutoGen、CrewAI 还是自研的 Agent 框架,只要输出 OpenTelemetry 格式的遥测数据,就能接入这套体系。
结语
如果你正在运行 AI Agent,你需要回答一个问题:
你知道它在做什么吗?
它执行了哪些命令?访问了哪些文件?调用了哪些外部服务?花了多少 token?有没有被注入攻击?
如果你回答不了这些问题,那你的 AI Agent 就是一个黑盒——一个拥有你全部权限的黑盒。
AI Observe Stack 的目标,就是为每一个 AI Agent 装上一扇“透明玻璃窗” 。
让黑盒变白盒,让不确定性变得确定。
我们相信,可观测性是 AI 大规模落地的基石。
开源不应孤独 , 如果你也认同这个理念,欢迎给我们的项目点个 Star,支持我们继续为 AI 的安全保驾护航。 GitHub 地址: https://github.com/ai-observe/ai-observe-stack
想立刻体验?
无论你是 OpenClaw 的玩家,还是正在开发自己的 AI Agent,都可以在几分钟内快速部署这套观测栈:
-
省心的云上部署:使用 ,无需自己维护数据库。
-
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-3111699/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
- Apache Doris + Lance:让多模态数据真正进入智能驾驶与具身智能的分析闭环
- Apache Doris 5.0 年度版本前瞻(一):构建统一的多模湖仓实时分析平台
- 统一全文检索与 SQL 分析:Apache Doris 日志分析实践
