数据库索引是一种数据结构,用于对数据库表中的一列或多列的值进行排序,以便快速访问表中的特定信息。索引的主要目的是加快检索表中数据的速度,提高系统的性能。可以将其类比为一本书的目录,通过目录可以快速定位到书中的特定章节,而无需逐页翻阅。
索引通过维护一个有序的数据结构(如B树、哈希表等),使得数据库系统能够在查询时快速定位到所需的数据行。在创建索引时,数据库系统会为索引列创建一个额外的数据结构,该结构包含了指向实际数据行的指针。当执行查询操作时,数据库系统首先会在索引中查找匹配的记录,然后通过指针快速定位到实际的数据行。
数据库索引的类型
从加速的查询和原理来看,ApacheDoris的索引分为点查索引和跳数索引两大类。
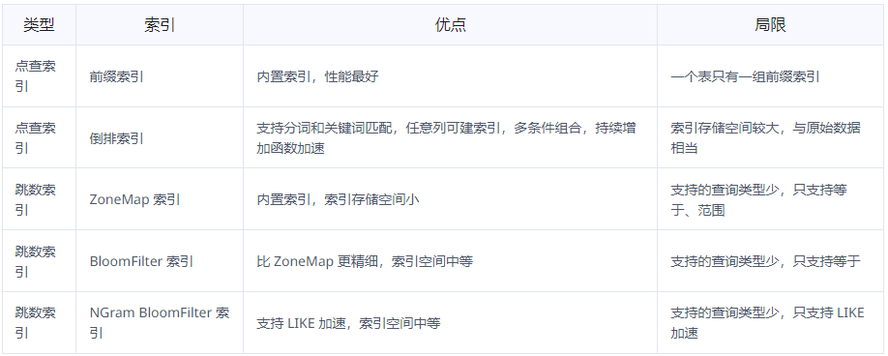
点查索引:常用于加速点查,原理是通过索引定位到满足WHERE条件的有哪些行,直接读取那些行。点查索引在满足条件的行比较少时效果很好。ApacheDoris的点查索引包括前缀索引和倒排索引:
1、前缀索引:ApacheDoris按照排序键以有序的方式存储数据,并每隔1024行数据创建一个稀疏前缀索引。索引中的Key是当前1024行中第一行中排序列的值。如果查询涉及已排序列,系统将找到相关1024行组的第一行并从那里开始扫描。
2、倒排索引:对创建了倒排索引的列,建立每个值到对应行号集合的倒排表。对于等值查询,先从倒排表中查到行号集合,然后直接读取对应行的数据,而不用逐行扫描匹配数据,从而减少I/O加速查询。倒排索引还能加速范围过滤、文本关键词匹配,算法更加复杂但是基本原理类似。(备注:之前的BITMAP索引已经被更强的倒排索引取代)
跳数索引:常用于加速分析,原理是通过索引确定不满足WHERE条件的数据块,跳过这些不满足条件的数据块,只读取可能满足条件的数据块并再进行一次逐行过滤,最终得到满足条件的行。跳数索引在满足条件的行比较多时效果较好。ApacheDoris的跳数索引包括ZoneMap索引、BloomFilter索引、NGramBloomFilter索引:
1、ZoneMap索引:自动维护每一列的统计信息,为每一个数据文件(Segment)和数据块(Page)记录最大值、最小值、是否有NULL。对于等值查询、范围查询、ISNULL,可以通过最大值、最小值、是否有NULL来判断数据文件和数据块是否可以包含满足条件的数据,如果没有则跳过不读对应的文件或数据块减少I/O加速查询。
2、BloomFilter索引:将索引对应列的可能取值存入BloomFilter数据结构中,它可以快速判断一个值是否在BloomFilter里面,并且BloomFilter存储空间占用很低。对于等值查询,如果判断这个值不在BloomFilter里面,就可以跳过对应的数据文件或者数据块减少I/O加速查询。
3、NGramBloomFilter索引:用于加速文本LIKE查询,基本原理与BloomFilter索引类似,只是存入BloomFilter的不是原始文本的值,而是对文本进行NGram分词,每个词作为值存入BloomFilter。对于LIKE查询,将LIKE的pattern也进行NGram分词,判断每个词是否在BloomFilter中,如果某个词不在则对应的数据文件或者数据块就不满足LIKE条件,可以跳过这部分数据减少I/O加速查询。
各种类型索引特点对比
倒排索引是什么
倒排索引,是信息检索领域常用的索引技术,将文本分成一个个词,构建词->文档编号的索引,可以快速查找一个词在哪些文档出现。
从2.0.0版本开始,Doris支持倒排索引,可以用来进行文本类型的全文检索、普通数值日期类型的等值范围查询,快速从海量数据中过滤出满足条件的行。
在Doris的倒排索引实现中,Table的一行对应一个文档、一列对应文档中的一个字段,因此利用倒排索引可以根据关键词快速定位包含它的行,达到WHERE子句加速的目的。
与Doris中其他索引不同的是,在存储层倒排索引使用独立的文件,跟数据文件一一对应、但物理存储上文件相互独立。这样的好处是可以做到创建、删除索引不用重写数据文件,大幅降低处理开销。
倒排索引案例分享:
倒排索引在数据仓库应用案例查看: 从Elasticsearch到SelectDB,观测云实现日志存储与分析的10倍性价比提升(https://www.selectdb.com/blog/122)
#倒排索引#
原文链接: 数据库索引有哪几种类型,倒排索引是什么
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/70017904/viewspace-3058480/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- Apache Doris x Fluss:面向湖流一体的统一查询与分析
- Apache Doris 高性能 Open Lake Variant 读写技术解析(含对比数据)
- StarRocks 迁移至 Apache Doris 完整指南:三步完成结构、数据与业务平滑切换
- 快手基于 Apache Doris 千亿多模态检索的实践
- 某头部保险公司基于 SelectDB 的统一 OLAP 架构实践
- Doris 直查 Paimon 索引:快手湖上向量检索的共建与落地
- Apache Doris+ Paimon 2.0:构建 Agentic AI 数据闭环
- Apache Doris + Lance:让多模态数据真正进入智能驾驶与具身智能的分析闭环
- Apache Doris 5.0 年度版本前瞻(一):构建统一的多模湖仓实时分析平台
- 统一全文检索与 SQL 分析:Apache Doris 日志分析实践
